
Руководство по использованию
Рецепты промптов reference-to-video для Vidu Q4 Preview: готовые к копированию промпты и реальные результаты
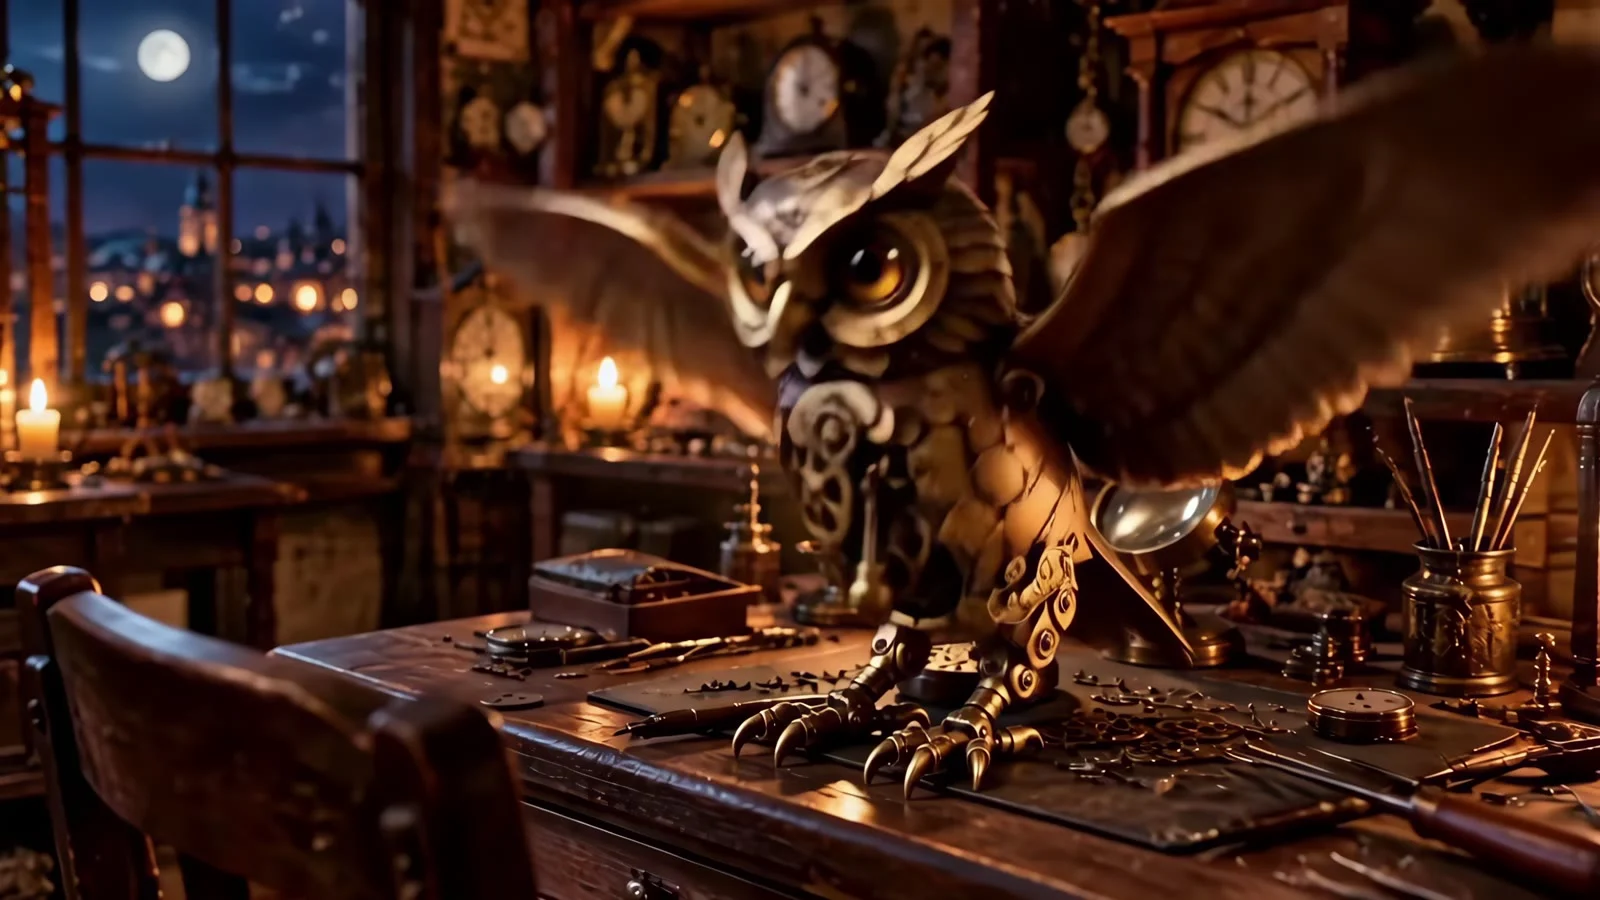
Пять проверенных на практике промптов reference-to-video — слияние нескольких изображений, аудиореференс и один настоящий 4K-кадр — каждый с созданным им видеороликом.
TL;DR
- Пять готовых к копированию рецептов промптов reference-to-video для vidu-q4-preview/reference-to-video, каждый с реально сгенерированным на hiapi видеороликом — не стоковым материалом и не рендером-имитацией.
- Reference-to-video — это режим «объединения нескольких статичных изображений в один кадр»: вы передаёте 1–15 референсных изображений и, опционально, до 3 референсных аудиофрагментов, а модель рендерит единый кадр длительностью 3–16 секунд, вплоть до 4K.
- Включает настоящий кинематографичный 4K-фрагмент и рабочий пример аудиореференса («говорящий ведущий») с точным запросом
reference_audio_urls. - Правила промптов, которые действительно изменили результат: указывать каждую референсную картинку по номеру, описывать кадр как одно непрерывное действие и сохранять реплику в промпте при подключении аудио.
- Скопируйте JSON, подставьте свои референсные URL и отправьте POST на
/v1/tasks.
Что на самом деле делает vidu-q4-preview/reference-to-video
Vidu Q4 Preview (от Shengshu Technology) на hiapi представлен двумя линейками продуктов, которые не взаимозаменяемы:
- reference-to-video (эта страница): вы передаёте набор референсных изображений — персонажа, локацию, продукт, реквизит — и модель объединяет их в движущийся кадр. Поле —
reference_image_urls, принимает 1–15 изображений. - image-to-video (рецепты здесь): вы передаёте один первый кадр (
image_url), и модель анимирует этот кадр вперёд. Полеreference_image_urlsполностью отклоняется.
Итак, выбирайте reference-to-video, когда нужно объединить независимые объекты в одну сцену; выбирайте image-to-video, когда у вас есть точный начальный кадр и нужно только движение. Если вы пользовались линейкой reference-to-video в Vidu Q3, прогресс здесь конкретный: Q4 Preview добавляет вывод в 4K (Q3 максимум 1080p) и увеличивает лимит референсов до 1–15 изображений (Q3 Mix допускает 1–7). Оба поколения поддерживают аудиореференсы; эти рецепты используют преимущества большего лимита изображений Q4 и 4K.
Проверенная схема входных данных (измерена на /v1/tasks в октябре 2026 года):
| Поле | Обязательное | Значения |
|---|---|---|
prompt |
Да | Свободный текст; указывайте референсные субъекты по номерам |
reference_image_urls |
Да | Массив, 1–15 публичных URL изображений |
reference_audio_urls |
Нет | Массив, максимум 3 URL аудио (референс голоса/звука) |
resolution |
Нет | 540p · 720p · 1080p · 2k · 4k |
duration |
Нет | Целое число, 3–16 секунд |
aspect_ratio |
Нет | 16:9 · 9:16 · 1:1 · 4:3 · 3:4 |
Ценообразование — фиксированная ставка за секунду в зависимости от разрешения (так что 5-секундный фрагмент стоит цену за секунду × 5). По состоянию на октябрь 2026 года на hiapi: 540p — $0.0515/сек, 720p — $0.109/сек, 1080p — $0.1375/сек, 2K — $0.2175/сек, 4K — $0.446/сек. Полные цифры — на странице цен. Практический вывод: итерируйте промпты на 720p, а затем перезапускайте удачный вариант на 4K — сам промпт не меняется, меняется только множитель.
Как мы получили эти результаты (чтобы вы могли воспроизвести)
Каждый фрагмент ниже сгенерирован на hiapi через асинхронный API задач. Процесс всегда одинаковый:
- Референсные изображения должны быть доступны публично. Мы генерировали свои изображения с помощью
gpt-image-2/text-to-image, загружали их в статическое хранилище и передавали эти URL — вы можете использовать любые размещённые изображения. - Отправьте
POST /v1/tasksс телом запроса, указанным в каждом рецепте. - Опрашивайте
GET /v1/tasks/{taskId}, покаstatusне станетsuccess, затем скачайтеoutput[0].url(это временная ссылка — сохраните её немедленно).
Документация для быстрого старта — в документации hiapi. Минимальный запрос выглядит так:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q4-preview/reference-to-video",
    "input": {
      "prompt": "...",
      "reference_image_urls": ["https://.../subject.jpg"],
      "resolution": "1080p",
      "duration": 5,
      "aspect_ratio": "16:9"
    }
  }'
Ниже — рецепты.
Рецепт 1 — Быстрый старт с одним референсом
Лучше всего подходит для: простейшего reference-to-video — один субъект, одна чистая анимация. Начните отсюда, прежде чем переходить к слиянию.
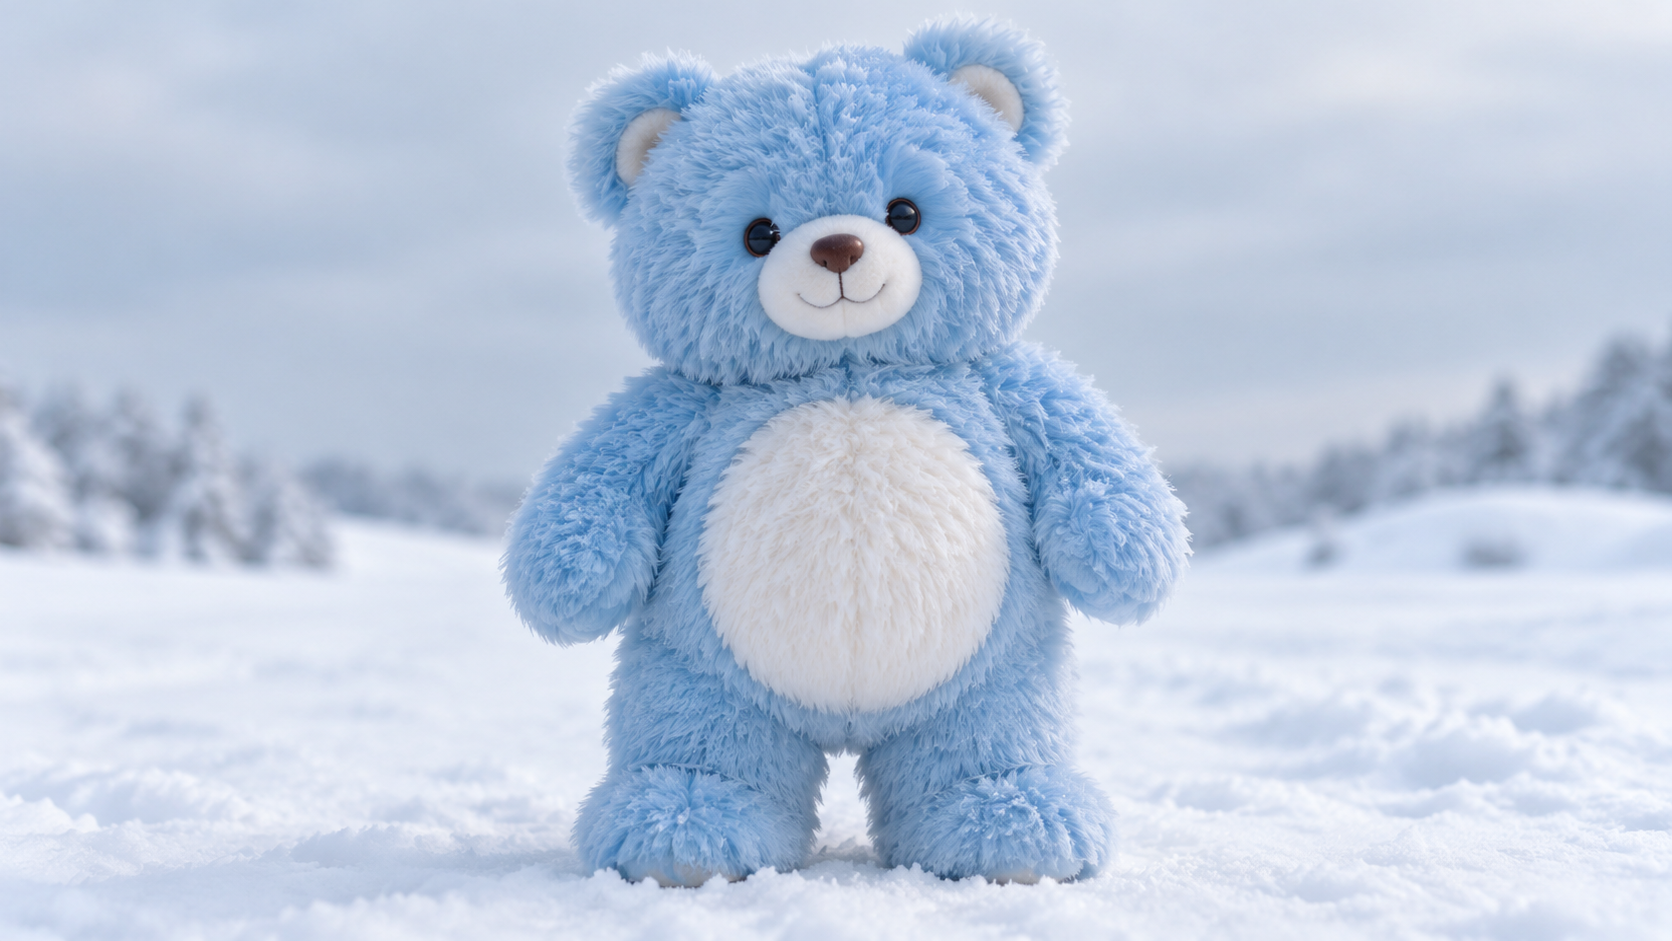
Входное референсное изображение:
Реальный результат (720p, 3 секунды):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Пушистый синий медвежонок из референсного изображения 1 медленно делает два шага вперёд по снегу, затем поднимает голову, смотрит в камеру и машет одной лапой. Мягкий падающий снег, кинематографичный мягкий свет.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/smoke_bear.jpg"],
    "resolution": "720p",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
Почему это работает: даже с одним изображением его упоминание («пушистый синий медвежонок из референсного изображения 1») закрепляет субъект и заставляет модель анимировать именно того медвежонка, а не создавать нового с нуля. Одно короткое конкретное действие («два шага… машет одной лапой») за 3 секунды рендерится чище, чем расплывчатое «пусть двигается». Обратите внимание: хотя мы не прикрепляли никакого референсного аудио, фрагмент вернулся с дорожкой окружающего звука.
Рецепт 2 — Кинематографичный 4K, слияние персонажа и сцены
Лучше всего подходит для: вашего главного кадра. Два референса — субъект и окружение — сливаются в атмосферный кадр, финализируемый в 4K.
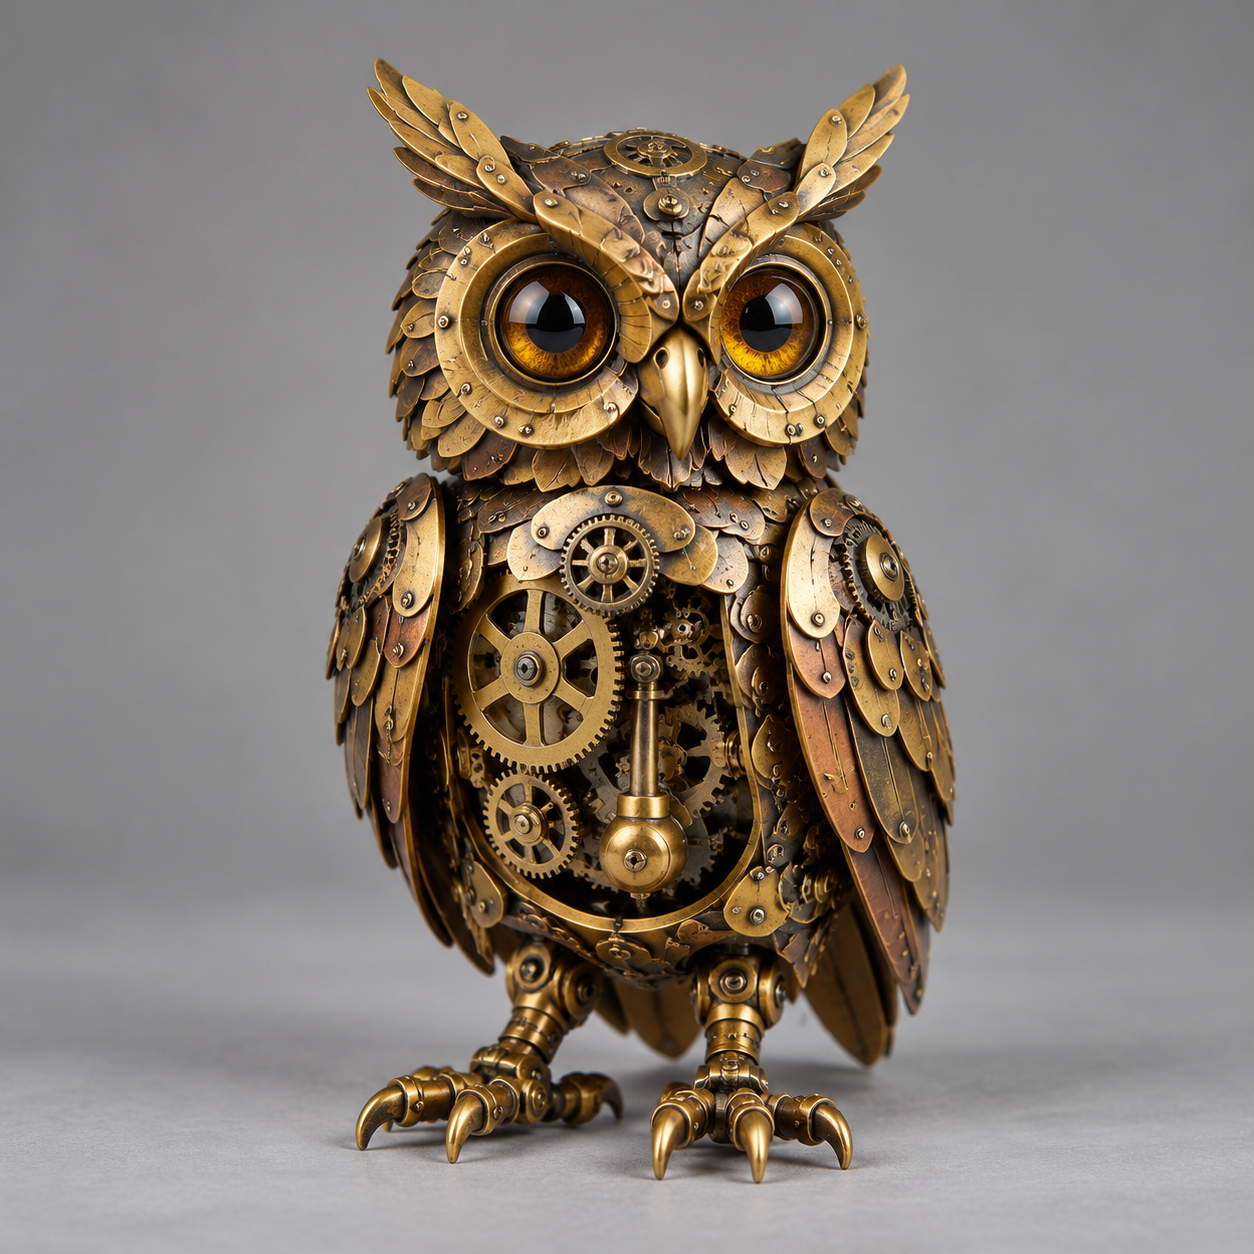
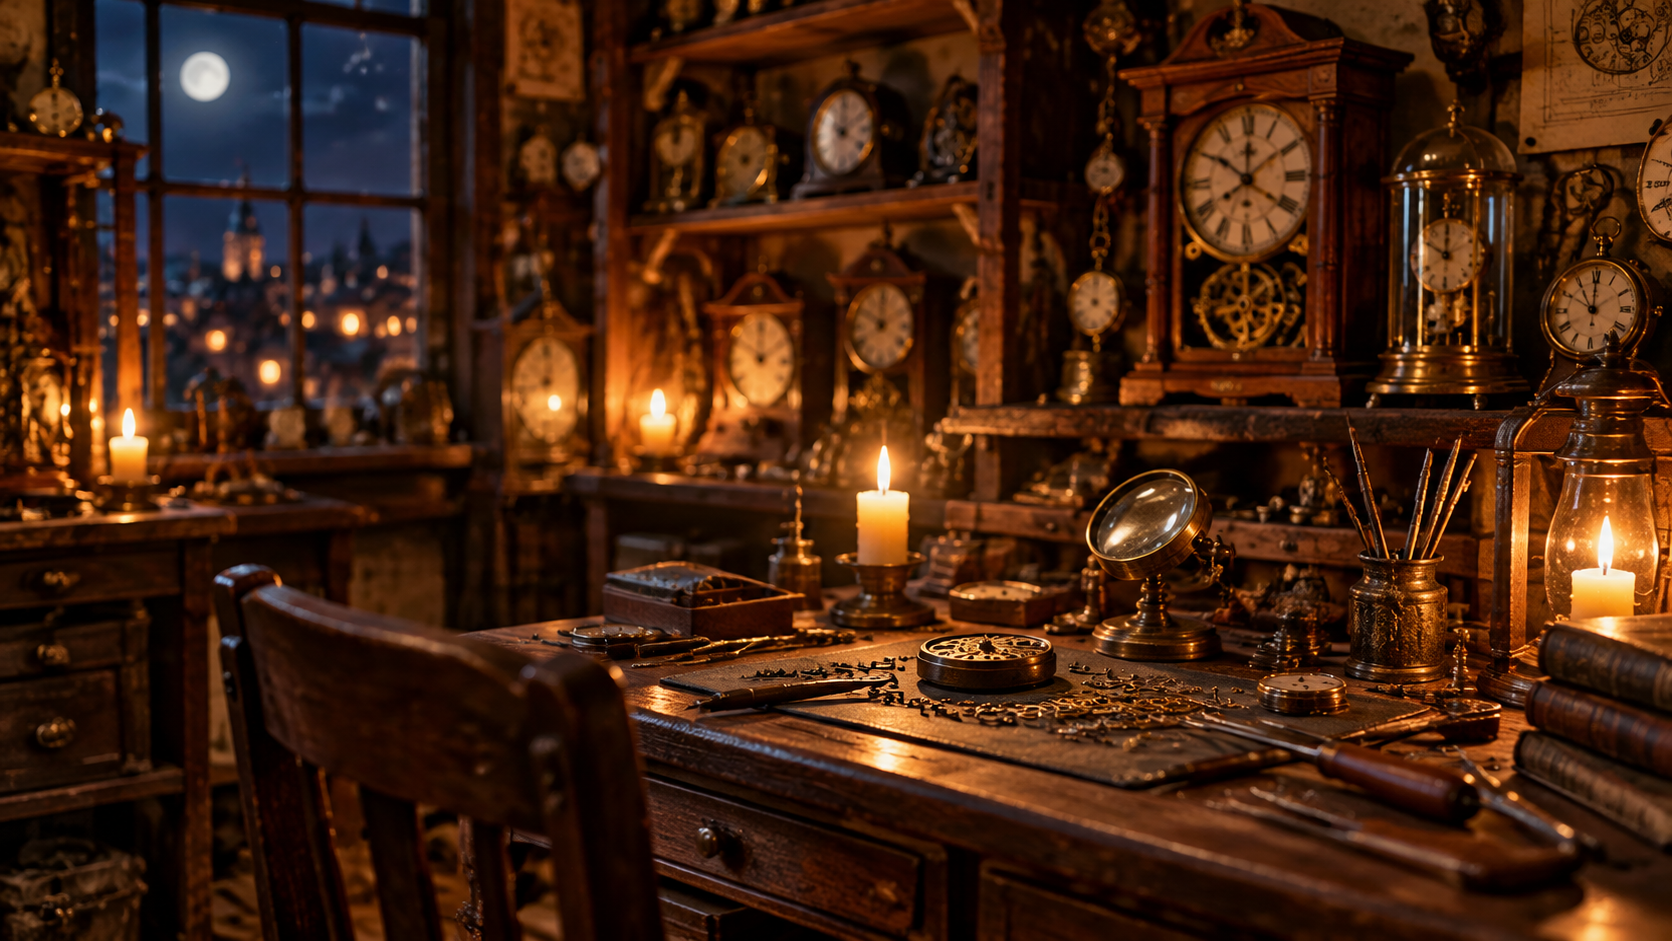
Входные референсы (субъект + локация):
Реальный результат (4K, 3 секунды):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Латунная заводная сова из референсного изображения 1 влетает в мастерскую с мерцающими свечами из референсного изображения 2, крылья гудят, видны шестерёнки, затем она мягко приземляется на деревянный верстак. Она медленно поворачивает голову к камере и один раз моргает. Тёплый янтарный свет свечей мерцает, в воздухе плавают пылинки, кинематографичная малая глубина резкости.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/owl_char.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/clock_workshop.jpg"],
    "resolution": "4k",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
Почему это работает: промпт назначает каждому референсу роль — изображение 1 — актёр, изображение 2 — декорация — так модель знает, какое статичное изображение является субъектом, а какое фоном. Движение камеры — это единый образ (влёт → приземление → поворот к камере), и reference-to-video рендерит его как один непрерывный кадр. При $0.446/сек этот 3-секундный 4K-фрагмент стоит около $1.34; мы сначала проверили композицию на 720p.
Рецепт 3 — Аудиореференс (говорящий ведущий)
Лучше всего подходит для: персонажа, говорящего определённым голосом. Вы прикрепляете аудио как reference_audio_urls; аудио задаёт тембр, промпт задаёт реплику и синхронизацию губ.
Входное референсное изображение:
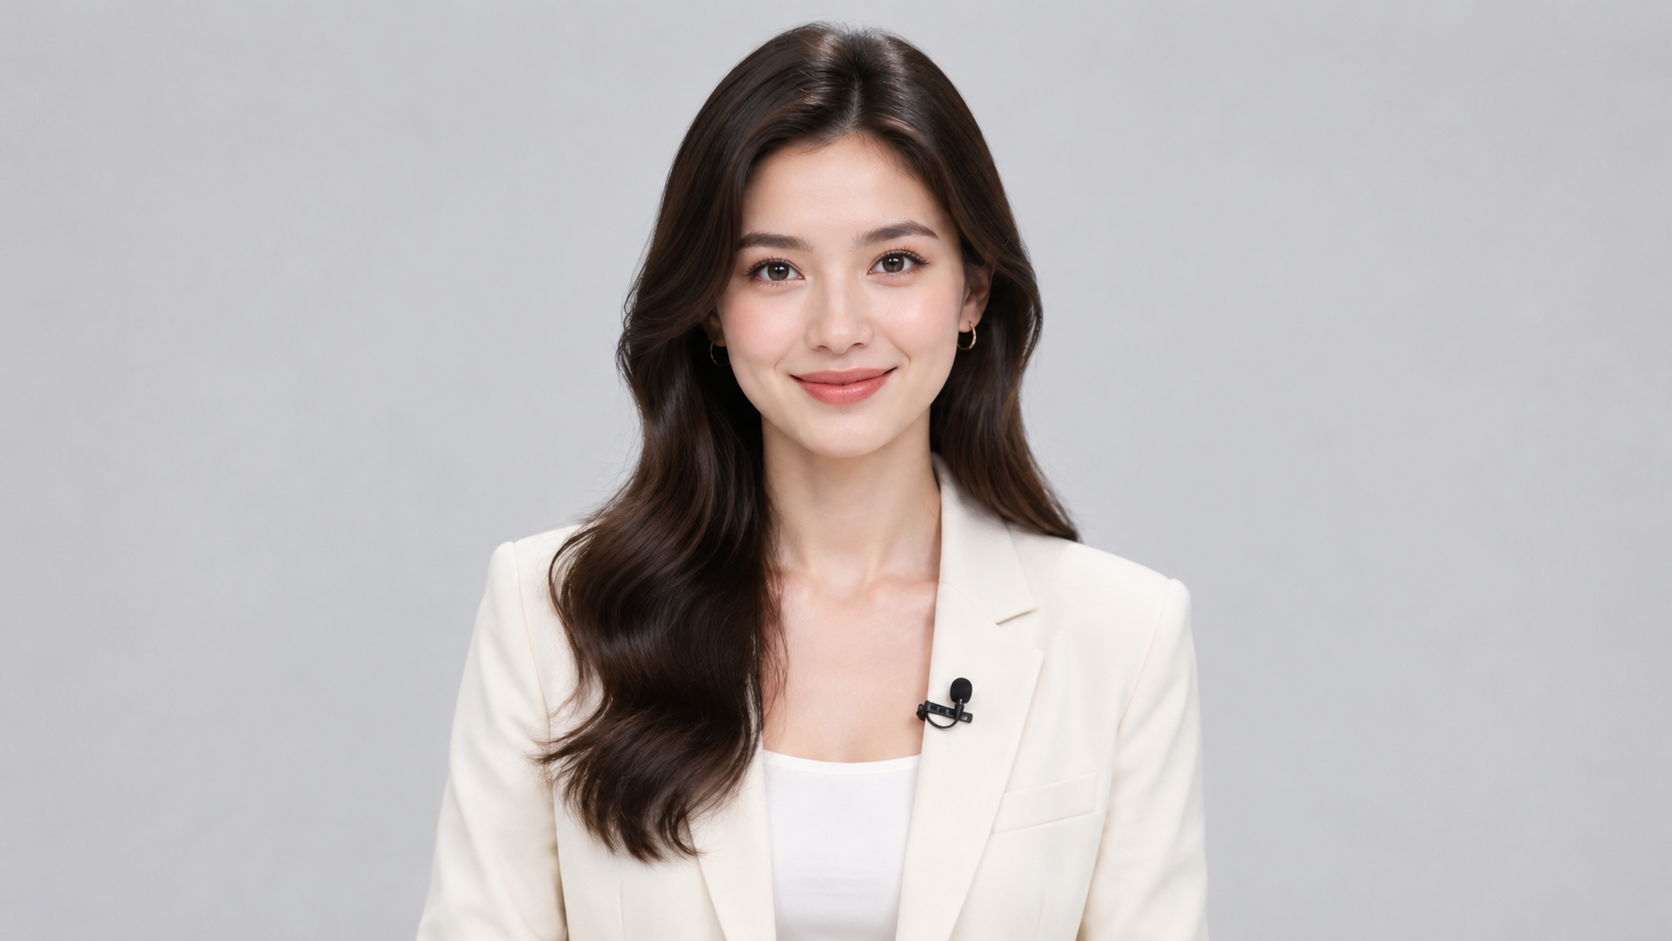
Входное референсное аудио: presenter_voice.mp3 (мы сгенерировали эту реплику с помощью qwen-audio-3.0-tts-plus; подойдёт любой размещённый URL аудио).
Реальный результат (1080p, 5 секунд):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Ведущий из референсного изображения 1 смотрит прямо в камеру, произносит эту реплику голосом из референсного аудио 1, губы естественно синхронизированы, лёгкие покачивания головы, тёплая улыбка. Устойчивый студийный кадр, мягкое освещение, лёгкое дыхание.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/presenter.jpg"],
    "reference_audio_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/audio/presenter_voice.mp3"],
    "resolution": "1080p",
    "duration": 5,
    "aspect_ratio": "16:9"
  }
}
Почему это работает: ключевая фраза — «произносит эту реплику голосом из референсного аудио 1». Аудиореференс управляет голосом; промпт по-прежнему несёт указания по игре («естественная синхронизация губ», «тёплая улыбка»). Сделайте длину аудиофрагмента близкой к вашему duration, чтобы речь уместилась в кадр. reference_audio_urls — это массив: можно передать до трёх фрагментов, чтобы сослаться на несколько голосов или на голос плюс слой окружающего звука.
Рецепт 4 — Слияние трёх референсов для продукта
Лучше всего подходит для: коммерческой композиции из независимых статичных изображений продукта — флакон, реквизит, столешница — расставленных в одной сцене.
Входные референсы (продукт + реквизит + сцена):
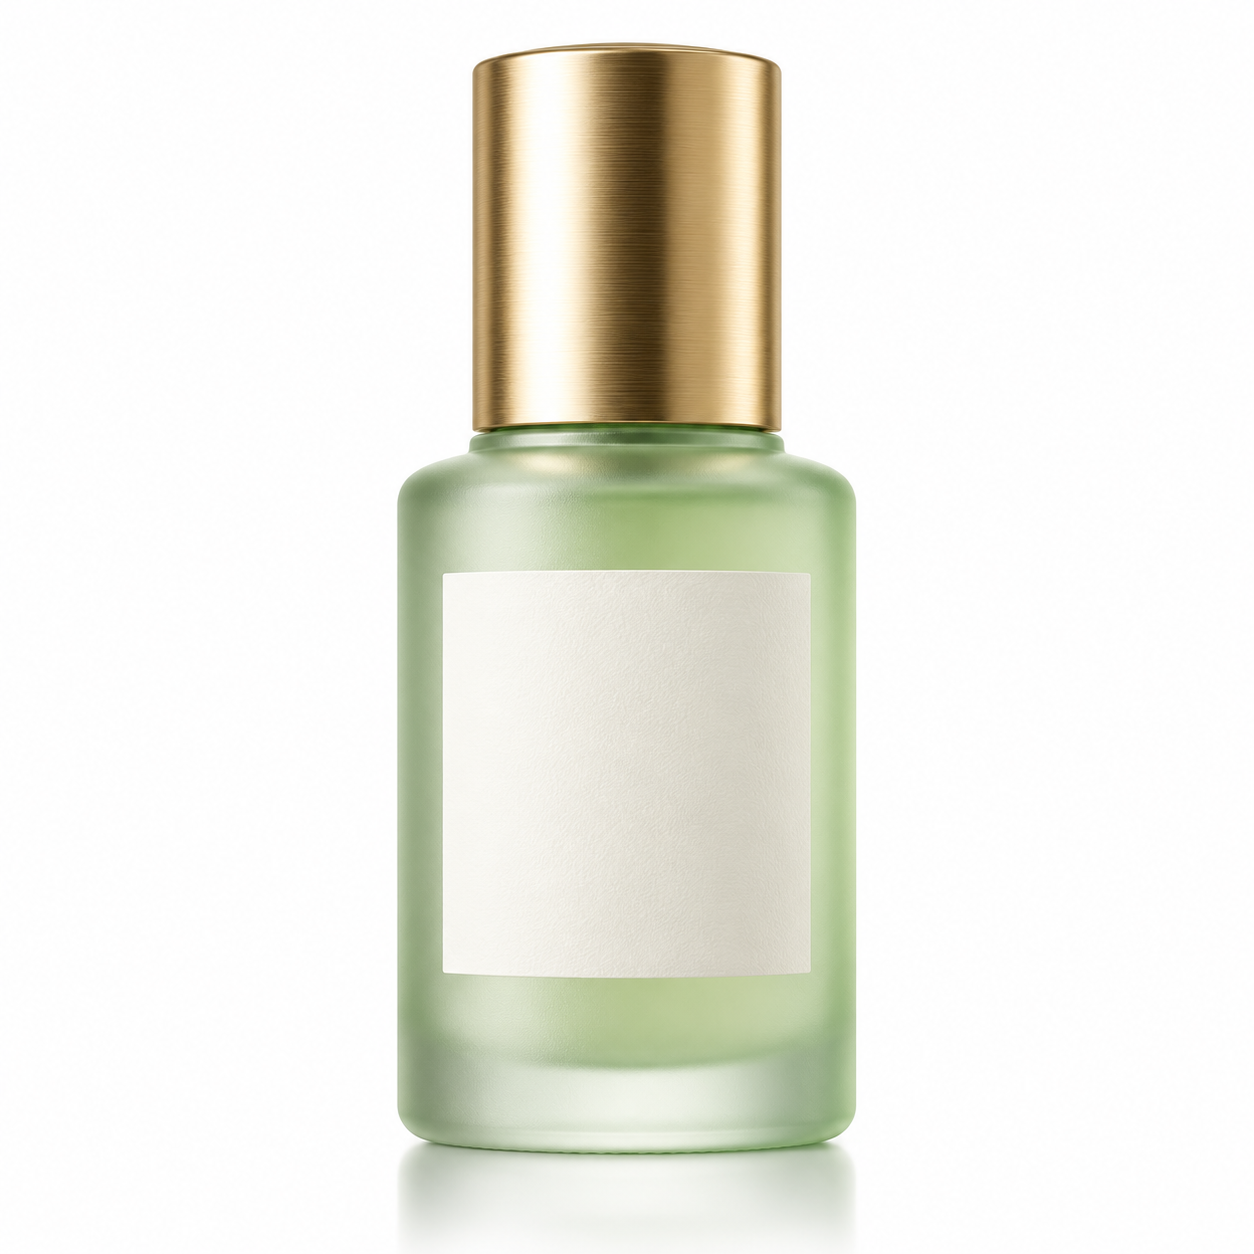
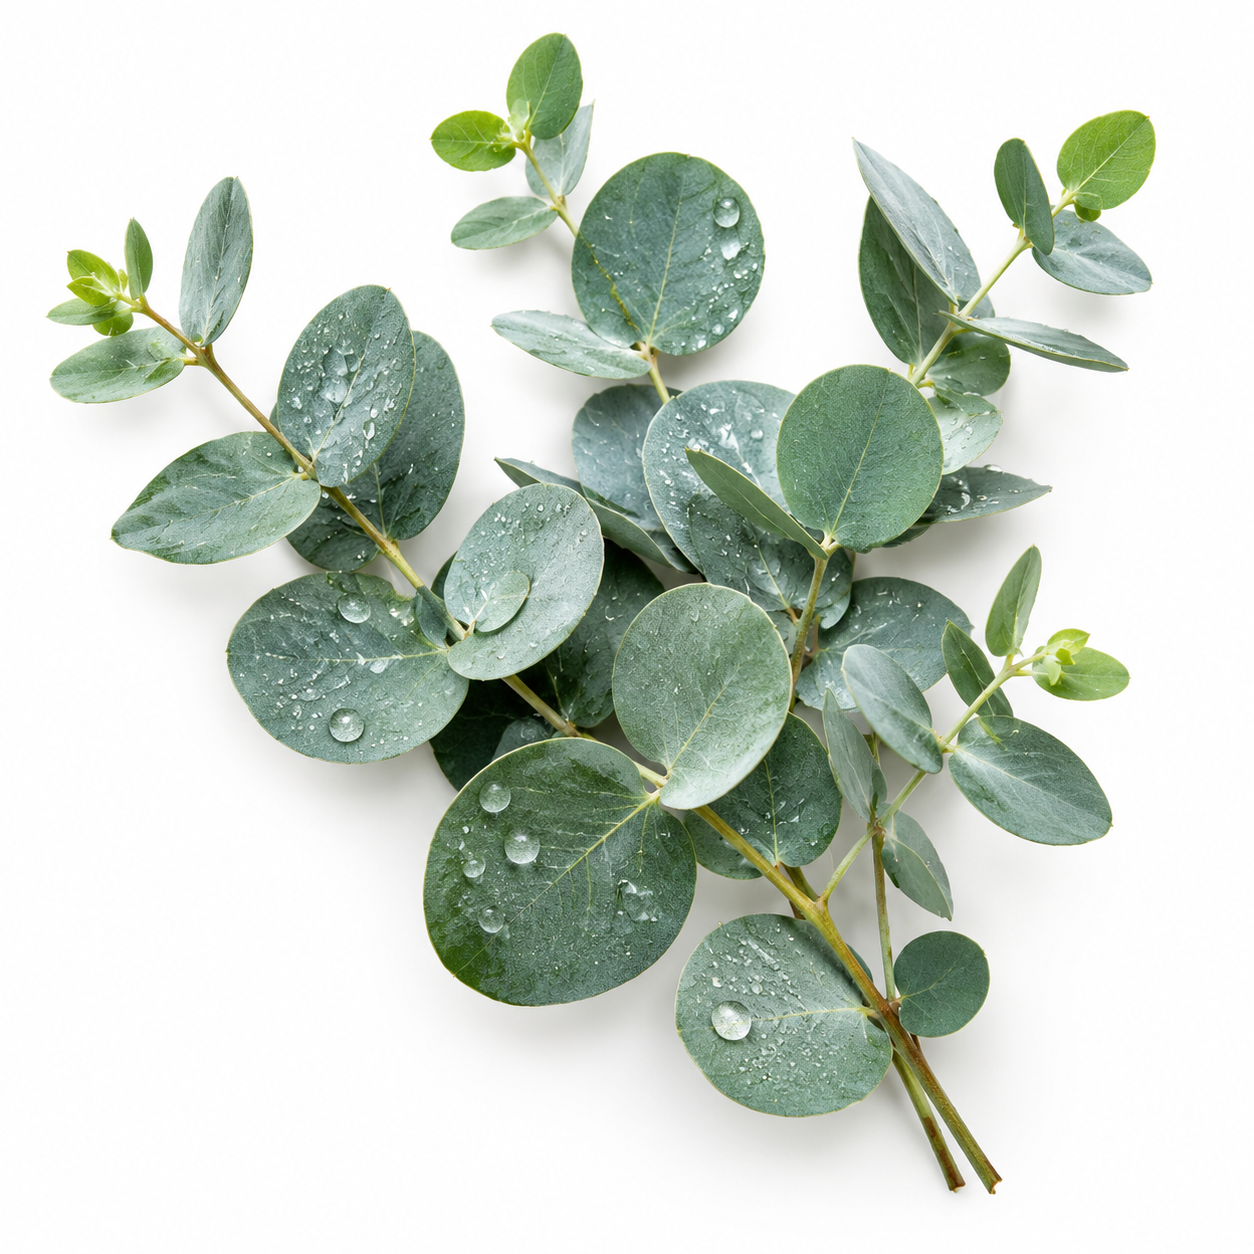
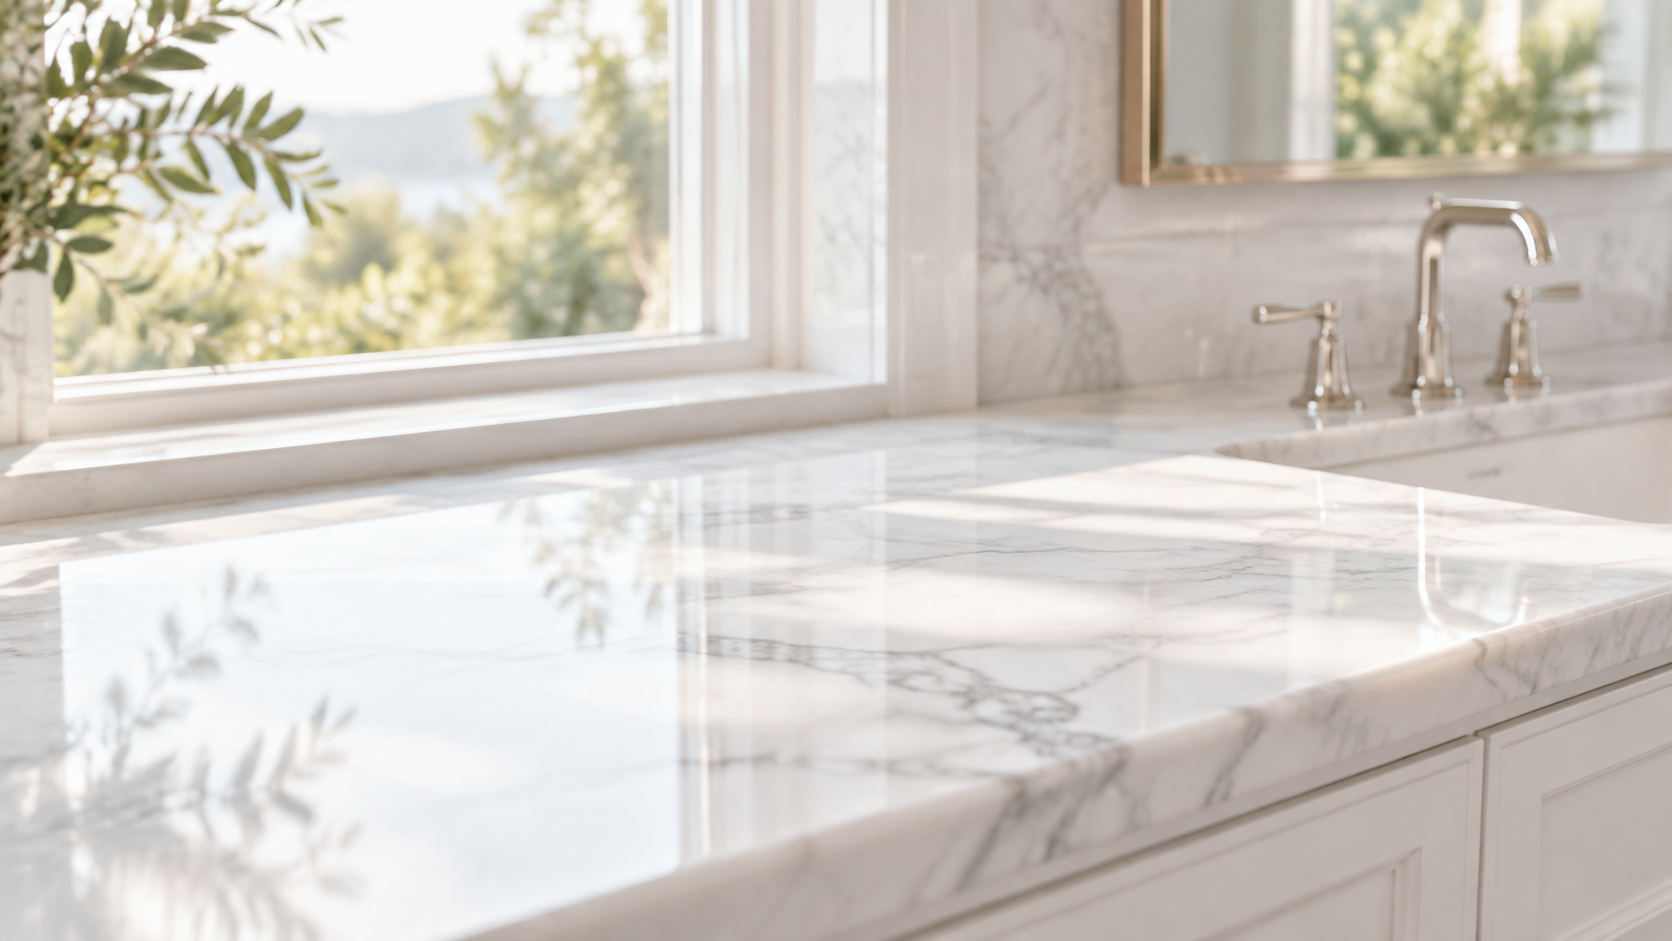
Реальный результат (1080p, 4 секунды):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Соберите сцену: поставьте флакон матовой сыворотки из референсного изображения 1 вертикально на мраморный туалетный столик из референсного изображения 3, прислоните рядом веточки эвкалипта из референсного изображения 2. Медленный кинематографичный наезд камеры, капля воды скатывается по флакону, мягкий утренний свет, лёгкий пар. Ощущение рекламы премиальной косметики.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/serum_bottle.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/eucalyptus.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/marble_vanity.jpg"],
    "resolution": "1080p",
    "duration": 4,
    "aspect_ratio": "16:9"
  }
}
Почему это работает: три чистых независимых статичных изображения (каждый субъект на однотонном фоне) дают модели однозначные элементы для сборки. Промпт явно задаёт пространственное расположение («на столике», «рядом с ним») и ссылается на каждое изображение по точному номеру. Слияние сбивается, когда сами референсы загромождены или вы просто говорите «объедини это», не указывая модели, где что должно находиться.
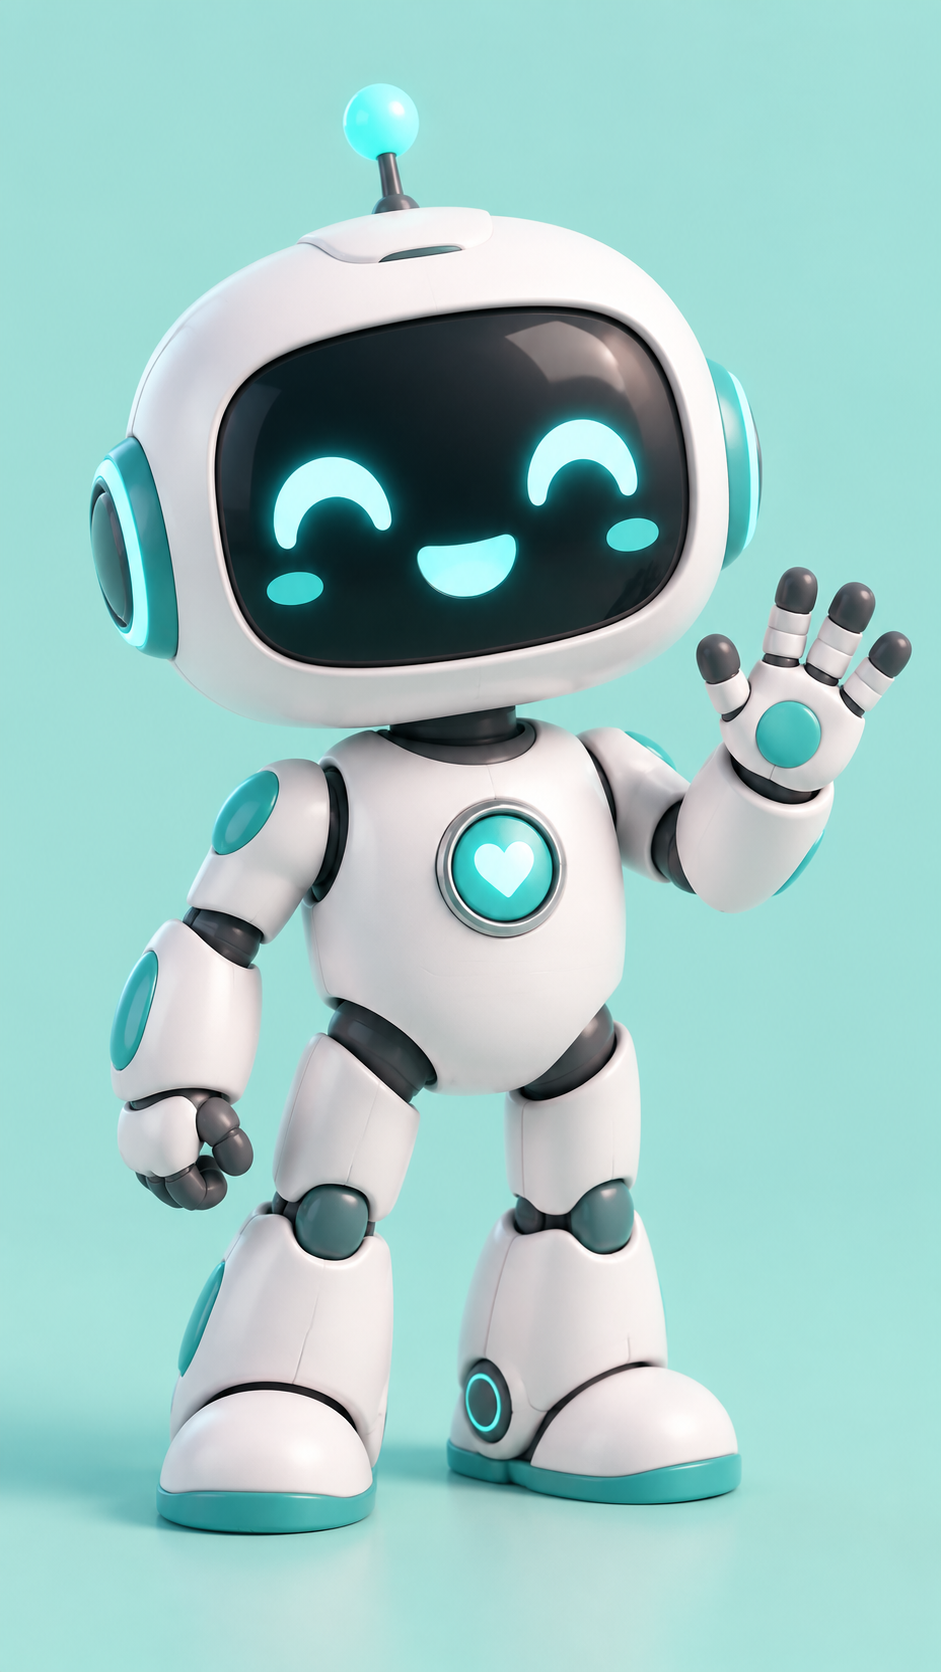
Рецепт 5 — Вертикальный цикл для соцсетей (9:16)
Лучше всего подходит для: платформ коротких видео. Та же модель, та же дисциплина промптов, только aspect_ratio: "9:16".
Входное референсное изображение:
Реальный результат (720p, 5 секунд, вертикальный):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Робот-талисман в бело-голубых цветах из референсного изображения 1 машет обеими руками, радостно подпрыгивает и в конце показывает большой палец вверх в камеру. Взрыв цветного конфетти, пружинистые энергичные движения, яркий жизнерадостный свет, вертикальная композиция для соцсетей.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/robot_mascot.jpg"],
    "resolution": "720p",
    "duration": 5,
    "aspect_ratio": "9:16"
  }
}
Почему это работает: aspect_ratio управляет выходным форматом, так что для вертикального фрагмента достаточно задать 9:16 — референсное изображение может быть любой формы. Для цикла в соцсетях дайте персонажу чёткий ритм начало—середина—конец (машет → подпрыгивает → большой палец вверх), чтобы 5 секунд читались как законченный микро-момент, а не обрывок.
Правила написания промптов, которые действительно изменили результат
- Нумеруйте референсы. «Сова из референсного изображения 1», «сцена из референсного изображения 2». Модель привязывает субъект к номеру; «объедини эти картинки» — именно то, из-за чего слияние сбивается.
- Дайте каждому референсу роль. Укажите, какое статичное изображение — актёр, какое — декорация, какое — реквизит. Расплывчатость заставляет модель гадать.
- Описывайте кадр как одно действие. Reference-to-video — это один непрерывный кадр длительностью 3–16 секунд. Один замысел кадра («наезд», «влёт и приземление») лучше списка из нескольких планов.
- При использовании голоса называйте аудио и сохраняйте реплику. «Говорит голосом из референсного аудио 1» + фактическая фраза в промпте. Согласуйте длину аудио с
duration. - Дешёвые итерации, финализация в 4K. Разрешение — фиксированный множитель за секунду, не затрагивающий промпт: сначала проверьте кадр на 720p, затем перезапустите удачный вариант на 4K.
FAQ
В чём разница между reference-to-video и image-to-video в Vidu Q4 Preview?
Reference-to-video принимает набор изображений (reference_image_urls, 1–15 штук) и объединяет их в один кадр. Image-to-video принимает один первый кадр (image_url) и анимирует его — поле reference_image_urls отклоняется. Для слияния независимых субъектов используйте reference-to-video; когда у вас есть точный начальный кадр — image-to-video.
Как добавить референсный голос?
Передайте reference_audio_urls — массив до трёх публичных URL аудио — и укажите в промпте «говорит голосом из референсного аудио 1». Аудио задаёт тембр; промпт задаёт реплику и синхронизацию губ.
Сколько референсных изображений можно использовать? От 1 до 15. Для простой анимации достаточно одного; дайте больше, чтобы объединить персонажа, локацию и реквизит в одной сцене.
Какие разрешения и длительности поддерживаются?
Разрешения 540p, 720p, 1080p, 2k, 4k; длительность — целое число от 3 до 16 секунд; соотношения сторон 16:9, 9:16, 1:1, 4:3, 3:4.
Сколько стоит 4K-фрагмент? 4K стоит $0.446 за секунду, так что 3-секундный 4K-фрагмент — около $1.34, 5-секундный — около $2.23. Более низкие разрешения намного дешевле (720p — $0.109 за секунду). Актуальные цифры смотрите на странице цен.
Должны ли референсные изображения быть публичными URL? Да — модель их загружает, поэтому они должны быть доступны через интернет. Разместите их в любом публично доступном месте и передайте URL.
Ключевые выводы
- Reference-to-video объединяет 1–15 статичных изображений в один кадр длительностью 3–16 секунд; image-to-video анимирует один первый кадр.
- Указывайте каждый референс по номеру и давайте ему роль — эта одна привычка исправляет большинство сбоев слияния.
- Аудиореференс — это
reference_audio_urls(максимум 3 фрагмента); аудио задаёт голос, промпт задаёт реплику. - 4K ($0.446 за секунду) — визитная карточка Q4 Preview по сравнению с Q3: используйте его для финализации, итерируйте на 720p.
- Скопируйте любой рецепт выше, подставьте свои референсные URL и запускайте.
Готовы попробовать? Откройте страницу модели vidu-q4-preview/reference-to-video, возьмите API-ключ в документации и вставьте рецепт. Если у вас есть только один опорный кадр, а не набор изображений, начните с линейки image-to-video или просмотрите другие рабочие процессы reference-to-video и рецепты промптов в блоге hiapi.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков