
Guía de uso
Fórmulas de prompts de referencia a video de Vidu Q4 Preview: prompts listos para copiar y resultados reales
Cinco prompts de referencia a video probados en batalla: fusión de múltiples imágenes, referencia de voz y un plano real en 4K, cada uno con el clip que generó.
TL;DR
- Cinco fórmulas de prompts de referencia a video listas para copiar, orientadas a vidu-q4-preview/reference-to-video, cada una con el clip que realmente generó en hiapi: no es material de archivo ni una imagen de demostración.
- La referencia a video es el modo de «fusionar varias imágenes fijas en un solo plano»: le das de 1 a 15 imágenes de referencia y, opcionalmente, hasta 3 clips de audio de referencia; el modelo renderiza un único plano de 3 a 16 segundos, con una resolución de hasta 4K.
- Incluye un clip cinematográfico real en 4K y un ejemplo funcional de referencia de voz («un presentador que habla»), con la solicitud exacta de
reference_audio_urls. - Las reglas de prompt que de verdad cambiaron el resultado: referirse a cada referencia por su número, escribir el plano como una sola acción continua y, al añadir voz, mantener el diálogo en el prompt.
- Copia el JSON, sustituye tus propias URLs de referencia y haz POST a
/v1/tasks.
Qué hace exactamente vidu-q4-preview/reference-to-video
Vidu Q4 Preview (de Shengshu Technology) tiene dos líneas de producto en hiapi que no son intercambiables:
- reference-to-video (esta página): proporcionas un conjunto de imágenes de referencia (un personaje, un lugar, un producto, un objeto de utilería) y el modelo las combina en un plano en movimiento. El campo es
reference_image_urlsy acepta de 1 a 15 imágenes. - image-to-video (fórmulas aquí): proporcionas un único fotograma inicial (
image_url) y anima ese fotograma hacia delante. Rechaza por completoreference_image_urls.
Así que elige referencia a video cuando quieras combinar sujetos independientes en una escena, y elige imagen a video cuando ya tengas el fotograma inicial exacto y solo quieras movimiento. Si has usado la página de la serie de referencia de Vidu Q3, el salto aquí es concreto: Q4 Preview añade salida en 4K (Q3 llegaba como máximo a 1080p) y eleva el presupuesto de referencias a 1–15 imágenes (Q3 Mix permitía de 1 a 7). Ambas generaciones aceptan referencias de audio; estas fórmulas se centran en aprovechar el mayor presupuesto de imágenes y el 4K de Q4.
Esquema de entrada verificado (probado contra /v1/tasks en octubre de 2026):
| Campo | Obligatorio | Valores |
|---|---|---|
prompt |
Sí | Texto libre; indica los sujetos de referencia por su número |
reference_image_urls |
Sí | Array, 1–15 URLs públicas de imágenes |
reference_audio_urls |
No | Array, como máximo 3 URLs de audio (referencia de voz/efectos de sonido) |
resolution |
No | 540p · 720p · 1080p · 2k · 4k |
duration |
No | Entero, 3–16 segundos |
aspect_ratio |
No | 16:9 · 9:16 · 1:1 · 4:3 · 3:4 |
El precio es una tarifa fija por segundo según la resolución (así que un clip de 5 segundos es el precio por segundo × 5). A octubre de 2026, en hiapi: 540p $0.0515/s, 720p $0.109/s, 1080p $0.1375/s, 2K $0.2175/s, 4K $0.446/s. Consulta las cifras completas en la página de precios. La conclusión práctica es: itera el prompt en 720p y luego vuelve a ejecutar en 4K la versión que te convenza; el prompt no cambia en absoluto, solo cambia el multiplicador.
Cómo generamos estos resultados (para que puedas reproducirlos)
Cada clip de abajo se generó en hiapi a través de la API de tareas asíncrona. El flujo es siempre el mismo:
- Las imágenes de referencia deben ser accesibles públicamente. Generamos nuestras propias imágenes con
gpt-image-2/text-to-image, las subimos a un bucket estático y pasamos esas URLs; tú puedes usar cualquier imagen ya alojada. - Haz
POST /v1/taskscon el cuerpo de solicitud que se indica en cada fórmula. - Haz polling a
GET /v1/tasks/{taskId}hasta questatusseasuccessy luego descargaoutput[0].url(es un enlace temporal; guárdalo de inmediato).
La documentación de inicio rápido está en docs de hiapi. Una solicitud mínima tiene este aspecto:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q4-preview/reference-to-video",
    "input": {
      "prompt": "...",
      "reference_image_urls": ["https://.../subject.jpg"],
      "resolution": "1080p",
      "duration": 5,
      "aspect_ratio": "16:9"
    }
  }'
Aquí están las fórmulas.
Fórmula 1 — Inicio rápido con una sola referencia
Ideal para: la referencia a video más sencilla: un sujeto, una animación limpia. Empieza por aquí antes de pasar a la fusión.
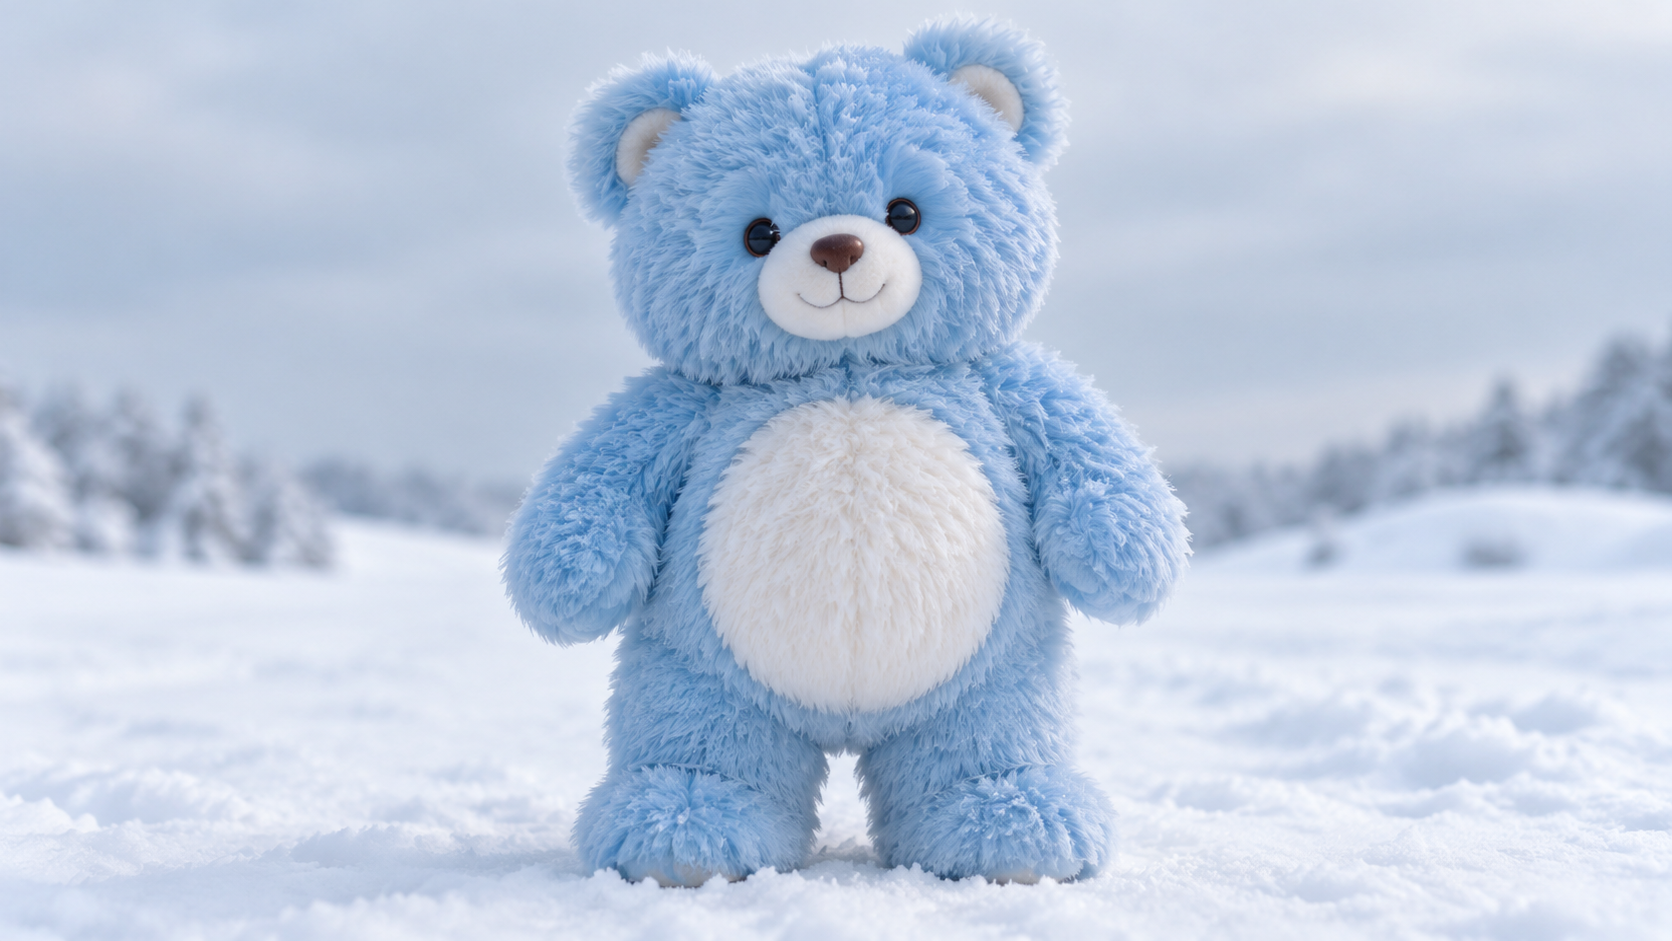
Imagen de referencia de entrada:
Resultado real (720p, 3 segundos):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "El osito de felpa azul y esponjoso de la imagen de referencia 1 da dos pasos lentos hacia delante en la nieve, luego levanta la cabeza para mirar a la cámara y agita una pata. Nieve suave cayendo, iluminación cinematográfica suave.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/smoke_bear.jpg"],
    "resolution": "720p",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
Por qué funciona: incluso con una sola imagen, nombrarla («el osito de felpa azul y esponjoso de la imagen de referencia 1») ancla el sujeto para que el modelo anime a ese osito en lugar de inventarse uno nuevo. Una acción breve y concreta («da dos pasos... agita una pata») se renderiza de forma más limpia en 3 segundos que un vago «haz que se mueva». Fíjate en que, aunque no adjuntamos ningún audio de referencia, el clip volvió con una pista de ambiente.
Fórmula 2 — 4K cinematográfico, fusión de personaje + escena
Ideal para: tu plano principal. Dos referencias (un sujeto y un entorno) se fusionan en un plano atmosférico que termina en 4K.
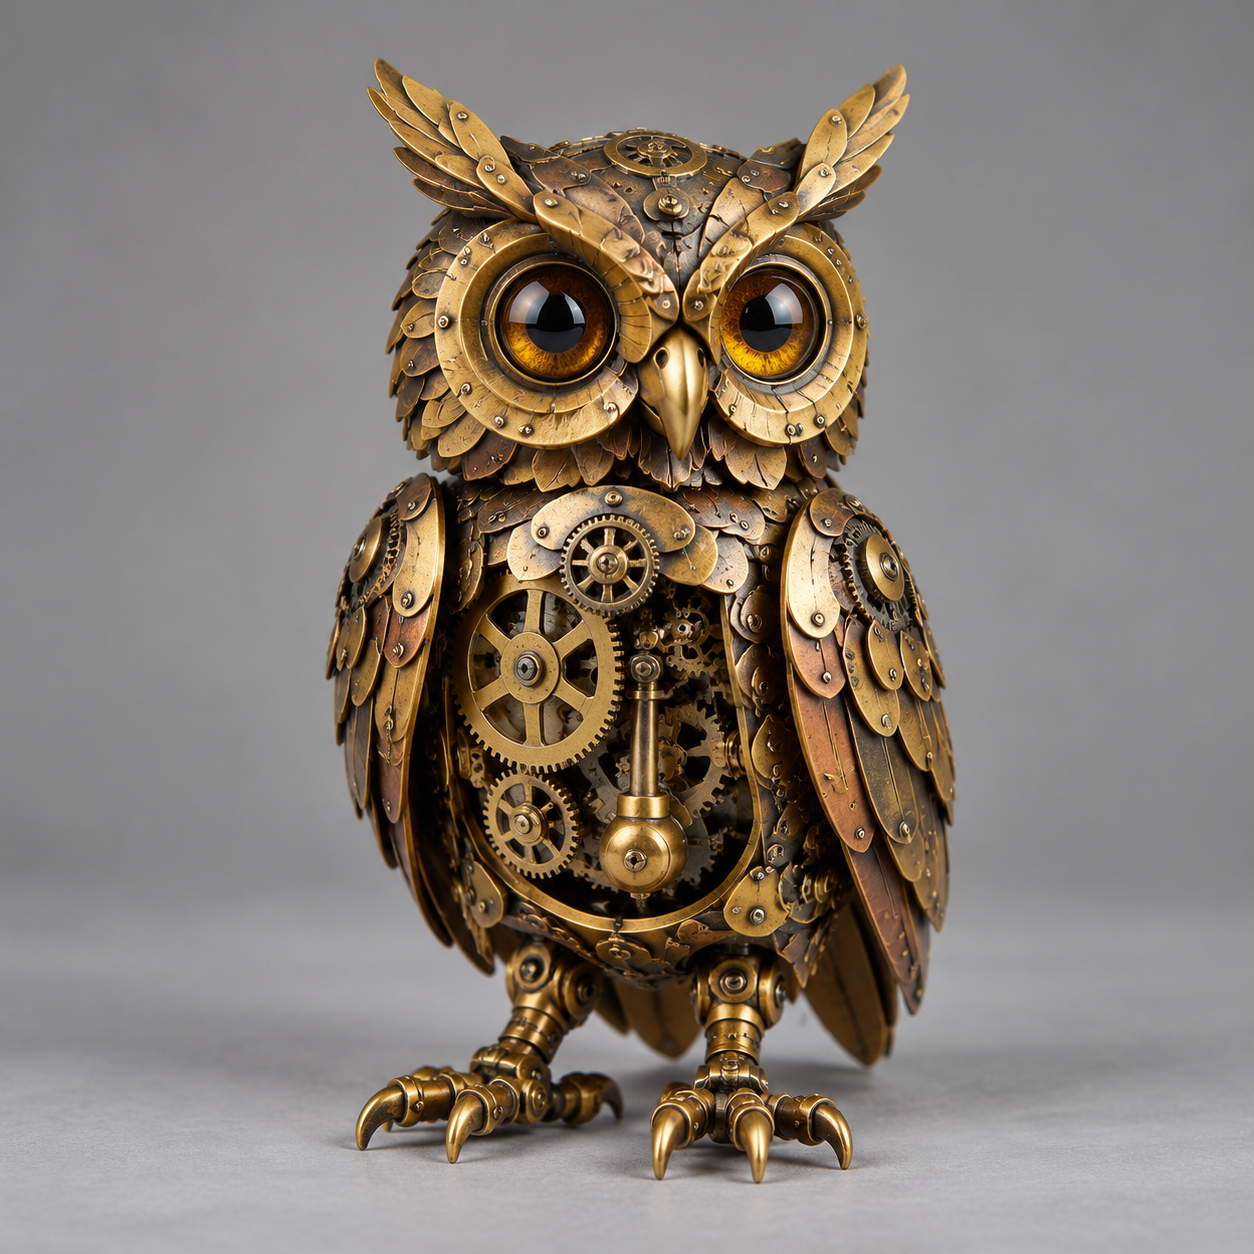
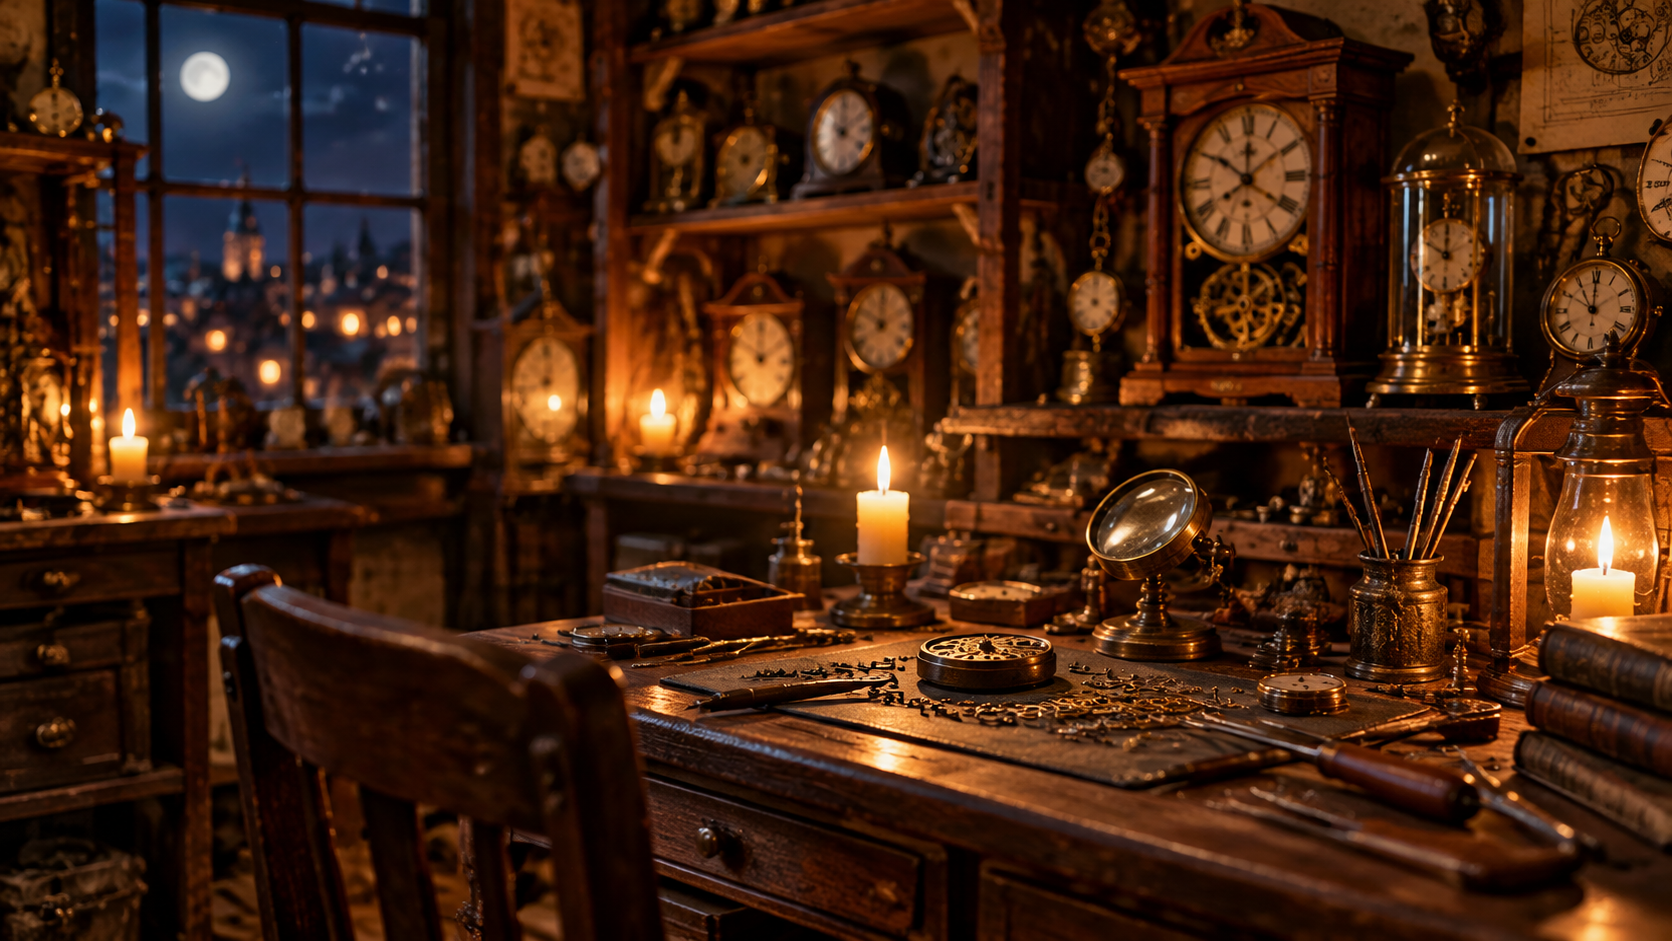
Referencias de entrada (sujeto + lugar):
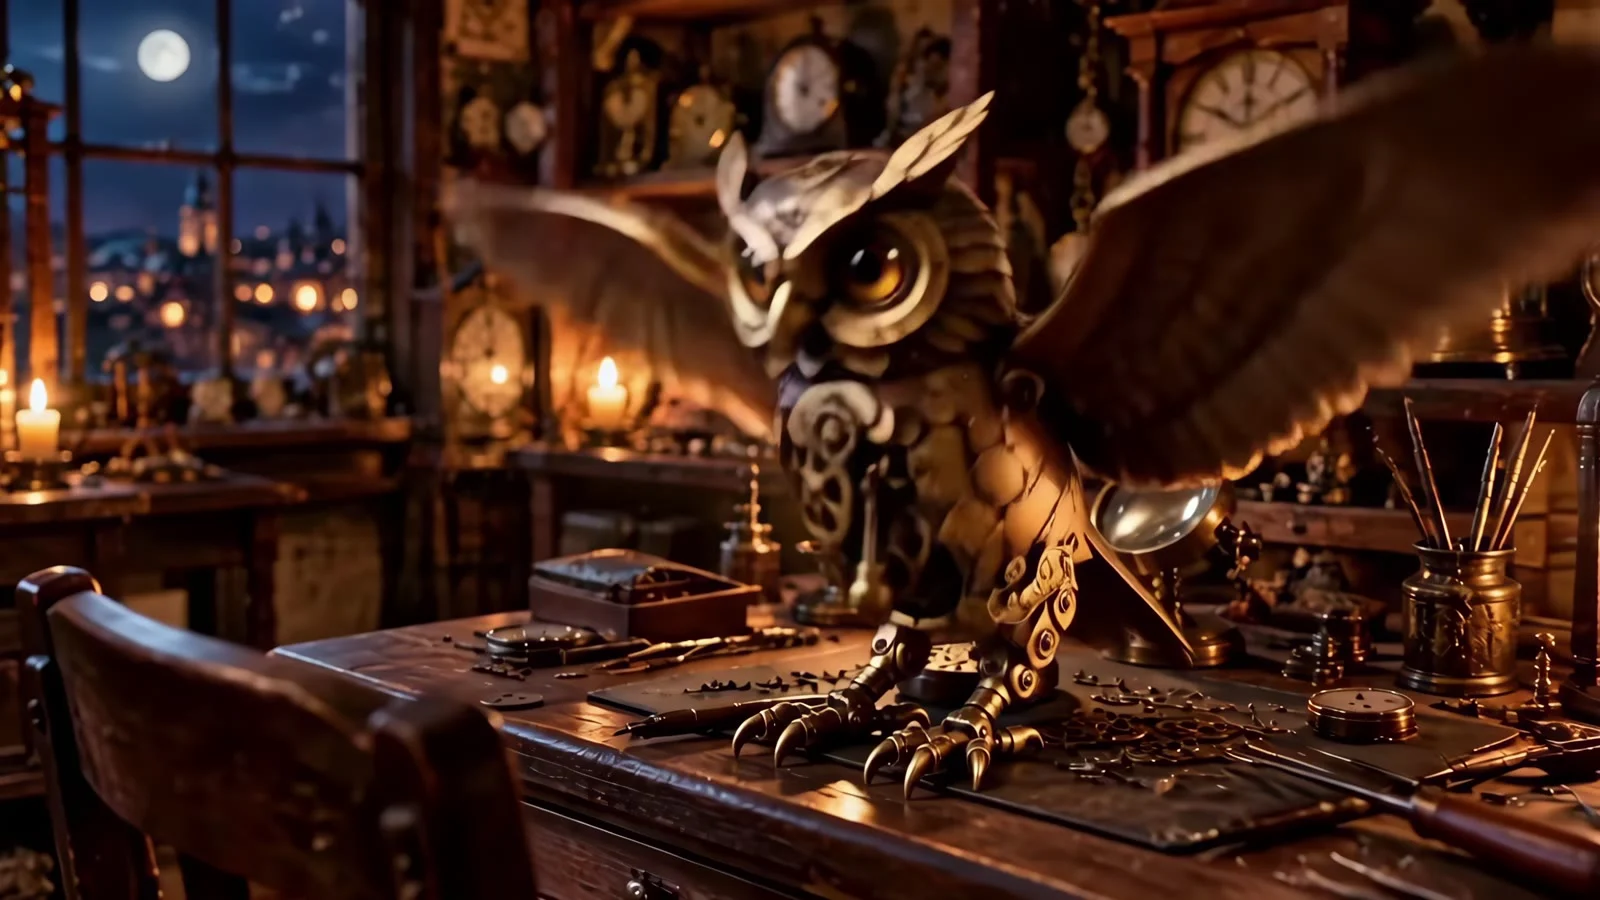
Resultado real (4K, 3 segundos):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "El búho de latón con cuerda de la imagen de referencia 1 entra volando en el taller con velas parpadeantes de la imagen de referencia 2, con las alas zumbando y los engranajes visibles, y luego se posa suavemente sobre el banco de madera. Gira lentamente la cabeza hacia la cámara y parpadea una vez. Luz cálida y ámbar de las velas parpadeando, partículas de polvo flotando, cinematográfico con poca profundidad de campo.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/owl_char.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/clock_workshop.jpg"],
    "resolution": "4k",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
Por qué funciona: el prompt asigna un rol a cada referencia: la imagen 1 es el actor y la imagen 2 es el decorado, así el modelo sabe qué imagen fija es el sujeto y cuál el fondo. La dirección del plano es una idea continua (entrar volando → posarse → girarse hacia la cámara) que la referencia a video renderiza como un plano ininterrumpido. A $0.446/s, este clip de 3 segundos en 4K cuesta unos $1.34; primero validamos la composición en 720p.
Fórmula 3 — Referencia de voz (un presentador que habla)
Ideal para: un personaje que habla con una voz concreta. Adjuntas un audio como reference_audio_urls; el audio define el timbre y el prompt define el diálogo y la sincronización labial.
Imagen de referencia de entrada:
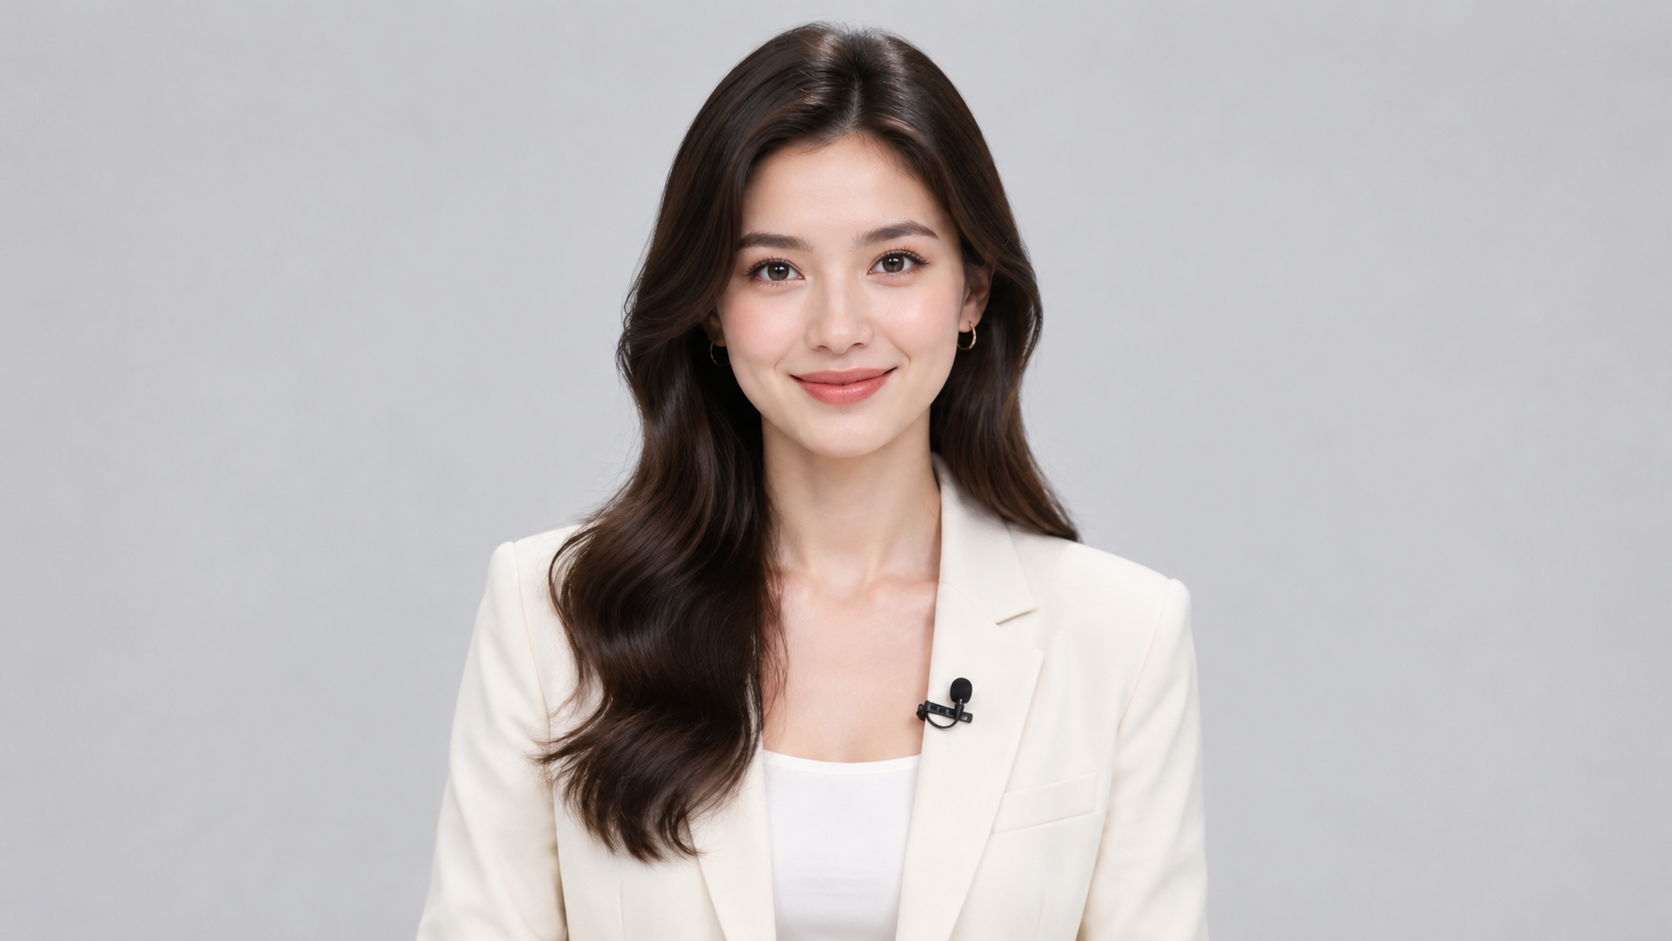
Audio de referencia de entrada: presenter_voice.mp3 (generamos esta línea con qwen-audio-3.0-tts-plus; sirve cualquier URL de audio ya alojada).
Resultado real (1080p, 5 segundos):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "El presentador de la imagen de referencia 1 mira directamente a cámara y dice esta línea con la voz del audio de referencia 1, con sincronización labial natural, un ligero balanceo de cabeza y una sonrisa cálida. Plano de estudio estable, iluminación suave, ligera sensación de respiración.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/presenter.jpg"],
    "reference_audio_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/audio/presenter_voice.mp3"],
    "resolution": "1080p",
    "duration": 5,
    "aspect_ratio": "16:9"
  }
}
Por qué funciona: la frase clave es «dice esta línea con la voz del audio de referencia 1». La referencia de audio aporta la voz; el prompt sigue llevando las indicaciones de actuación («sincronización labial natural», «sonrisa cálida»). Haz que la duración del clip de audio se acerque a tu duration para que la voz quepa dentro del plano. reference_audio_urls es un array: puedes pasar hasta tres clips para referenciar varias voces, o una voz más una capa de ambiente.
Fórmula 4 — Fusión de producto con tres referencias
Ideal para: composiciones de estilo comercial con imágenes fijas de productos independientes (un frasco, un objeto de utilería, una superficie) dispuestas en una escena.
Referencias de entrada (producto + utilería + escena):
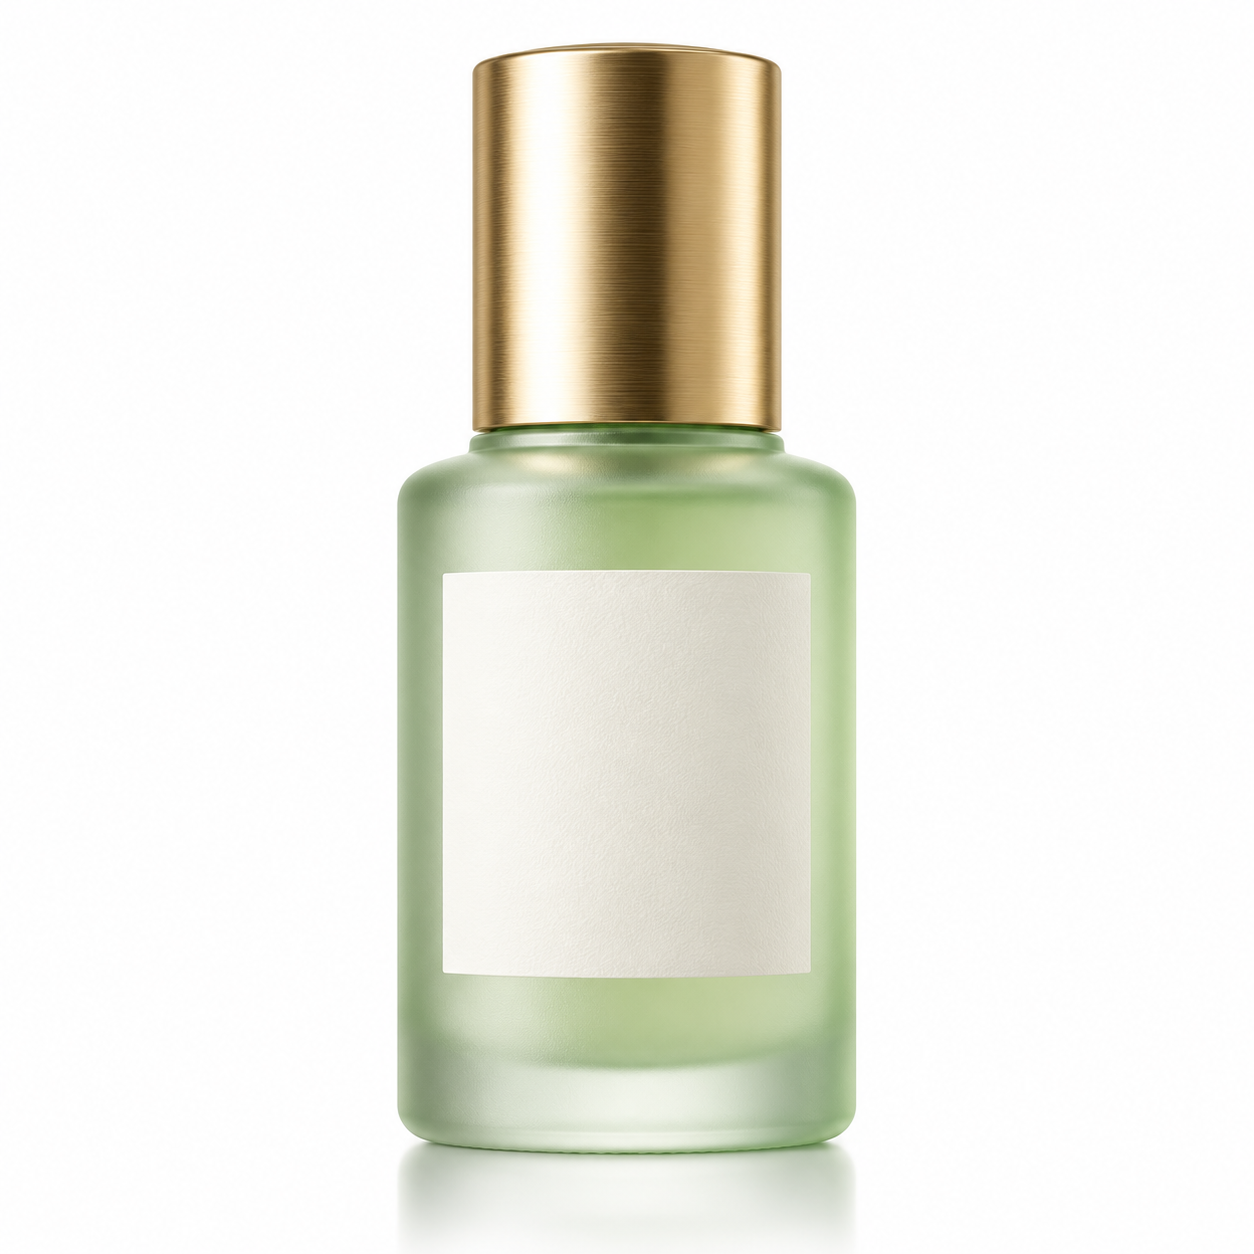
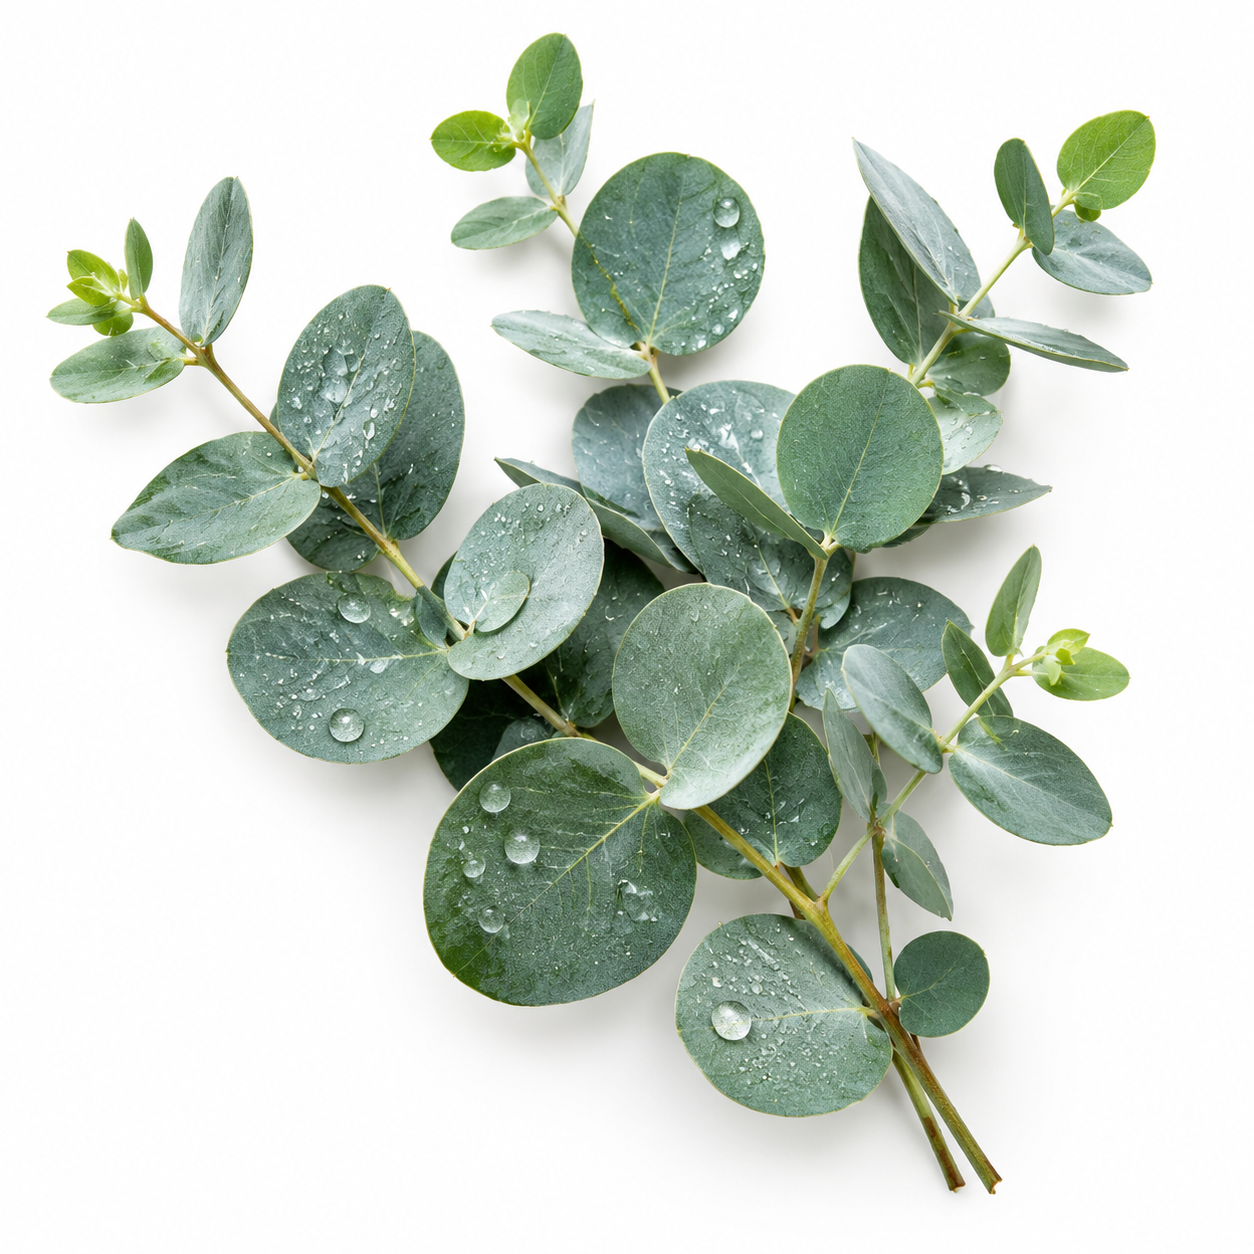
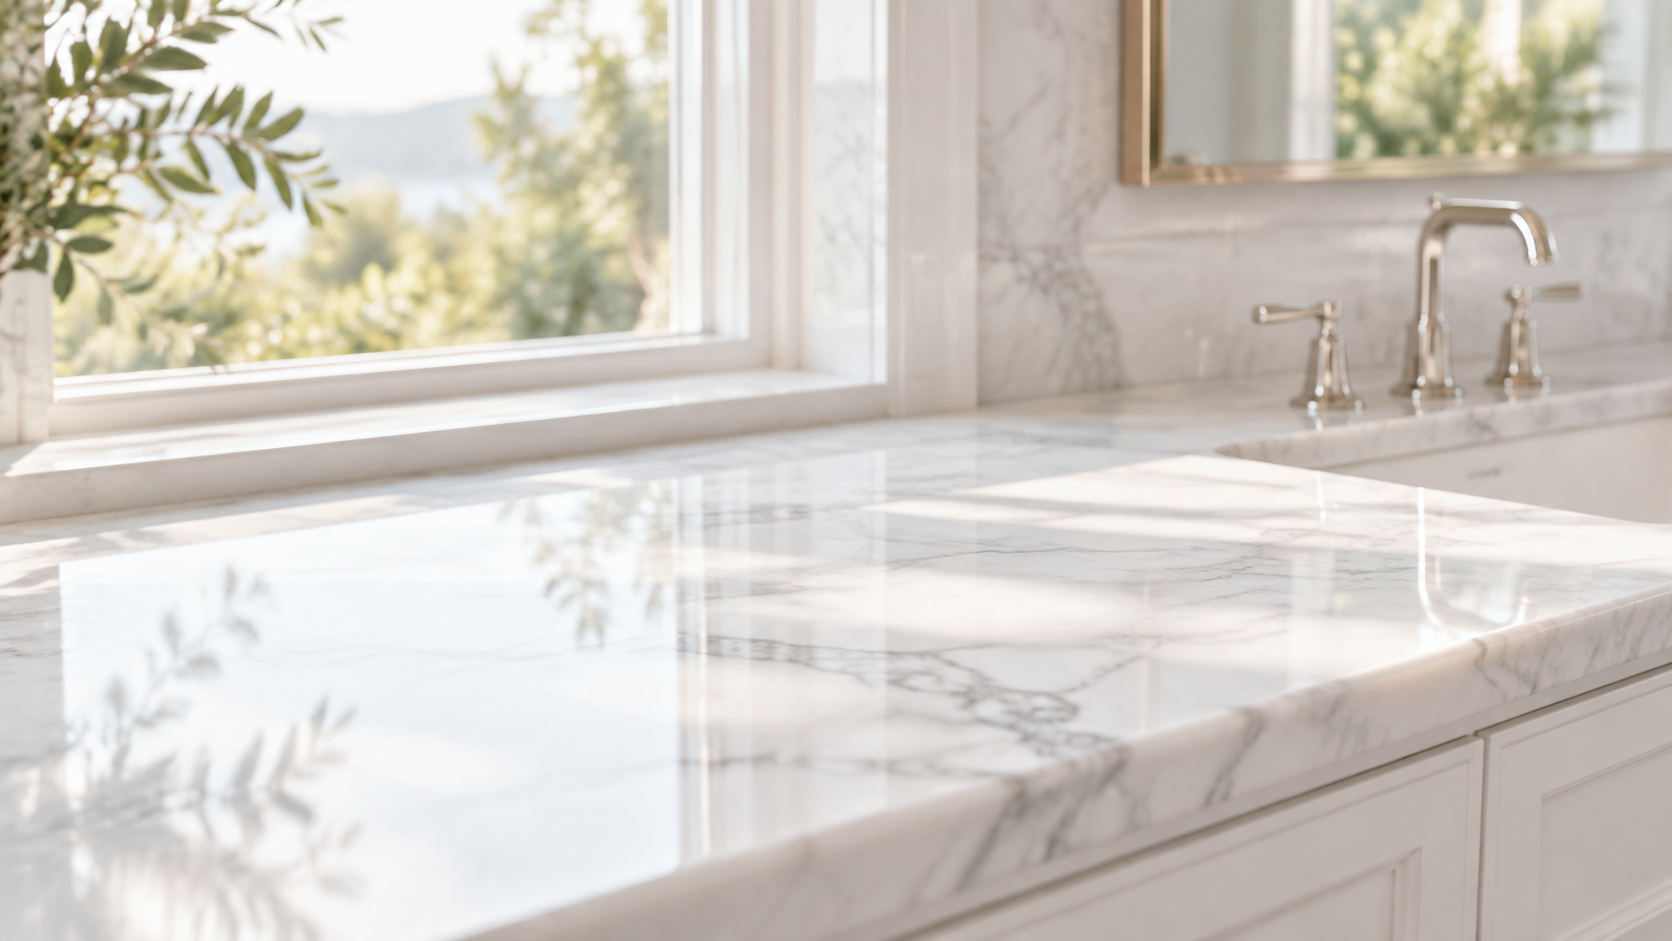
Resultado real (1080p, 4 segundos):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "Compón una escena: coloca el frasco de sérum mate de la imagen de referencia 1 en vertical sobre el tocador de mármol de la imagen de referencia 3, y apoya junto a él la rama de eucalipto de la imagen de referencia 2. Lento acercamiento cinematográfico, una gota de agua resbala por el frasco, luz suave de mañana, vapor tenue. Calidad de anuncio de cosmética premium.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/serum_bottle.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/eucalyptus.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/marble_vanity.jpg"],
    "resolution": "1080p",
    "duration": 4,
    "aspect_ratio": "16:9"
  }
}
Por qué funciona: tres imágenes fijas limpias e independientes (cada sujeto sobre un fondo liso) dan al modelo piezas inequívocas que ensamblar. El prompt especifica la disposición espacial («sobre el tocador», «junto a él») y se refiere a cada imagen con su número exacto. La fusión se desvía cuando las imágenes de referencia son desordenadas o cuando solo dices «combina esto» sin indicar al modelo dónde va cada cosa.
Fórmula 5 — Bucle vertical para redes sociales (9:16)
Ideal para: plataformas de vídeo corto. El mismo modelo, la misma disciplina de prompt, solo aspect_ratio: "9:16".
Imagen de referencia de entrada:
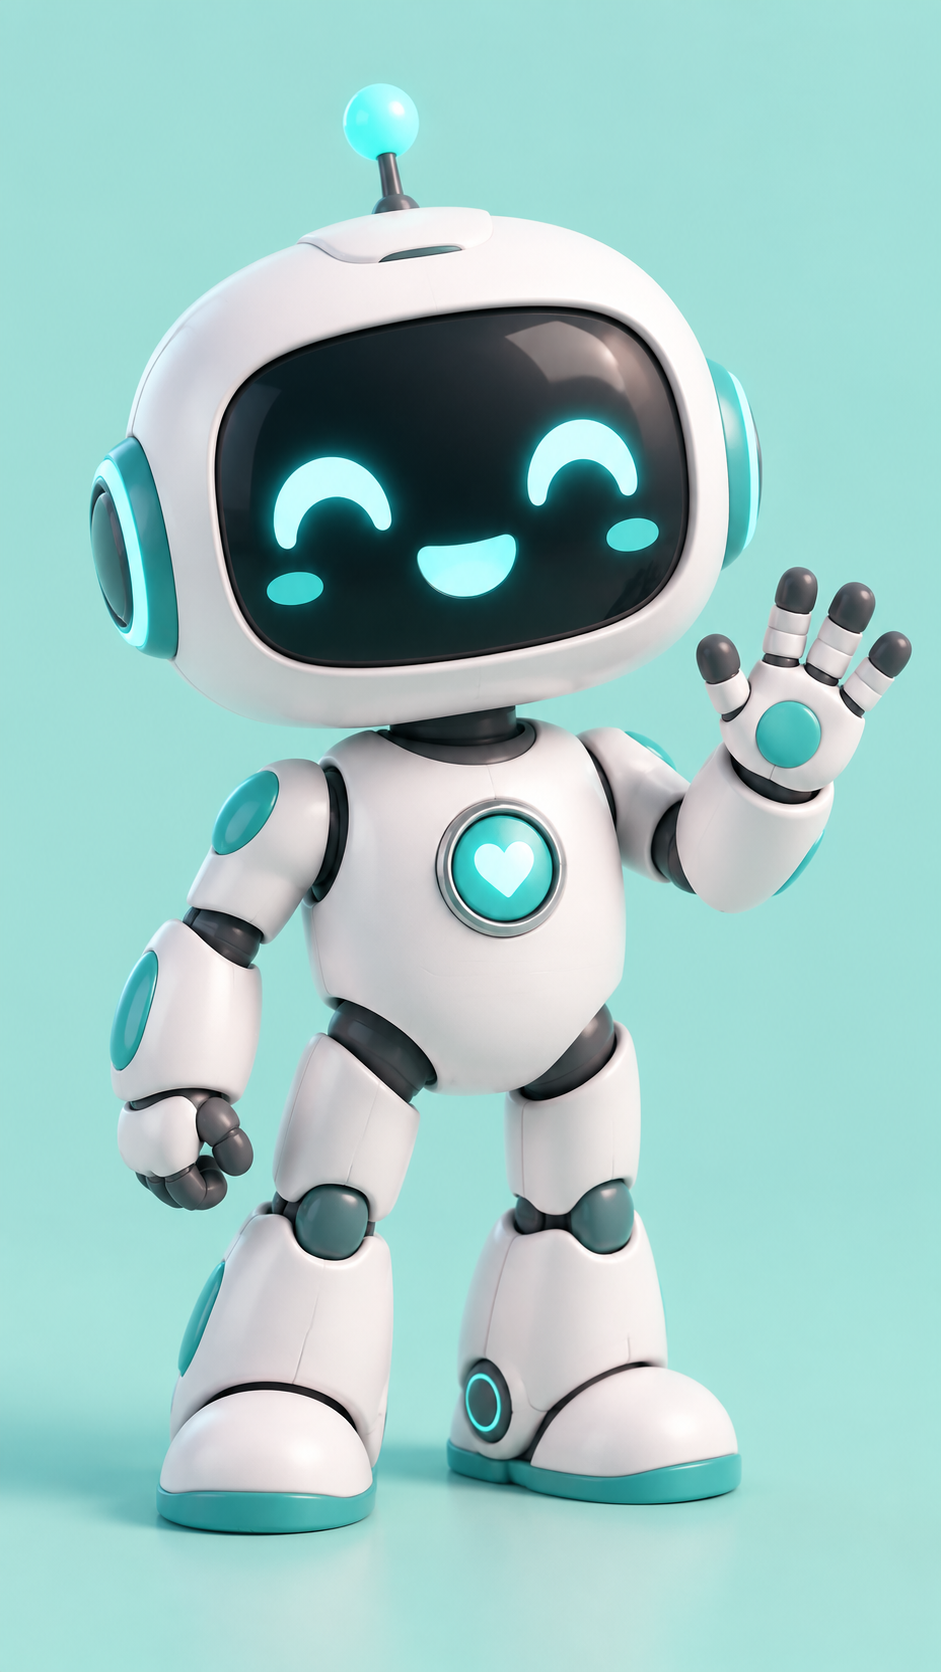
Resultado real (720p, 5 segundos, vertical):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "La mascota robot blanca y cian de la imagen de referencia 1 agita ambos brazos, da un pequeño salto alegre y termina levantando el pulgar hacia la cámara. Confeti de colores estalla, movimiento enérgico y saltarín, iluminación brillante y alegre, composición vertical para redes sociales.",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/robot_mascot.jpg"],
    "resolution": "720p",
    "duration": 5,
    "aspect_ratio": "9:16"
  }
}
Por qué funciona: aspect_ratio controla el encuadre de la salida, así que un clip vertical solo requiere 9:16; la imagen de referencia puede tener cualquier forma. Para un bucle de redes sociales, dale al personaje un pulso claro de inicio, nudo y desenlace (saludar → saltar → pulgar arriba) para que los 5 segundos se lean como un micro-momento completo y no como un fragmento.
Reglas de escritura de prompts que de verdad cambiaron el resultado
- Numera tus referencias. «El búho de la imagen de referencia 1», «la escena de la imagen de referencia 2». El modelo vincula el sujeto con el número; «combina estas imágenes» es justo la raíz de una fusión fallida.
- Dale un rol a cada referencia. Indica qué imagen fija es el actor, cuál el decorado y cuál el objeto de utilería. La vaguedad hace que el modelo adivine.
- Escribe el plano como una sola acción. La referencia a video es un único plano continuo de 3 a 16 segundos. Una idea de plano («acercarse», «entrar volando y posarse») supera a una lista de varios planos.
- Si usas voz, nombra el audio y mantén el diálogo. «Habla con la voz del audio de referencia 1» + la frase real en el prompt. Haz que la duración del audio coincida con
duration. - Itera barato, finaliza en 4K. La resolución es un multiplicador fijo por segundo que no toca tu prompt: valida el plano en 720p y luego vuelve a ejecutar en 4K la versión ganadora.
FAQ
¿Cuál es la diferencia entre referencia a video e imagen a video en Vidu Q4 Preview?
La referencia a video acepta un conjunto de imágenes (reference_image_urls, de 1 a 15) y las combina en un solo plano. La imagen a video acepta un único fotograma inicial (image_url) y lo anima; rechaza reference_image_urls. Para fusionar sujetos independientes, usa referencia a video; cuando ya tengas el fotograma inicial exacto, usa imagen a video.
¿Cómo añado una voz de referencia?
Pasa reference_audio_urls (un array de hasta tres URLs públicas de audio) e indica en el prompt «habla con la voz del audio de referencia 1». El audio define el timbre; el prompt define el diálogo y la sincronización labial.
¿Cuántas imágenes de referencia puedo usar? De 1 a 15. Para una animación sencilla basta con una; si quieres fusionar personaje, lugar y utilería en la misma escena, da más.
¿Qué resoluciones y duraciones se admiten?
Resoluciones 540p, 720p, 1080p, 2k, 4k; la duración es un entero de 3 a 16 segundos; relaciones de aspecto 16:9, 9:16, 1:1, 4:3, 3:4.
¿Cuánto cuesta un clip en 4K? El 4K cuesta $0.446 por segundo, así que un clip de 3 segundos en 4K cuesta unos $1.34 y uno de 5 segundos unos $2.23. Las resoluciones más bajas son mucho más baratas (720p cuesta $0.109 por segundo). Consulta las cifras actuales en la página de precios.
¿Las imágenes de referencia tienen que ser URLs públicas? Sí: el modelo las descarga, así que deben ser accesibles desde internet. Alójalas en cualquier lugar de acceso público y pasa la URL.
Conclusiones clave
- La referencia a video fusiona de 1 a 15 imágenes fijas en un plano de 3 a 16 segundos; la imagen a video anima un único fotograma inicial.
- Refiérete a cada referencia por su número y dale un rol: ese único hábito corrige la mayoría de las fusiones fallidas.
- La referencia de voz es
reference_audio_urls(hasta 3 clips); el audio define la voz y el prompt define el diálogo. - El 4K ($0.446 por segundo) es la insignia de Q4 Preview frente a Q3: úsalo para la versión final e itera en 720p.
- Copia cualquiera de las fórmulas de arriba, sustituye tus URLs de referencia y ejecútala.
¿Listo para probarlo? Abre la página del modelo vidu-q4-preview/reference-to-video, consigue una clave de API en la documentación y pega una fórmula. Si solo tienes un fotograma de anclaje en lugar de un conjunto de imágenes, empieza por la línea de imagen a video, o explora más flujos de trabajo de referencia a video y fórmulas de prompts en el blog de hiapi.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores