
使用ガイド
Vidu Q4 Preview 参照動画生成プロンプトレシピ:そのままコピーできるプロンプトと実際の出力
実戦で検証済みの参照動画生成プロンプト5選——複数画像の融合、音声参照、そして実際の4Kショット——それぞれに生成されたクリップを添えて。
TL;DR
- そのままコピーできる参照動画生成プロンプトのレシピ5選。vidu-q4-preview/reference-to-video 向けで、それぞれに hiapi 上で実際に生成されたクリップを添えています——ストック素材でもイメージ画像でもありません。
- 参照動画生成とは「複数の静止画像を1つのショットに融合する」モードです。1〜15枚の参照画像を渡し、さらに任意で最大3本の参照音声を提供すると、3〜16秒の単一ショットとして、最大4Kまでレンダリングします。
- 実際の4Kシネマティッククリップと、実用的な音声参照(「話す司会者」)の例を含み、正確な
reference_audio_urlsリクエストも示しています。 - 出力を実際に変えたプロンプトのルール:各参照を番号で指し示す、ショットを1つの連続した動作として書く、音声を付ける場合はプロンプトにセリフを残す。
- JSONをコピーし、自分の参照URLに差し替えて、
/v1/tasksに POST するだけです。
vidu-q4-preview/reference-to-video は一体何をするのか
Vidu Q4 Preview(生数科技製)は hiapi 上に2つの製品ラインがあり、互換性はありません:
- reference-to-video(本ページ):参照画像のセット——キャラクター、場所、製品、小道具——を提供すると、モデルがそれらを1つの動くショットに組み合わせます。フィールドは
reference_image_urlsで、1〜15枚の画像を受け付けます。 - image-to-video(レシピはこちら):単一の最初のフレーム(
image_url)を提供すると、そのフレームを前方にアニメーション化します。reference_image_urlsは完全に拒否します。
つまり、互いに独立した被写体を1つのシーンに組み合わせたい場合は参照動画生成を、正確な開始フレームがすでにあって動きだけが欲しい場合は画像からの動画生成を選びます。Vidu Q3 の参照シリーズページを使ったことがあるなら、ここでの進化は具体的です:Q4 Preview は4K出力を追加し(Q3は最大1080p)、参照の予算を1〜15枚に引き上げました(Q3 Mix は1〜7枚)。両世代とも音声参照を受け付けますが、これらのレシピは Q4 のより大きな画像予算と4Kを活用することに重点を置いています。
検証済みの入力スキーマ(2026年10月に /v1/tasks に対して実測):
| フィールド | 必須 | 値 |
|---|---|---|
prompt |
はい | 自由テキスト。参照被写体を番号で指し示す |
reference_image_urls |
はい | 配列、1〜15個の公開画像URL |
reference_audio_urls |
いいえ | 配列、最大3個の音声URL(声/効果音の参照) |
resolution |
いいえ | 540p · 720p · 1080p · 2k · 4k |
duration |
いいえ | 整数、3〜16秒 |
aspect_ratio |
いいえ | 16:9 · 9:16 · 1:1 · 4:3 · 3:4 |
料金は解像度ごとに設定された固定の秒単価です(つまり5秒クリップは秒単価 × 5)。2026年10月時点の hiapi では:540p $0.0515/秒、720p $0.109/秒、1080p $0.1375/秒、2K $0.2175/秒、4K $0.446/秒。詳細な数字は料金ページをご覧ください。実用的な結論は:720pでプロンプトを反復し、満足したものを4Kで再実行する——プロンプト自体は何も変わらず、倍率だけが変わります。
これらの結果をどうやって出したか(再現できるように)
以下の各クリップは hiapi 上の非同期タスクAPIを通じて生成しました。流れは常に同じです:
- 参照画像は公衆からアクセス可能でなければなりません。私たちは
gpt-image-2/text-to-imageで自分の画像を生成し、静的ストレージバケットにアップロードして、そのURLを渡しました——ホスト済みの画像なら何でも使えます。 - 各レシピに記載されたリクエストボディで
POST /v1/tasksします。 GET /v1/tasks/{taskId}をstatusがsuccessになるまでポーリングし、output[0].urlをダウンロードします(これは期限付きリンクです——すぐ保存してください)。
クイックスタートのドキュメントはhiapi ドキュメントをご覧ください。最小のリクエストは次のようになります:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q4-preview/reference-to-video",
    "input": {
      "prompt": "...",
      "reference_image_urls": ["https://.../subject.jpg"],
      "resolution": "1080p",
      "duration": 5,
      "aspect_ratio": "16:9"
    }
  }'
以下がレシピです。
レシピ 1 —— 単一参照のクイックスタート
最適な用途:最もシンプルな参照動画生成——1つの被写体、1つのクリーンなアニメーション。融合を始める前にここから入りましょう。
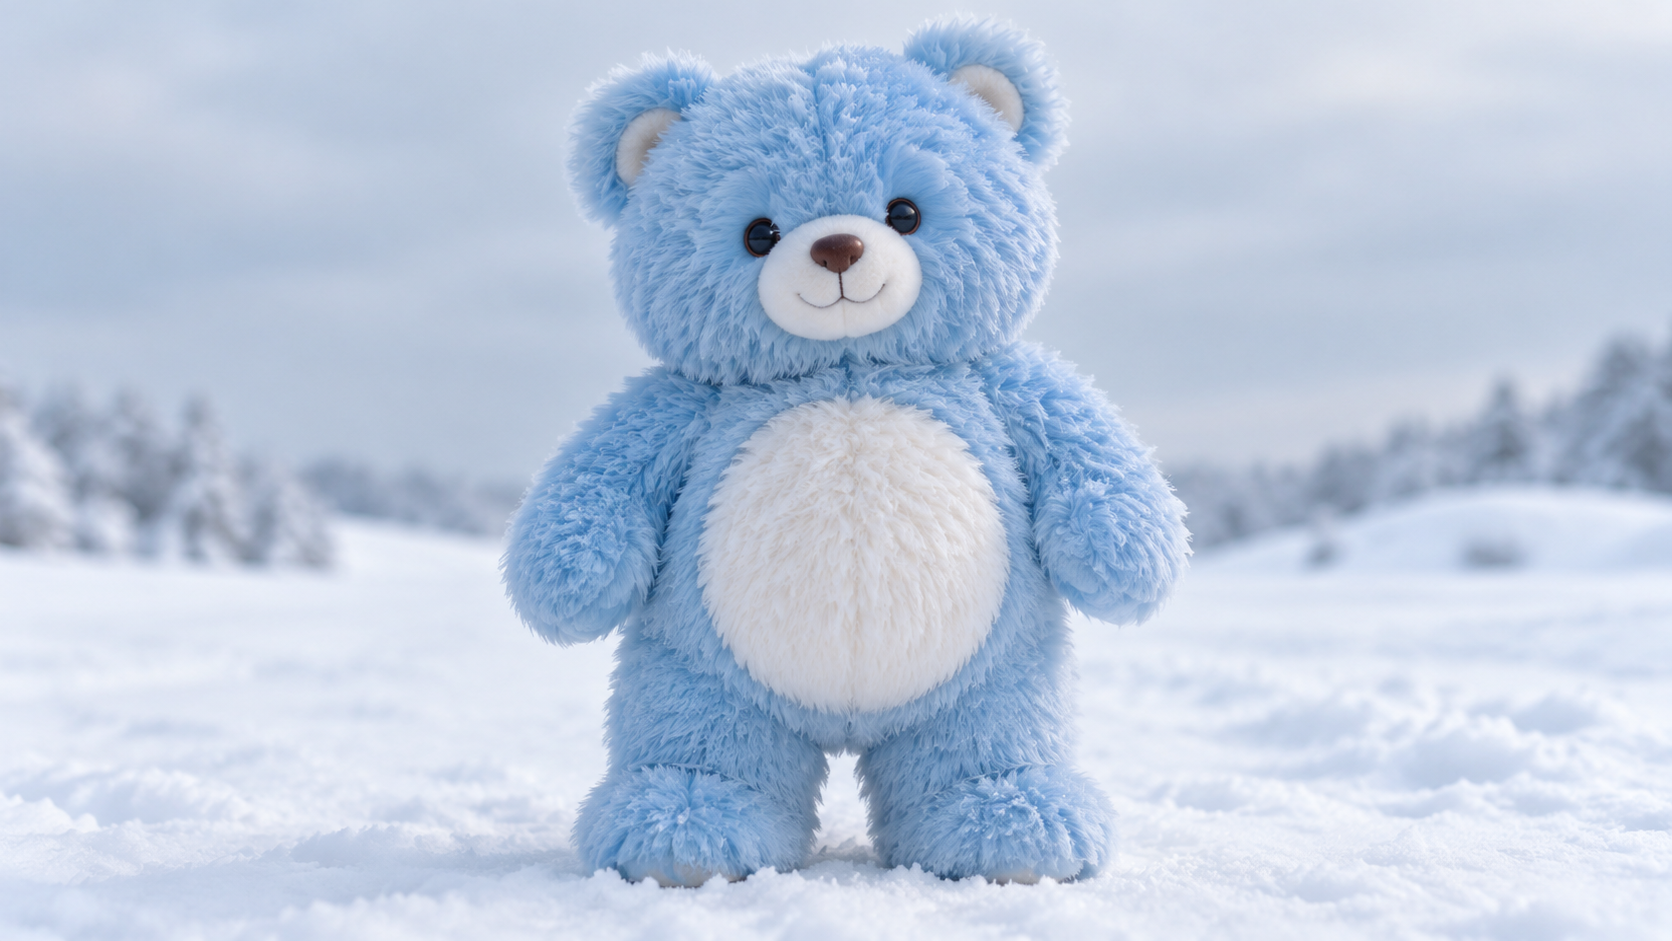
入力参照画像:
実際の出力(720p、3秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参照画像1のもふもふした青いクマが雪の中を前方にゆっくり2歩歩き、それからカメラを見上げて片方の前足を振る。静かに降る雪、映画のような柔らかな光。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/smoke_bear.jpg"],
    "resolution": "720p",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
なぜ効果的か:たとえ1枚の画像でも、それを名指しする(「参照画像1のもふもふした青いクマ」)ことで被写体が固定され、モデルはそのクマをアニメーション化し、勝手に新しいクマを作りません。短く具体的な動作(「2歩歩く……片方の前足を振る」)は、曖昧な「動かして」よりも3秒間でクリーンにレンダリングされやすいです。なお、参照音声を一切添付していないのに、クリップには環境音トラックが付いて戻ってきたことに注目してください。
レシピ 2 —— シネマティック4K、キャラクター + シーンの融合
最適な用途:あなたのヒーローショット。2つの参照——1つの被写体と1つの環境——が雰囲気のあるショットに融合し、4Kで仕上げます。
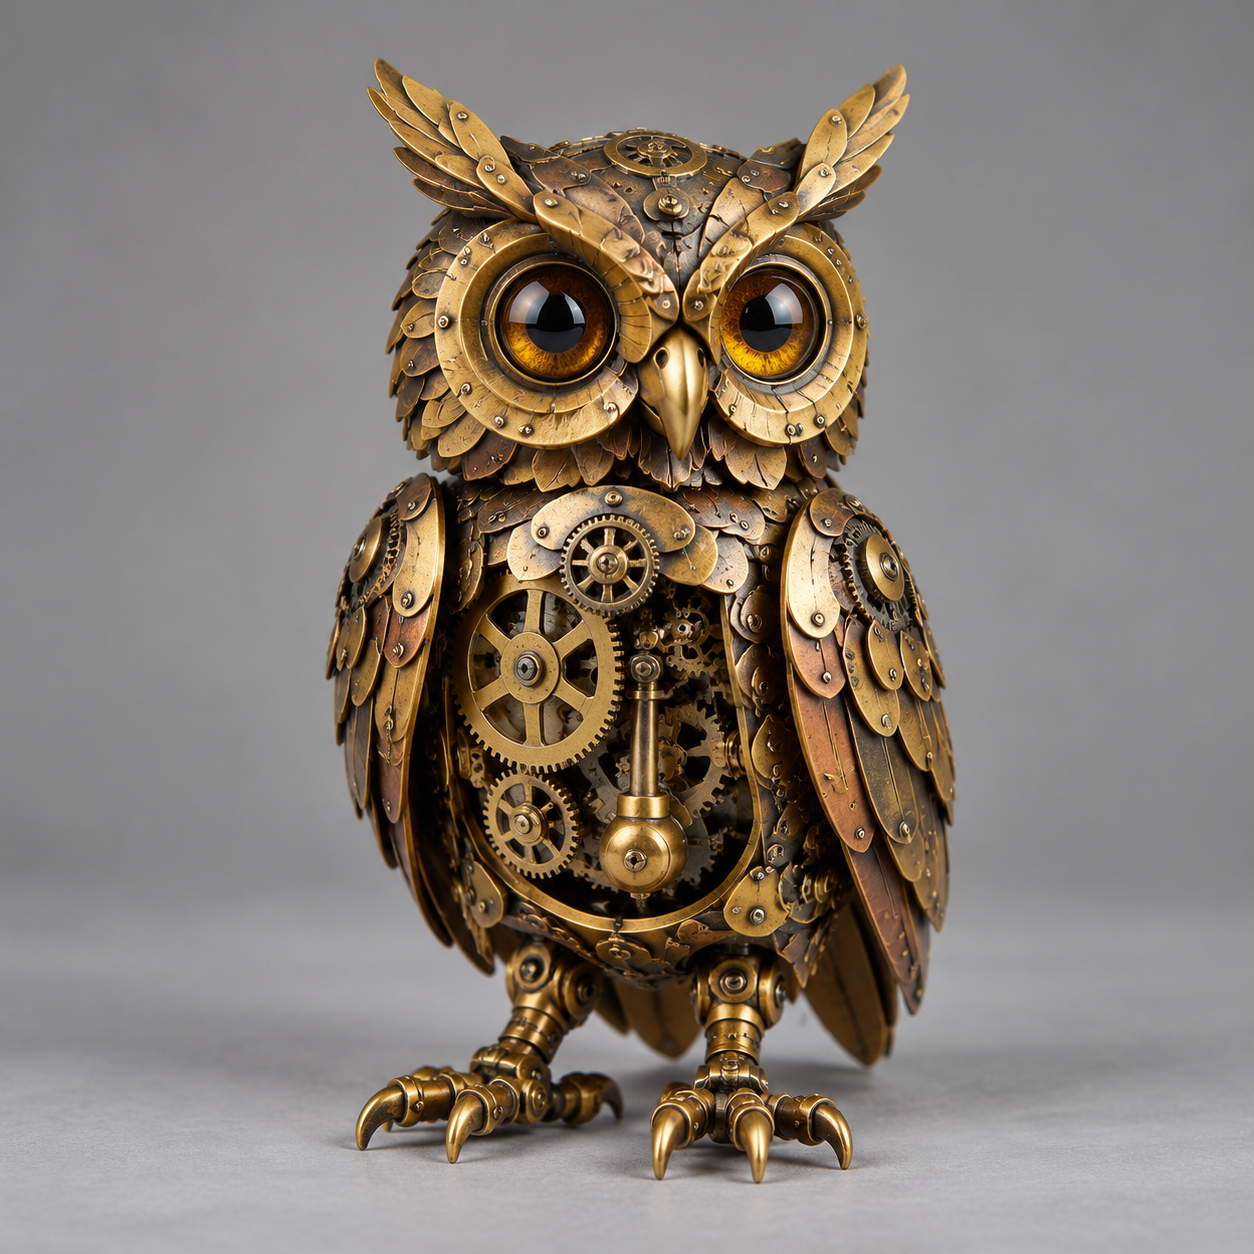
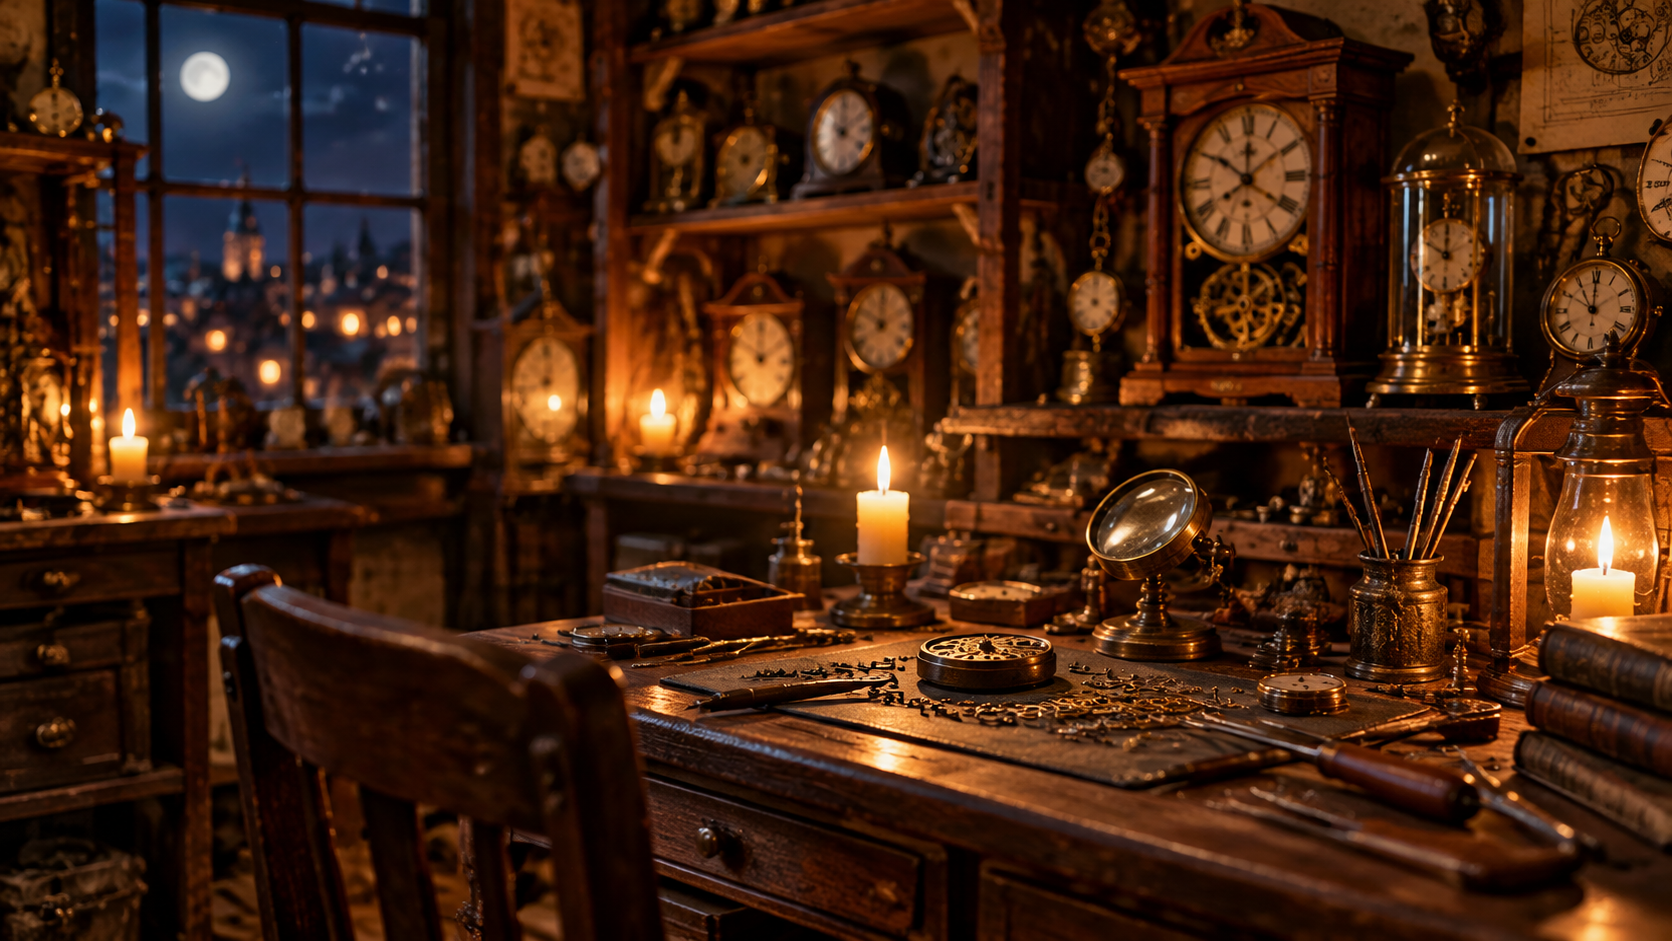
入力参照(被写体 + 場所):
実際の出力(4K、3秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
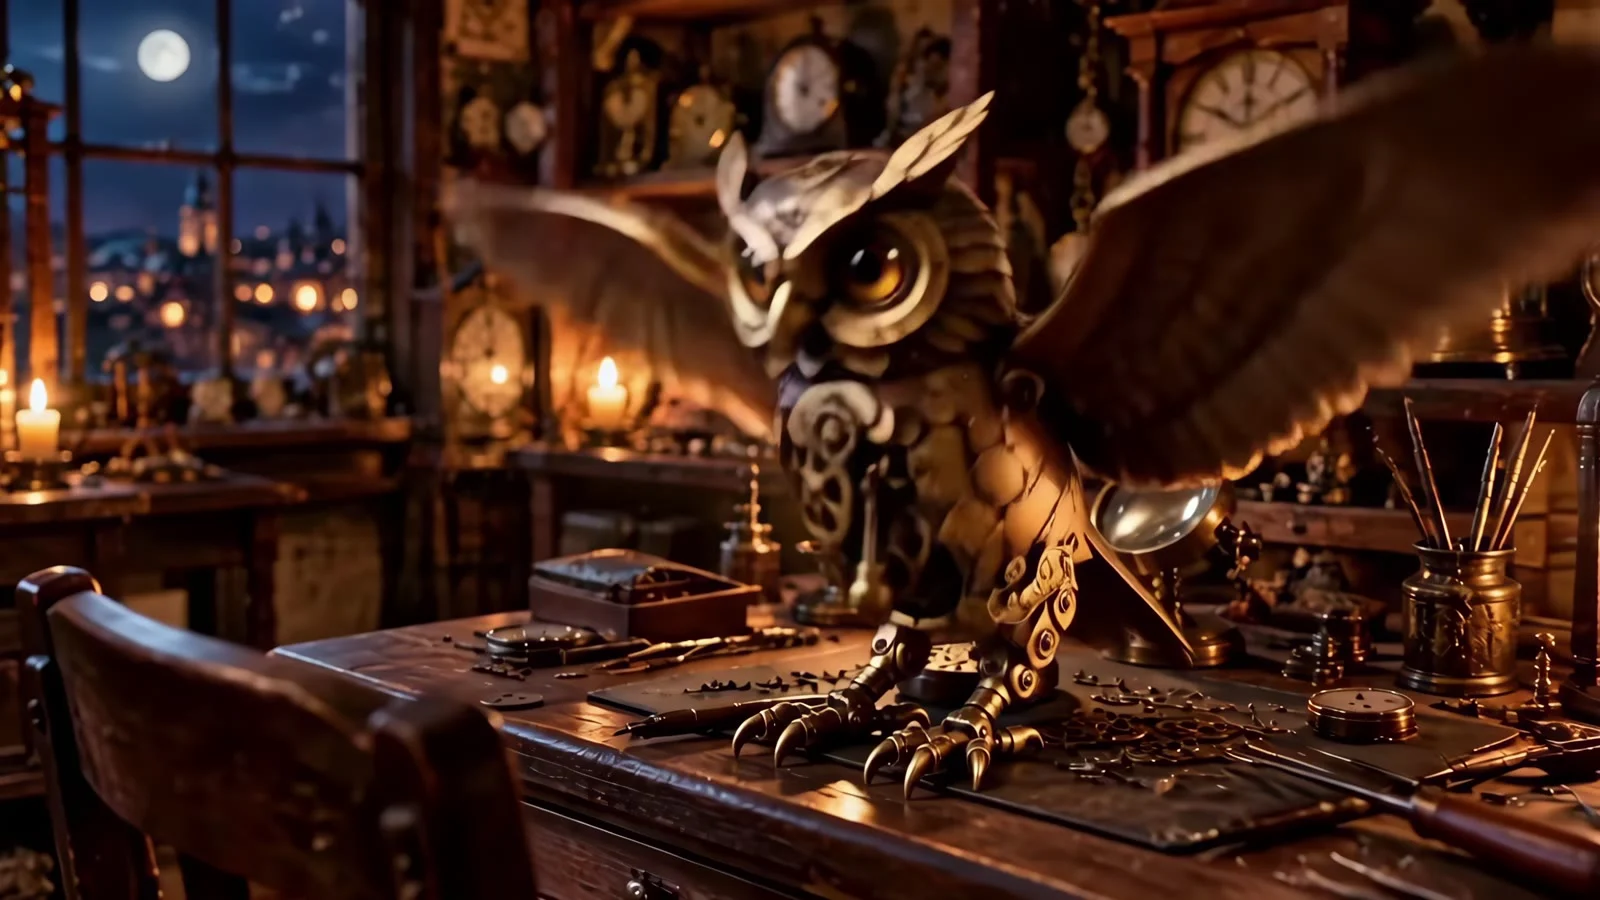
    "prompt": "参照画像1の真鍮製のぜんまい仕掛けのフクロウが、参照画像2のろうそくの揺れる工房に飛び込み、羽音を響かせ、歯車が見えたまま、そっと木製の作業台に着地する。ゆっくりと頭をカメラに向けて一度まばたきする。温かな琥珀色のろうそくの光が揺らめき、塵の粒子が漂い、浅い被写界深度の映画的な質感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/owl_char.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/clock_workshop.jpg"],
    "resolution": "4k",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
なぜ効果的か:プロンプトは各参照に役割を割り当てています——画像1は俳優、画像2はセット——これによりモデルはどの静止画像が被写体で、どれが背景かを理解します。カメラの動きは1つの連続した構想(飛び込む → 着地する → カメラの方を向く)で、参照動画生成はそれを途切れない1つのショットとしてレンダリングします。$0.446/秒で、この3秒の4Kクリップは約$1.34かかります。私たちはまず720pで構図を検証しました。
レシピ 3 —— 音声参照(話す司会者)
最適な用途:特定の声で話すキャラクター。音声を reference_audio_urls として添付します。音声が声質を、プロンプトがセリフとリップシンクを設定します。
入力参照画像:
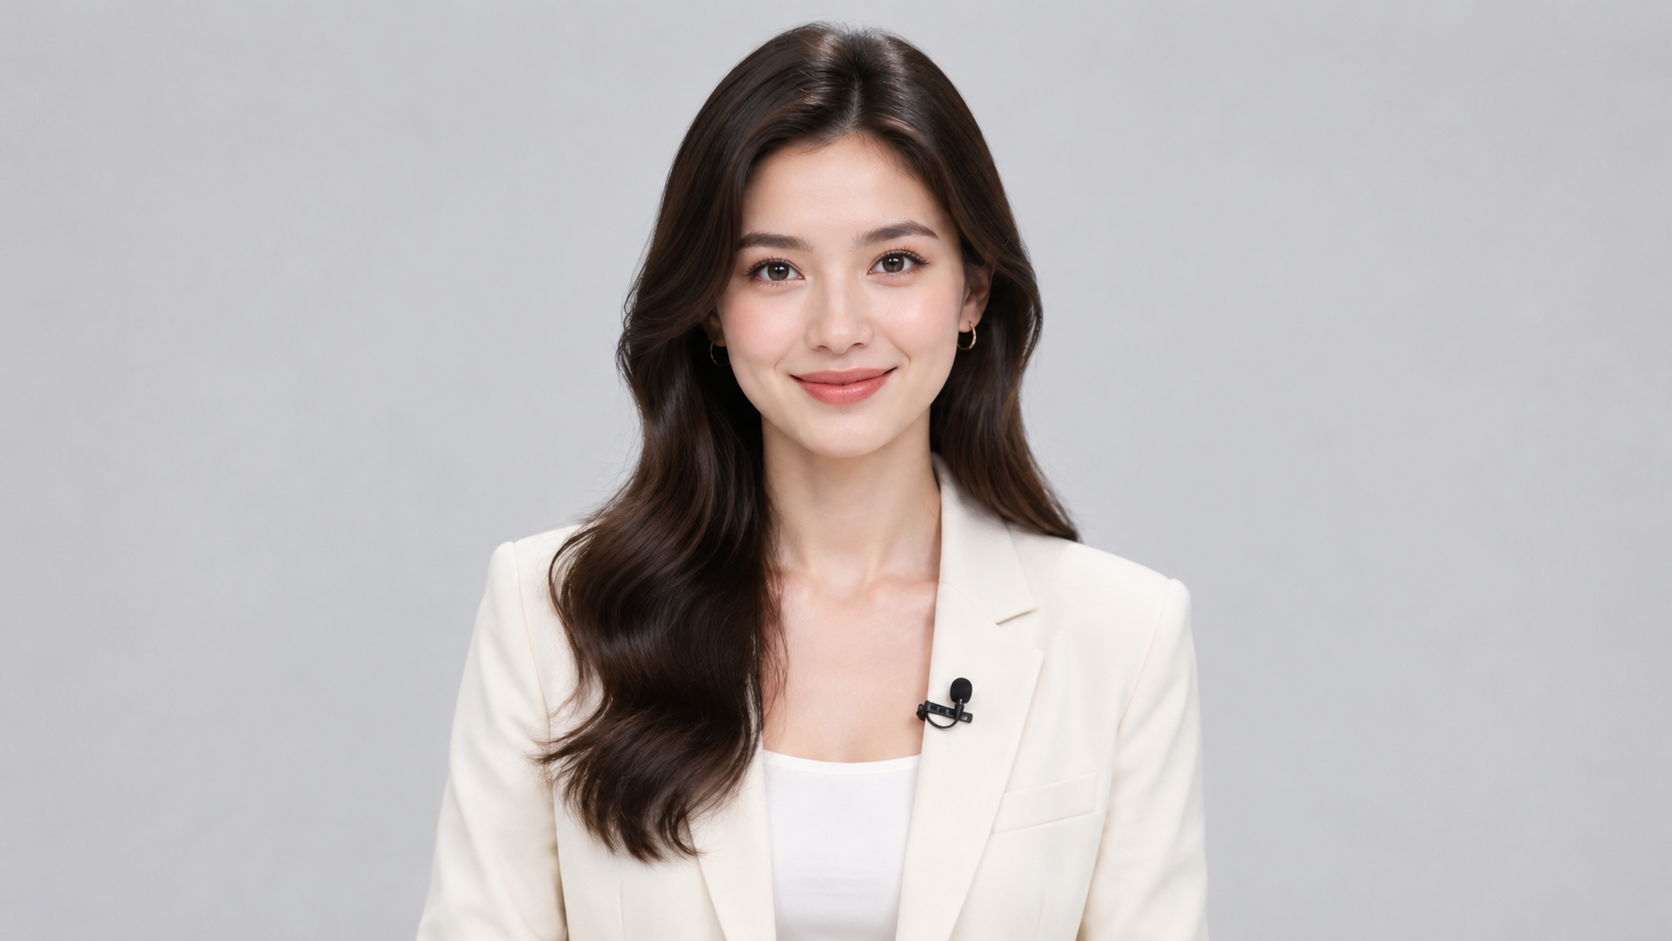
入力参照音声:presenter_voice.mp3(このセリフは qwen-audio-3.0-tts-plus で生成しました。ホスト済みの音声URLなら何でも使えます)。
実際の出力(1080p、5秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参照画像1の司会者がカメラをまっすぐ見て、参照音声1の声でこのセリフを話し、口の動きが自然に同期し、頭が小さく揺れ、温かな笑顔。安定したスタジオのカメラワーク、柔らかな照明、わずかな呼吸感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/presenter.jpg"],
    "reference_audio_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/audio/presenter_voice.mp3"],
    "resolution": "1080p",
    "duration": 5,
    "aspect_ratio": "16:9"
  }
}
なぜ効果的か:キーとなるフレーズは「参照音声1の声でこのセリフを話す」です。音声参照が声を駆動し、プロンプトは依然として演技の指示(「自然なリップシンク」「温かな笑顔」)を担います。音声クリップの長さをdurationに近づけて、音声がショット内に収まるようにしてください。reference_audio_urls は配列です——最大3本のクリップを渡して、複数の声、または1つの声に環境音のレイヤーを加えることができます。
レシピ 4 —— 3参照の製品融合
最適な用途:互いに独立した製品の静止画像を使ったコマーシャル風の構図——ボトル、小道具、カウンター——を1つのシーンに配置します。
入力参照(製品 + 小道具 + シーン):
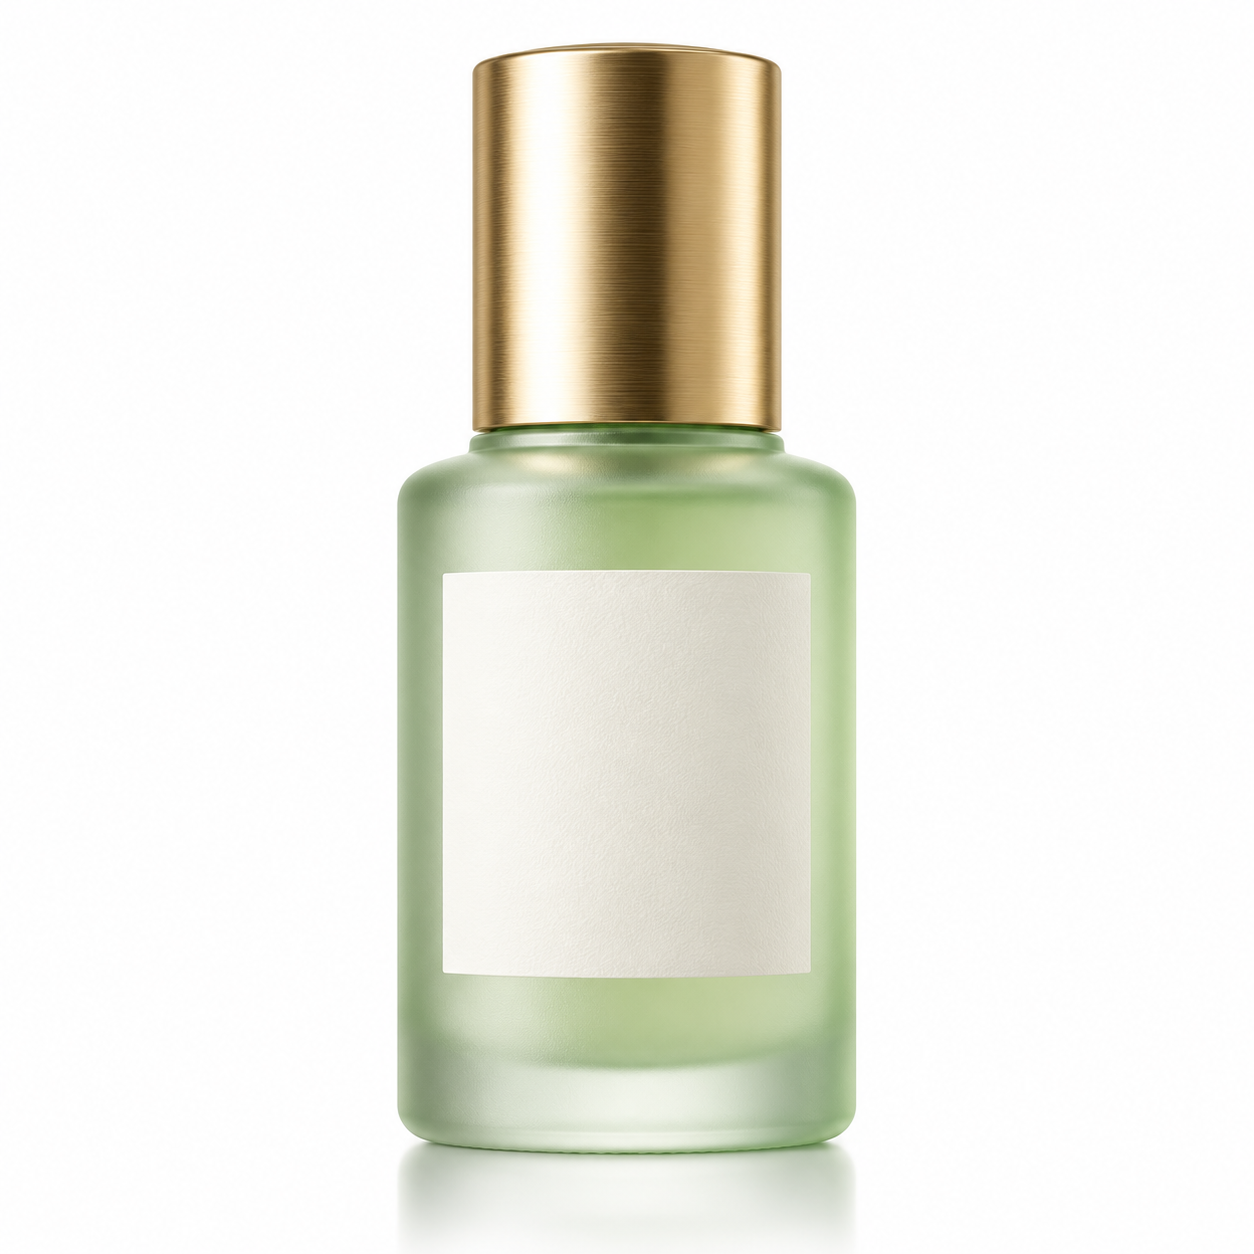
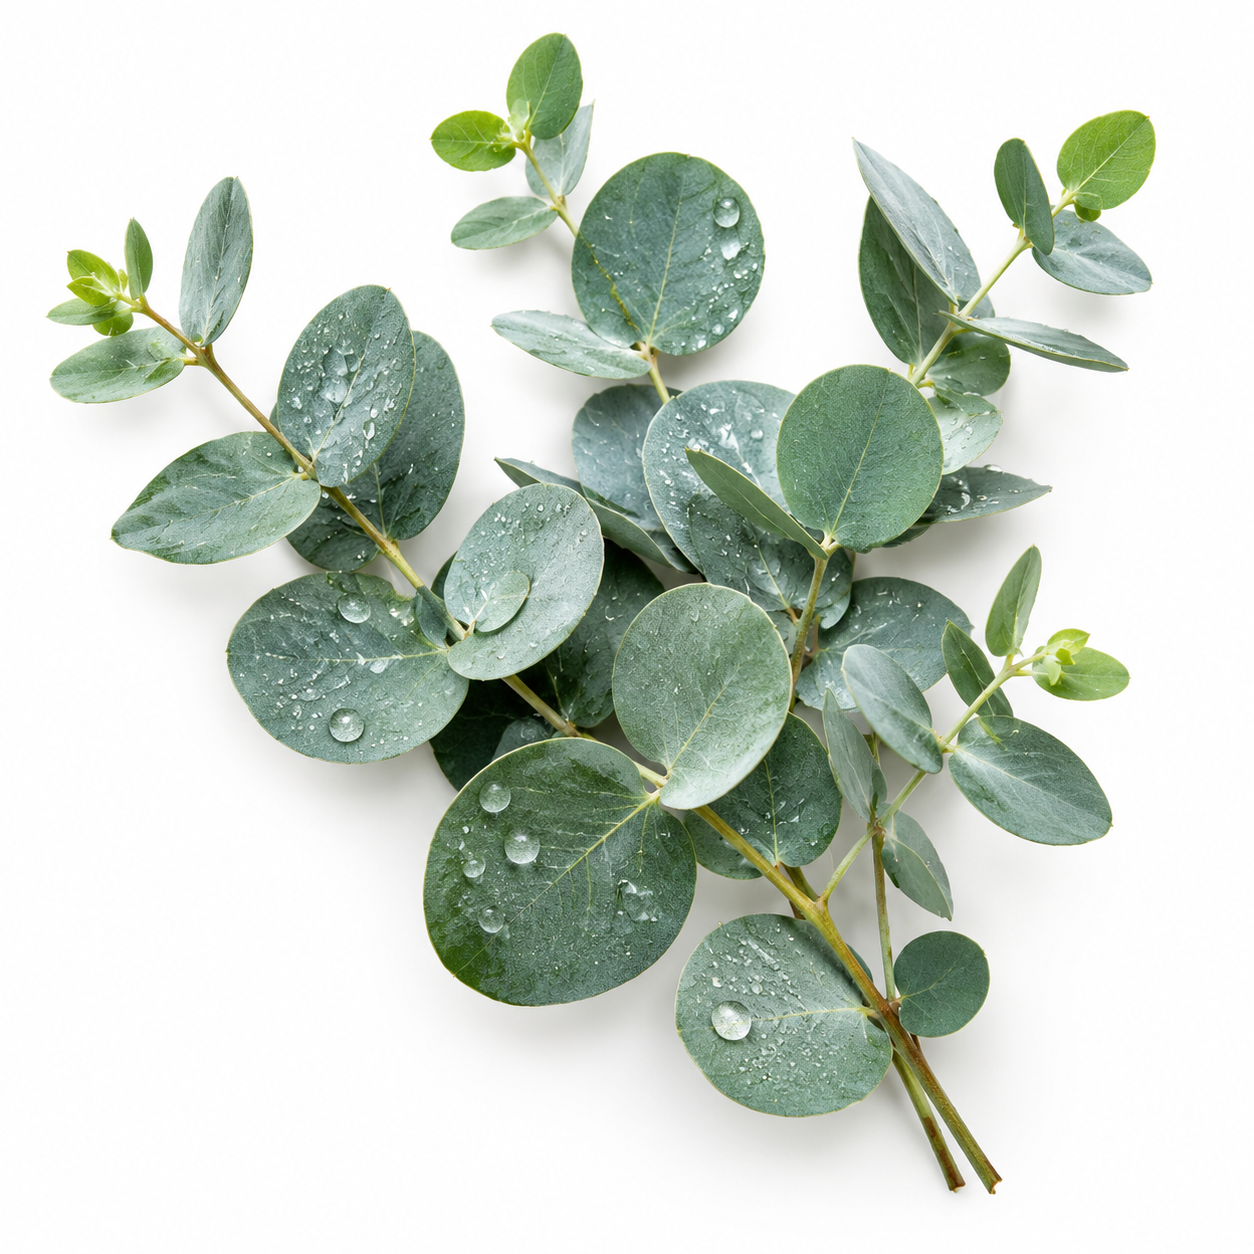
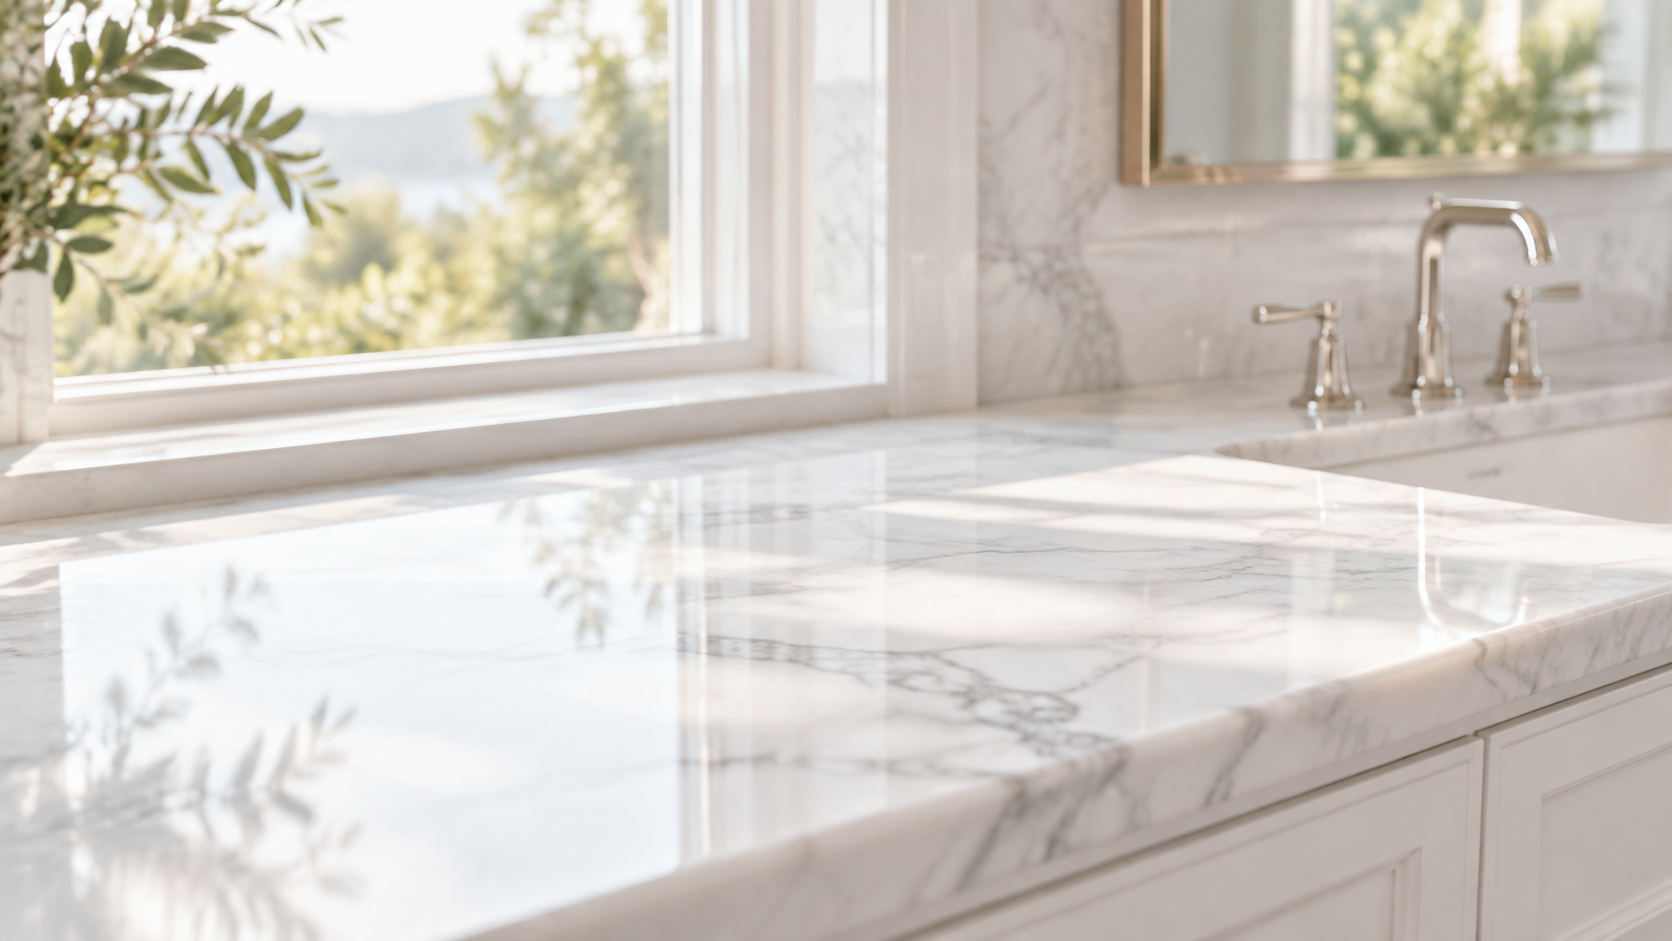
実際の出力(1080p、4秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "シーンを組み立てる:参照画像1のマットな美容液ボトルを参照画像3の大理石のドレッサーの上に直立させ、参照画像2のユーカリの枝をその横に寄りかからせる。ゆっくりとした映画的なプッシュイン、ボトルを一滴の水滴が伝い落ちる、柔らかな朝の光、かすかな湯気。高級スキンケア広告の質感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/serum_bottle.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/eucalyptus.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/marble_vanity.jpg"],
    "resolution": "1080p",
    "duration": 4,
    "aspect_ratio": "16:9"
  }
}
なぜ効果的か:3つのクリーンで独立した静止画像(各被写体が無地の背景上にある)は、モデルに組み立てるべき曖昧さのない部品を提供します。プロンプトは空間的なレイアウトを明示し(「ドレッサーの上に」「その横に」)、各画像を正確な番号で指し示しています。参照画像自体が雑然としていたり、各アイテムをどこに置くかをモデルに伝えずに「これらを組み合わせて」と言うだけだと、融合は崩れます。
レシピ 5 —— 縦型ソーシャルメディアのループ(9:16)
最適な用途:ショート動画プラットフォーム。同じモデル、同じプロンプトの規律、ただ aspect_ratio: "9:16" であるだけです。
入力参照画像:
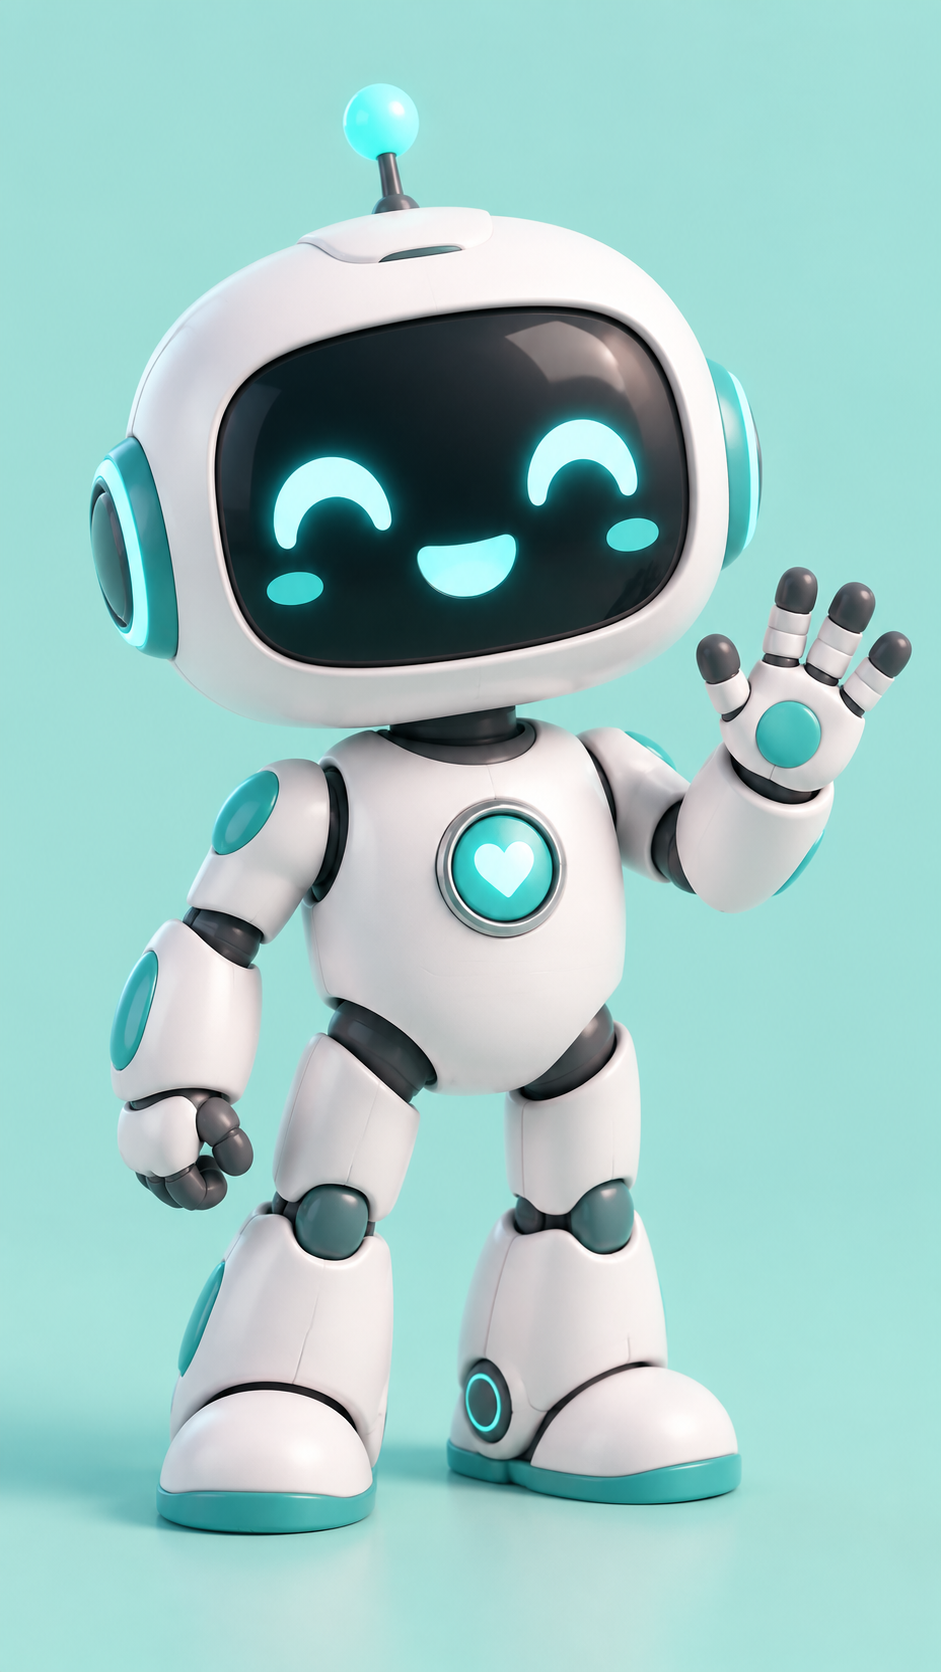
実際の出力(720p、5秒、縦型):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参照画像1の白と青の配色のロボットマスコットが両腕を振り、嬉しそうに小さくジャンプし、最後にカメラに向かって親指を立てる。カラフルな紙吹雪が弾け、弾むような力強い動き、明るく陽気な照明、縦型ソーシャルメディアの構図。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/robot_mascot.jpg"],
    "resolution": "720p",
    "duration": 5,
    "aspect_ratio": "9:16"
  }
}
なぜ効果的か:aspect_ratio は出力の画幅を制御するので、縦型クリップは 9:16 を設定するだけで済みます——参照画像はどんな形でもかまいません。ソーシャルメディアのループには、キャラクターに明確な起承転結のビート(手を振る → ジャンプする → 親指を立てる)を与え、5秒が断片ではなく完全な小さな瞬間として読めるようにします。
出力を実際に変えたプロンプト作成のルール
- 参照に番号を振る。「参照画像1のフクロウ」「参照画像2のシーン」。モデルは被写体と番号を結びつけます。「これらの画像を組み合わせて」がまさに融合が失敗する原因です。
- 各参照に役割を与える。どの静止画像が俳優で、どれがセットで、どれが小道具かを明示します。曖昧にするとモデルが推測します。
- ショットを1つの動作として書く。参照動画生成は3〜16秒の単一の連続ショットです。1つのカメラ構想(「プッシュイン」「飛び込んで着地」)は、複数ショットのリストに勝ります。
- 音声を使う場合は、音声を名指ししてセリフを残す。「参照音声1の声で話す」+ プロンプト内の実際の文。音声の長さを
durationに合わせます。 - 安く反復し、4Kで仕上げる。解像度は固定の秒倍率で、プロンプトには影響しません——まず720pでショットを検証し、勝者を4Kで再実行します。
FAQ
Vidu Q4 Preview の参照動画生成と画像からの動画生成の違いは何ですか?
参照動画生成はセットの画像(reference_image_urls、1〜15枚)を受け付け、それらを1つのショットに組み合わせます。画像からの動画生成は単一の最初のフレーム(image_url)を受け付け、それをアニメーション化します——reference_image_urls は拒否します。互いに独立した被写体を融合したい場合は参照動画生成を、正確な開始フレームがすでにある場合は画像からの動画生成を使います。
参照音声はどうやって追加しますか?
reference_audio_urls——最大3本の公開音声URLの配列——を渡し、プロンプトで「参照音声1の声で話す」と指示します。音声が声質を設定し、プロンプトがセリフとリップシンクを設定します。
参照画像は何枚使えますか? 1〜15枚です。シンプルなアニメーションなら1枚で十分です。キャラクター、場所、小道具を同じシーンに融合するために複数枚使いたい場合は、より多く渡してください。
対応している解像度と長さは?
解像度は 540p、720p、1080p、2k、4k。長さは3〜16秒の整数。アスペクト比は 16:9、9:16、1:1、4:3、3:4 です。
4Kクリップはいくらかかりますか? 4Kは毎秒$0.446なので、3秒の4Kクリップは約$1.34、5秒は約$2.23です。低解像度はずっと安価です(720pは毎秒$0.109)。最新の数字は料金ページをご覧ください。
参照画像は公開URLでなければなりませんか? はい——モデルがそれらを取得するので、インターネット経由でアクセス可能でなければなりません。公衆からアクセス可能な任意の場所にホストし、URLを渡してください。
重要なポイント
- 参照動画生成は1〜15枚の静止画像を融合して3〜16秒のショットにします。画像からの動画生成は単一の最初のフレームをアニメーション化します。
- 各参照を番号で指し示し、役割を与えましょう——この1つの習慣が融合の失敗のほとんどを修正します。
- 音声参照は
reference_audio_urls(最大3本)です。音声が声を設定し、プロンプトがセリフを設定します。 - 4K(毎秒$0.446)は Q4 Preview の Q3 に対する看板機能です——仕上げに使い、720pで反復しましょう。
- 上記のいずれかのレシピをコピーし、自分の参照URLに差し替えて、実行してください。
試す準備はできましたか?vidu-q4-preview/reference-to-video モデルページを開き、ドキュメントからAPIキーを取得して、レシピを1つ貼り付けてください。画像のセットではなく1枚のアンカーフレームしかない場合は、画像からの動画生成の製品ラインから始めるか、hiapi ブログのその他の参照動画生成ワークフローやプロンプトレシピをご覧ください。


