
使用指南
Vidu Q4 Preview 参考生视频提示词配方:可直接复制的提示词与真实输出
五条经过实战检验的参考生视频提示词——多图融合、声音参考,以及一条真实的 4K 镜头——每条都配上了它生成的片段。
TL;DR
- 五条可直接复制的 参考生视频 提示词配方,面向 vidu-q4-preview/reference-to-video,每条都配上了它在 hiapi 上实际生成的片段——不是库存素材,也不是效果图。
- 参考生视频就是「把多张静图融合成一个镜头」的模式:你给它 1–15 张参考图,还可选提供 最多 3 段参考音频,它会渲染成一段 3–16 秒 的单一镜头,最高可达 4K。
- 包含一段真实的 4K 电影感片段,以及一个可用的 声音参考(「开口说话的主持人」)示例,并展示了精确的
reference_audio_urls请求。 - 真正改变了输出的提示词规则:用序号来指代每一份参考、把镜头写成 一个连续动作,以及附加声音时在提示词里保留台词。
- 复制 JSON,换成你自己的参考 URL,然后 POST 到
/v1/tasks。
vidu-q4-preview/reference-to-video 到底做什么
Vidu Q4 Preview(来自生数科技)在 hiapi 上有两条产品线,它们不能互换:
- reference-to-video(本页):你提供一组参考图——一个角色、一个地点、一个产品、一件道具——模型把它们组合成一个运动镜头。字段是
reference_image_urls,接受 1–15 张图片。 - image-to-video(配方见此):你提供 单张首帧(
image_url),它把 那一帧 向前动画化。它完全拒绝reference_image_urls。
所以,当你想把彼此独立的主体 组合 进一个场景时,选参考生视频;当你已经有确切的起始帧、只想要运动时,选图生视频。如果你用过 Vidu Q3 的参考系列页面,这里的跃升是具体的:Q4 Preview 增加了 4K 输出(Q3 最高 1080p),并把参考预算提高到 1–15 张图(Q3 Mix 允许 1–7 张)。两代都能接受音频参考;这些配方侧重利用 Q4 更大的图片预算和 4K。
已验证的输入 schema(2026 年 10 月对着 /v1/tasks 实测):
| 字段 | 必填 | 取值 |
|---|---|---|
prompt |
是 | 自由文本;用序号指代参考主体 |
reference_image_urls |
是 | 数组,1–15 个公开图片 URL |
reference_audio_urls |
否 | 数组,最多 3 个音频 URL(声音/音效参考) |
resolution |
否 | 540p · 720p · 1080p · 2k · 4k |
duration |
否 | 整数,3–16 秒 |
aspect_ratio |
否 | 16:9 · 9:16 · 1:1 · 4:3 · 3:4 |
定价是 按分辨率设定的固定每秒费率(所以 5 秒片段就是每秒单价 × 5)。截至 2026 年 10 月,hiapi 上:540p $0.0515/秒,720p $0.109/秒,1080p $0.1375/秒,2K $0.2175/秒,4K $0.446/秒。完整数字见 定价页。实用的结论是:在 720p 上迭代提示词,然后把满意的那条放到 4K 重跑——提示词本身什么都不变,只有倍数变。
我们是怎么跑出这些结果的(方便你复现)
下面每个片段都是在 hiapi 上通过异步任务 API 生成的。流程始终一样:
- 参考图必须能通过公网访问。我们用
gpt-image-2/text-to-image生成自己的图片,上传到静态存储桶,再传那些 URL——你可以用任何已托管的图片。 - 用每条配方中给出的请求体
POST /v1/tasks。 - 轮询
GET /v1/tasks/{taskId}直到status为success,然后下载output[0].url(这是限时链接——立即保存)。
快速入门文档见 hiapi 文档。一个最小请求长这样:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "vidu-q4-preview/reference-to-video",
    "input": {
      "prompt": "...",
      "reference_image_urls": ["https://.../subject.jpg"],
      "resolution": "1080p",
      "duration": 5,
      "aspect_ratio": "16:9"
    }
  }'
下面是配方。
配方 1 —— 单参考快速上手
最适合:最简单的参考生视频——一个主体,一段干净的动画。在开始融合之前先从这里入手。
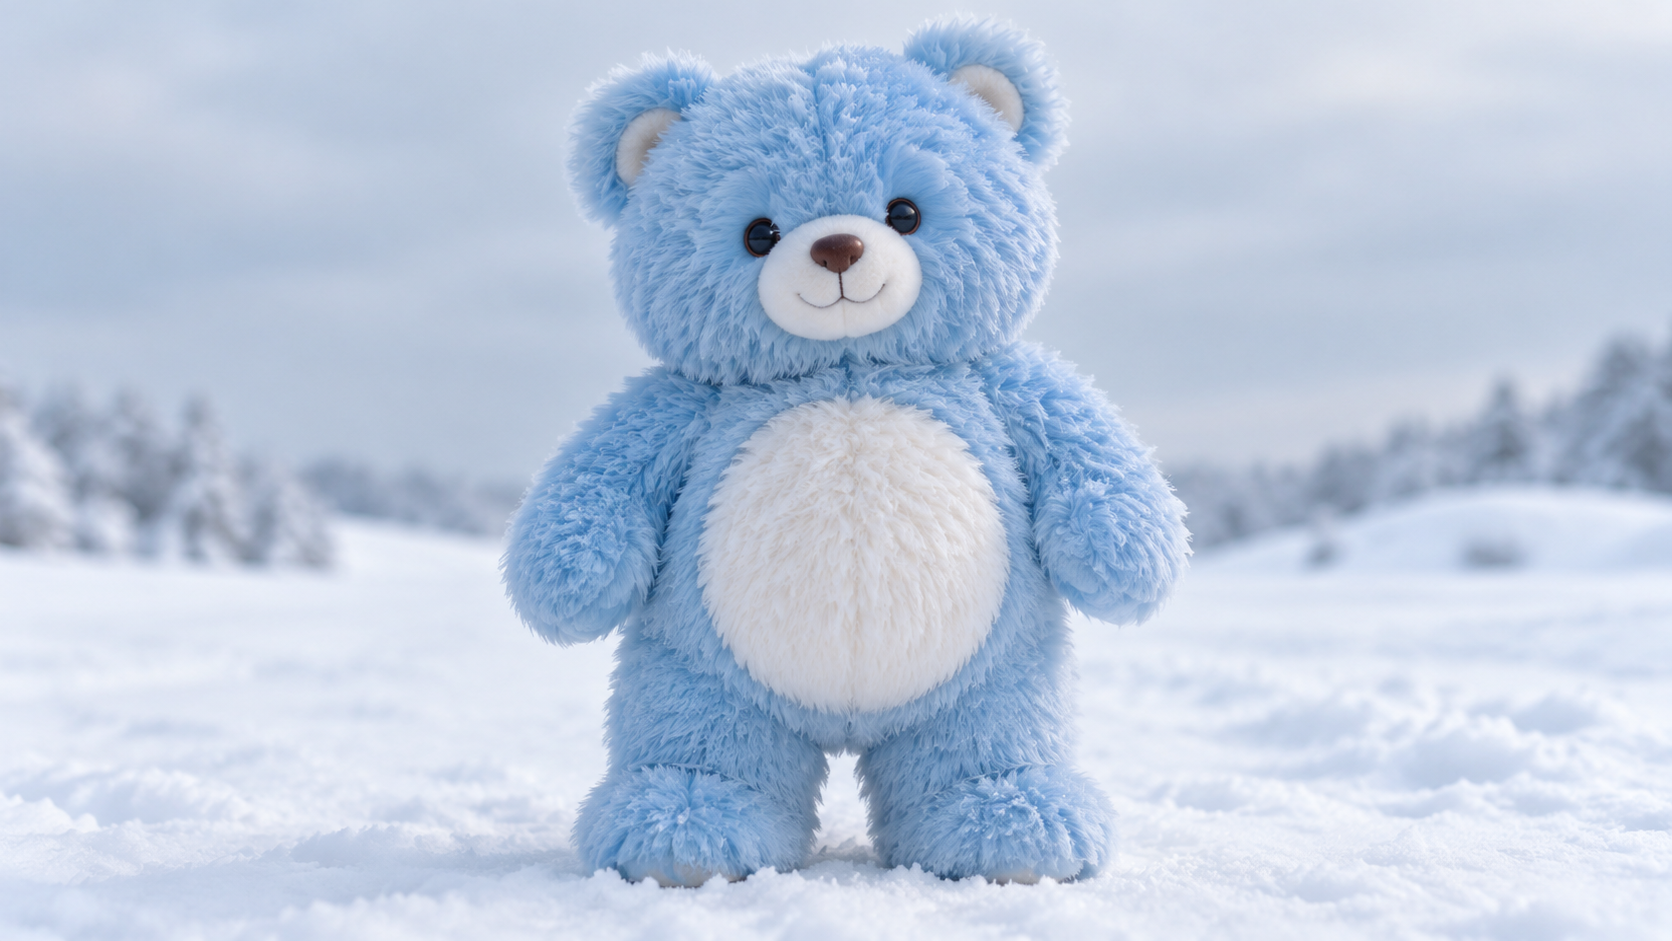
输入参考图:
真实输出(720p,3 秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参考图 1 中的毛茸茸蓝色小熊在雪地里向前缓慢走两步,然后抬头看向镜头并挥动一只爪子。轻柔飘落的雪,电影感柔光。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/smoke_bear.jpg"],
    "resolution": "720p",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
为什么有效:即使只有一张图,点名它(「来自参考图 1 的毛茸茸蓝色小熊」)也能锚定主体,让模型去动画化 那只 熊,而不是凭空造一只新的。一个简短、具体的动作(「走两步……挥动一只爪子」)在 3 秒内比含糊的「让它动起来」更容易干净地渲染。注意,尽管我们没附加任何参考音频,片段回来时也带有一条环境音轨。
配方 2 —— 电影感 4K,角色 + 场景融合
最适合:你的主视觉镜头。两张参考——一个主体和一个环境——融合成一段有氛围的镜头,以 4K 收尾。
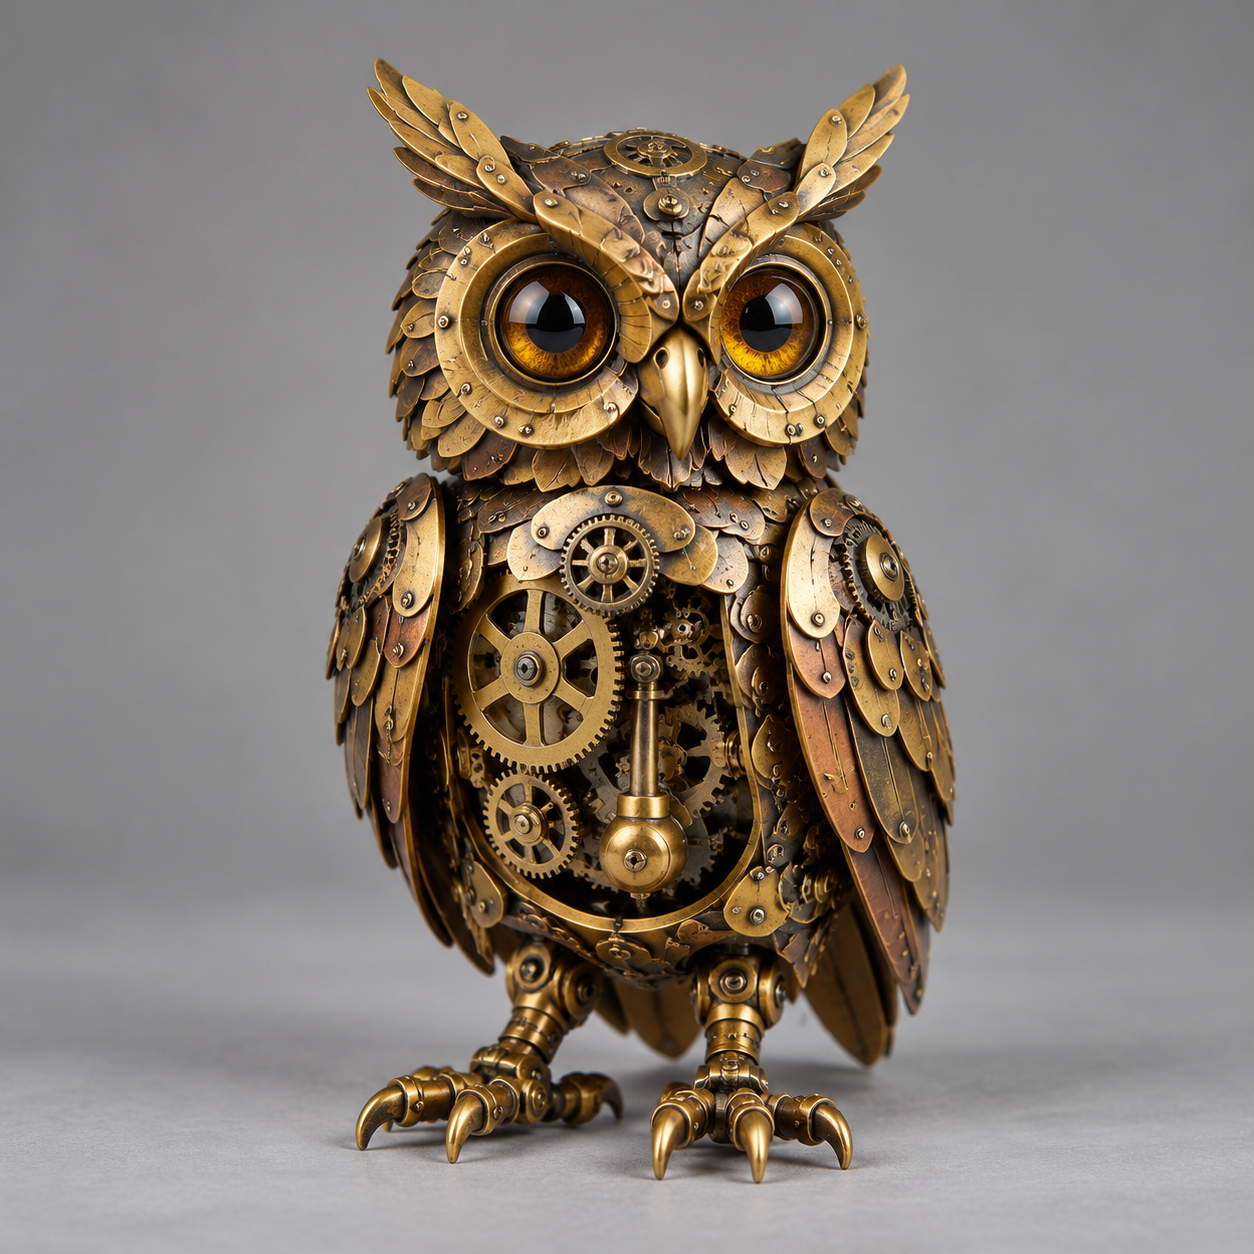
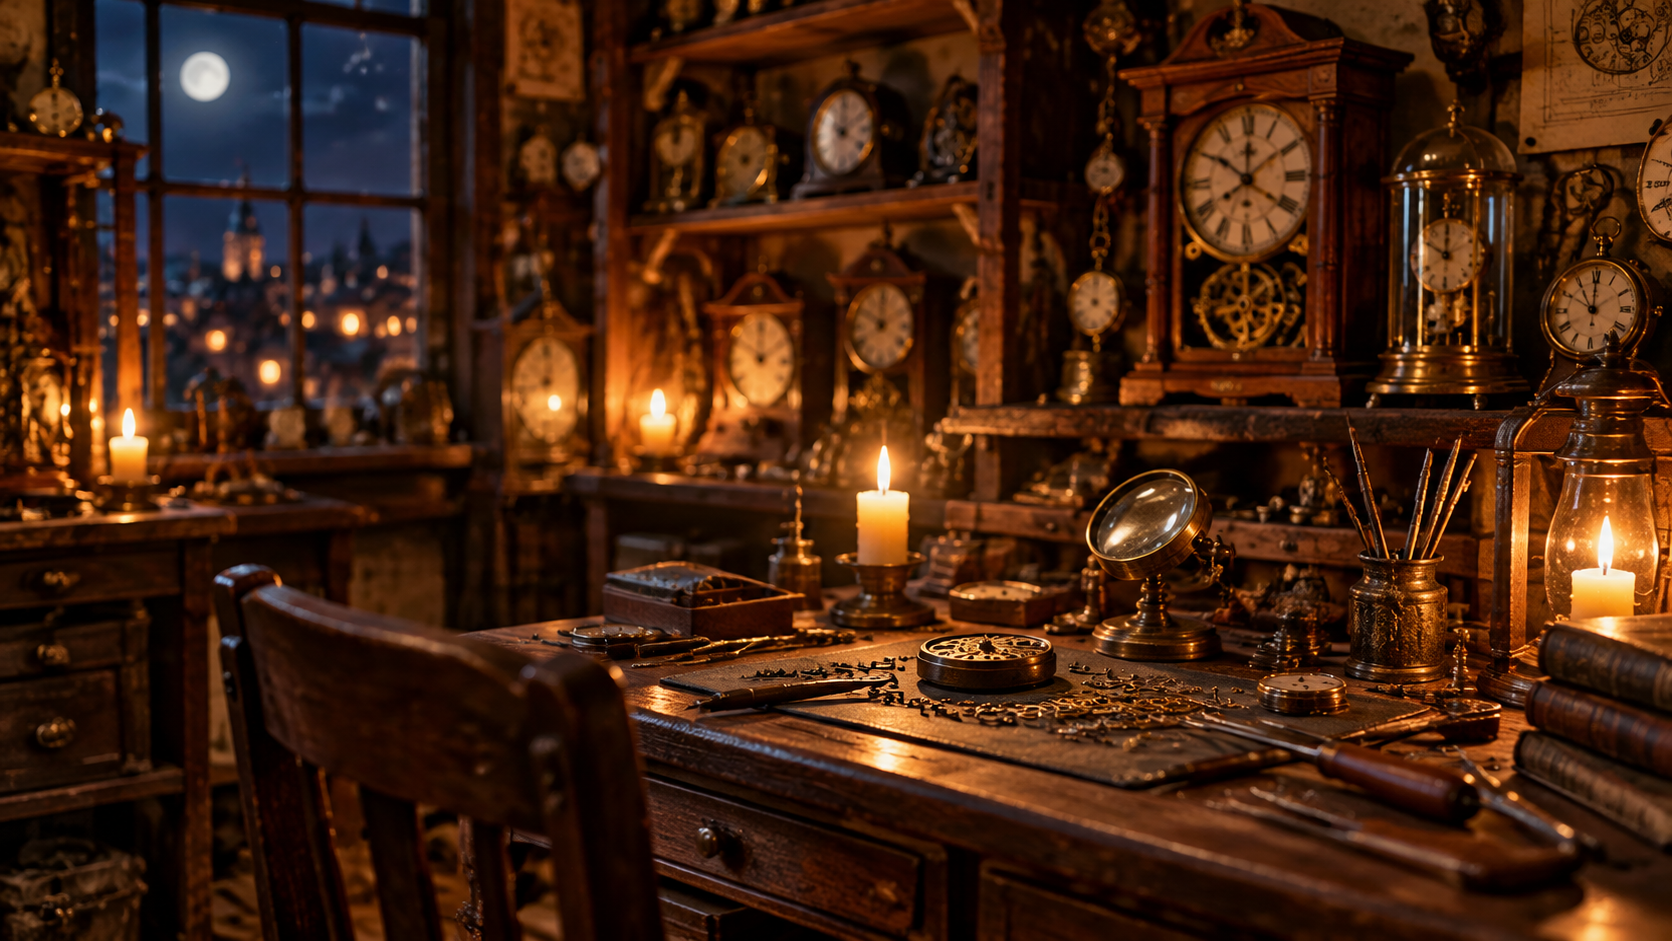
输入参考(主体 + 地点):
真实输出(4K,3 秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
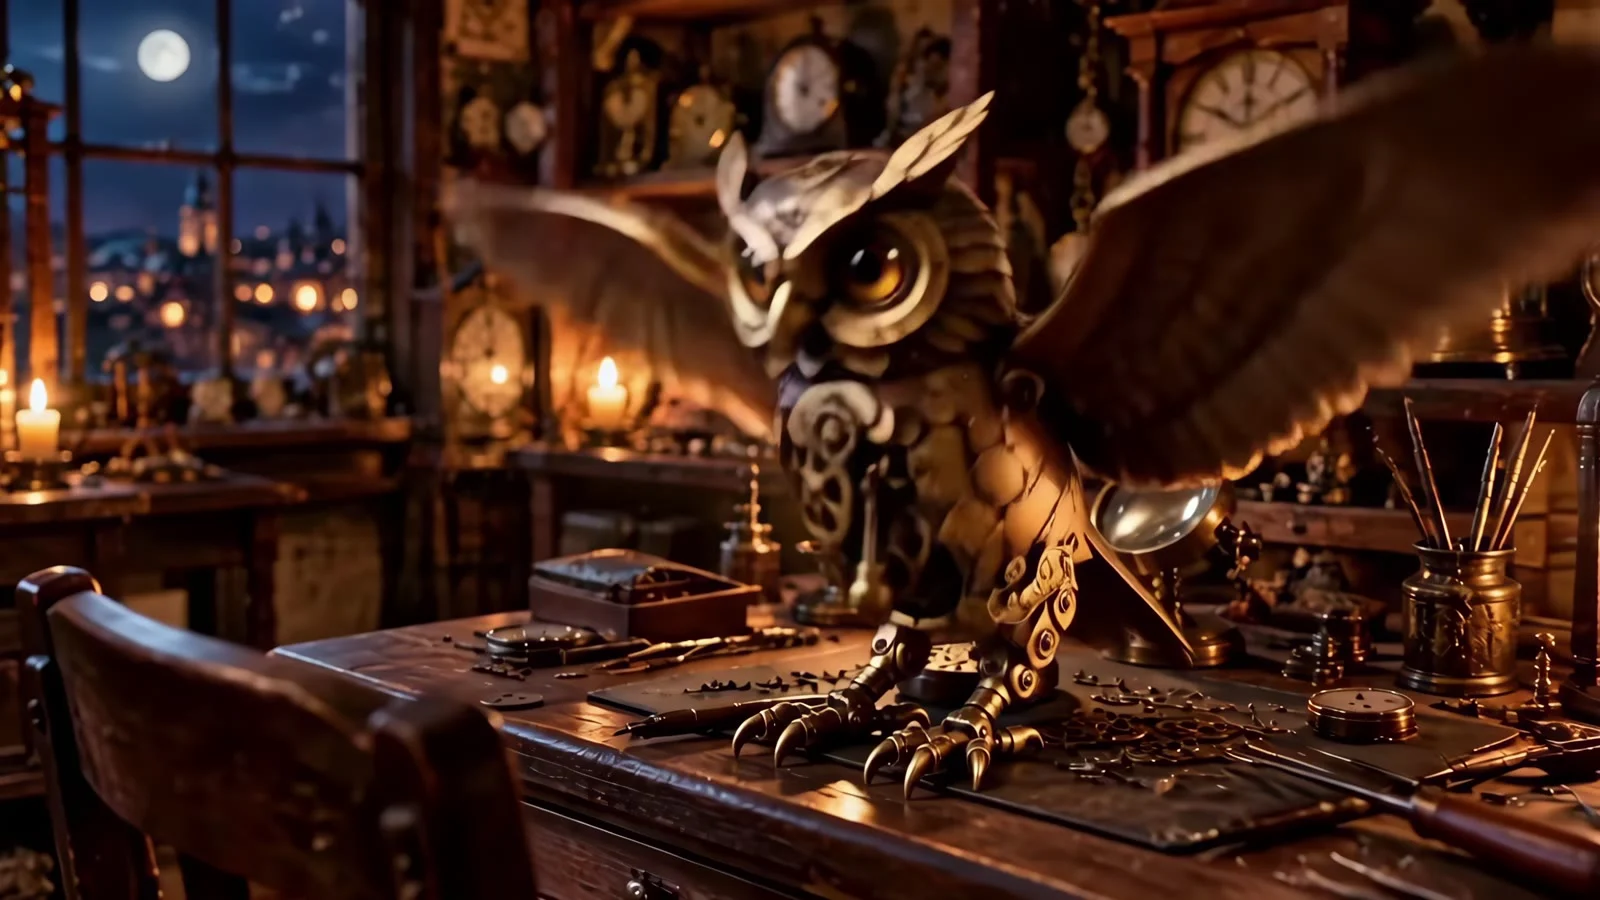
    "prompt": "参考图 1 中的黄铜发条猫头鹰飞入参考图 2 中烛光摇曳的工坊,翅膀嗡鸣、齿轮可见,然后轻轻落在木制工作台上。它慢慢把头转向镜头并眨了一下眼。温暖的琥珀色烛光闪烁,尘埃微粒飘浮,浅景深电影感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/owl_char.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/clock_workshop.jpg"],
    "resolution": "4k",
    "duration": 3,
    "aspect_ratio": "16:9"
  }
}
为什么有效:提示词给每份参考分配了一个 角色——图 1 是演员,图 2 是布景——这样模型就知道哪张静图是主体、哪张是背景。镜头方向是一个连续的构想(飞入 → 降落 → 转向镜头),参考生视频会把它渲染成一个不间断的镜头。按 $0.446/秒,这个 3 秒 4K 片段约花 $1.34;我们先在 720p 上验证了构图。
配方 3 —— 声音参考(开口说话的主持人)
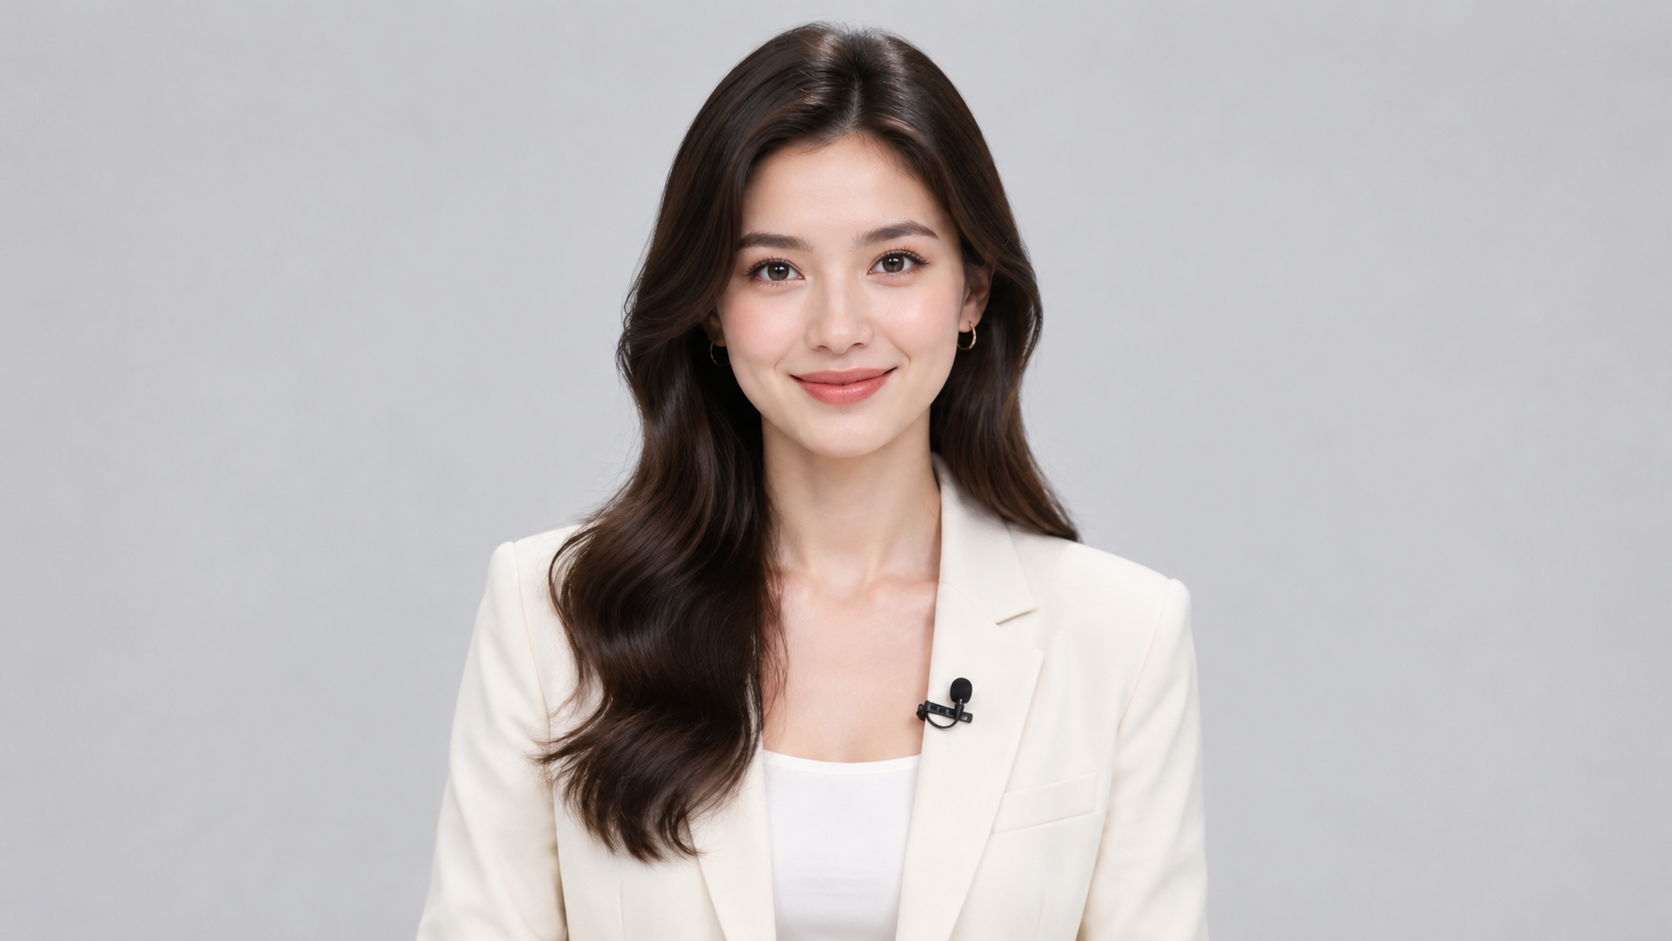
最适合:一个用特定声音说话的角色。你把一段音频作为 reference_audio_urls 附加;音频设定 音色,提示词设定 台词 和口型同步。
输入参考图:
输入参考音频:presenter_voice.mp3(我们用 qwen-audio-3.0-tts-plus 生成了这句台词;任何已托管的音频 URL 都可用)。
真实输出(1080p,5 秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参考图 1 中的主持人直视镜头,用参考音频 1 的声音说出这句台词,口型自然同步,头部小幅摆动,笑容温暖。稳定的演播室镜头,柔和布光,轻微呼吸感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/presenter.jpg"],
    "reference_audio_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/audio/presenter_voice.mp3"],
    "resolution": "1080p",
    "duration": 5,
    "aspect_ratio": "16:9"
  }
}
为什么有效:关键短语是「用 参考音频 1 的声音 说出这句台词」。音频参考驱动声音;提示词仍然承载表演说明(「自然口型同步」「温暖笑容」)。让音频片段的长度接近你的 duration,这样语音才能放进镜头里。reference_audio_urls 是一个数组——最多可以传三段片段,来参考多个声音,或一个声音加一层环境声。
配方 4 —— 三参考产品融合
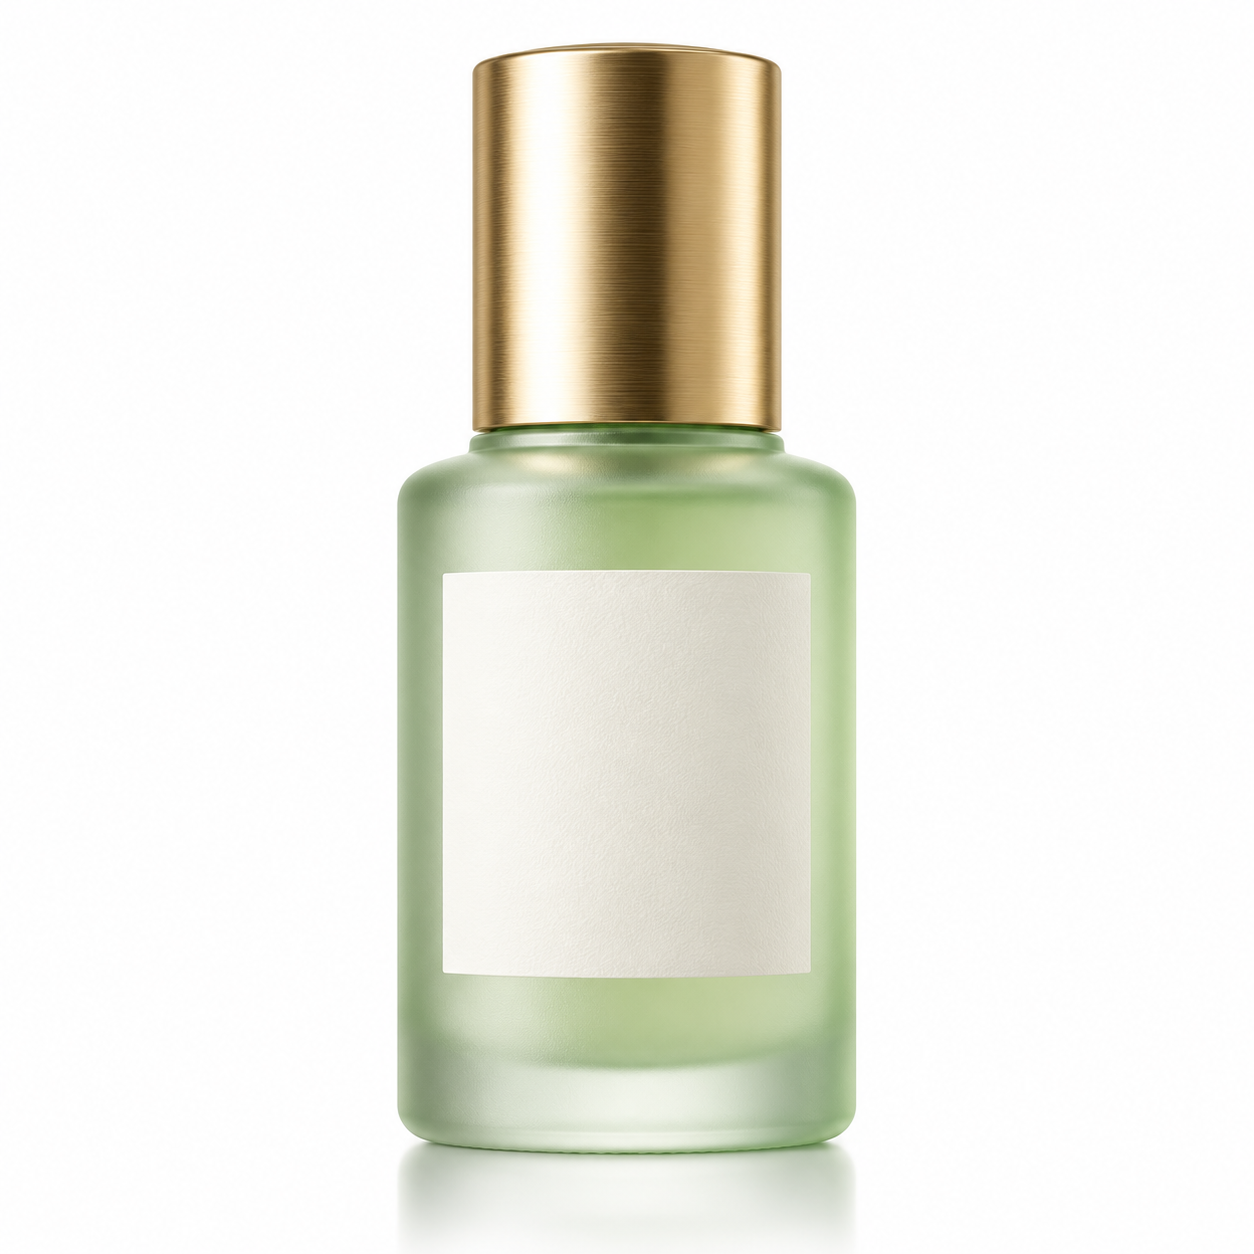
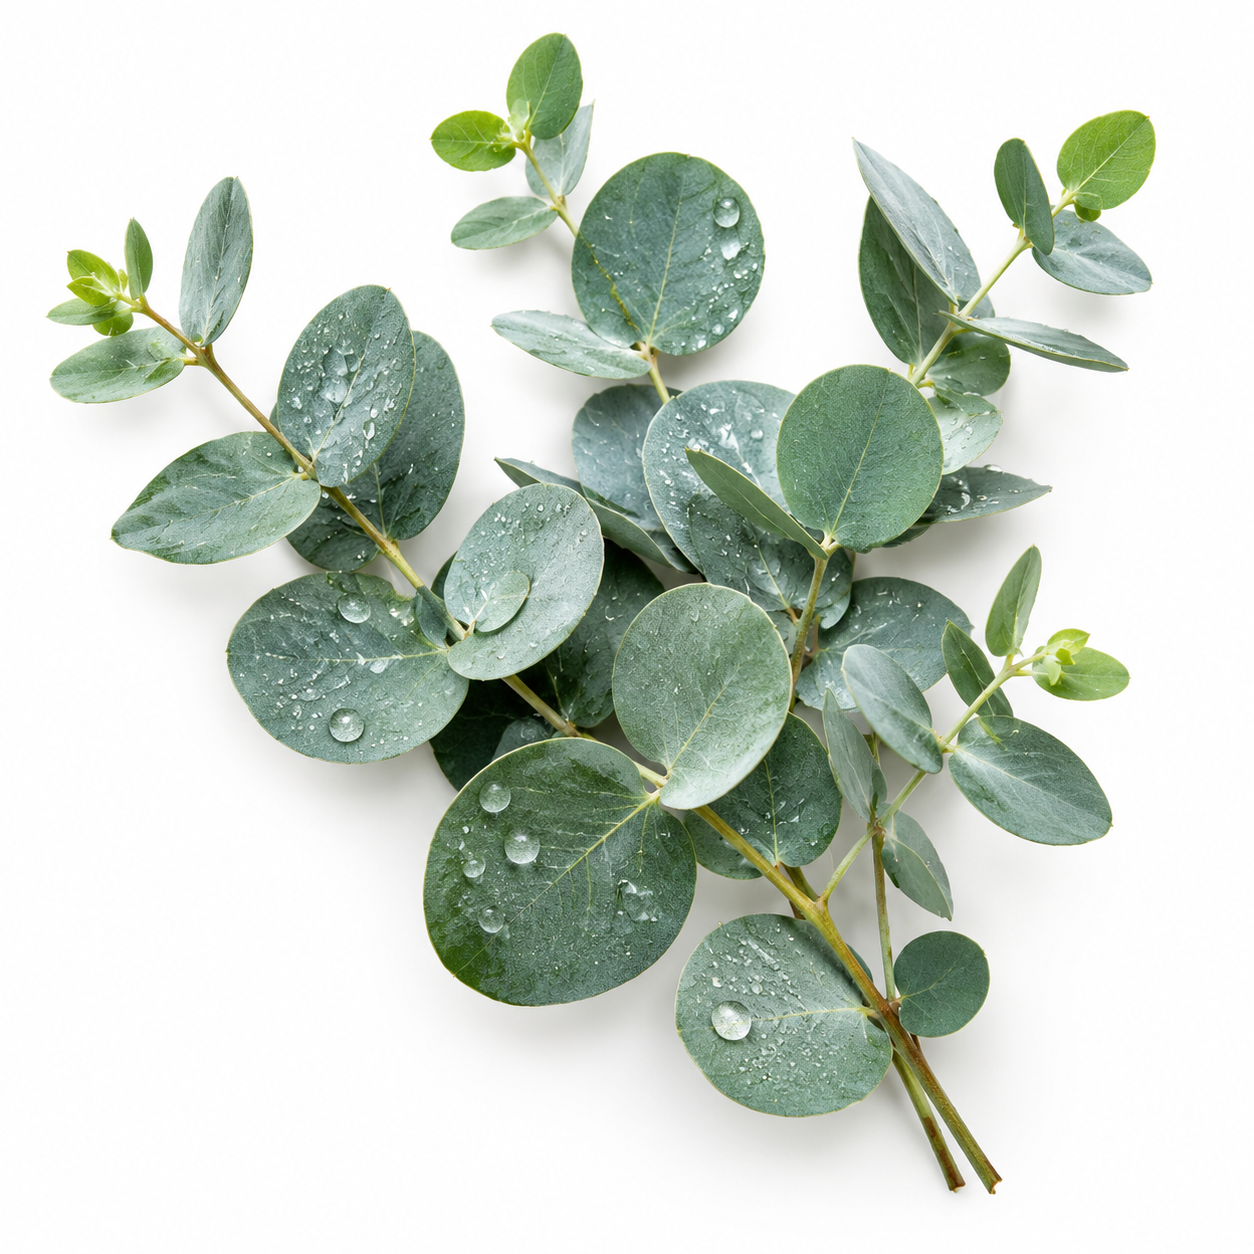
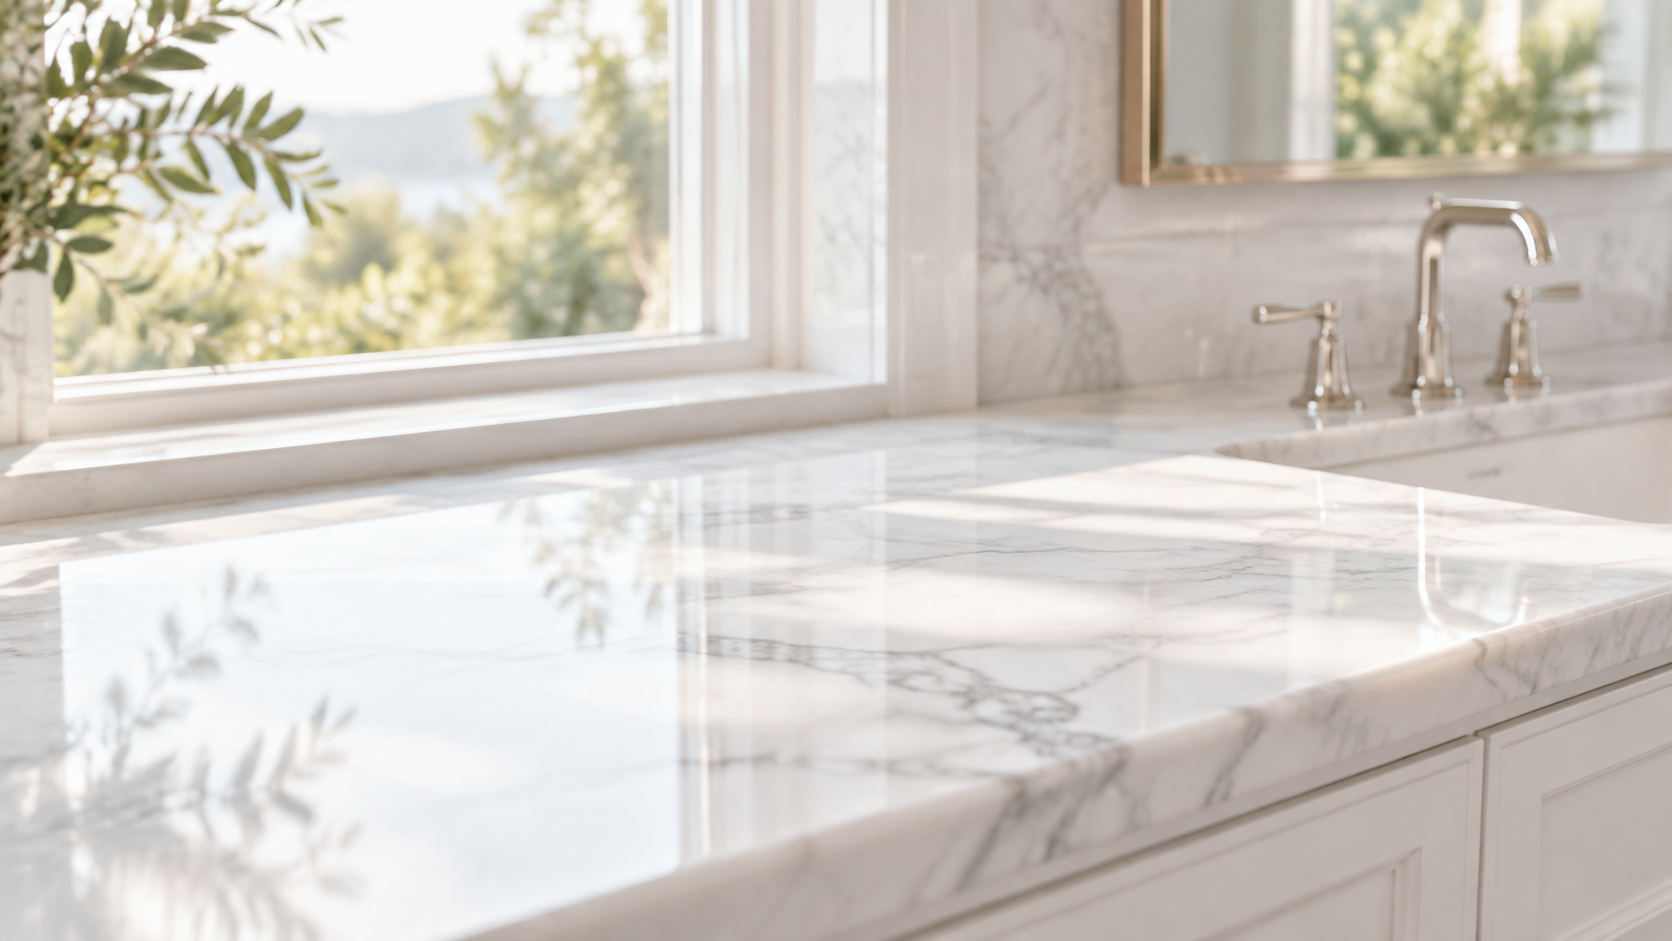
最适合:用彼此独立的产品静图做商业风格构图——瓶子、道具、台面——布置进一个场景。
输入参考(产品 + 道具 + 场景):
真实输出(1080p,4 秒):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "组合一个场景:把参考图 1 中的磨砂精华瓶直立放在参考图 3 中的大理石梳妆台上,让参考图 2 中的尤加利枝条靠在它旁边。缓慢的电影感推镜,一滴水珠从瓶身滑落,柔和晨光,轻柔蒸汽。高端护肤品广告质感。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/serum_bottle.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/eucalyptus.jpg", "https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/marble_vanity.jpg"],
    "resolution": "1080p",
    "duration": 4,
    "aspect_ratio": "16:9"
  }
}
为什么有效:三张干净、独立的静图(每个主体都在纯色背景上)给模型提供了无歧义的部件来组装。提示词明确说明了 空间布局(「在梳妆台上」「在它旁边」),并用精确序号指代每张图。当参考图本身很杂乱,或者你只说「把这些合起来」却不告诉模型每件东西该放哪时,融合就会跑偏。
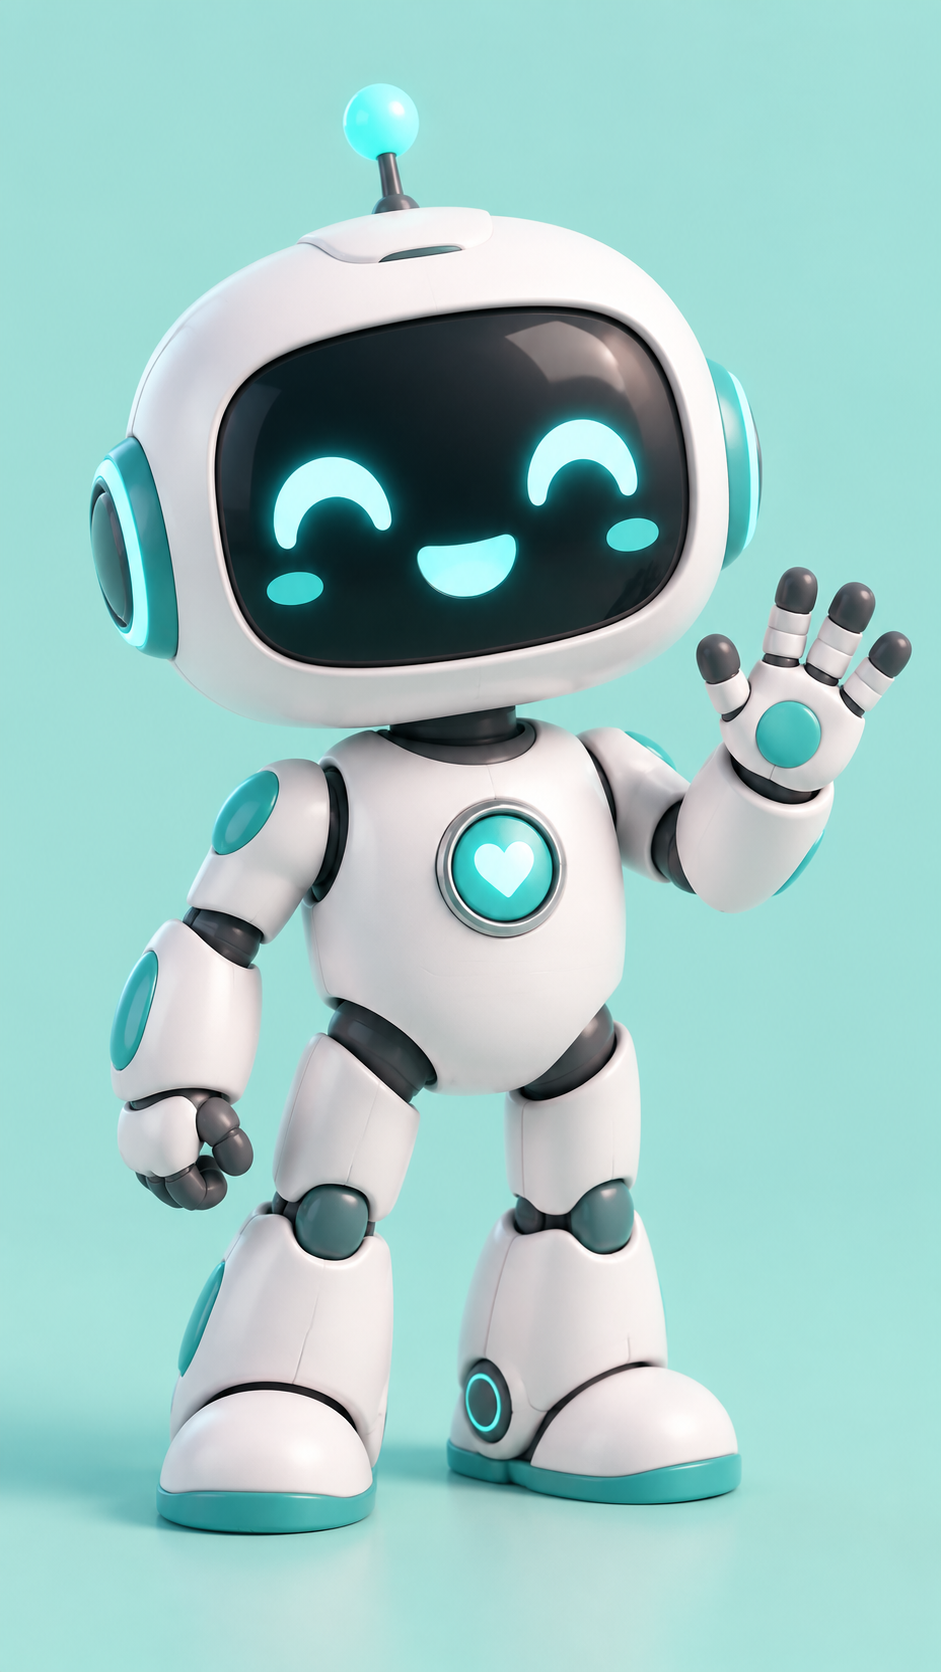
配方 5 —— 竖屏社媒循环(9:16)
最适合:短视频平台。同样的模型,同样的提示词纪律,只是 aspect_ratio: "9:16"。
输入参考图:
真实输出(720p,5 秒,竖屏):
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "参考图 1 中白青配色的机器人吉祥物挥动双臂,开心地小跳一下,最后对镜头竖起大拇指。彩色纸屑爆开,弹跳有力的动作,明亮欢快的灯光,竖屏社交媒体构图。",
    "reference_image_urls": ["https://static.hiapi.ai/blog/vidu-q4-preview-reference-to-video-prompt-recipes/refs/robot_mascot.jpg"],
    "resolution": "720p",
    "duration": 5,
    "aspect_ratio": "9:16"
  }
}
为什么有效:aspect_ratio 控制的是 输出 画幅,所以竖屏片段只需设 9:16——参考图可以是任意形状。对社媒循环来说,给角色一个清晰的开始—中间—结尾节拍(挥手 → 跳一下 → 竖大拇指),这样 5 秒读起来才是一个完整的微瞬间,而不是一个碎片。
真正改变了输出的提示词写作规则
- 给你的参考编号。「参考图 1 中的猫头鹰」「参考图 2 中的场景」。模型把主体和序号绑定;「把这些图片合起来」正是融合出错的根源。
- 给每份参考一个角色。说明哪张静图是演员、哪张是布景、哪张是道具。含糊会让模型去猜。
- 把镜头写成一个动作。参考生视频是 3–16 秒的单一连续镜头。一个镜头构想(「推近」「飞入并降落」)胜过一串多镜头清单。
- 用声音时,点名音频并保留台词。「用参考音频 1 的声音说话」+ 提示词里的实际句子。让音频长度与
duration匹配。 - 便宜的迭代,4K 定稿。分辨率是固定的每秒倍数,不碰你的提示词——先在 720p 验证镜头,再把赢家放到 4K 重跑。
FAQ
Vidu Q4 Preview 上参考生视频和图生视频有什么区别?
参考生视频接受一 组 图片(reference_image_urls,1–15 张),并把它们组合成一个镜头。图生视频接受 单张 首帧(image_url)并把它动画化——它拒绝 reference_image_urls。想把彼此独立的主体融合,就用参考生视频;当你已经有确切的起始帧时,就用图生视频。
怎么加参考声音?
传 reference_audio_urls——一个最多三段公开音频 URL 的数组——并告诉提示词「用参考音频 1 的声音说话」。音频设定音色;提示词设定台词和口型同步。
我可以用多少张参考图? 1 到 15 张。简单的动画一张就够;要用更多张把角色、地点和道具融合到同一个场景里,就多给几张。
支持哪些分辨率和时长?
分辨率 540p、720p、1080p、2k、4k;时长是 3 到 16 秒的整数;宽高比 16:9、9:16、1:1、4:3、3:4。
一段 4K 片段要多少钱? 4K 是每秒 $0.446,所以 3 秒 4K 片段约 $1.34,5 秒约 $2.23。较低分辨率便宜得多(720p 是每秒 $0.109)。当前数字请查看 定价页。
参考图必须是公开 URL 吗? 是的——模型会去抓取它们,所以必须能通过互联网访问。把它们托管在任何可公开访问的地方,然后传 URL。
关键要点
- 参考生视频是把 1–15 张静图 融合 成一段 3–16 秒的镜头;图生视频是把单张首帧动画化。
- 用序号指代每一份参考,并给它一个角色——这一个习惯就能修复大多数融合跑偏。
- 声音参考是
reference_audio_urls(最多 3 段);音频设定声音,提示词设定台词。 - 4K(每秒 $0.446)是 Q4 Preview 相对 Q3 的招牌——用它做定稿,在 720p 上迭代。
- 复制上面任一配方,换成你的参考 URL,然后跑起来。
准备好试试了吗?打开 vidu-q4-preview/reference-to-video 模型页,从 文档 拿一个 API key,然后粘贴一条配方。如果你只有一张锚定帧而不是一组图,请从 图生视频产品线 开始,或者浏览 hiapi 博客里更多 参考生视频工作流 和 提示词配方。


