
使用指南
Wan 2.7 图生视频提示词配方:3 个可复制粘贴的提示词与真实输出
针对 wan2.7-video/image-to-video 的三条一次成片提示词配方——锁定机位下的产品运动、人像微表演与真实运镜旅行——每条都附有输入帧、精确提示词、内嵌输出片段以及已验证的标准档价格。
图生视频是使用视频模型时杠杆率最高的方式:你通过一张静态图片锁定构图、灯光和主体,把模型的全部能力都花在运动上。问题在于,i2v 提示词本身就是一项独立技能——大多数适用于文生视频的提示词,都会浪费大量 token 去重新描述模型已经能看到的场景。
本指南为你提供三条可复制粘贴的提示词配方,用于 wan2.7-video/image-to-video,即阿里巴巴通义万相 2.7 图生视频模型,覆盖人们实际使用 i2v 的三类任务:产品运动、人像表演和镜头运动。下面嵌入的每个片段都是对应提示词的真实一次成片输出——通过 hiapi 任务 API 在标准 720P 档(每秒视频 $0.10)生成。输入帧也一并附上,因此你可以准确追踪模型得到了什么、又创造出了什么。
请求结构(请先阅读)
wan2.7 i2v 运行在 hiapi 的异步任务端点上。三个 schema 细节能帮你省下一轮 400 错误:
media是对象数组,不是裸 URL 字符串。每个对象需要type和url。接受的类型有first_frame、last_frame、driving_audio和first_clip——因此同一个端点就能覆盖普通首帧动画、首尾帧插值、音频驱动运动和片段延长。本文中的所有内容都只传入一个first_frame。resolution是枚举:720P或1080P,没有其他值。duration以秒为单位,上限为 15。
图片 URL 必须可公开访问——平台在创建任务时会在服务端下载它。
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/image-to-video",
    "input": {
      "prompt": "充电盒盖平滑向上打开,两枚哑光黑色耳机缓慢从盒中升起……",
      "media": [
        {"type": "first_frame", "url": "https://your-cdn.example/frame.jpg"}
      ],
      "resolution": "720P",
      "duration": 5
    }
  }'
响应会立即返回一个 taskId。轮询 GET /v1/tasks/{taskId} 直到 status 为 success,然后下载 output[0].url:
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}

task_id = requests.post(BASE, headers=HEADERS, json=payload).json()["data"]["taskId"]

while True:
    task = requests.get(f"{BASE}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] == "success":
        video = requests.get(task["output"][0]["url"]).content
        open("clip.mp4", "wb").write(video)
        break
    if task["status"] == "fail":
        raise RuntimeError(task.get("error"))
    time.sleep(10)
一条运维提示:output[0].url 是带 expireAt 时间戳的限时链接。任务成功后应立即下载文件并存入你自己的存储桶——如果不这样做会发生什么,请看这里。
配方 1:锁定机位下的产品运动
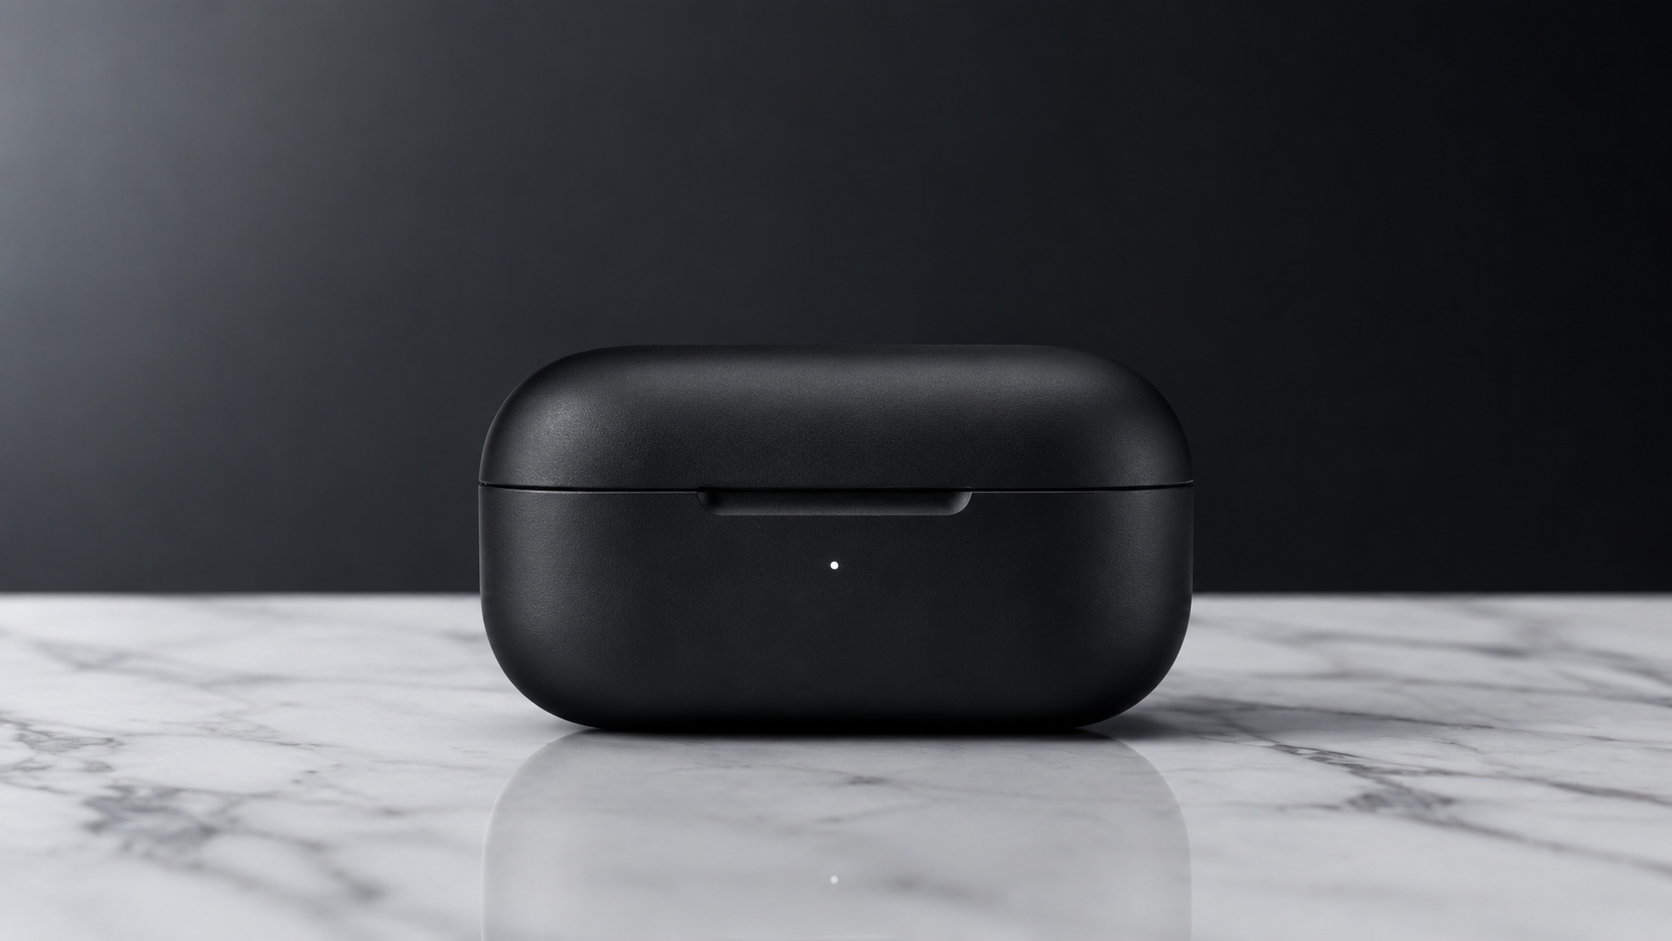
经典电商主图循环:产品在动,镜头不动。我们从这张 gpt-image-2 影棚拍摄的闭合耳机盒图片开始:
提示词:
充电盒盖平滑向上打开,两枚哑光黑色耳机缓慢从盒中升起,悬停在盒子上方,同时同步缓慢旋转。它们转动时,柔和的影棚光在其表面闪过。相机完全锁定不动;浅景深将焦点保持在耳机上。干净、高级的产品发布美学,无镜头运动。
参数:resolution: 720P、duration: 5——费用 $0.50。
一次成片输出:
模型自己创造了盒子内部和耳机本身——输入帧中两者都不存在——并在盒盖摆动时保持了大理石反射的连贯性。提示词中有两点起了关键作用:物体状态按顺序命名(盒盖打开 → 耳机升起 → 悬停 → 同步旋转),以及相机被明确要求什么都不做,而且说了两次(完全锁定不动……无镜头运动)。负面运动约束会被遵守;如果没有它们,i2v 模型往往会加入你并未要求的漂移或变焦。
配方 2:人像微表演
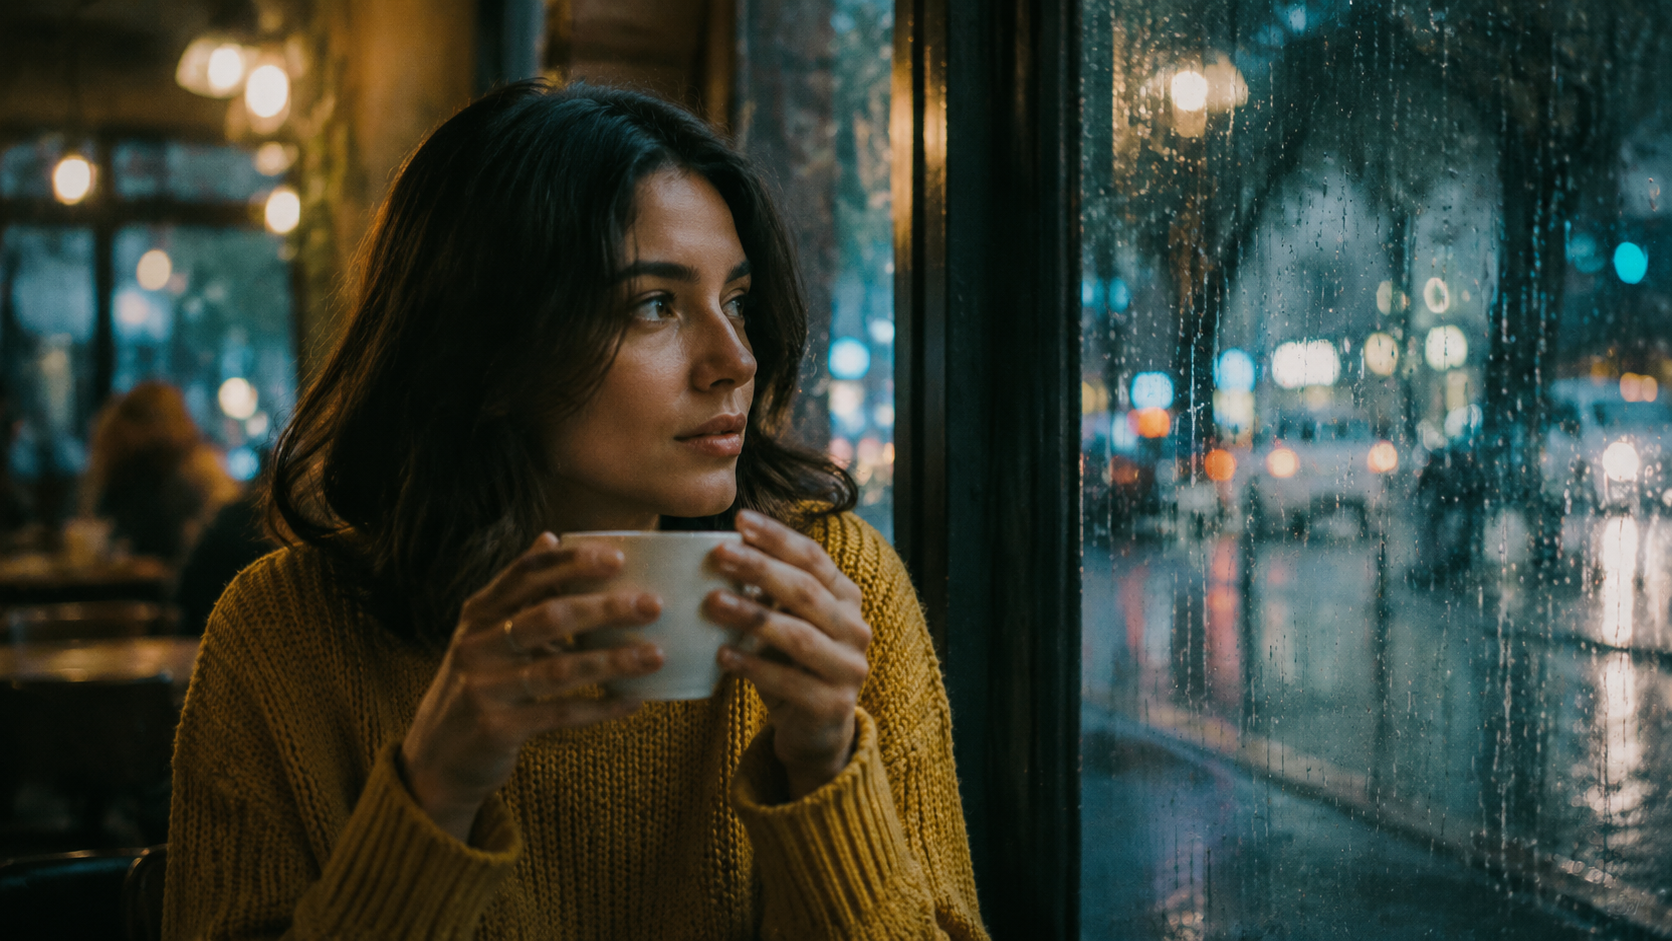
为人物制作动画正是 i2v 发挥价值的地方——选角、服装和灯光都已经由帧画面解决。输入同样来自 gpt-image-2:
提示词:
女子轻轻举起杯子,缓慢安静地啜饮一口,然后放下杯子,转头望向布满雨痕的窗外,露出柔和的微笑。热气从杯口袅袅升起;雨滴在她身后的玻璃上滑落。她移动时头发微微晃动。相机保持静止,焦点从杯子柔和地拉到她的脸上。温暖、从容、电影般的运动。
参数:resolution: 720P、duration: 5——费用 $0.50。
一次成片输出:
这里的配方是按明确顺序排列的两三个小动作链(举起 → 啜饮 → 放下 → 转头 → 微笑)。wan2.7 会按写出的顺序逐一执行,这正是让片段读起来像表演、而不是循环动态图的原因。另一半是次级运动:热气、雨滴和头发都很容易要求,而它们承载了大部分真实感。面部方向要温和(“柔和微笑”,而不是“大笑”)——细微表情能存活下来;夸张表情则是赌博。
配方 3:静态场景上的镜头运动
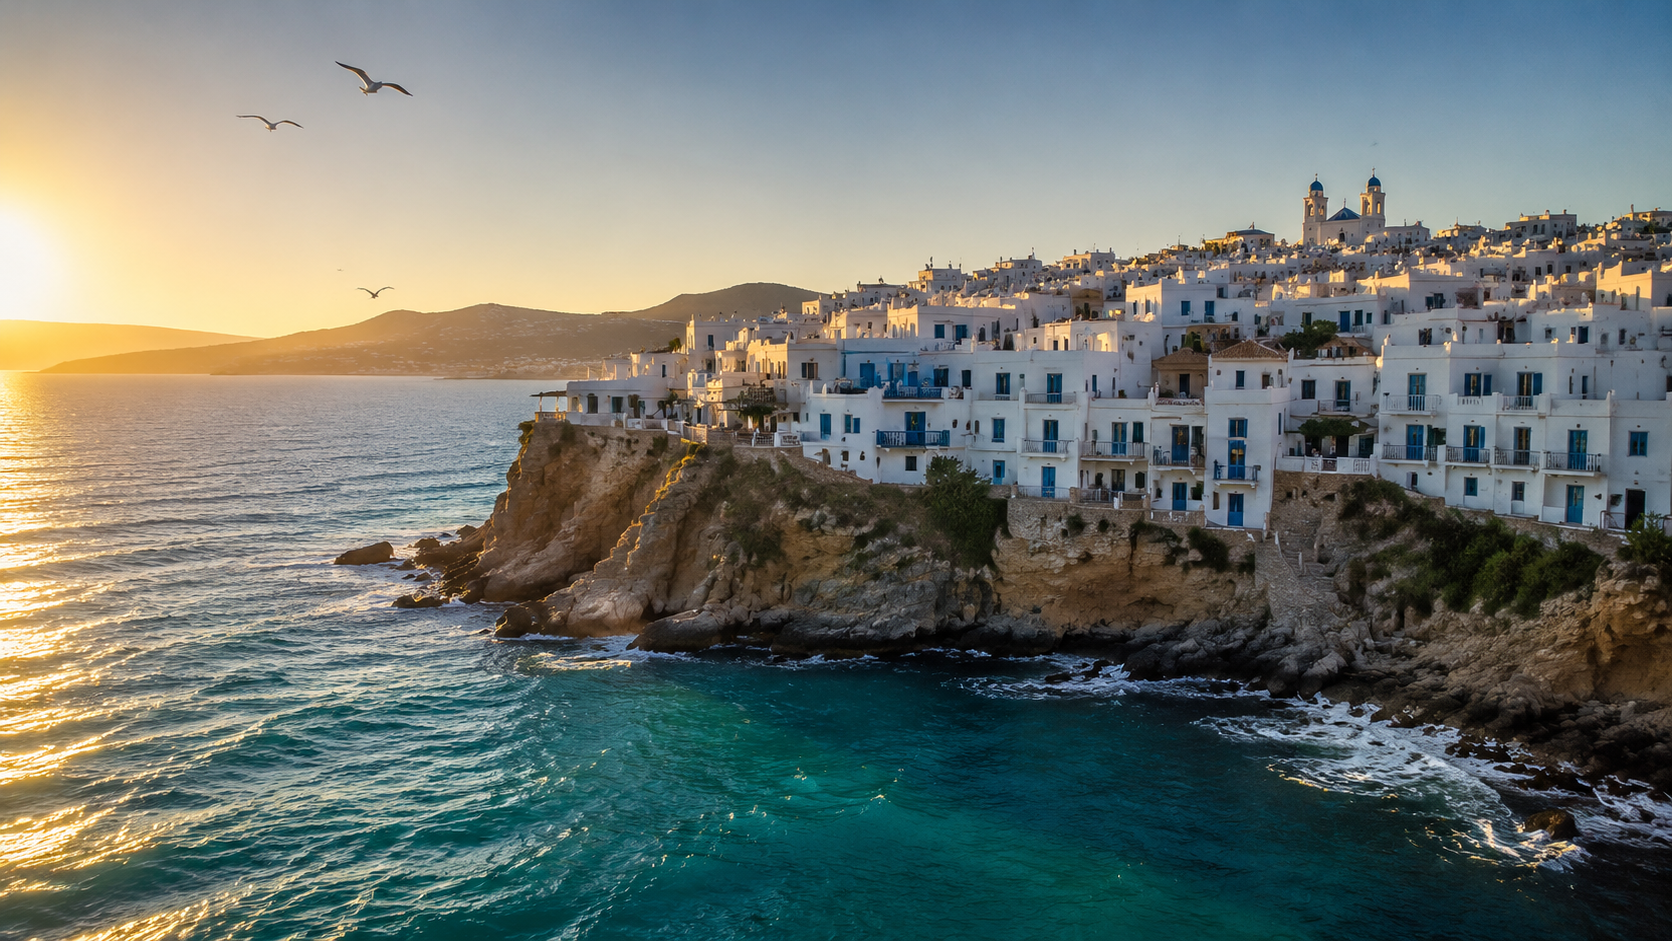
配方 1 的反面:世界静止,镜头旅行。输入帧——黄金时刻的宽阔海岸村庄:
提示词:
缓慢的电影式推近:相机在水面上方向前滑行,朝悬崖村庄推进,然后随着继续前进,平滑过渡为沿海岸线向右的轻柔平移。海浪拍打下方的岩石;海鸥缓慢掠过画面。黄金时刻的光线保持恒定。平滑、稳定的云台式运动,无剪辑。
参数:resolution: 720P、duration: 4——费用 $0.40。
一次成片输出:
将片段的最后一秒与输入帧对比:相机确实移动了——村庄充满画面,悬崖与背景山丘之间的视差是正确的,而不是虚假的 Ken Burns 变焦。模式是:命名运动、排列运动顺序、定义运动风格。“推近,然后向右平移”给了它轨迹;“云台式、无剪辑”设定了阻尼;“光线保持恒定”防止黄金时刻在你眼前变成延时摄影。
速查表
综合这些以及我们之前的运行,wan2.7 i2v 提示词遵循五条规则:
- 帧是场景;提示词是运动。不要重新描述画面——只把画面中的名词用作动词的锚点(“盒盖”“杯子”“海岸线”)。
- 每个片段只放一个主体表演 + 一条相机指令。把两类复杂度叠加起来,短片段就会变得混乱。
- 按顺序写舞台指示。模型会按写出的顺序执行动作链——这就是你在 5 秒片段中的时间线控制。
- 说明什么不能动。“相机保持锁定不动”和“光线保持恒定”会被遵守,并能抑制模型的默认漂移。
- 用环境运动换取真实感。热气、雨、海浪、飞鸟——每项只需一个短句,感知质量回报很大。
费用
wan2.7-video/image-to-video 按标准的每秒计费,费率由输出分辨率决定:
| 分辨率 | 价格 | 5 秒片段 | 15 秒片段(最大) |
|---|---|---|---|
| 720P | 每秒 $0.10 | $0.50 | $1.50 |
| 1080P | 每秒 $0.167 | $0.835 | $2.505 |
本文中的全部三个片段——14 秒完成的 720P 视频(在实际输出上测得为 1280×720、30 fps)——总计花费 $1.40,而且整批任务在提交后约九分钟内完成,因为任务在服务端并行运行。当前费率始终可在价格页面查看。
如果你想要运动效果但不想先找一张帧图,同系列的 wan2.7-video/text-to-video 以相同的每秒价格运行,并支持原生音频和同样的 15 秒上限——我们在短视频指南中做了端到端介绍。
试一试
任选上面三条提示词之一,换成你自己的首帧,几分钟内就能以远低于一美元的价格拿回一个片段。wan2.7-video/image-to-video 模型页面提供实时参数参考和交互式 playground——先从 4 秒 720P 片段($0.40)开始,在提示词上迭代,然后再决定是否提交 1080P 渲染。


