
Guida all'uso
Ricette di prompt per image-to-video di Wan 2.7: 3 prompt copia-incolla e output reali
Tre ricette di prompt one-shot per wan2.7-video/image-to-video — movimento del prodotto a camera bloccata, micro-recitazione del ritratto e viaggio con movimento di camera realistico — ciascuna con frame di input, prompt preciso, clip di output incorporata e prezzi di tier standard verificati.
L'image-to-video è il modo con la massima leva per usare un modello video: blocchi composizione, illuminazione e soggetto con una singola immagine statica e spendi tutta la capacità del modello sul movimento. Il problema è che il prompt i2v è una competenza a sé stante — la maggior parte dei prompt che funzionano per il text-to-video spreca una grande quantità di token per ridescriere una scena che il modello già vede.
Questa guida ti fornisce tre ricette di prompt copia-incolla per wan2.7-video/image-to-video, il modello image-to-video Tongyi Wanxiang 2.7 di Alibaba, che coprono le tre categorie di attività per cui le persone usano davvero i2v: movimento del prodotto, recitazione del ritratto e movimento di camera. Ogni clip incorporata qui sotto è l'output one-shot reale del prompt corrispondente — generato tramite l'API task di hiapi al tier standard 720P ($0.10 al secondo di video). Anche i frame di input sono inclusi, così puoi tracciare esattamente cosa ha ricevuto il modello e cosa ha creato.
Struttura della richiesta (leggi prima)
wan2.7 i2v gira sull'endpoint task asincrono di hiapi. Tre dettagli dello schema ti risparmiano un round di errori 400:
mediaè un array di oggetti, non una stringa URL nuda. Ogni oggetto richiedetypeeurl. I tipi accettati sonofirst_frame,last_frame,driving_audioefirst_clip— quindi lo stesso endpoint copre l'animazione standard del primo frame, l'interpolazione primo-ultimo frame, il movimento guidato dall'audio e l'estensione della clip. Tutto in questo articolo passa solo unfirst_frame.resolutionè un enum:720Po1080P, nessun altro valore.durationè in secondi, con un massimo di 15.
L'URL dell'immagine deve essere accessibile pubblicamente — la piattaforma lo scarica lato server al momento della creazione del task.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/image-to-video",
    "input": {
      "prompt": "il coperchio della custodia di ricarica si apre dolcemente verso l'alto, due auricolari neri opachi si sollevano lentamente dalla custodia……",
      "media": [
        {"type": "first_frame", "url": "https://your-cdn.example/frame.jpg"}
      ],
      "resolution": "720P",
      "duration": 5
    }
  }'
La risposta restituisce immediatamente un taskId. Fai polling su GET /v1/tasks/{taskId} finché status non è success, poi scarica output[0].url:
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}

task_id = requests.post(BASE, headers=HEADERS, json=payload).json()["data"]["taskId"]

while True:
    task = requests.get(f"{BASE}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] == "success":
        video = requests.get(task["output"][0]["url"]).content
        open("clip.mp4", "wb").write(video)
        break
    if task["status"] == "fail":
        raise RuntimeError(task.get("error"))
    time.sleep(10)
Una nota operativa: output[0].url è un link a scadenza con timestamp expireAt. Scarica il file e salvalo nel tuo bucket di storage subito dopo il successo del task — qui scopri cosa succede se non lo fai.
Ricetta 1: movimento del prodotto a camera bloccata
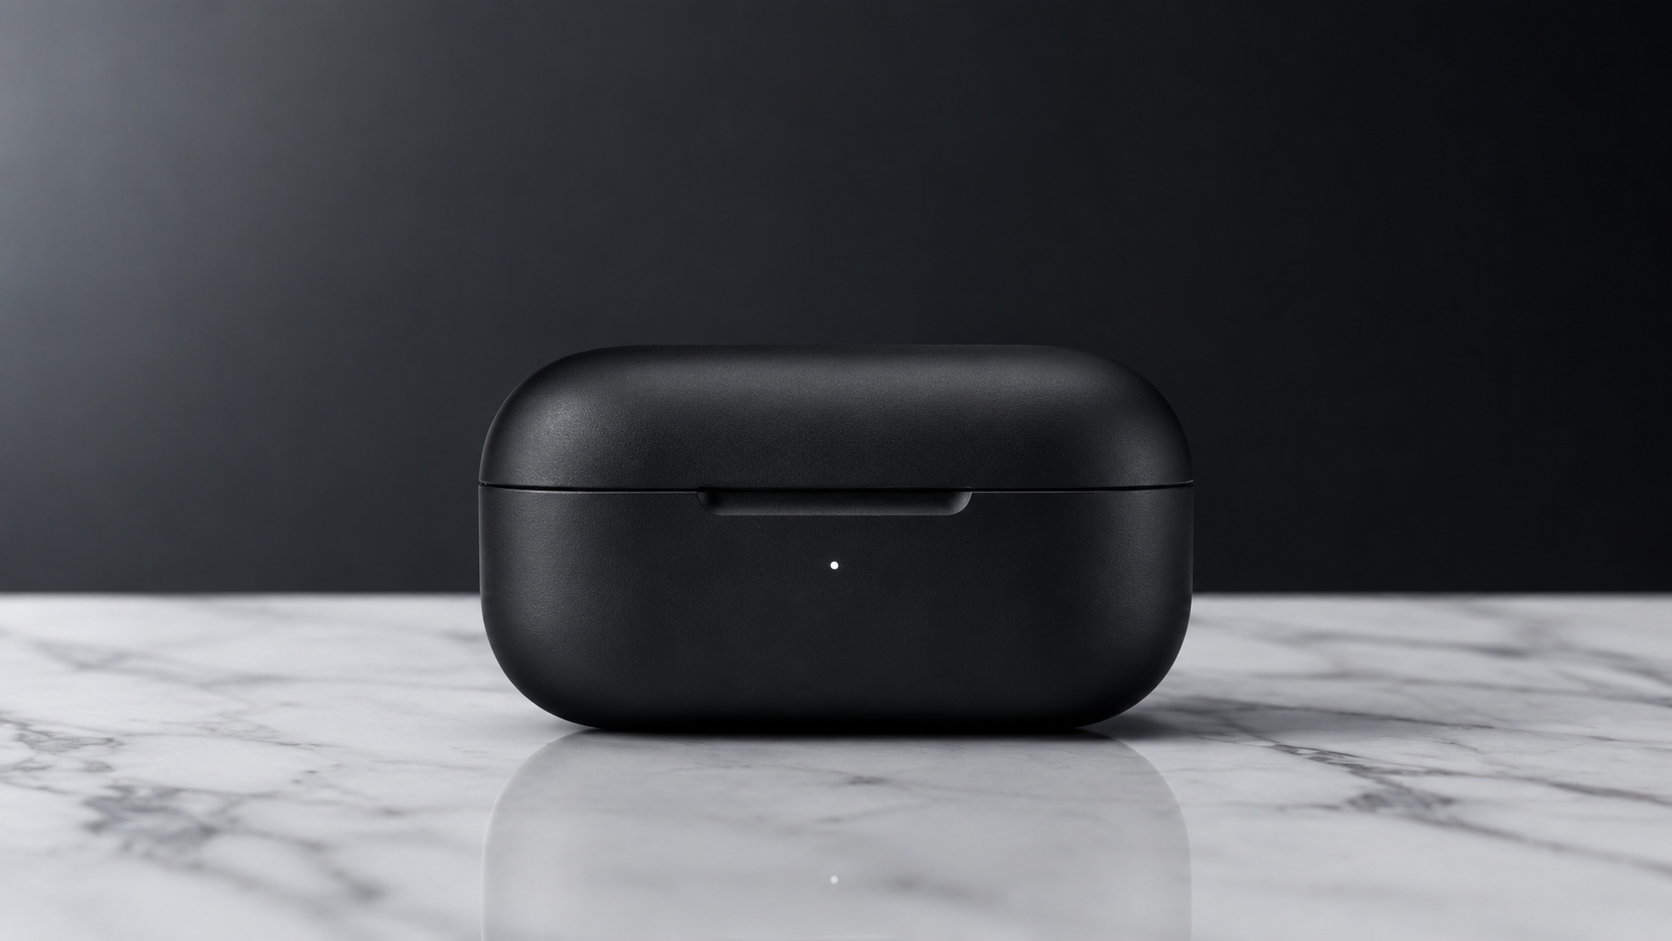
Il classico loop dell'immagine principale e-commerce: il prodotto si muove, la camera no. Partiamo da questa immagine di una custodia di auricolari chiusa, fotografata in studio con gpt-image-2:
Prompt:
Il coperchio della custodia di ricarica si apre dolcemente verso l'alto, due auricolari neri opachi si sollevano lentamente dalla custodia e si librano sopra di essa, ruotando lentamente in sincronia mentre si sollevano. Mentre ruotano, una morbida luce da studio scorre sulle loro superfici. La camera è completamente bloccata e immobile; una profondità di campo ridotta mantiene la messa a fuoco sugli auricolari. Estetica da lancio prodotto pulita e premium, nessun movimento di camera.
Parametri: resolution: 720P, duration: 5 — costo $0.50.
Output one-shot:
Il modello ha creato da solo l'interno della custodia e gli auricolari stessi — entrambi assenti nel frame di input — e ha mantenuto la coerenza dei riflessi sul marmo mentre il coperchio oscillava. Due cose nel prompt sono state determinanti: gli stati dell'oggetto nominati in sequenza (coperchio che si apre → auricolari che si sollevano → sospensione → rotazione sincronizzata) e la camera esplicitamente istruita a non fare nulla, e detto due volte (completamente bloccata e immobile… nessun movimento di camera). I vincoli negativi sul movimento vengono rispettati; senza di essi, i modelli i2v tendono ad aggiungere drift o zoom che non hai richiesto.
Ricetta 2: micro-recitazione del ritratto
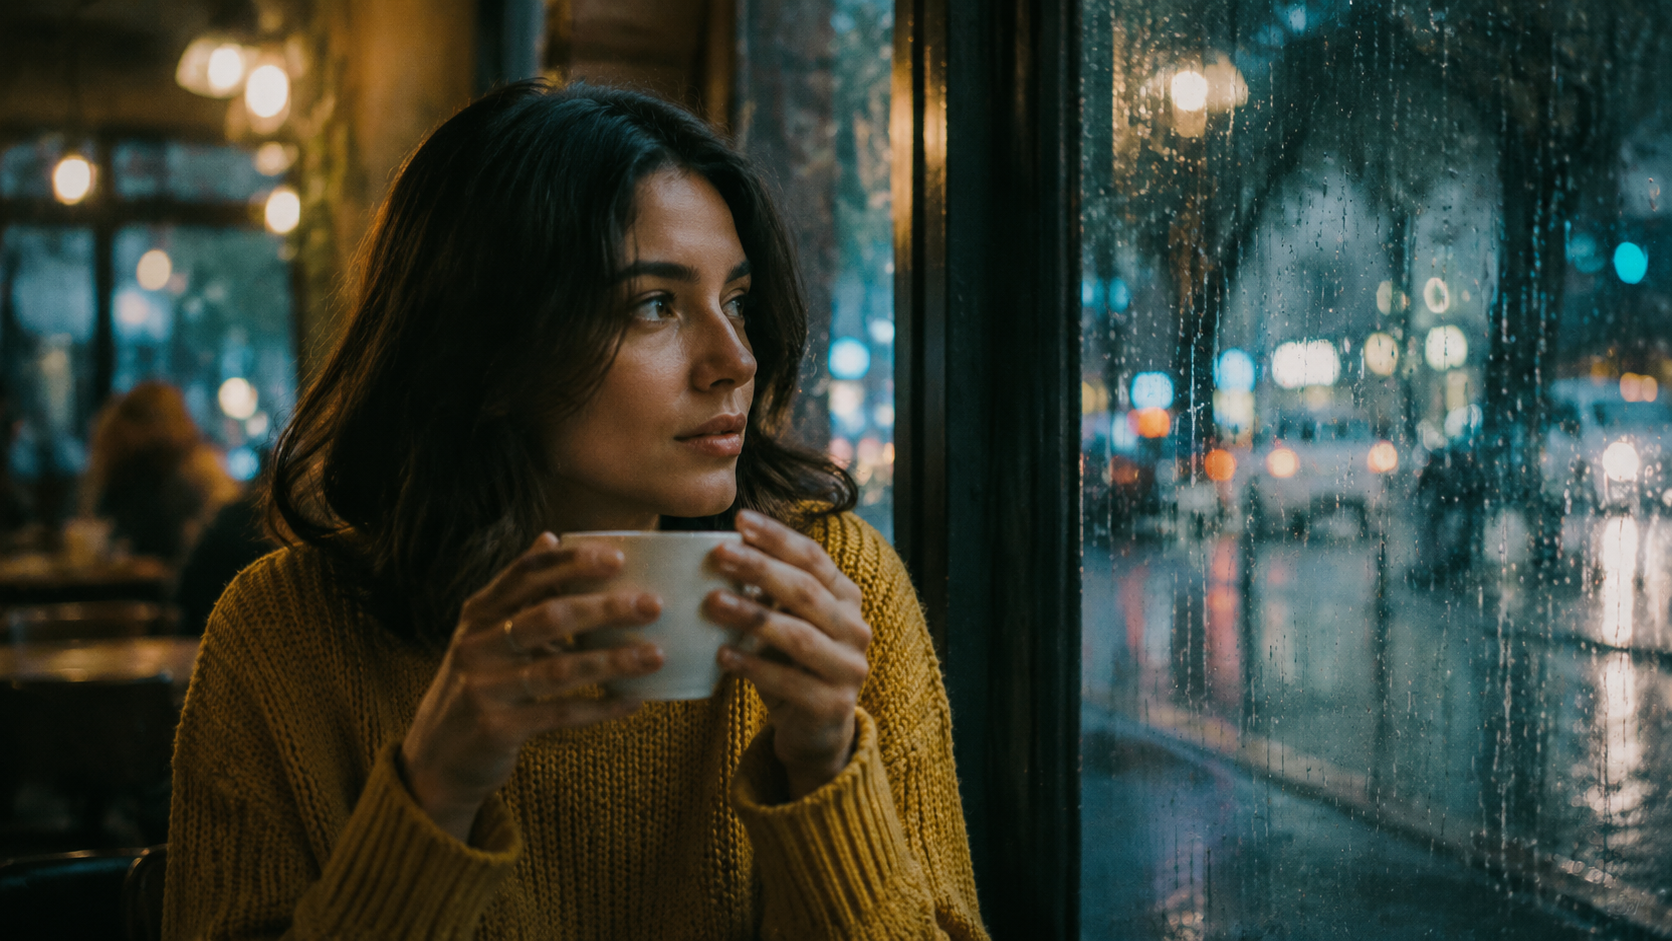
Animare una persona è dove i2v dà il meglio — casting, abbigliamento e illuminazione sono già risolti dal frame. Anche l'input viene da gpt-image-2:
Prompt:
La donna solleva delicatamente la tazza, ne beve un sorso lento e silenzioso, poi la posa e gira la testa verso la finestra rigata dalla pioggia, con un sorriso dolce. Il vapore sale dalla tazza; le gocce di pioggia scivolano sul vetro dietro di lei. I suoi capelli oscillano leggermente mentre si muove. La camera resta ferma, con il fuoco che passa dolcemente dalla tazza al suo viso. Movimento caldo, pacato e cinematografico.
Parametri: resolution: 720P, duration: 5 — costo $0.50.
Output one-shot:
La ricetta qui è una catena di due o tre piccole azioni in ordine esplicito (solleva → beve → posa → gira la testa → sorride). wan2.7 le esegue una per una nell'ordine scritto, ed è questo che fa leggere la clip come una recitazione invece che come una GIF in loop. L'altra metà è il movimento secondario: vapore, gocce di pioggia e capelli sono facili da richiedere, e portano gran parte del realismo. Mantieni gentile la direzione del viso ("sorriso dolce", non "risata fragorosa") — le micro-espressioni sopravvivono; le espressioni esagerate sono un azzardo.
Ricetta 3: movimento di camera su una scena statica
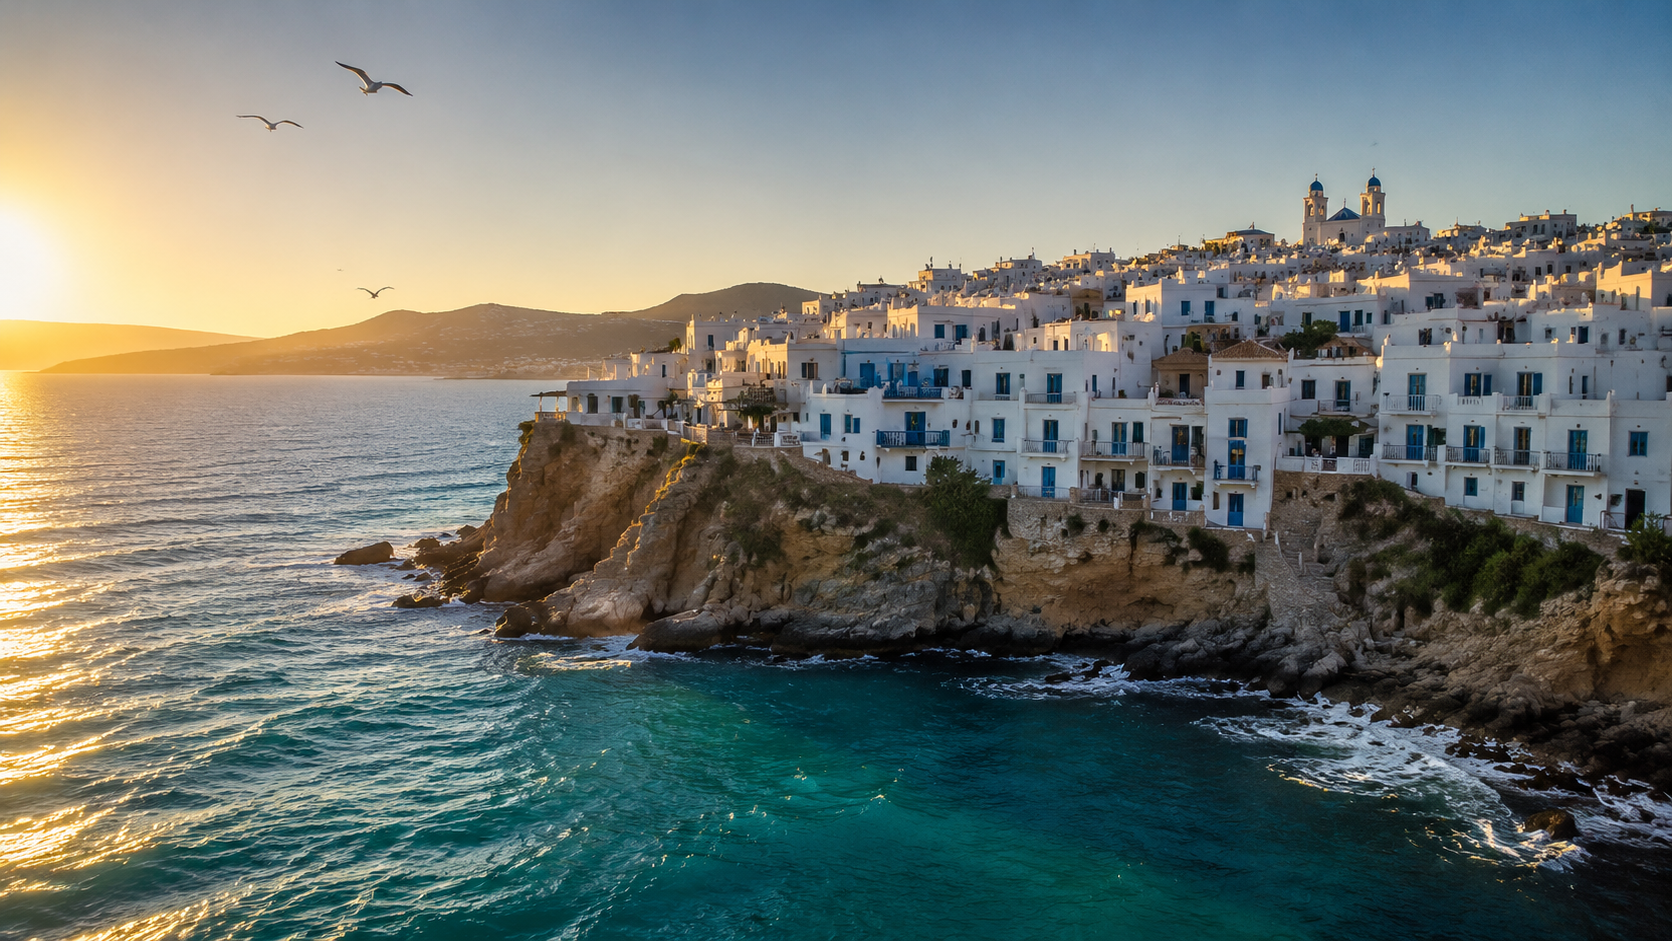
Il contrario della Ricetta 1: il mondo è fermo, la camera viaggia. Frame di input — un ampio villaggio costiero all'ora d'oro:
Prompt:
Lento push-in cinematografico: la camera scivola in avanti sopra l'acqua, avanzando verso il villaggio sulla scogliera, poi, continuando, passa dolcemente a una leggera panoramica verso destra lungo la costa. Le onde si infrangono sulle rocce sottostanti; i gabbiani attraversano lentamente l'inquadratura. La luce dell'ora d'oro resta costante. Movimento fluido e stabile su testa fluida, senza tagli.
Parametri: resolution: 720P, duration: 4 — costo $0.40.
Output one-shot:
Confronta l'ultimo secondo della clip con il frame di input: la camera si è davvero mossa — il villaggio riempie l'inquadratura, e la parallasse tra la scogliera e le colline sullo sfondo è corretta, non un finto zoom alla Ken Burns. Il pattern è: nomina il movimento, ordinalo, definisci lo stile del movimento. "Push-in, poi panoramica a destra" gli dà la traiettoria; "su testa fluida, senza tagli" imposta lo smorzamento; "la luce resta costante" impedisce che l'ora d'oro si trasformi in timelapse davanti ai tuoi occhi.
Cheat sheet
Combinando queste con le nostre esecuzioni precedenti, i prompt i2v di wan2.7 seguono cinque regole:
- Il frame è la scena; il prompt è il movimento. Non ridescrivere l'immagine — usa i nomi presenti nell'immagine solo come ancore per i verbi ("coperchio", "tazza", "costa").
- Una sola performance del soggetto + una sola istruzione di camera per clip. Sovrapporre i due tipi di complessità rende caotica una clip breve.
- Scrivi le indicazioni di scena in ordine. Il modello esegue le catene di azioni nell'ordine scritto — è questo il tuo controllo della timeline in una clip di 5 secondi.
- Specifica cosa non deve muoversi. "La camera resta bloccata e immobile" e "la luce resta costante" vengono rispettate e sopprimono il drift predefinito del modello.
- Baratta il movimento ambientale con il realismo. Vapore, pioggia, onde, uccelli — ognuno richiede solo una frase breve e ha un grande ritorno in qualità percepita.
Costi
wan2.7-video/image-to-video è fatturato al secondo secondo la tariffa standard, determinata dalla risoluzione di output:
| Risoluzione | Prezzo | Clip da 5 secondi | Clip da 15 secondi (max) |
|---|---|---|---|
| 720P | $0.10 al secondo | $0.50 | $1.50 |
| 1080P | $0.167 al secondo | $0.835 | $2.505 |
Tutte e tre le clip di questo articolo — 14 secondi di video 720P completati (misurati sull'output reale a 1280×720, 30 fps) — sono costate in totale $1.40, e l'intero batch è stato completato circa nove minuti dopo l'invio, perché i task girano in parallelo lato server. Le tariffe attuali sono sempre visibili nella pagina dei prezzi.
Se vuoi l'effetto movimento ma non vuoi prima trovare un frame, wan2.7-video/text-to-video della stessa famiglia gira allo stesso prezzo al secondo e supporta audio nativo e lo stesso limite di 15 secondi — lo abbiamo trattato end-to-end nella guida ai video brevi.
Provalo
Scegli uno dei tre prompt qui sopra, sostituisci il tuo primo frame e in pochi minuti avrai indietro una clip a molto meno di un dollaro. La pagina del modello wan2.7-video/image-to-video offre un riferimento live dei parametri e un playground interattivo — inizia con una clip da 4 secondi a 720P ($0.40), itera sul prompt, poi decidi se inviare un rendering 1080P.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori