
使用ガイド
Wan 2.7 画像から動画へのプロンプトレシピ:コピー&ペースト可能な3つのプロンプトと実際の出力
wan2.7-video/image-to-video 向けの3つの一発撮りプロンプトレシピ——固定カメラ下での製品の動き、ポートレートの微細な演技、リアルなカメラワークの旅行映像——各レシピに入力フレーム、正確なプロンプト、埋め込み出力クリップ、検証済みの標準プラン価格を掲載。
画像から動画への生成は、動画モデルを使う上で最もレバレッジの効く方法です。静止画で構図・照明・被写体を固定し、モデルの能力をすべて動きに注ぎ込めるからです。問題は、i2v のプロンプト自体が独立したスキルだという点です——テキストから動画向けのプロンプトのほとんどは、モデルがすでに見えているシーンを再説明するために大量のトークンを浪費してしまいます。
本ガイドでは、wan2.7-video/image-to-video(Alibaba の通義万相 2.7 画像から動画モデル)向けのコピー&ペースト可能な3つのプロンプトレシピを提供します。実際に i2v が使われる3つのタスク——製品の動き、ポートレートの演技、カメラワーク——をカバーします。以下に埋め込まれた各クリップは、対応するプロンプトによる実際の一発撮り出力です——hiapi のタスク API を通じて標準 720P プラン(動画1秒あたり $0.10)で生成しました。入力フレームも併記しているので、モデルが何を受け取り、何を生み出したかを正確に追跡できます。
リクエスト構造(まずお読みください)
wan2.7 i2v は hiapi の非同期タスクエンドポイントで動作します。3つの schema の詳細を知っておくと、400 エラーを1ラウンド節約できます:
mediaはオブジェクトの配列であり、生の URL 文字列ではありません。各オブジェクトにはtypeとurlが必要です。受け付けるタイプはfirst_frame、last_frame、driving_audio、first_clip——つまり同じエンドポイントで、通常の先頭フレームアニメーション、先頭・末尾フレーム補間、音声駆動の動き、クリップ延長をすべてカバーできます。本記事のすべての例ではfirst_frameを1つだけ渡しています。resolutionは列挙型:720Pまたは1080Pのみで、他の値はありません。durationは秒単位で、上限は 15。
画像 URL は公開アクセス可能である必要があります——プラットフォームはタスク作成時にサーバー側でそれをダウンロードします。
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/image-to-video",
    "input": {
      "prompt": "充電ケースの蓋が滑らかに上へ開き、2つのマットブラックのイヤホンがゆっくりとケースからせり上がる……",
      "media": [
        {"type": "first_frame", "url": "https://your-cdn.example/frame.jpg"}
      ],
      "resolution": "720P",
      "duration": 5
    }
  }'
レスポンスは即座に taskId を返します。status が success になるまで GET /v1/tasks/{taskId} をポーリングし、その後 output[0].url をダウンロードします:
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}

task_id = requests.post(BASE, headers=HEADERS, json=payload).json()["data"]["taskId"]

while True:
    task = requests.get(f"{BASE}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] == "success":
        video = requests.get(task["output"][0]["url"]).content
        open("clip.mp4", "wb").write(video)
        break
    if task["status"] == "fail":
        raise RuntimeError(task.get("error"))
    time.sleep(10)
運用上のヒント:output[0].url は expireAt タイムスタンプ付きの期限付きリンクです。タスク成功後はすぐにファイルをダウンロードして自分のストレージバケットに保存してください——そうしないとどうなるかはこちらをご覧ください。
レシピ 1:固定カメラ下での製品の動き
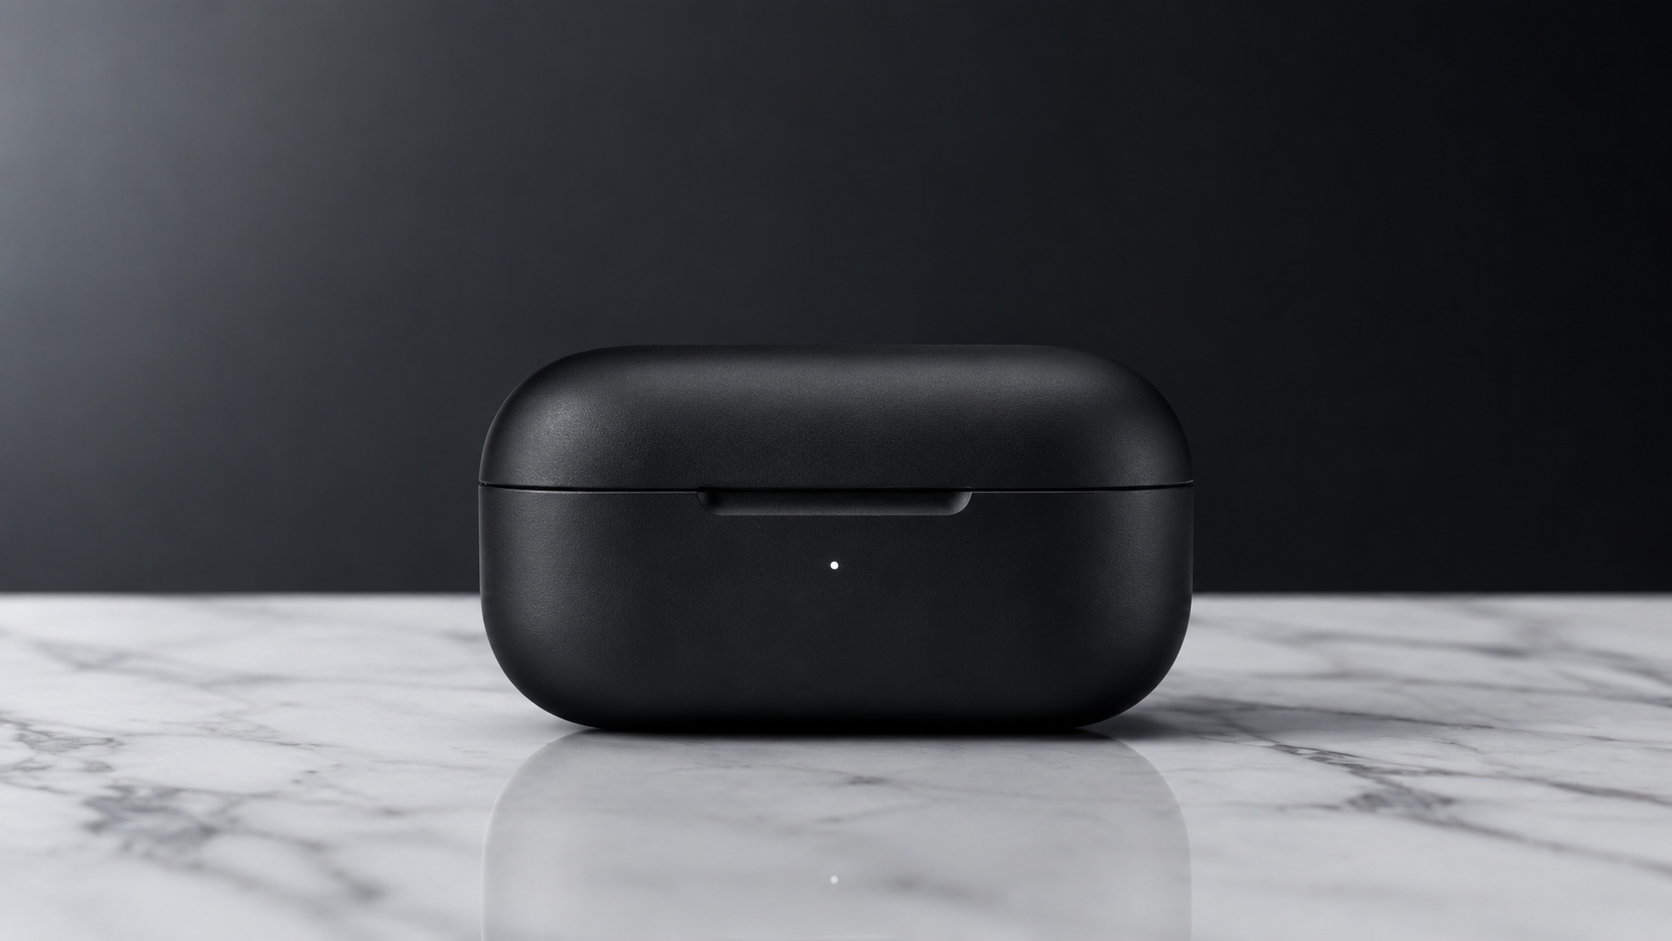
定番の EC メイン画像ループ:製品が動き、カメラは動かない。まずはこの gpt-image-2 でスタジオ撮影した閉じたイヤホンケースの画像から始めます:
プロンプト:
充電ケースの蓋が滑らかに上へ開き、2つのマットブラックのイヤホンがゆっくりとケースからせり上がり、ケースの上でホバリングしながら、同期してゆっくり回転する。それらが回転するとき、柔らかなスタジオ光がその表面を閃く。カメラは完全に固定されて動かない;浅い被写界深度がイヤホンに焦点を保つ。クリーンでプレミアムな製品発表の美学、カメラの動きなし。
パラメータ:resolution: 720P、duration: 5——費用 $0.50。
一発撮り出力:
モデルはケースの内部とイヤホン自体を自ら創造しました——入力フレームにはどちらも存在しません——そして蓋が揺れる間も大理石の反射の一貫性を保ちました。プロンプトで鍵となったのは2点:物体の状態を順序立てて指定したこと(蓋が開く → イヤホンがせり上がる → ホバリング → 同期回転)、そしてカメラに対して何もしないよう明確に指示し、しかもそれを2回述べたことです(完全に固定されて動かない……カメラの動きなし)。ネガティブな動きの制約は遵守されます;それがないと、i2v モデルは頼んでいないドリフトやズームを加えがちです。
レシピ 2:ポートレートの微細な演技
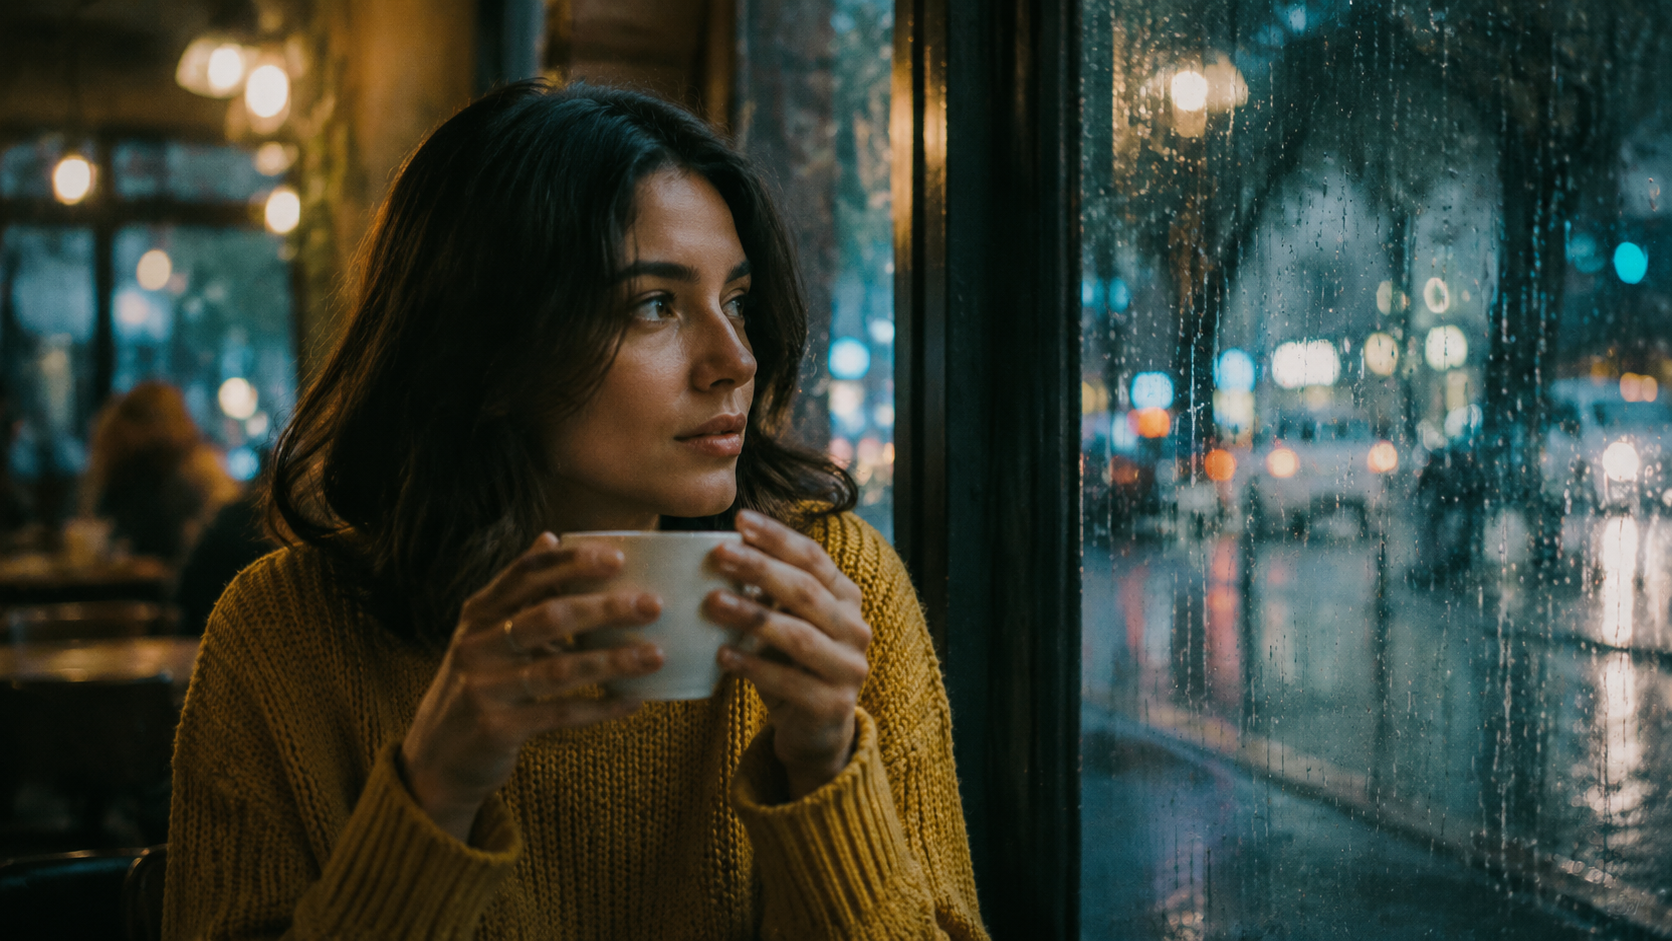
人物をアニメーション化することこそ i2v が価値を発揮する場面です——キャスティング、衣装、照明はすべてフレームがすでに解決しています。入力も同様に gpt-image-2 から:
プロンプト:
女性はそっとカップを持ち上げ、ゆっくりと静かに一口すする。そしてカップを置き、雨の筋がついた窓の外へ顔を向け、柔らかな微笑みを浮かべる。湯気がカップの縁から立ち上る;雨粒が彼女の背後のガラスを伝って流れ落ちる。彼女が動くと髪がわずかに揺れる。カメラは静止したまま、焦点はカップから彼女の顔へと柔らかに移る。温かく、落ち着いた、映画のような動き。
パラメータ:resolution: 720P、duration: 5——費用 $0.50。
一発撮り出力:
ここでのレシピは明確な順序で並べた2〜3の小さな動作の連鎖です(持ち上げる → すする → 置く → 顔を向ける → 微笑む)。wan2.7 は書かれた順序どおりに一つずつ実行し、まさにそれがクリップをループする GIF ではなく演技のように読ませる理由です。もう半分は二次的な動き:湯気、雨粒、髪は要求するのが容易で、それらがリアリズムの大部分を担っています。顔の向きは穏やかに(「大笑い」ではなく「柔らかな微笑み」)——繊細な表情は生き残りますが、誇張された表情は賭けです。
レシピ 3:静的なシーン上でのカメラワーク
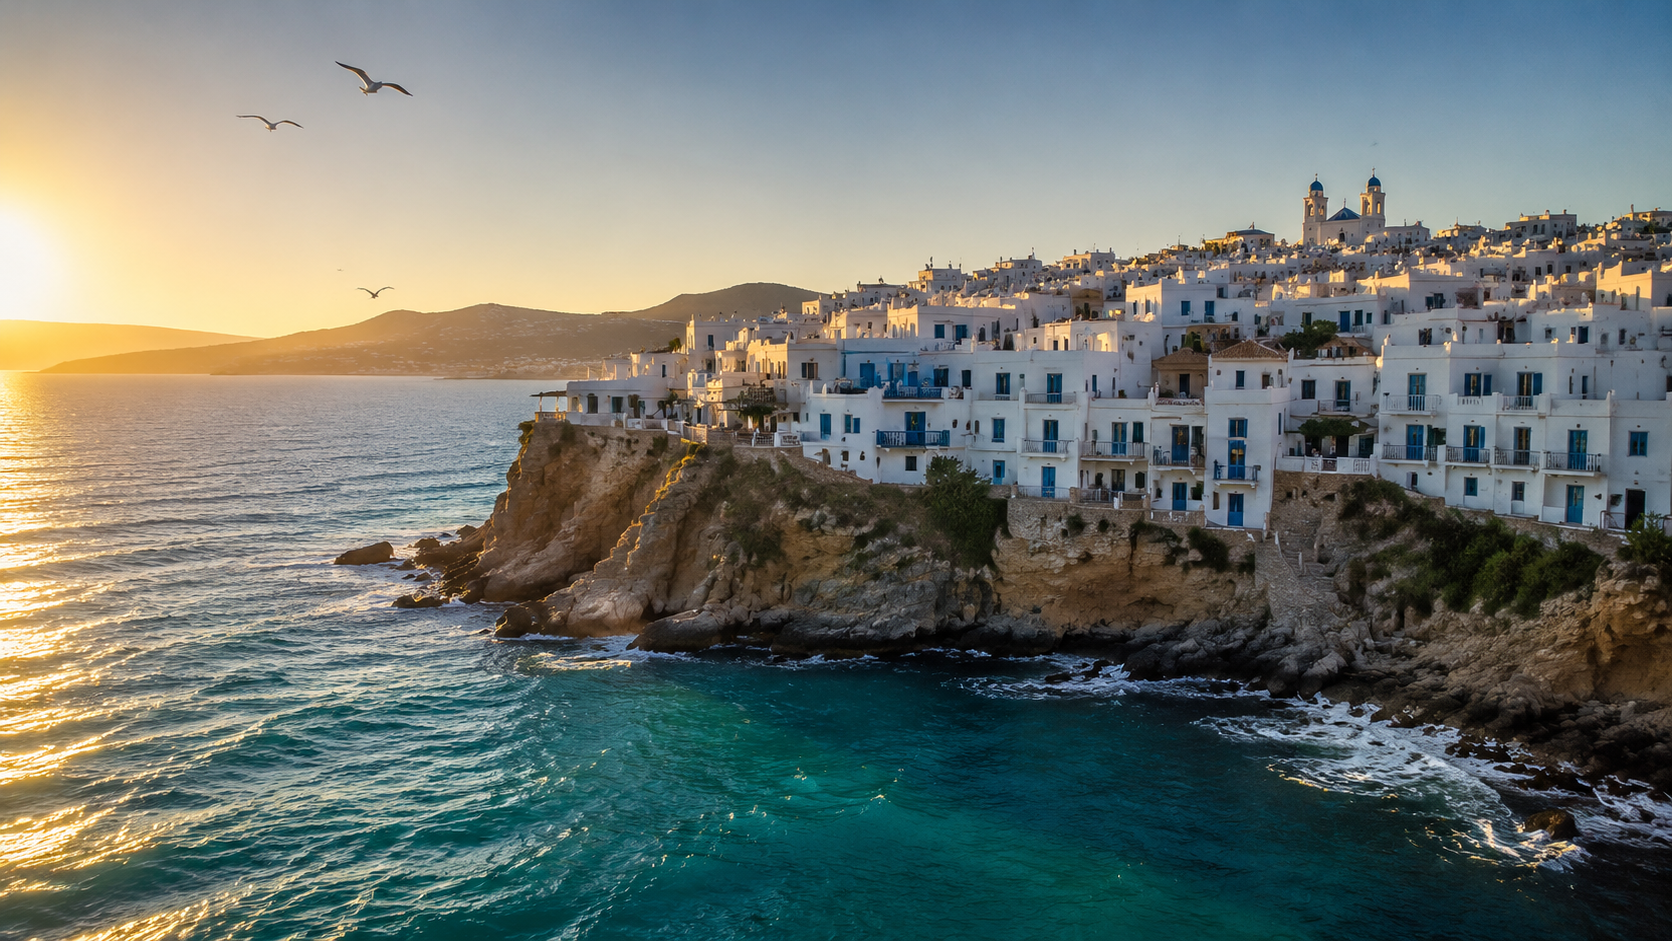
レシピ 1 の逆:世界は静止し、カメラが旅する。入力フレーム——ゴールデンアワーの広い海岸の村:
プロンプト:
ゆっくりとした映画的なプッシュイン:カメラは水面の上を前方へ滑るように進み、崖の村へと近づき、そのまま進みながら海岸線に沿って右への穏やかなパンへと滑らかに移行する。波が下の岩に打ち寄せる;カモメがゆっくりと画面を横切る。ゴールデンアワーの光は一定に保たれる。滑らかで安定した雲台のような動き、カットなし。
パラメータ:resolution: 720P、duration: 4——費用 $0.40。
一発撮り出力:
クリップの最後の1秒を入力フレームと比較してください:カメラは確かに動いています——村が画面いっぱいに広がり、崖と背後の丘との間の視差は正しく、偽物の Ken Burns ズームではありません。パターンは:動きを名づけ、動きを順序立て、動きのスタイルを定義する。「プッシュイン、その後右へパン」が軌道を与え;「雲台式、カットなし」が減衰を設定し;「光は一定に保たれる」がゴールデンアワーが目の前でタイムラプスに変わるのを防ぎます。
クイックリファレンス
これらと以前の実行を総合すると、wan2.7 i2v プロンプトは5つのルールに従います:
- フレームはシーン;プロンプトは動き。画面を再説明しない——画面内の名詞を動詞のアンカーとして使うだけ(「蓋」「カップ」「海岸線」)。
- 各クリップには被写体の演技を1つ+カメラ指示を1つだけ。両方の複雑さを重ねると、短いクリップは混乱します。
- 舞台指示は順序立てて書く。モデルは書かれた順で動作の連鎖を実行します——これが5秒クリップでのタイムライン制御です。
- 何が動いてはいけないかを明示する。「カメラは固定されて動かない」「光は一定に保たれる」は遵守され、モデルのデフォルトのドリフトを抑制します。
- 環境の動きでリアリズムを稼ぐ。湯気、雨、波、飛ぶ鳥——それぞれ短い一文だけで、知覚品質へのリターンは大きい。
料金
wan2.7-video/image-to-video は標準の秒単位課金で、料率は出力解像度によって決まります:
| 解像度 | 価格 | 5秒クリップ | 15秒クリップ(最大) |
|---|---|---|---|
| 720P | 1秒あたり $0.10 | $0.50 | $1.50 |
| 1080P | 1秒あたり $0.167 | $0.835 | $2.505 |
本記事の3つのクリップすべて——14秒分の完成した 720P 動画(実際の出力で 1280×720、30 fps と測定)——の合計費用は$1.40で、タスクはサーバー側で並列実行されるため、バッチ全体が送信後約9分で完了しました。現在の料率は常に価格ページで確認できます。
動きの効果は欲しいがフレーム画像を先に探したくない場合は、同シリーズの wan2.7-video/text-to-video が同じ秒単位価格で動作し、ネイティブ音声と同様の15秒上限をサポートします——ショート動画ガイドでエンドツーエンドで紹介しています。
試してみる
上記の3つのプロンプトのいずれかを選び、自分の先頭フレームに差し替えれば、数分以内に1ドルをはるかに下回る価格でクリップが返ってきます。wan2.7-video/image-to-video モデルページにはリアルタイムのパラメータリファレンスとインタラクティブな playground があります——まずは4秒の 720P クリップ($0.40)から始め、プロンプトを反復してから 1080P レンダリングを送信するか決めましょう。


