
Guia de uso
Receitas de prompts de imagem para vídeo do Wan 2.7: 3 prompts prontos para copiar e colar com saídas reais
Três receitas de prompts para o wan2.7-video/image-to-video que acertam de primeira — movimento de produto com câmera travada, microatuação de retrato e movimento de câmera realista em viagens — cada uma com o frame de entrada, o prompt exato, o clipe de saída incorporado e o preço padrão já verificado.
Imagem para vídeo é a forma de maior alavancagem de usar um modelo de vídeo: você trava a composição, a iluminação e o sujeito com uma única imagem estática e gasta toda a capacidade do modelo em movimento. O problema é que o prompt de i2v é uma habilidade à parte — a maioria dos prompts que funcionam em texto para vídeo desperdiça muitos tokens redescrevendo uma cena que o modelo já consegue ver.
Este guia traz três receitas de prompts prontos para copiar e colar, para o wan2.7-video/image-to-video, o modelo de imagem para vídeo Wan 2.7 da Alibaba Tongyi, cobrindo os três tipos de tarefa em que as pessoas realmente usam i2v: movimento de produto, atuação de retrato e movimento de câmera. Cada clipe incorporado abaixo é a saída real de uma única geração do prompt correspondente — gerado pela API de tarefas da hiapi no nível padrão 720P (US$ 0,10 por segundo de vídeo). Os frames de entrada também estão incluídos, então você pode acompanhar exatamente o que o modelo recebeu e o que ele criou.
Estrutura da requisição (leia primeiro)
O i2v do wan2.7 roda no endpoint de tarefas assíncronas da hiapi. Três detalhes do schema podem te poupar um erro 400:
mediaé um array de objetos, não uma string de URL solta. Cada objeto precisa detypeeurl. Os tipos aceitos sãofirst_frame,last_frame,driving_audioefirst_clip— assim o mesmo endpoint cobre animação de primeiro frame comum, interpolação entre primeiro e último frame, movimento guiado por áudio e extensão de clipe. Tudo neste artigo passa apenas umfirst_frame.resolutioné um enum:720Pou1080P, sem outros valores.durationé em segundos e tem limite máximo de 15.
A URL da imagem precisa ser publicamente acessível — a plataforma a baixa no lado do servidor ao criar a tarefa.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/image-to-video",
    "input": {
      "prompt": "A tampa do estojo de carregamento se abre suavemente para cima, dois fones preto fosco sobem lentamente de dentro do estojo……",
      "media": [
        {"type": "first_frame", "url": "https://your-cdn.example/frame.jpg"}
      ],
      "resolution": "720P",
      "duration": 5
    }
  }'
A resposta retorna imediatamente um taskId. Faça polling em GET /v1/tasks/{taskId} até que status seja success e então baixe output[0].url:
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}

task_id = requests.post(BASE, headers=HEADERS, json=payload).json()["data"]["taskId"]

while True:
    task = requests.get(f"{BASE}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] == "success":
        video = requests.get(task["output"][0]["url"]).content
        open("clip.mp4", "wb").write(video)
        break
    if task["status"] == "fail":
        raise RuntimeError(task.get("error"))
    time.sleep(10)
Uma dica operacional: output[0].url é um link temporário com timestamp de expireAt. Baixe o arquivo assim que a tarefa for concluída com sucesso e guarde no seu próprio bucket — veja aqui o que acontece se você não fizer isso.
Receita 1: movimento de produto com câmera travada
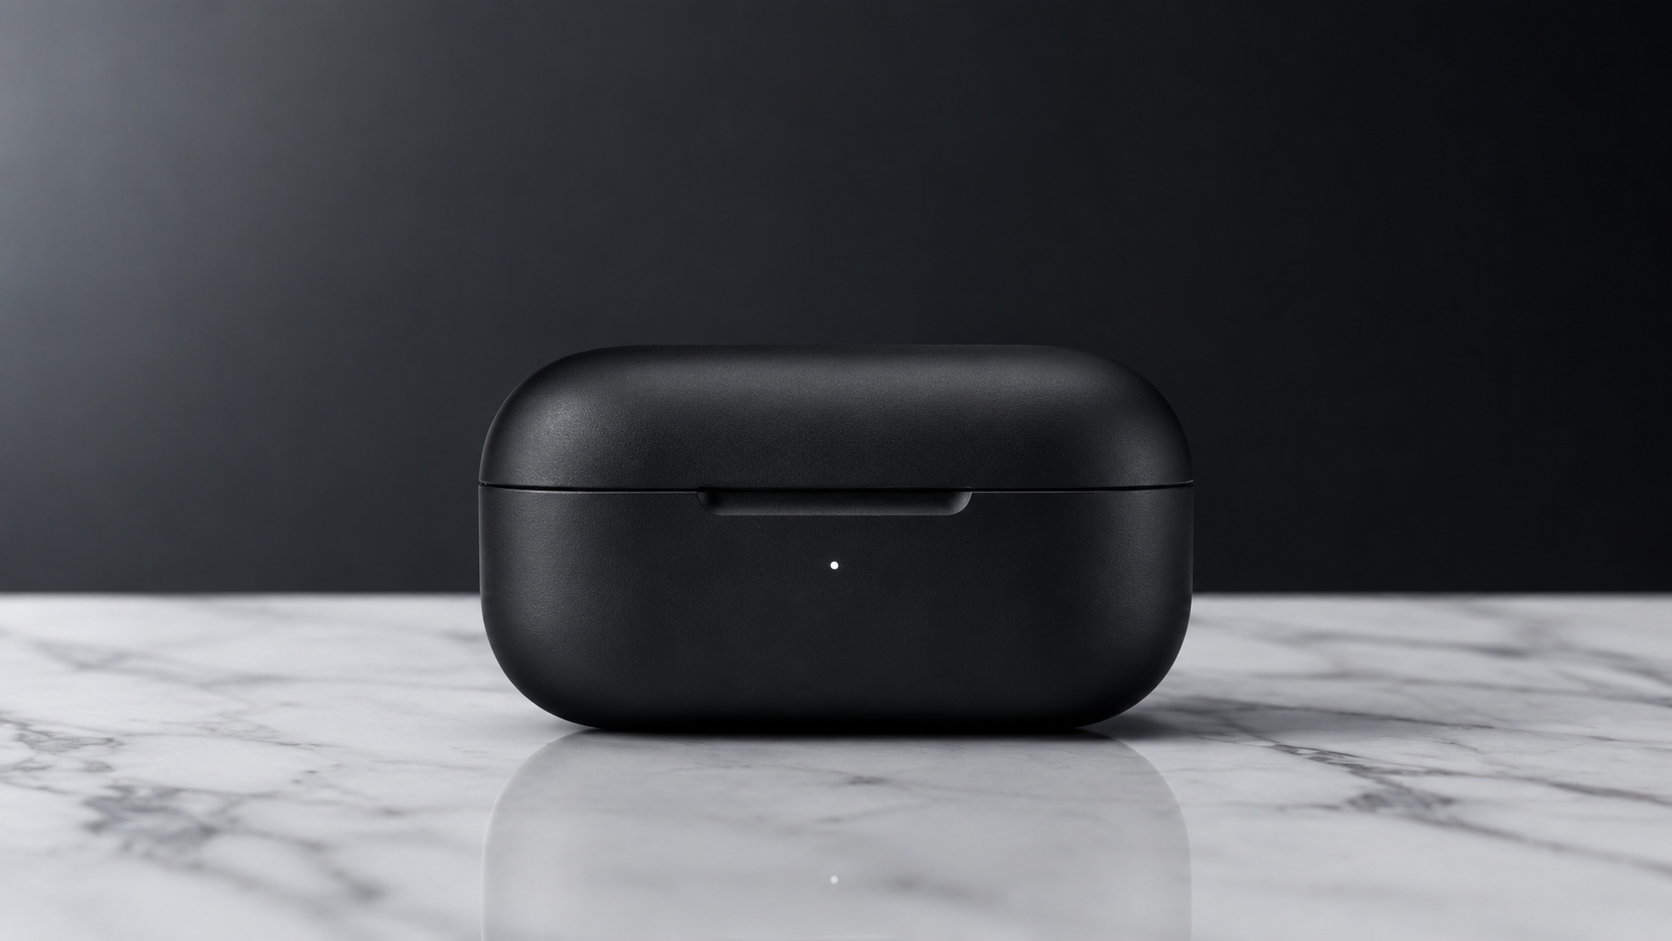
O loop clássico de imagem principal de e-commerce: o produto se move, a câmera não. Começamos com esta imagem de estojo de fones fechado, fotografado em estúdio com gpt-image-2:
Prompt:
A tampa do estojo de carregamento se abre suavemente para cima, dois fones preto fosco sobem lentamente de dentro do estojo, pairam acima dele enquanto giram lentamente em sincronia. À medida que giram, uma luz de estúdio suave desliza pelas superfícies. A câmera permanece totalmente travada e imóvel; a profundidade de campo rasa mantém o foco nos fones. Estética limpa e premium de lançamento de produto, sem movimento de câmera.
Parâmetros: resolution: 720P, duration: 5 — custo US$ 0,50.
Saída de uma única geração:
O modelo criou por conta própria o interior do estojo e os próprios fones — nenhum dos dois existia no frame de entrada — e manteve a coerência dos reflexos no mármore enquanto a tampa se movia. Duas coisas no prompt foram decisivas: os estados do objeto nomeados em sequência (tampa abre → fones sobem → pairam → giram em sincronia) e a câmera explicitamente instruída a não fazer nada, e isso dito duas vezes (totalmente travada e imóvel… sem movimento de câmera). Restrições negativas de movimento são respeitadas; sem elas, modelos de i2v costumam adicionar deriva ou zoom que você não pediu.
Receita 2: microatuação de retrato
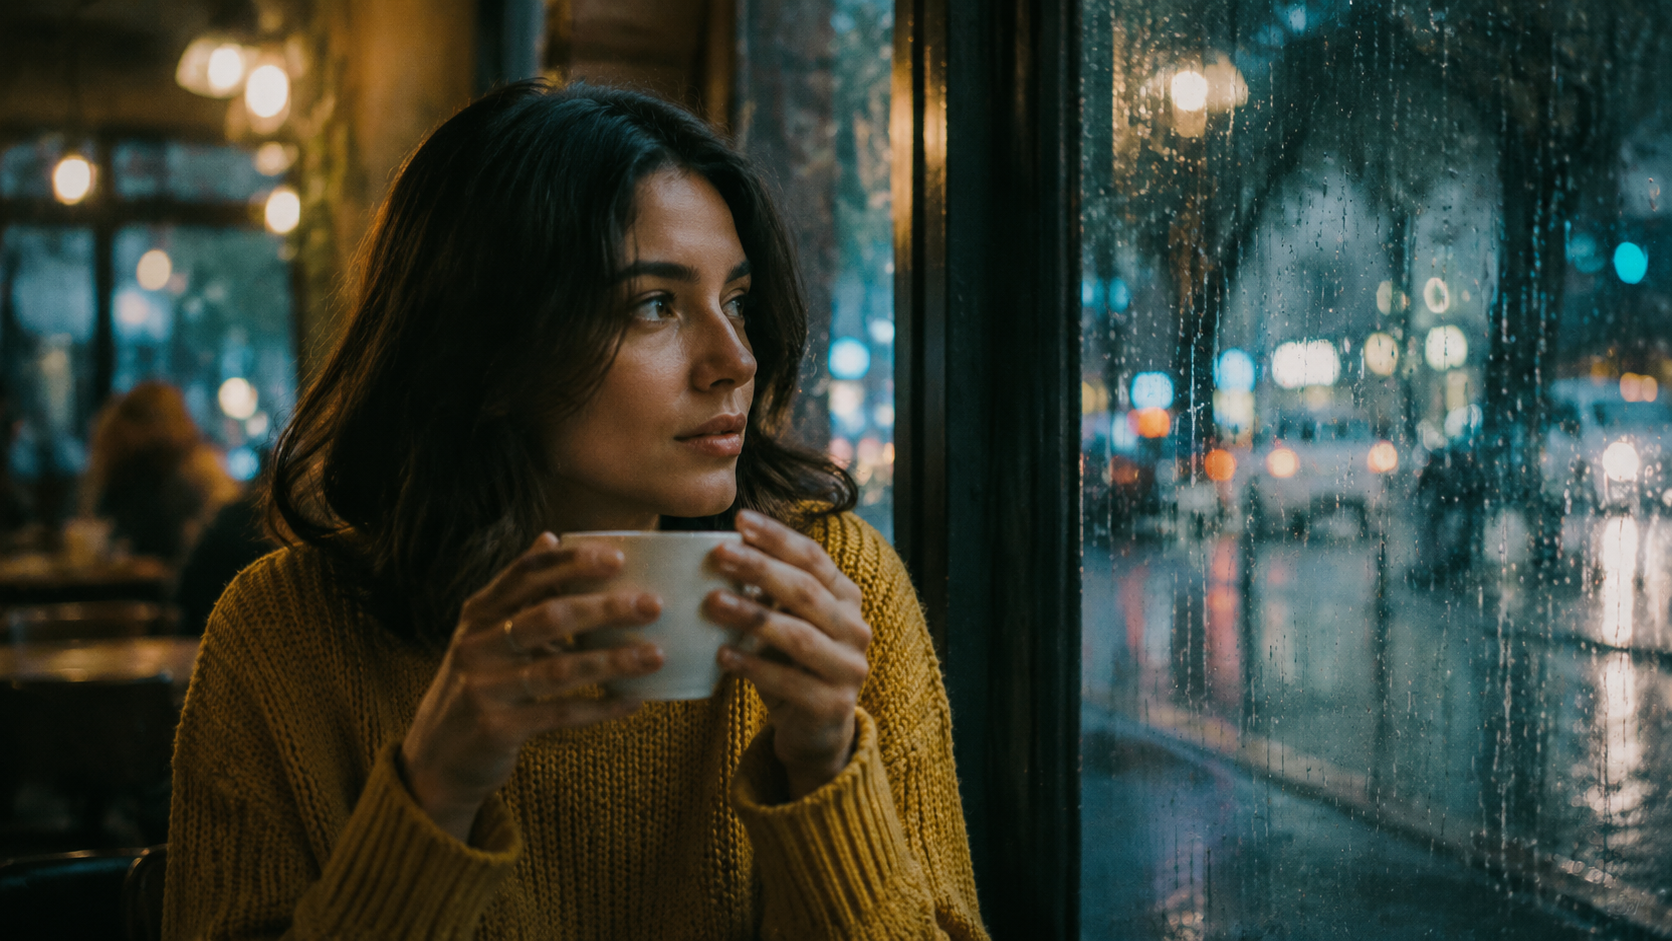
Animar pessoas é onde o i2v realmente compensa — elenco, figurino e iluminação já foram resolvidos pelo frame. A entrada também vem do gpt-image-2:
Prompt:
A mulher ergue a xícara suavemente, dá um gole lento e silencioso, depois abaixa a xícara, vira o rosto para a janela coberta de chuva e esboça um sorriso suave. O vapor sobe da borda da xícara; gotas de chuva escorrem pelo vidro atrás dela. O cabelo balança levemente enquanto ela se move. A câmera permanece estática, com o foco deslizando suavemente da xícara para o rosto dela. Movimento caloroso, contido e cinematográfico.
Parâmetros: resolution: 720P, duration: 5 — custo US$ 0,50.
Saída de uma única geração:
Aqui a receita é uma cadeia de dois ou três pequenos movimentos em ordem explícita (ergue → bebe → abaixa → vira → sorri). O wan2.7 executa na ordem escrita, e é exatamente isso que faz o clipe parecer uma atuação em vez de um GIF em loop. A outra metade é o movimento secundário: vapor, gotas de chuva e cabelo são fáceis de pedir e carregam a maior parte do realismo. Mantenha a direção do rosto contida (“sorriso suave”, não “gargalhada”) — microexpressões sobrevivem; expressões exageradas são uma aposta.
Receita 3: movimento de câmera sobre uma cena estática
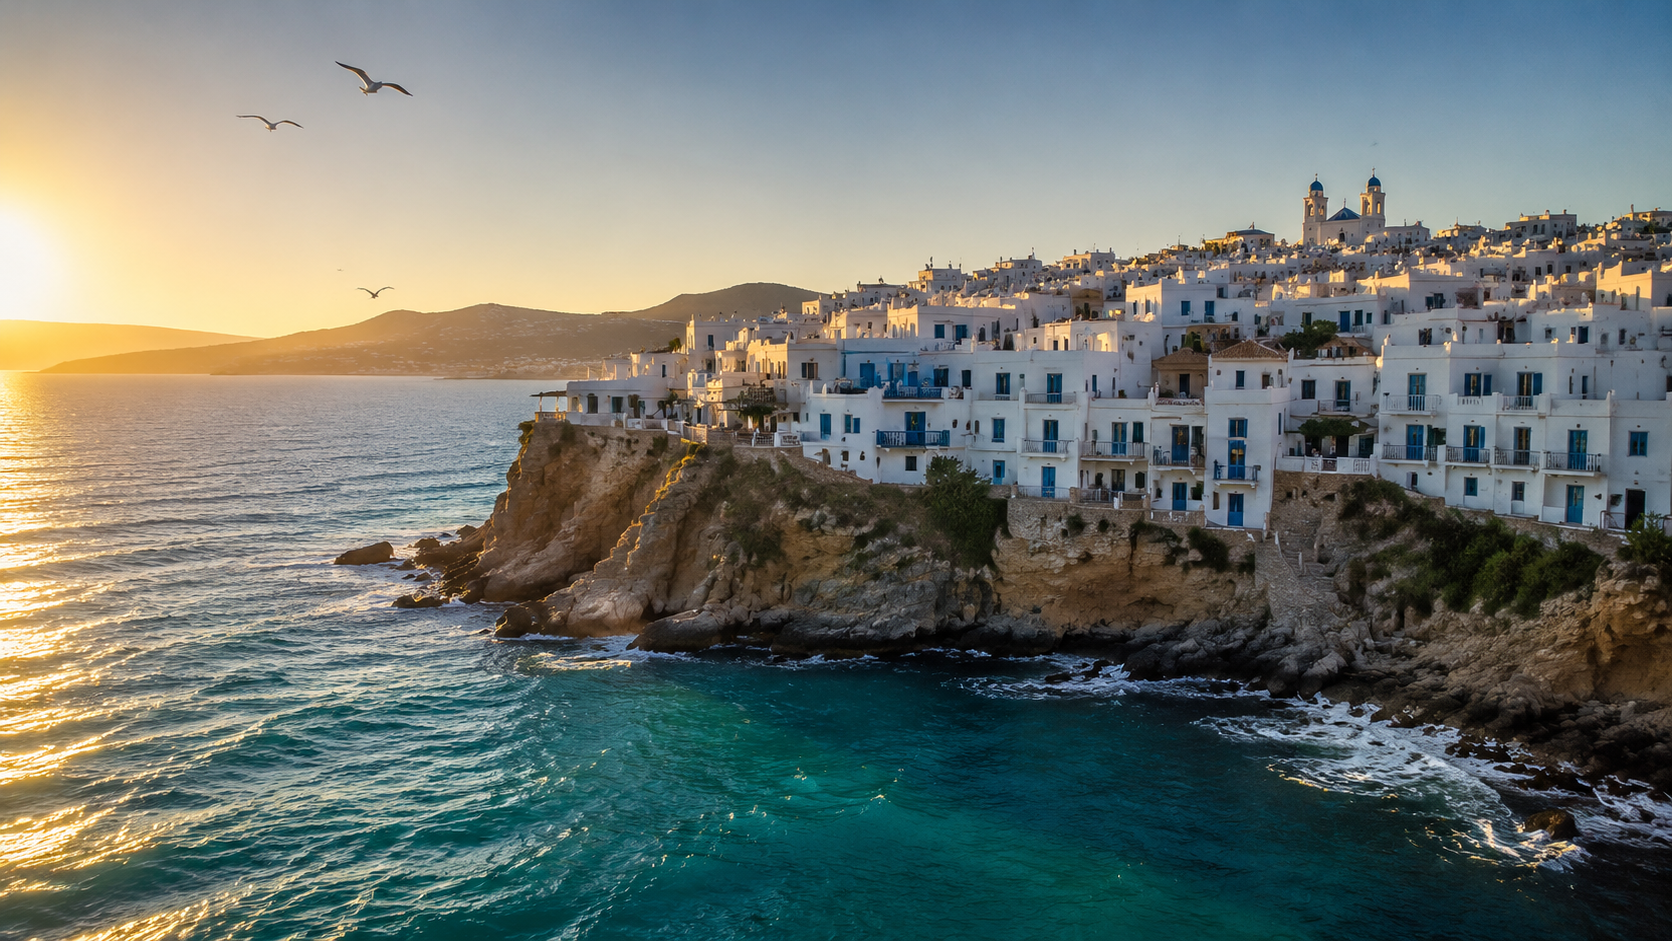
O oposto da receita 1: o mundo fica parado, a câmera viaja. Frame de entrada — uma vila costeira ampla na hora dourada:
Prompt:
Dolly-in cinematográfico lento: a câmera avança deslizando sobre a água em direção à vila na falésia, depois faz uma transição suave para um pan suave à direita ao longo da costa enquanto continua avançando. As ondas quebram nas rochas abaixo; gaivotas cruzam a cena lentamente. A luz da hora dourada permanece constante. Movimento de cabeça panorâmica suave e estável, sem cortes.
Parâmetros: resolution: 720P, duration: 4 — custo US$ 0,40.
Saída de uma única geração:
Compare o último segundo do clipe com o frame de entrada: a câmera de fato se moveu — a vila preenche o quadro, e a paralaxe entre a falésia e as colinas ao fundo está correta, em vez de um zoom falso tipo Ken Burns. O padrão é: nomeie o movimento, ordene o movimento, defina o estilo do movimento. “Dolly-in, depois pan à direita” dá a trajetória; “cabeça panorâmica, sem cortes” define o amortecimento; “a luz permanece constante” impede que a hora dourada vire timelapse diante dos seus olhos.
Tabela de consulta rápida
Juntando estas com nossas execuções anteriores, os prompts de i2v do wan2.7 seguem cinco regras:
- O frame é a cena; o prompt é o movimento. Não redescreva a imagem — use os substantivos dela apenas como âncoras para verbos (“tampa”, “xícara”, “litoral”).
- Uma atuação de sujeito + uma instrução de câmera por clipe. Empilhe as duas complexidades e o clipe curto vira bagunça.
- Escreva as marcações em ordem. O modelo executa a cadeia de ações na ordem escrita — esse é o seu controle de linha do tempo em um clipe de 5 segundos.
- Diga o que não pode se mover. “A câmera permanece travada e imóvel” e “a luz permanece constante” são respeitadas e inibem a deriva padrão do modelo.
- Troque movimento ambiental por realismo. Vapor, chuva, ondas, pássaros — cada um custa uma frase curta e rende muito em qualidade percebida.
Custos
O wan2.7-video/image-to-video cobra por segundo no padrão, com a tarifa definida pela resolução de saída:
| Resolução | Preço | Clipe de 5 s | Clipe de 15 s (máximo) |
|---|---|---|---|
| 720P | US$ 0,10 por segundo | US$ 0,50 | US$ 1,50 |
| 1080P | US$ 0,167 por segundo | US$ 0,835 | US$ 2,505 |
Os três clipes deste artigo — 14 segundos de vídeo 720P concluídos (medidos na saída real como 1280×720 a 30 fps) — custaram no total US$ 1,40, e o lote inteiro de tarefas ficou pronto cerca de nove minutos após o envio, porque as tarefas rodam em paralelo no servidor. As tarifas atuais estão sempre disponíveis na página de preços.
Se você quer movimento mas não quer primeiro procurar um frame, o wan2.7-video/text-to-video da mesma linha roda com o mesmo preço por segundo e suporta áudio nativo e o mesmo limite de 15 segundos — apresentamos de ponta a ponta no guia de vídeos curtos.
Experimente
Escolha qualquer um dos três prompts acima, troque pelo seu próprio primeiro frame e receba um clipe em poucos minutos por bem menos de um dólar. A página do modelo wan2.7-video/image-to-video traz uma referência de parâmetros ao vivo e um playground interativo — comece com um clipe de 4 segundos em 720P (US$ 0,40), itere no prompt e só então decida se envia uma renderização em 1080P.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores