
Benutzerhandbuch
Wan 2.7 Image-to-Video-Prompt-Rezepte: 3 kopierfertige Prompts mit echten Ausgaben
Drei Prompt-Rezepte für wan2.7-video/image-to-video, die auf Anhieb funktionieren – Produktbewegung bei fixierter Kamera, subtiles Portrait-Spiel und echte Kamerafahrten – jeweils mit Eingangsbild, präzisem Prompt, eingebettetem Ausgabesegment und verifiziertem Standardtarif.
Image-to-Video ist der Hebel mit der größten Wirkung bei Videomodellen: Du fixierst mit einem Standbild Komposition, Licht und Motiv und steckst die gesamte Leistungsfähigkeit des Modells in die Bewegung. Das Problem: i2v-Prompts sind eine eigenständige Fähigkeit – die meisten Prompts, die bei Text-to-Video funktionieren, verschwenden massenhaft Token damit, die Szene neu zu beschreiben, die das Modell bereits sieht.
Dieser Leitfaden liefert dir drei kopierfertige Prompt-Rezepte für wan2.7-video/image-to-video, das Image-to-Video-Modell von Alibabas Tongyi Wanxiang 2.7, für die drei Aufgabentypen, für die i2v tatsächlich genutzt wird: Produktbewegung, Portrait-Performance und Kamerafahrt. Jedes unten eingebettete Segment ist eine echte Ausgabe des jeweiligen Prompts in einem Durchlauf – erzeugt über die hiapi Task-API in der Standardstufe 720P ($0.10 pro Videosekunde). Die Eingangsbilder sind ebenfalls beigefügt, damit du genau nachvollziehen kannst, was das Modell erhalten und was es daraus erschaffen hat.
Anfragestruktur (bitte zuerst lesen)
wan2.7 i2v läuft auf dem asynchronen Task-Endpunkt von hiapi. Drei Schema-Details ersparen dir eine Runde von 400-Fehlern:
mediaist ein Array von Objekten, kein nackter URL-String. Jedes Objekt benötigttypeundurl. Akzeptierte Typen sindfirst_frame,last_frame,driving_audioundfirst_clip– derselbe Endpunkt deckt also gewöhnliche Erstbild-Animation, Erst-/Letztbild-Interpolation, audiogetriebene Bewegung und Clip-Verlängerung ab. Alles in diesem Artikel übergibt nur einfirst_frame.resolutionist ein Enum:720Poder1080P, keine anderen Werte.durationwird in Sekunden angegeben, Obergrenze 15.
Bild-URLs müssen öffentlich erreichbar sein – die Plattform lädt sie beim Erstellen des Tasks serverseitig herunter.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "wan2.7-video/image-to-video",
    "input": {
      "prompt": "充电盒盖平滑向上打开,两枚哑光黑色耳机缓慢从盒中升起……",
      "media": [
        {"type": "first_frame", "url": "https://your-cdn.example/frame.jpg"}
      ],
      "resolution": "720P",
      "duration": 5
    }
  }'
Die Antwort liefert sofort eine taskId. Frage GET /v1/tasks/{taskId} ab, bis status gleich success ist, und lade dann output[0].url herunter:
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}"}

task_id = requests.post(BASE, headers=HEADERS, json=payload).json()["data"]["taskId"]

while True:
    task = requests.get(f"{BASE}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] == "success":
        video = requests.get(task["output"][0]["url"]).content
        open("clip.mp4", "wb").write(video)
        break
    if task["status"] == "fail":
        raise RuntimeError(task.get("error"))
    time.sleep(10)
Ein Betriebshinweis: output[0].url ist ein zeitlich begrenzter Link mit expireAt-Zeitstempel. Lade die Datei direkt nach erfolgreichem Task herunter und speichere sie in deinem eigenen Bucket – was passiert, wenn du das nicht tust, erfährst du hier.
Rezept 1: Produktbewegung bei fixierter Kamera
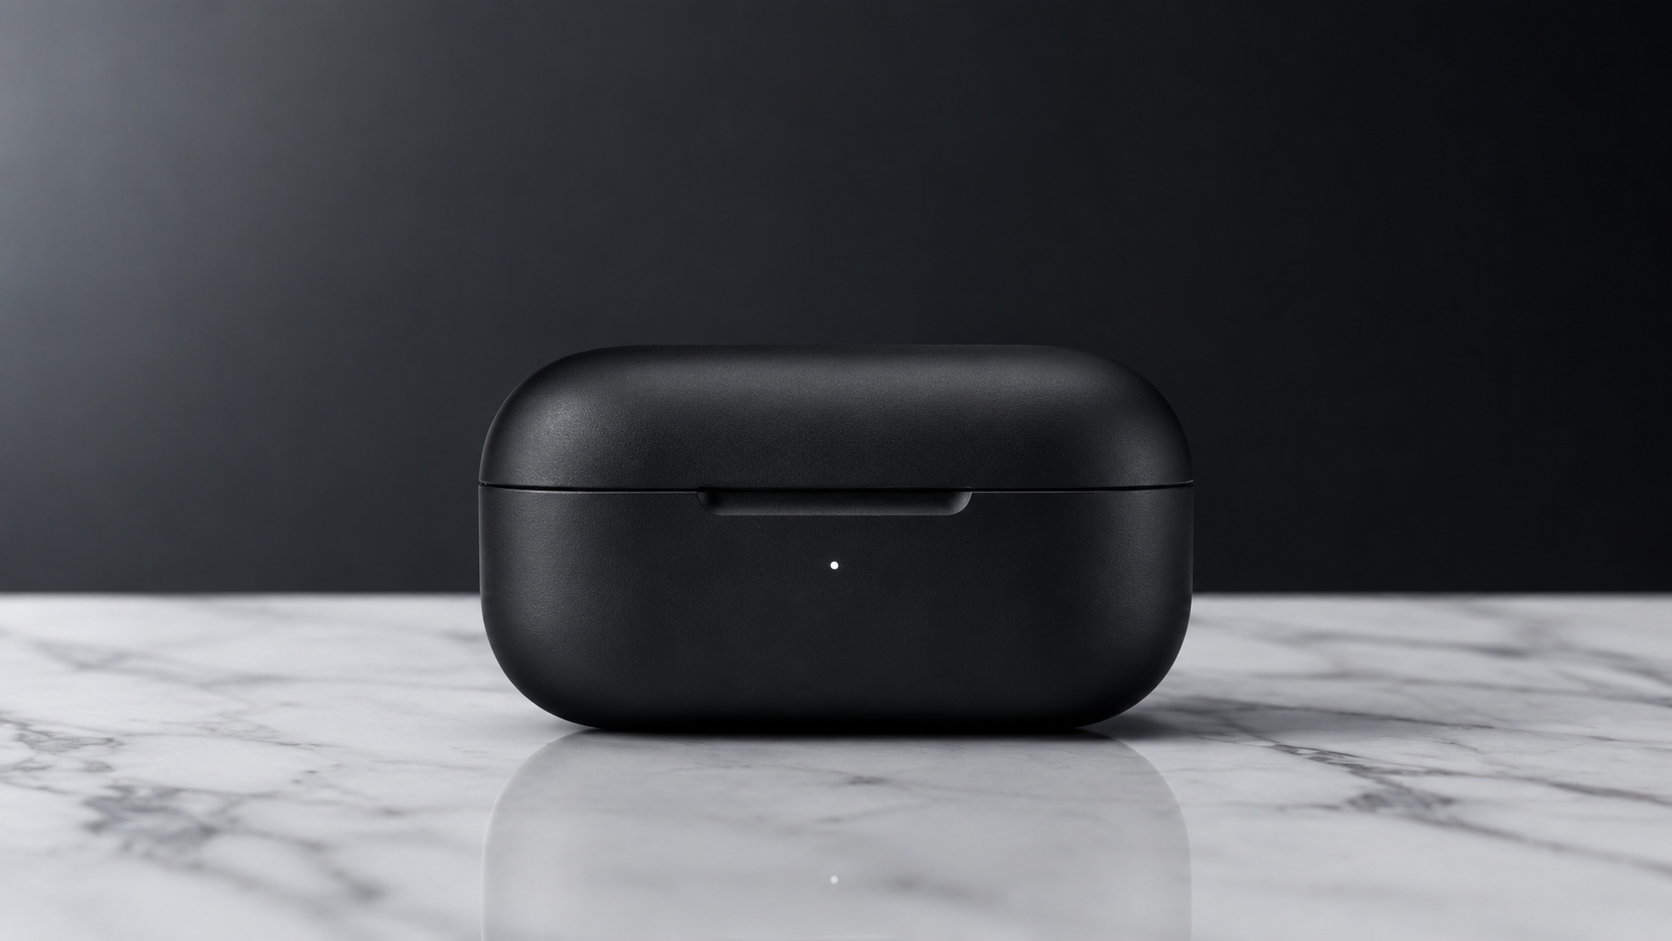
Der klassische E-Commerce-Hauptbild-Loop: Das Produkt bewegt sich, die Kamera nicht. Wir beginnen mit diesem in gpt-image-2-Studioqualität aufgenommenen Bild einer geschlossenen Ohrhörer-Ladebox:
Prompt:
充电盒盖平滑向上打开,两枚哑光黑色耳机缓慢从盒中升起,悬停在盒子上方,同时同步缓慢旋转。它们转动时,柔和的影棚光在其表面闪过。相机完全锁定不动;浅景深将焦点保持在耳机上。干净、高级的产品发布美学,无镜头运动。
Parameter: resolution: 720P, duration: 5 – Kosten $0.50.
Ausgabe in einem Durchlauf:
Das Modell hat das Innere der Box und die Ohrhörer selbst erschaffen – beides existiert im Eingangsbild nicht – und die Kohärenz der Marmorreflexionen beim Aufschwingen des Deckels bewahrt. Zwei Dinge im Prompt waren entscheidend: Der Objektzustand wird der Reihe nach benannt (Deckel öffnet → Ohrhörer steigen auf → schweben → rotieren synchron), und die Kamera wird ausdrücklich angewiesen, nichts zu tun, und zwar zweimal (vollständig fixiert … keine Kamerabewegung). Negative Bewegungsvorgaben werden befolgt; ohne sie fügen i2v-Modelle oft ein nicht angefordertes Driften oder Zoomen hinzu.
Rezept 2: Subtiles Portrait-Spiel
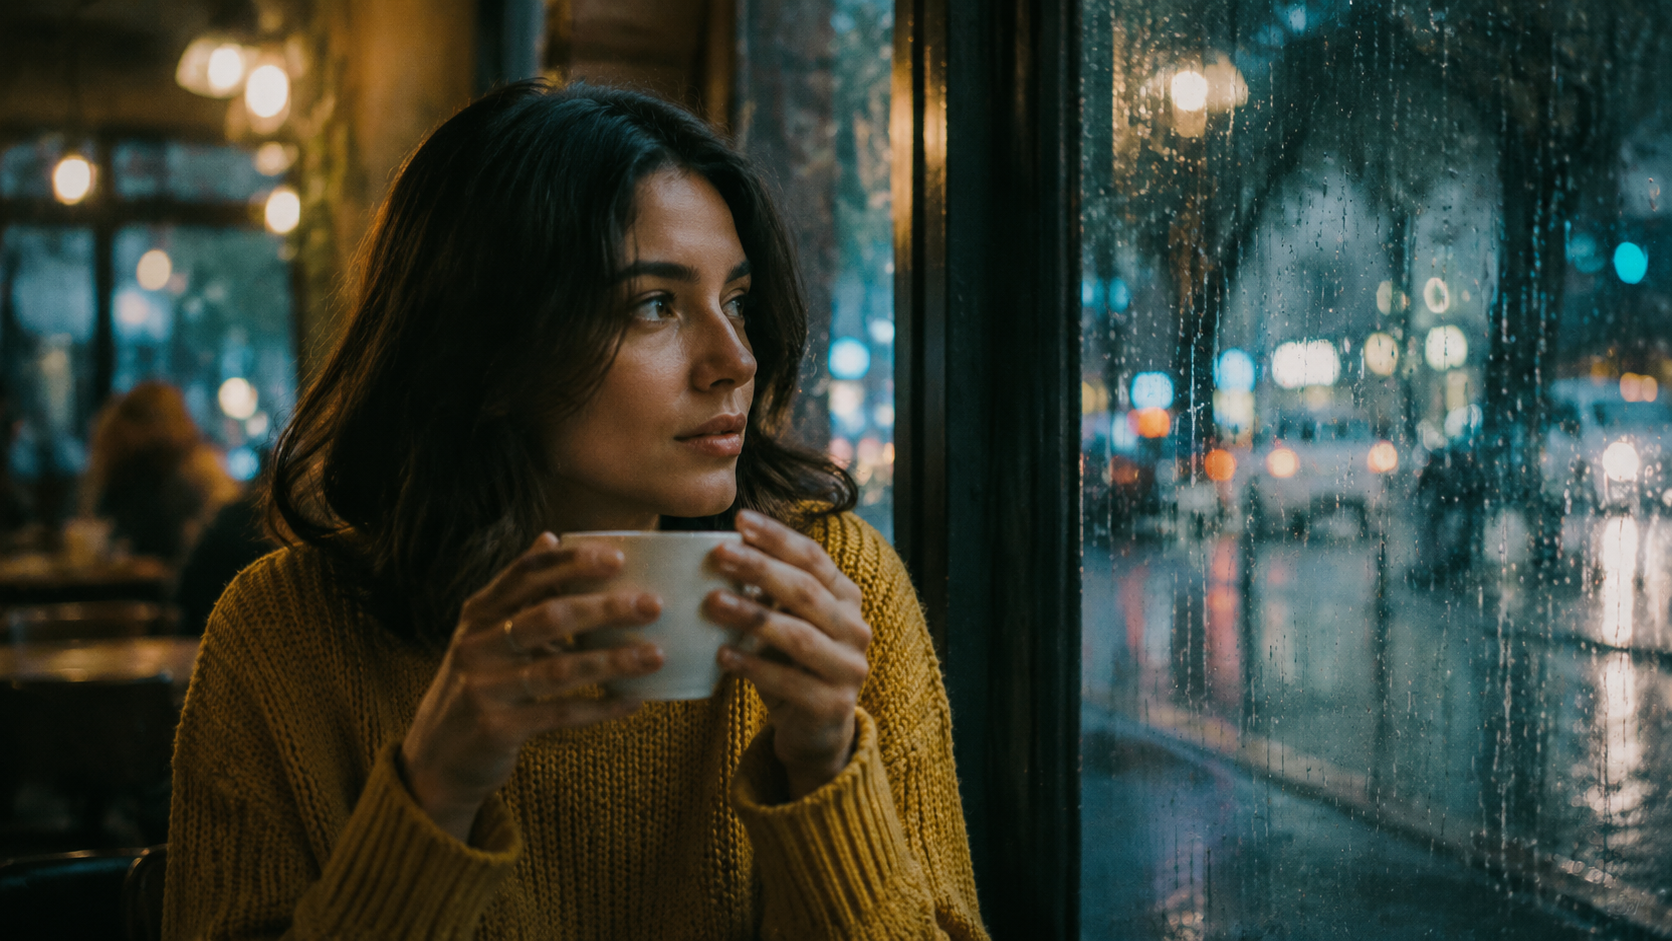
Menschen zu animieren ist genau der Bereich, in dem i2v seinen Wert entfaltet – Casting, Kleidung und Licht sind durch das Bild bereits gelöst. Auch die Eingabe stammt von gpt-image-2:
Prompt:
女子轻轻举起杯子,缓慢安静地啜饮一口,然后放下杯子,转头望向布满雨痕的窗外,露出柔和的微笑。热气从杯口袅袅升起;雨滴在她身后的玻璃上滑落。她移动时头发微微晃动。相机保持静止,焦点从杯子柔和地拉到她的脸上。温暖、从容、电影般的运动。
Parameter: resolution: 720P, duration: 5 – Kosten $0.50.
Ausgabe in einem Durchlauf:
Das Rezept hier ist eine Kette aus zwei oder drei kleinen Aktionen in klarer Reihenfolge (heben → nippen → absetzen → Kopf drehen → lächeln). wan2.7 führt sie in der geschriebenen Reihenfolge aus – genau das lässt das Segment wie eine Performance wirken statt wie ein animiertes Standbild. Die andere Hälfte ist Sekundärbewegung: Dampf, Regentropfen und Haar lassen sich leicht anfordern und tragen den Großteil des Realismus. Bei der Blickrichtung gilt: sanft bleiben („sanftes Lächeln“ statt „lautes Lachen“) – subtile Mimik überlebt; übertriebene Mimik ist ein Glücksspiel.
Rezept 3: Kamerafahrt über eine statische Szene
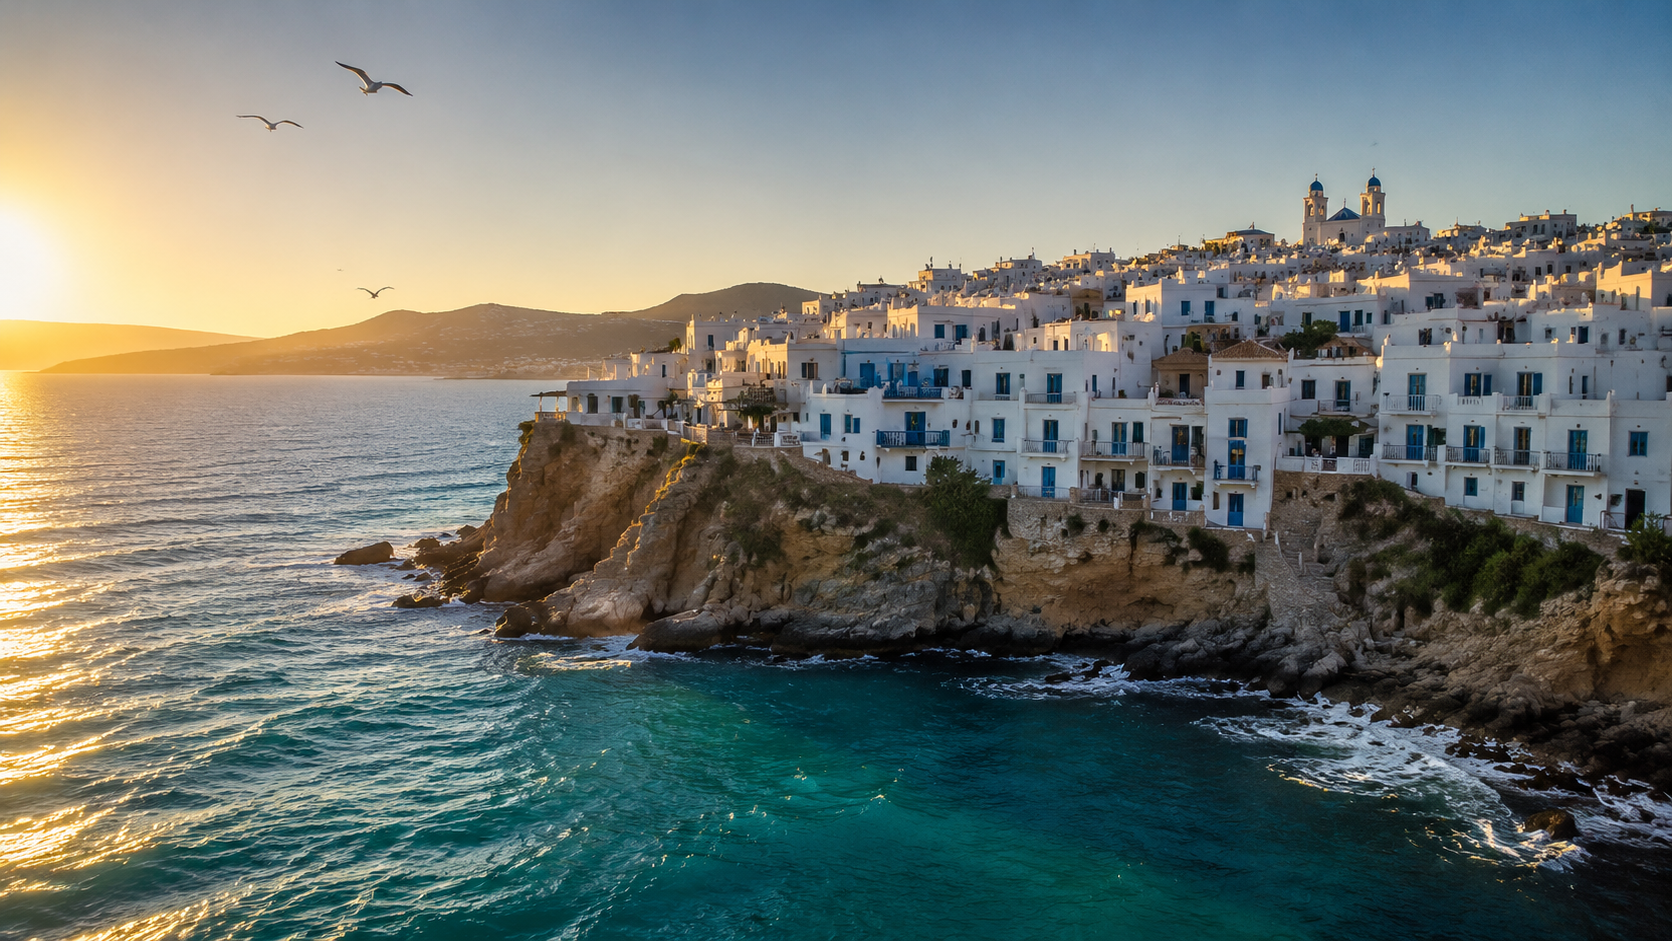
Der Gegenentwurf zu Rezept 1: Die Welt steht still, die Kamera reist. Das Eingangsbild – ein weites Küstendorf in der goldenen Stunde:
Prompt:
缓慢的电影式推近:相机在水面上方向前滑行,朝悬崖村庄推进,然后随着继续前进,平滑过渡为沿海岸线向右的轻柔平移。海浪拍打下方的岩石;海鸥缓慢掠过画面。黄金时刻的光线保持恒定。平滑、稳定的云台式运动,无剪辑。
Parameter: resolution: 720P, duration: 4 – Kosten $0.40.
Ausgabe in einem Durchlauf:
Vergleiche die letzte Sekunde des Segments mit dem Eingangsbild: Die Kamera hat sich tatsächlich bewegt – das Dorf füllt das Bild, die Parallaxe zwischen Klippen und Hügeln im Hintergrund stimmt, statt eines falschen Ken-Burns-Zooms. Das Muster lautet: Bewegung benennen, Bewegung ordnen, Bewegungsstil definieren. „Push-in, dann Schwenk nach rechts“ gibt die Trajektorie vor; „kamerawagenartig, ohne Schnitt“ setzt die Dämpfung; „Licht bleibt konstant“ verhindert, dass die goldene Stunde vor deinen Augen zur Zeitrafferaufnahme wird.
Schnellreferenz
Zusammengefasst aus diesen und unseren früheren Läufen folgen wan2.7-i2v-Prompts fünf Regeln:
- Das Bild ist die Szene; der Prompt ist die Bewegung. Beschreibe das Bild nicht neu – nutze nur die Substantive aus dem Bild als Anker für Verben („Deckel“, „Tasse“, „Küstenlinie“).
- Pro Segment nur eine Hauptaktion + eine Kameraanweisung. Stapelst du beide Komplexitätsarten, wird ein kurzes Segment unübersichtlich.
- Schreibe die Regieanweisungen der Reihe nach. Das Modell führt Aktionsketten in der geschriebenen Reihenfolge aus – das ist deine Zeitachsensteuerung in einem 5-Sekunden-Segment.
- Sag, was sich nicht bewegen darf. „Kamera bleibt vollständig fixiert“ und „Licht bleibt konstant“ werden befolgt und dämpfen das Standard-Driften des Modells.
- Erhandle Realismus durch Umgebungsbewegung. Dampf, Regen, Wellen, Möwen – jeweils ein kurzer Satz, und der wahrgenommene Qualitätsgewinn ist groß.
Kosten
wan2.7-video/image-to-video wird sekundengenau nach dem Standardtarif abgerechnet, der Satz richtet sich nach der Ausgaberesolution:
| Resolution | Preis | 5-Sekunden-Segment | 15-Sekunden-Segment (Maximum) |
|---|---|---|---|
| 720P | $0.10 pro Sekunde | $0.50 | $1.50 |
| 1080P | $0.167 pro Sekunde | $0.835 | $2.505 |
Alle drei Segmente in diesem Artikel – 14 Sekunden fertiges 720P-Video (gemessen an der tatsächlichen Ausgabe: 1280×720, 30 fps) – kosteten zusammen $1.40, und der gesamte Stapel war etwa neun Minuten nach der Einreichung fertig, weil die Tasks serverseitig parallel laufen. Die aktuellen Tarife findest du jederzeit auf der Preisseite.
Wenn du Bewegung willst, aber nicht zuerst ein Bild besorgen möchtest, läuft wan2.7-video/text-to-video aus derselben Serie zum gleichen Sekundentarif und unterstützt natives Audio sowie dieselbe 15-Sekunden-Obergrenze – wir haben es im Kurzvideo-Leitfaden von Anfang bis Ende vorgestellt.
Ausprobieren
Nimm einen der drei Prompts oben, ersetze ihn durch dein eigenes erstes Bild und hole dir in wenigen Minuten ein Segment für deutlich unter einem Dollar zurück. Die Modellseite von wan2.7-video/image-to-video bietet eine Live-Parameterreferenz und einen interaktiven Playground – starte mit einem 4-Sekunden-720P-Segment ($0.40), iteriere am Prompt und entscheide dann, ob du ein 1080P-Rendering einreichst.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte