
Benutzerhandbuch
GLM 5.3 Strukturierte Extraktion in der Praxis: Jedes JSON-Feld mit Beleg aus dem Originaltext
Feldextraktion mit dem JSON-Objektmodus: fehlende Werte, Zitate und Geschäftsvalidierung halten Fehler vom Datenbankeintrag fern

Auf dieser Seite
Warum strukturierte Ausgaben trotzdem einen "Beleg aus dem Originaltext" brauchen
Der JSON-Objektmodus (response_format: {"type": "json_object"}) löst das Problem, ob die Ausgabeform ein JSON-Objekt ist, nicht aber die Frage, ob diese Anfrage sicher erfolgreich ist, der Inhalt sicher vollständig ist und das Parsen sicher keine Ausnahme auslöst. Anfragen können fehlschlagen, das Modell kann die Antwort verweigern, die Ausgabe kann wegen Längenlimits abgeschnitten werden, die Streaming-Übertragung kann abbrechen, und der zurückgegebene Inhalt kann unvollständig oder fehlerhaft sein; der Client muss diese Fälle sowie Parse-Ausnahmen von json.loads behandeln. Zuerst muss bestätigt werden, dass die Antwort normal abgeschlossen und der Inhalt vollständig ist, bevor geparst wird. Parsebar bedeutet nicht verwendbar: Korrektes Format bedeutet nicht korrekte Fakten. Ob ein Feldwert aus dem Originaltext extrahiert wurde, ob das Modell ihn nebenbei ergänzt hat, ob ein Feld im Originaltext nicht vorkommt oder im Originaltext leer angegeben ist – all das deckt die Formatvorgabe nicht ab.
Eine Feldvorlage in den Prompt zu schreiben bedeutet im Kern, dem Modell eine Ausfüllvorlage zu geben und keine Belegliste. Wenn einem Feld die Stütze im Originaltext fehlt, neigt das Modell dazu, einen plausibel wirkenden Wert zu liefern – im Extraktionsaufgaben ist das der gefährlichste Fehlermodus, denn er meldet keinen Fehler, sondern verunreinigt still die nachgelagerten Daten.
Daher besteht der Extraktionsvertrag in diesem Artikel aus drei Teilen: Feld- und Typdefinition, ein zu jedem Wert gehörendes Originalzitat sowie eine explizite Modellierung fehlender Werte. Zusammen machen sie die Frage "Woher stammt dieser Satz?" zu einem Teil der Ausgabe statt zu einer nachträglichen Vermutung.
Den Extraktionsvertrag gestalten: Felder, Typen und Nullable-Konventionen
Der Vertrag beginnt mit der Feldliste. Angenommen, die Aufgabe besteht darin, aus einer Stellen- oder Kooperationsbeschreibung strukturierte Informationen zu extrahieren; dann werden die Zielfelder zuerst festgeschrieben:
title: String, erforderlichbudget: Zahl, nullabledeadline: String (ISO-Datum), nullablecontact: String, nullableskills: String-Array, darf leeres Array sein
Entscheidend ist, dass "nullable" nicht "darf weggelassen werden" bedeutet. Es wird vereinbart, dass jedes Feld in der Ausgabe erscheinen muss; bei Unbekanntem wird explizit null oder ein leeres Array angegeben, Schlüssel dürfen nicht weggelassen werden. Weggelassene Schlüssel machen es der nachgelagerten Verarbeitung unmöglich, zu unterscheiden, ob das Modell das Feld als leer beurteilt hat oder es überhaupt nicht behandelt hat.
Auch bei den Typen muss man auf eine maschinell prüfbare Granularität einschränken: budget akzeptiert nur Zahlen, keine Strings wie "nach Absprache"; deadline wird auf das Format YYYY-MM-DD festgelegt; skills muss ein String-Array sein, ein einzelner mit Kommas zusammengefügter String ist nicht zulässig. Je konkreter die Typen, desto besser kann die spätere Validierungsschicht Probleme abfangen.
Der folgende Abschnitt ist eine Feldbeschreibung, die in den Prompt geschrieben wird, kein Anfrageparameter; die Anfrageparameter aktivieren nur den JSON-Objektmodus.
Bitte gib ein JSON-Objekt aus, das genau die folgenden Schlüssel enthält:
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
Alle Schlüssel müssen erscheinen. Wenn es aus dem Originaltext nicht bestimmt werden kann, fülle null ein (Arrays: leeres Array), nicht raten.
Jedem Feld ein Zitatfragment mitgeben
Nur Werte ohne Quelle zu liefern bedeutet, auf Nachvollziehbarkeit zu verzichten. Die Methode besteht darin, jedes extrahierbare Feld in eine Paarstruktur umzuwandeln: Wert und Zitat erscheinen gemeinsam.
{
  "title": {"value": "Praktikant Datenanalyse", "evidence": "2 Praktikanten für Datenanalyse gesucht"},
  "budget": {"value": 300, "evidence": "Tageslohn 300 Yuan"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "Lebenslauf an hr@example.com senden"},
  "skills": [
    {"value": "SQL", "evidence": "SQL-Kenntnisse erforderlich"},
    {"value": "Python", "evidence": "Python-Kenntnisse von Vorteil"}
  ]
}
Einige wichtige Punkte. Erstens muss evidence ein zusammenhängendes Fragment des Originaltexts sein, keine Umschreibung oder Zusammenfassung des Modells – Umschreibungen machen das Zitat für den Abgleich wertlos. Zweitens muss evidence auch null sein, wenn der Wert null ist; diese Einschränkung allein unterdrückt einen Teil der Erfindungen: Wenn das Modell einen Wert erfindet, kann es meist kein entsprechendes Originalfragment erfinden, wodurch das Format in sich widersprüchlich wird. Drittens erhalten Array-Felder Zitate pro Element und nicht ein Zitat für das gesamte Array, sonst verunreinigt ein fehlerhaftes Element die Glaubwürdigkeit der ganzen Gruppe. Viertens sollten Zitatfragmente so kurz wie möglich sein und nur den minimalen Text abdecken, der den Wert stützt, damit später ein String-Enthaltensein-Abgleich möglich ist.
Die Ausgabe wird dadurch größer, aber dafür kann jeder in die Datenbank eingetragene Datensatz die Frage beantworten: "Auf welchen Satz des Originaltexts stützt sich dieses Feld?"
Fehlende Werte und Unsicherheit explizit behandeln
Der häufigste Fehler des Modells bei Extraktionsaufgaben ist nicht das falsche Extrahieren, sondern das Ergänzen. Auf Vertragsebene müssen drei Situationen getrennt modelliert werden.
Fehlend. Im Originaltext gibt es überhaupt keine relevante Information, das Feld wird mit null gefüllt. Diese Semantik muss von "Wert ist ein leerer String" unterschieden werden: Ein leerer String ist ein extrahierter Wert, null bedeutet, dass nichts extrahiert werden konnte. Erst wenn dies vorgelagert klar vereinbart ist, kann die nachgelagerte Verarbeitung entscheiden, ob übersprungen oder alarmiert wird.
Mehrdeutig. Im Originaltext gibt es eine relevante Angabe, aber sie reicht zur Bestimmung nicht aus. Wenn beispielsweise nur "Gehalt nach Absprache" steht, sollte budget null sein; gleichzeitig muss im Prompt klargestellt werden: Qualitative Beschreibungen nicht in Zahlen umwandeln und "nach Absprache" nicht auf 0 abbilden.
Mehrere Kandidaten. Im Originaltext erscheinen zwei Kontaktmöglichkeiten oder zwei Daten, während der Vertrag nur einen Einzelwert akzeptiert. Mögliche Vorgehensweisen sind, die Feldstruktur Kandidatenlisten unterstützen zu lassen oder im Prompt eine Priorität festzulegen (z. B. den zuerst erscheinenden Wert nehmen). Welche Variante auch gewählt wird, sie muss in den Vertrag geschrieben werden, sonst kann die Auswahlstrategie des Modells jedes Mal anders ausfallen und die Ergebnisse sind schwer stabil reproduzierbar.
Zusätzlich eine Absicherung: Dem Modell darf erlaubt werden, ein unresolved-Array auszugeben, das wichtige Informationen auflistet, die keinem Feld zugeordnet werden können. Das ist deutlich sicherer, als sie gewaltsam in ein Feld zu stopfen, und gibt dir zugleich einen Zugang, um die Fehlermodi des Modells zu beobachten.
Drei Ebenen der Geschäftsvalidierung vor dem Datenbankeintrag
Der JSON-Objektmodus beschränkt nur die Ausgabeform; das Parsen kann dennoch fehlschlagen. Die Validierung erfolgt in Reihenfolge: zuerst die Vollständigkeit der Antwort bestätigen, dann clientseitige Struktur- und Geschäftsvalidierung, zuletzt den Belegabgleich; wenn eine Ebene nicht besteht, geht es nicht zur nächsten.
Vor dem Parsen prüfen: ob die Anfrage erfolgreich zurückgekehrt ist, ob eine Antwortverweigerung vorliegt, ob der Endgrund eine Kürzung wegen Länge anzeigt, ob die Streaming-Antwort normal beendet wurde, ob der Inhalt leer ist. Erst nach Bestätigung, dass die Antwort normal abgeschlossen und der Inhalt vollständig ist, wird json.loads ausgeführt; Parse-Ausnahmen gehen direkt in die Fehlerbehandlung, abgeschnittener Inhalt wird nicht in die nachfolgende Validierung gegeben. Erst nach erfolgreichem Parsen folgen die drei Validierungsebenen unten.
Erste Ebene: Typen und Struktur
Sind die Schlüssel vollständig, passen die Typen, erfüllt deadline das Datumsformat, ist budget eine endliche Zahl. Diese Ebene lässt sich mit normalem Code erledigen, ist kostengünstig und fängt am meisten ab.
Zweite Ebene: Enumerationen und Wertebereiche
Geschäftlich unmögliche Werte abfangen: negative Beträge, Daten vor dem heutigen Tag, leere Strings oder Duplikate in skills, String-Längen über der Feldobergrenze. Wenn ein Feld ein kontrolliertes Vokabular hat (z. B. Branche, Karrierestufe), hier eine Whitelist-Prüfung durchführen und einen Platz für die Normalisierung von Synonymen vorsehen.
Dritte Ebene: Feldübergreifende Konsistenz
Ein einzelnes Feld gültig zu haben bedeutet nicht, dass der gesamte Datensatz stimmt. Typische Prüfungen umfassen: ob deadline ebenfalls nicht leer ist, wenn budget nicht leer ist (in vielen Geschäftsszenarien sind beide gebunden), ob contact dem durch skills angedeuteten Stellentyp widerspricht, ob die Feldverteilung von Datensätzen mit demselben title innerhalb desselben Batches ungewöhnlich konzentriert ist. Diese Ebene kommt der Geschäftssemantik am nächsten und erfordert am meisten Testarbeit.
Vergiss nicht die mechanische Prüfung von evidence: Wenn der Wert nicht leer ist, muss evidence nicht leer sein und sollte im Eingabe-Originaltext durch String-Enthaltensein oder Fuzzy-Matching auffindbar sein. Ein fehlgeschlagener Treffer muss nicht zwingend direkt verworfen werden, aber zumindest mit einer Niedrig-Konfidenz-Markierung in die manuelle Warteschlange gehen.
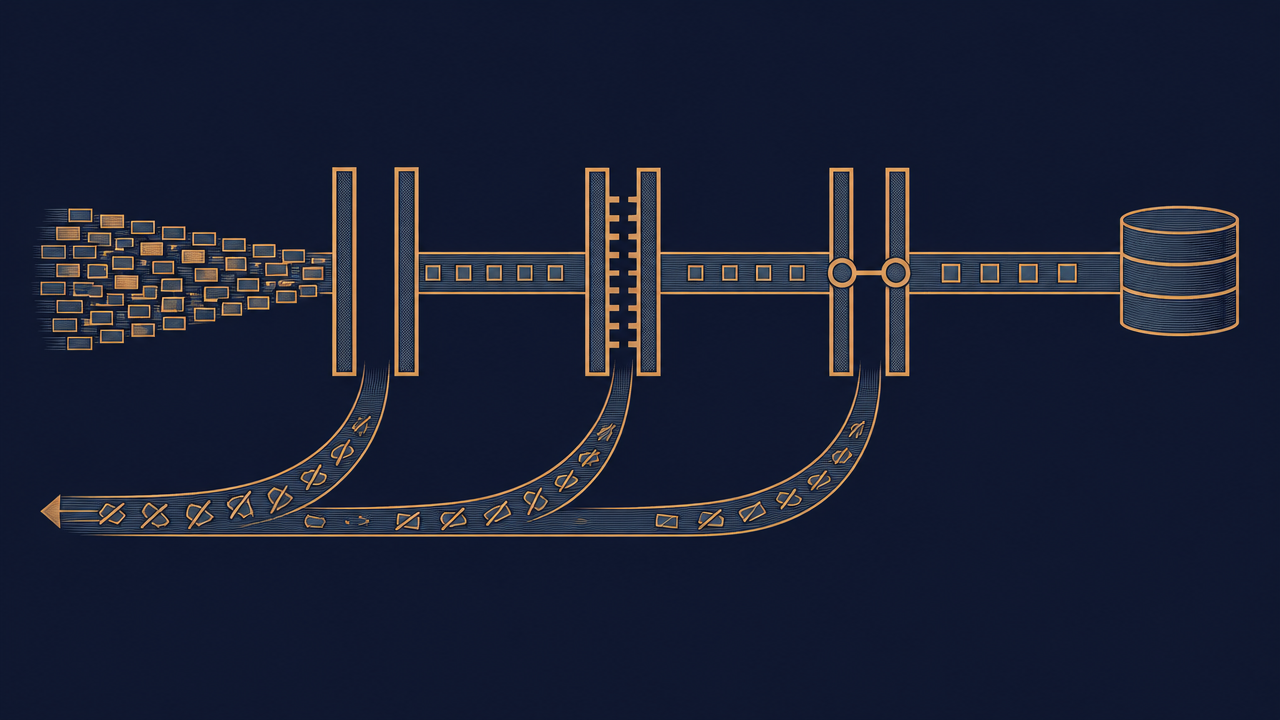
Validierungsfehler in den Prompt der nächsten Runde verwandeln
Die schlechteste Vorgehensweise nach einem Validierungsfehler ist, die Anfrage unverändert erneut zu senden und zu hoffen, dass diesmal richtig extrahiert wird. Besser ist es, die Fehlerursachen strukturiert zurückzugeben:
Die letzte Ausgabe hat die Validierung nicht bestanden:
- Der Wert "so schnell wie möglich" von deadline entspricht nicht dem Format YYYY-MM-DD
- Die evidence von skills[2] konnte im Originaltext nicht gefunden werden
Bitte korrigiere nur die oben genannten Probleme, lasse die übrigen Felder unverändert und gib das vollständige JSON erneut aus.
Drei Details sind beachtenswert. Erstens sollte die Fehlermeldung auf den konkreten Feldpfad zeigen, damit das Modell lokale Korrekturen vornehmen kann, statt alles neu zu machen. Zweitens ausdrücklich fordern, dass die übrigen Felder unverändert bleiben, sonst werden leicht neue Fehler eingeführt und es entsteht ein Hin-und-Her, bei dem eine Korrektur einen neuen Fehler erzeugt. Drittens ein Retry-Limit festlegen (z. B. zwei Runden); über dem Limit geht es in die manuelle Warteschlange statt in eine Endlosschleife – unbegrenzte Wiederholungen verlängern nicht nur die Latenz, sondern treiben auch die Kosten hoch.
Wenn dieselbe Fehlerart bei Wiederholungen immer wieder auftritt, ist das meist kein Modellproblem, sondern ein unklar formulierter Vertrag. Dann sollte man die Felddefinitionen und Beispiele überprüfen, statt weiter Prompts zu ergänzen.
Aufrufweise und Grenzen dieses Artikels
Auf HiAPI wird glm-5.3 über das OpenAI-Chat-Completions-kompatible Protokoll aufgerufen; der JSON-Objektmodus wird aktiviert, indem in der Anfrage response_format auf den Objekttyp gesetzt wird. Konkrete Parameter und Feldnamen richten sich nach der Schnittstellenbeschreibung auf der Modellseite. Das Fähigkeitsmerkmal jsonObject=true bedeutet, dass das Modell den JSON-Objektmodus unterstützt, nicht dass die Schnittstelle den JSON-Schema-Antwortmodus unterstützt und auch nicht, dass man sich auf eine serverseitige Validierung nach Schema verlassen kann; Feldstruktur, Typen und Geschäftsbeschränkungen in diesem Artikel werden nach dem Parsen clientseitig lokal validiert. Extraktionslogik, Zitatfelder und Validierungsschicht liegen in deinem eigenen Backend; das Modell ist nur dafür zuständig, gemäß dem Vertrag Text zu erzeugen.
Dieser Artikel behandelt nur Vertragsdesign und Validierungsablauf, nicht Abrechnungszahlen und Leistungsversprechen; aktuelle Preise und Kontingente richten sich nach dem Preispanel der Website. Erst wenn Felddefinition, Zitatvalidierung und Retry-Strategie erledigt sind, ist der Schritt von "formal gültig" zu "semantisch verwendbar" vollzogen; korrektes Format bedeutet nicht korrekte Fakten, und ein fester Seed garantiert auch keine vollständige Reproduzierbarkeit; die Retry-Strategie muss weiterhin mit einem Limit und einer manuellen Warteschlange kombiniert werden.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Nano Banana Basisversion Leitfaden für Text-zu-Bild: Bildformat, Freiraum und Prompt-Nutzung
Mit den Feldern aspect_ratio und prompt der Aufgaben-API kompositorisch klare Bilder für Banner und Social Cards erzeugen
-

Benutzerhandbuch
Kimi K3 Antwortverarbeitung in der Praxis: Vollständiges JSON, Streaming-Abbrüche und Retry-Grenzen
-

Benutzerhandbuch
MiniMax Music 3 Kurzlied-Leitfaden: Songtext, Abschnitts-Tags und Arrangement-Brief getrennt schreiben
Auf Basis der beiden Pflichteingaben des aktuellen Vertrags eine reproduzierbare Kurzlied-Anfrage entwerfen