
Benutzerhandbuch
Leitfaden für den Einstieg in gpt-6.2-sol: Grenzen der Fähigkeiten, API-Anbindung und Hinweise zur Token-Abrechnung
Entscheidungshilfen und praktische Hinweise zur Anbindung für Engineering-Teams

Auf dieser Seite
Was gpt-6.2-sol ist und für wen es geeignet ist
gpt-6.2-sol ist ein von OpenAI veröffentlichtes Textmodell und ist über die einheitliche Schnittstelle von HiAPI.ai verfügbar. Es ist die tägliche Arbeitsklasse der GPT-6-Serie, die OpenAI als ein gängiges Modell positioniert, das von der Programmierung bis zum großskaligen Betrieb von Agents geeignet ist. Sein Ausgabetyp ist reiner Text – dies ist der erste Filter bei der Beurteilung, ob es für Sie geeignet ist, und nicht eine universelle Blackbox, die „alles kann“.
Am angenehmsten ist es in folgenden Szenarien: Wissensfragen und Zusammenführung von Suchergebnissen, Erstellung und Überarbeitung von Inhaltsentwürfen, Extraktion und Klassifizierung strukturierter Daten, semantische Beurteilung in mehrstufigen Dialogen sowie als Glied in einem Ablauf für Textentscheidungen (Triage, Kennzeichnung, Zusammenfassung, Intent-Erkennung). Diese Aufgaben haben gemeinsam, dass die Eingabe Text ist und die erwartete Ausgabe ebenfalls Text, sodass das Modell als Funktionsaufruf in bestehende Dienste eingebettet werden kann.
Die Zielgruppe sind Engineering-Teams: Sie prüfen die Einführung eines neuen Textmodells oder bereiten die Umstellung bestehender Aufrufe im großen Stil auf das neue Modell vor. Wenn Sie Bilder oder Audio generieren möchten, liegt das außerhalb seiner Grenzen und sollte bereits in der Auswahlphase ausgeschlossen werden.
Ein pragmatisches Beurteilungskriterium: Schreiben Sie die zu lösende Aufgabe zunächst in einen Satz und fragen Sie sich: „Sind Eingabe und Ausgabe dieser Aufgabe beide Text?“. Wenn die Antwort Nein lautet, kann dieses Modell höchstens den Textabschnitt im Ablauf übernehmen.
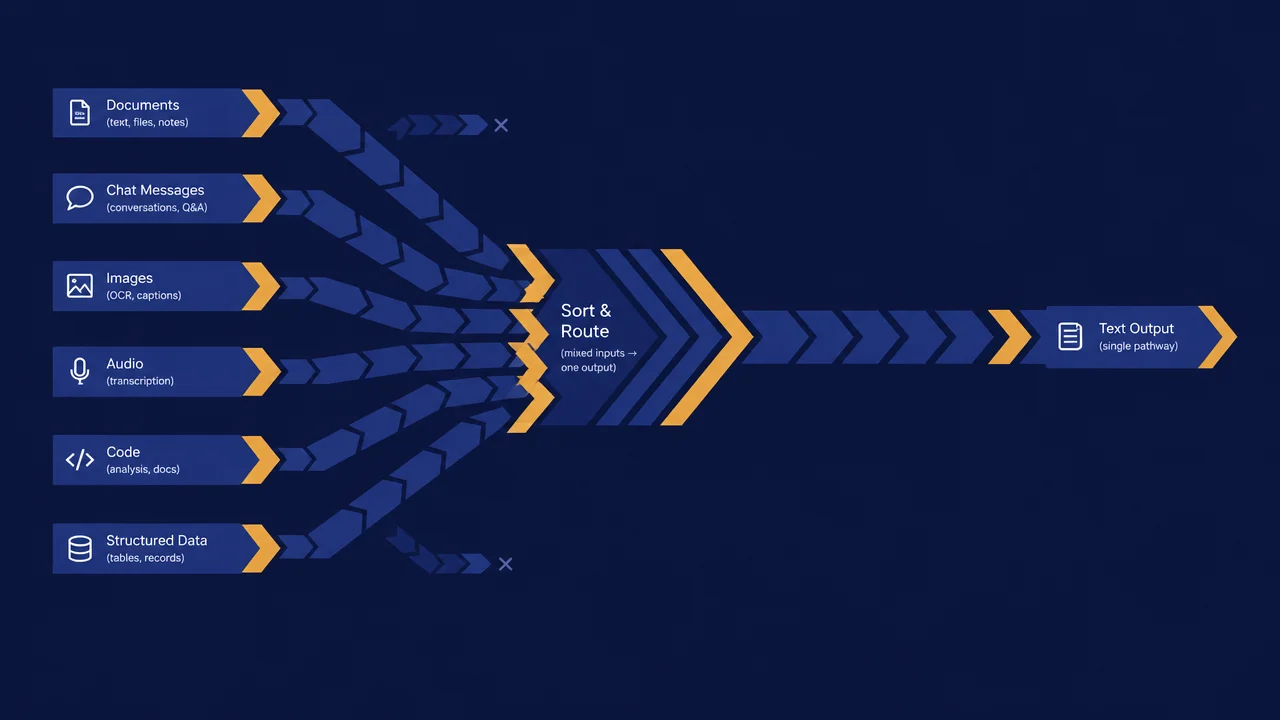
Grenzen der Fähigkeiten: Was die Textausgabe kann und was nicht
Betrachten Sie gpt-6.2-sol als eine Pipeline, in die Text hineingeht und aus der Text herauskommt. Was die Pipeline kann, ist klar: Auf der Grundlage eines Textkontexts ein Textergebnis erzeugen. Darauf aufbauend lassen sich direkt Aufgaben wie Klassifizierung und Kennzeichnung, Zusammenfassung und Überarbeitung, Informationsextraktion, Frage-Antwort-Generierung, Formatkonvertierung (z. B. von Freitext in einen von Ihnen festgelegten strukturierten Text) sowie die Sortierung und Erklärung mehrerer Kandidatenergebnisse übernehmen.
Die Teile, die zusätzliche Schritte erfordern, müssen ebenfalls frühzeitig erkannt werden:
- Aufgaben mit strikt strukturierter Ausgabe: Bei Aufruf über die Responses API kann mit
text.formatein JSON Schema übergeben und strict aktiviert werden, sodass die Rückgabe direkt gemäß der Felddefinition erzeugt wird; bei Chat Completions gibt es diese Option nicht, dann ist man auf Prompt-Einschränkungen angewiesen. Bei Chat Completions müssen Sie auf Prompt-Einschränkungen plus serverseitige Validierung und Wiederholung setzen und dürfen nicht davon ausgehen, dass die erste Rückgabe immer parsebar ist. - Aufgaben mit Bedarf an aktuellen Fakten: Die Modellausgabe ist nicht gleichbedeutend mit einer Faktenquelle; Inhalte zu Daten, Zeit und externem Zustand sollten von Ihrer Retrieval-Schicht oder Datenbank bereitgestellt und dann dem Modell zur Formulierung übergeben werden.
- Aufgaben mit Bedarf an Nicht-Text-Artefakten: Bilder, Sprachgenerierung usw. liegen nicht in seinem Ausgabetyp und müssen über separate Schritte angebunden werden.
- Aufgaben mit Bedarf an deterministischem Verhalten: Derselbe Request ist nicht garantiert wortgetreu reproduzierbar; Teile mit stark konsistenter Logik sollten im Code liegen und nicht dem Modell zur Entscheidung überlassen werden.
Die Grenzen in das Designdokument zu schreiben, ist deutlich günstiger, als sie später im laufenden Betrieb nachzubessern. Alles, was über die Textfähigkeit hinausgeht, sollte ausdrücklich als „benötigt externe Komponente“ gekennzeichnet werden, damit es bei der Überprüfung keine Erwartungsverschiebungen gibt.
Wichtige Parameter und Preise von gpt-6.2-sol
Im Folgenden finden Sie die bereits feststehenden Informationen beim Aufruf von gpt-6.2-sol über HiAPI; die Anbindung und die Kostenschätzung im weiteren Text orientieren sich daran.
- Positionierung: Tägliche Arbeitsklasse der GPT-6-Serie. OpenAI positioniert es als ein gängiges Modell, das von der Programmierung bis zum großskaligen Betrieb von Agents geeignet ist; es ist intelligenter und token-sparsamer als GPT-6.1 Sol.
- Kontext und Ausgabe: Kontextfenster 1.050.000 Token, maximale Ausgabe pro Aufruf 128.000 Token.
- Wissensstand: 2026-06-01.
- Ausgabe und Fähigkeiten: Textausgabe, unterstützt Streaming-Ausgabe und Tool-Aufrufe (
tools). - Aufrufmethode: Unterstützt Responses API (
https://api.hiapi.ai/v1/responses) und Chat Completions (https://api.hiapi.ai/v1/chat/completions). Die Denkstufereasoning.effort(low / medium / high / xhigh / max, Standard medium) und die strukturierte JSON-Ausgabetext.formatsind nur unter der Responses API verfügbar. - Preis: Die aktuell auf der Modellseite angegebenen Preise (pro Million Token) sind Eingabe $0.500, gecachte Eingabe $0.025, Ausgabe $2.500, Cache-Schreiben (5 Minuten) $0.625. Die Abrechnung richtet sich nach der Echtzeitanzeige auf der gpt-6.2-sol-Modellseite.
Wie man zwischen gpt-6.2-astra und diesem Modell wählt
Das gpt-6.2-astra derselben Serie ist die Flaggschiff-Klasse für die schwierigsten und langwierigsten Projekte und hat einen höheren Stückpreis. Für die meisten Aufgaben empfiehlt es sich, zunächst Sol zu verwenden; bei schwierigen Aufgaben, die Sol nicht gut löst – etwa komplexe modulübergreifende Refactorings oder hochanspruchsvolle Fachdokumente – wechseln Sie zu Astra. Beide werden auf dieselbe Weise aufgerufen; für den Wechsel muss nur der Modellname geändert werden.
Schnittstelleninformationen, die vor der Anbindung geklärt werden müssen
Bei der Anbindung auf HiAPI.ai ist die Modellseite /models/gpt-6.2-sol der Einstiegspunkt für Informationen. Die folgende Checkliste sollte vor der ersten Zeile Aufrufcode Punkt für Punkt geprüft werden, und zwar anhand der offiziellen und der Plattform-Dokumentation, nicht anhand von Community-Beiträgen oder Konfigurationen aus alten Projekten:
- Anmeldedaten und Authentifizierungsmethode: Woher der Schlüssel kommt, wo er liegt, wie er serverseitig sicher eingebracht wird – niemals an den Browser ausliefern.
- Request-Felder und Pflichtfelder: Genaue Benennung und Wertbeschränkungen der Felder für Modellkennung, Nachrichtenstruktur, maximale Generierungslänge usw.
- Beschränkungen für Kontext und Ausgabelänge: Das Kontextfenster von gpt-6.2-sol beträgt 1.050.000 Token, die maximale Ausgabe pro Aufruf 128.000 Token; wie die Ausgabegrenze wirkt, bestimmt direkt Ihre Chunking-Strategie.
- Maßstab für Ratenbegrenzung und Kontingent: Nach welcher Dimension die Ratenbegrenzung gezählt wird (Anzahl der Requests oder Token-Menge) und wie die Antwort nach dem Auslösen aussieht.
- Semantik der Fehlercodes: Welche Fehler eine Wiederholung wert sind und bei welchen es sich um Parameterprobleme handelt, bei denen eine Wiederholung nichts bringt – diese müssen unterschieden werden.
- Abrechnungsmaßstab: Dieses Modell wird nach Token abgerechnet; die Modellseite gibt die Stückpreise für Eingabe, gecachte Eingabe, Ausgabe und Cache-Schreiben getrennt an.
Halten Sie diese Ergebnisse in der internen Anbindungsdokumentation des Teams fest, damit diese Checkliste bei einem Personalwechsel oder Modellwechsel direkt wiederverwendet werden kann. Was noch nicht geklärt ist, sollte zunächst nicht in den Produktionszweig geschrieben werden.
Wesentliche Punkte zu API-Aufrufen und Parameterorganisation
Die Kernarbeit auf der Aufrufseite besteht nicht darin, einen Request abzusetzen, sondern den Request in eine wiederverwendbare, beobachtbare und ausfallsichere Kapselung zu bringen. Sehen Sie sich zunächst ein minimales Beispiel an: Strukturiertes JSON über die Responses API abrufen. Bei Verwendung des offiziellen OpenAI SDK genügt es, base_url auf HiAPI zu zeigen:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Felder aus dem Ticket extrahieren; fehlende Felder mit null füllen.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Wenn Sie bereits einen Chat-Completions-Client haben, können Sie durch Ändern des Modellnamens auf gpt-6.2-sol aufrufen, aber Denkstufe und strukturierte JSON-Ausgabe sind unter Chat Completions nicht verfügbar. Setzen Sie anschließend in der folgenden Reihenfolge um:
Request-Struktur
Teilen Sie die Nachrichten in zwei Ebenen: Systemeinschränkungen und Benutzerinhalte. Die Systemebene enthält Rolle, Anforderungen an das Ausgabeformat und Verbote, die Benutzerebene die Geschäftsdaten. Geschäftsdaten sollten nicht mit Anweisungen in einem Absatz vermischt werden, sonst lässt sich bei Problemen nicht feststellen, ob es an den Daten oder an den Anweisungen liegt.
Ausgabevertrag
Schreiben Sie klar, welche Ausgabeform erwartet wird (z. B. Feldnamen, ob erklärender Text erlaubt ist). Auch wenn Sie dies tun, führen Sie serverseitig eine Parse-Validierung durch: Schlägt das Parsen fehl, gilt dies als fehlgeschlagener Aufruf und es wird wiederholt oder degradiert, statt das Halbfertige direkt an das Frontend durchzureichen.
Ausnahmen und Wiederholungen
Wiederholungen sollten nur bei behebbaren Fehlern erfolgen, etwa bei transienten Netzwerkfehlern oder Ratenbegrenzung. Bei Fehlern wie ungültigen Parametern oder zu langem Inhalt bringt eine Wiederholung nichts; sie sollten direkt gemeldet werden. Wiederholungen brauchen eine Obergrenze und ein Backoff-Intervall, damit aus einer Störung keine Lawine wird.
Minimales Beobachtungsset
Pro Aufruf mindestens protokollieren: Dauer, Token-Menge der Eingabe und Ausgabe, ob eine Wiederholung stattfand und ob das Endergebnis erfolgreich war oder degradiert wurde. Diese Punkte entscheiden, ob sich später Kosten berechnen und Probleme lokalisieren lassen. Eine Anbindung ohne Logs ist gleichbedeutend mit keiner Anbindung.
Kostenstruktur unter der Token-Abrechnung
gpt-6.2-sol wird nach Token abgerechnet, was bedeutet, dass die Kosten pro Aufruf kein fester Wert sind, sondern sich linear mit Eingabe- und Ausgabemenge akkumulieren. In der Technik müssen Sie ein Kostenmodell aufbauen und sich nicht eine bestimmte Zahl merken:
- Eingabeseite: System-Prompts, Gesprächsverlauf und abgerufener Kontext zählen hinein. Ohne Kürzung wächst die Eingabe bei mehrstufigen Dialogen mit jeder Runde weiter an.
- Ausgabeseite: Je länger die Generierung, desto mehr wird abgerechnet. Wenn Sie vom Modell lange Erklärungen verlangen, steigen die Kosten unkontrolliert.
- Gesamtkosten: Die Kosten eines Requests setzen sich aus Eingabe und Ausgabe zusammen, daher muss die Optimierung beide Seiten betrachten.
Entsprechende Steuerungsmaßnahmen: System-Prompts straffen und wiederverwenden; den Gesprächsverlauf per Schiebefenster oder Zusammenfassungskompression kürzen; lange Dokumente zuerst aufteilen und dann nach Bedarf einspielen; eine sinnvolle Obergrenze für die Ausgabe setzen; bei Batch-Aufgaben Duplikate entfernen und cachen, damit identische Eingaben nicht mehrfach bezahlt werden.
Richtig ist es, das Budget anhand echter Stichproben zu schätzen: die durchschnittliche Token-Menge von Eingabe und Ausgabe statistisch erfassen, mit der Aufrufmenge multiplizieren und so eine Größenordnung ableiten. Die aktuellen Preise finden Sie oben unter „Wichtige Parameter und Preise“; Preise können sich ändern, die Abrechnung richtet sich nach der Echtzeitanzeige auf der Modellseite.
Entscheidung für oder gegen einen Wechsel durch Quervergleich
Die Auswahl sollte nicht allein auf einem einzelnen Test oder einem einzelnen Kriterium beruhen. Zuverlässiger ist es, gpt-6.2-sol und Ihr aktuelles Kandidatenmodell mit derselben Charge echter Geschäftsbeispiele zu vergleichen:
- Stichprobe: Aus Produktionslogs oder annotierten Daten eine repräsentative Menge von Requests ziehen, die häufige Aufgaben und Langschwanz-Aufgaben abdeckt.
- Einheitliche Eingabe: Derselbe Prompt, dieselben Daten, nur die Modellkennung ändern, um Störungen durch Prompt-Unterschiede auszuschließen.
- Mehrdimensionale Bewertung: Nicht nur die Punktzahl betrachten, sondern auch die Formatkonformitätsrate, Fehlerrate, durchschnittlichen Token-Verbrauch und durchschnittliche Dauer.
- Manuelle Stichprobenprüfung: Ausdrucksqualität und Faktenfehler, die maschinelle Metriken nicht erkennen, müssen von Menschen geprüft werden.
- Entscheidung: Die Zulassungsschwelle für den Wechsel klar festlegen, z. B. ab welchem Niveau von Formatkonformitätsrate und Fehlerrate freigegeben wird.
Das Ziel des Vergleichs ist nicht der Beweis, dass das neue Modell besser ist, sondern die Beantwortung der Frage: „Deckt der Nutzen des Wechsels bei der aktuellen Aufgabe die Migrations- und Betriebskosten ab?“. Ist der Unterschied nicht signifikant, ist das Beibehalten des Status quo ebenfalls eine richtige Entscheidung. Innerhalb derselben Serie können Sie für die schwierigsten und langwierigsten Aufgaben auch gpt-6.2-astra in den Vergleich aufnehmen; für die meisten Aufgaben empfiehlt es sich, zunächst Sol zu verwenden.
Häufige Fragen und Vorgehen zur Fehlerbehebung
Bei häufigen Problemen in der frühen Anbindungsphase führt die Fehlersuche in der folgenden Reihenfolge meist am schnellsten zum Ziel:
- Timeout: Prüfen Sie zuerst, ob die Eingabe zu lang ist und dadurch die Bearbeitungszeit steigt, dann, ob es an Netzwerk oder serverseitiger Ratenbegrenzung liegt. Ein Degradationsplan sollte vor dem Störfall bereitstehen.
- Ausgabe abgeschnitten: Prüfen Sie, ob die Obergrenze für die Generierungslänge zu klein gesetzt ist und ob der System-Prompt eine zu lange Ausgabe verlangt. Abschneiden ist oft kein Modellproblem, sondern ein Parameterproblem.
- Ausgabeformat passt nicht: Stellen Sie sicher, dass die Formatanforderungen im Prompt konkret genug sind, und dass serverseitig Validierung und Wiederholung eingebaut sind; bei wiederholtem Fehlschlag erwägen Sie klarere Beispielvorgaben.
- Authentifizierung fehlgeschlagen: Prüfen Sie, ob der Schlüssel korrekt eingebracht wurde, ob der serverseitige Schlüssel versehentlich an das Frontend gelangt ist und ob Umgebungsvariablen fehlen.
- Fehler durch Ratenbegrenzung: Bestätigen Sie Dimension und Schwellenwert der Ratenbegrenzung, bauen Sie Backoff und Warteschlangen ein, um zu vermeiden, dass momentane Parallelität das Limit ausschöpft.
Die grundlegende Disziplin bei der Fehlersuche: Zuerst feststellen, ob es ein Problem der Request-Konstruktion, der serverseitigen Einschränkung oder der Parsing-Logik im Geschäftscode ist, und dann ändern. Verlassen Sie sich nicht darauf, durch Parameteränderungen zu raten.
Überwachung und Iteration nach dem Go-live
Der Go-live ist nicht das Ende. Betrachten Sie die Anbindung als eine kontinuierlich laufende Kette und behalten Sie mindestens diese Kennzahlen im Blick: Aufrufmenge und Erfolgsrate, Formatkonformitätsrate, durchschnittliche Token-Menge von Eingabe und Ausgabe, durchschnittliche Dauer, Anteil von Degradation und Wiederholungen. Sie entsprechen den vier Dimensionen Kapazität, Qualität, Kosten und Stabilität.
Beim Iterationstempo empfiehlt es sich, in festen Zyklen fehlgeschlagene Stichproben und Nutzerfeedback zu überprüfen, typische Fehler in neue Bewertungsfälle zu überführen und darauf aufbauend Prompts, Chunking-Strategie und Ausgabegrenze anzupassen. Wenn sich die Modell- oder Plattformkonfiguration ändert, führen Sie mit derselben Bewertungsstichprobe eine Regression durch, bevor Sie über eine Ausweitung entscheiden.
Ein brauchbares Prinzip für den Go-live: Zuerst mit kleinem Traffic im Graustufenbetrieb die tatsächliche Wirkung validieren, dann schrittweise ausweiten und jederzeit einen Schalter zum Zurückfallen auf das alte Modell behalten. Wenn Sie zunächst die Modelldetails und Anbindungsinformationen ansehen möchten, beginnen Sie mit /models/gpt-6.2-sol. Nur wenn Sie die drei Dinge – Grenzen der Fähigkeiten, Kostenmodell und Überwachung – gleichzeitig solide umsetzen, kann gpt-6.2-sol ein stabiler und zuverlässiger Textbaustein in Ihrem System werden.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
gpt-6.2-astra Einstiegsleitfaden: Grenzen der Textmodell-Fähigkeiten, Integrationspunkte und Kostenkontrolle
-

Benutzerhandbuch
Tripo H3.1 Einstiegsleitfaden: Drei Eingabewege, Parameter und Preiswahl
Praktische Entscheidungsfindung und Kostenkontrolle bei der 3D-Generierungsintegration für Entwickler
-

Benutzerhandbuch
E-Commerce-Produktbilder mit qwen-image-2.1-turbo über die HiAPI-API generieren
Ein schneller Katalog-Visual-Workflow für Entwickler: transparente PNG-Ausgaben und lauffähige API-Anfragen