
Guía de uso
GLM 5.3 extracción estructurada en la práctica: cada campo JSON con respaldo en el texto original
Extraer campos con el modo de objeto JSON: frenar los errores antes de almacenarlos mediante valores ausentes, citas y validaciones de negocio

En esta página
Por qué la salida estructurada necesita además un "respaldo en el texto original"
El modo de objeto JSON (response_format: {"type": "json_object"}) resuelve la cuestión de «si la forma de salida es un objeto JSON», no la de «si esta solicitud tendrá éxito con seguridad, si el contenido estará completo con seguridad y si el análisis no lanzará excepciones con seguridad». La solicitud puede fallar, el modelo puede rechazar responder, la salida puede truncarse por límites de longitud, la transmisión en streaming puede interrumpirse y el contenido devuelto puede ser incompleto o estar malformado; el cliente debe gestionar estos casos y las excepciones de análisis de json.loads. Primero hay que confirmar que la respuesta se completó correctamente y que el contenido está completo, y solo después pasar al análisis. Que se pueda analizar tampoco significa que se pueda usar: un formato correcto no implica que los hechos sean correctos. Si el valor de un campo se extrajo del texto original, si el modelo lo completó por su cuenta, o si un campo determinado es «el texto original no lo indica» o «el texto original lo indica vacío», nada de esto queda cubierto por las restricciones de formato.
Escribir una plantilla de campos en el prompt equivale, en esencia, a dar al modelo una «plantilla de formulario que rellenar», no una «lista de pruebas». Cuando a un campo le falta respaldo en el texto original, el modelo tiende a dar un valor que parece razonable; este es el modo de fallo más peligroso en las tareas de extracción, porque no genera error, solo contamina silenciosamente los datos posteriores.
Por eso el contrato de extracción de este artículo consta de tres partes: la definición de campos y tipos, la cita del texto original que acompaña a cada valor y la modelización explícita de valores ausentes. Las tres juntas hacen que «de dónde sale esta frase» forme parte de la salida, en lugar de ser una conjetura a posteriori.
Diseñar el contrato de extracción: campos, tipos y convención de nulabilidad
El contrato empieza por la lista de campos. Supongamos que la tarea consiste en extraer información estructurada de una descripción de oferta de empleo o de colaboración; primero fijamos los campos objetivo:
title: cadena, obligatoriobudget: número, anulabledeadline: cadena (fecha ISO), anulablecontact: cadena, anulableskills: array de cadenas, puede ser un array vacío
La clave está en que «anulable» no equivale a «se puede omitir». Se establece que todos los campos deben aparecer en la salida; cuando se desconozcan, se indica explícitamente null o un array vacío, y no se permite omitir claves. Omitir una clave impide que los sistemas posteriores distingan entre «el modelo determinó que estaba vacío» y «el modelo simplemente no procesó este campo».
En cuanto a los tipos, hay que ajustarlos a un nivel de granularidad que la máquina pueda determinar: budget solo acepta números, no cadenas como "a convenir"; deadline sigue el formato YYYY-MM-DD; skills debe ser un array de cadenas y no se permite salir del paso con una única cadena unida por comas. Cuanto más específicos sean los tipos, mejor podrá la capa de validación posterior interceptar problemas.
El siguiente bloque es la descripción de campos que se escribe en el prompt, no un parámetro de la solicitud; el parámetro de la solicitud solo se encarga de activar el modo de objeto JSON.
Genera un objeto JSON que contenga y solo contenga las siguientes claves:
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
Todas las claves deben aparecer. Cuando no se pueda determinar a partir del texto original, rellena con null (arrays con un array vacío); no adivines.
Hacer que cada campo lleve su fragmento de cita
Dar solo el valor y no la fuente equivale a renunciar a la capacidad de trazabilidad. La solución es transformar cada campo extraíble en una estructura de pares: el valor y la cita se emiten juntos.
{
  "title": {"value": "Becario de análisis de datos", "evidence": "Se contratan 2 becarios de análisis de datos"},
  "budget": {"value": 300, "evidence": "300 yuanes al día"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "Envía tu currículum a hr@example.com"},
  "skills": [
    {"value": "SQL", "evidence": "Se requiere familiaridad con SQL"},
    {"value": "Python", "evidence": "Se valora el dominio de Python"}
  ]
}
Algunos puntos clave. Primero, evidence debe ser un fragmento continuo del texto original, no una paráfrasis ni un resumen del modelo; la paráfrasis haría que la cita perdiera su valor de comparación. Segundo, cuando el valor es null, evidence también debe ser null; esta restricción por sí sola ya frena parte de las invenciones: si el modelo inventa un valor, normalmente no podrá inventar el fragmento correspondiente del texto original, y el formato se contradice a sí mismo. Tercero, los campos de tipo array dan una cita por elemento, no una sola cita para todo el array; de lo contrario, un elemento erróneo contaminaría la credibilidad de todo el grupo. Cuarto, los fragmentos de cita deben ser lo más breves posible y cubrir solo el texto mínimo que respalda el valor, para facilitar después la comparación por contención de cadenas.
Así el volumen de salida aumenta, pero a cambio se obtiene que cualquier registro que entre en el almacenamiento pueda responder «en qué frase del texto original se basa este campo».
Tratar explícitamente los valores ausentes y la incertidumbre
En las tareas de extracción, el error más frecuente del modelo no es extraer mal, sino «completar». Hay que modelizar por separado tres situaciones en el propio contrato.
Ausencia. El texto original no contiene información relacionada en absoluto y el campo se rellena con null. Esta semántica debe distinguirse de «valor igual a cadena vacía»: la cadena vacía es un valor que se ha extraído, null es que no se ha podido extraer. Solo si el nivel superior lo define con claridad podrá el nivel posterior decidir si omitir o alertar.
Ambigüedad. El texto original contiene una formulación relacionada pero insuficiente para determinarlo. Por ejemplo, solo dice «salario a convenir»; en ese caso budget debe ser null y, además, hay que indicar claramente en el prompt: no conviertas descripciones cualitativas en números ni asignes 0 a «a convenir».
Múltiples candidatos. En el texto original aparecen dos formas de contacto o dos fechas, mientras que el contrato solo acepta un valor único. Las opciones son permitir que la estructura del campo admita una lista de candidatos o establecer en el prompt una prioridad (por ejemplo, tomar la primera aparición). Sea cual sea la opción, debe quedar escrita en el contrato; de lo contrario, la estrategia de elección del modelo puede variar cada vez y el resultado será difícil de reproducir de forma estable.
Añade además una red de seguridad: permite que el modelo emita un array unresolved con la información clave que no encaje en ningún campo. Es mucho más seguro que forzarla dentro de algún campo y, además, te deja un punto de entrada para observar los modos de fallo del modelo.
Las tres capas de validación de negocio antes de almacenar
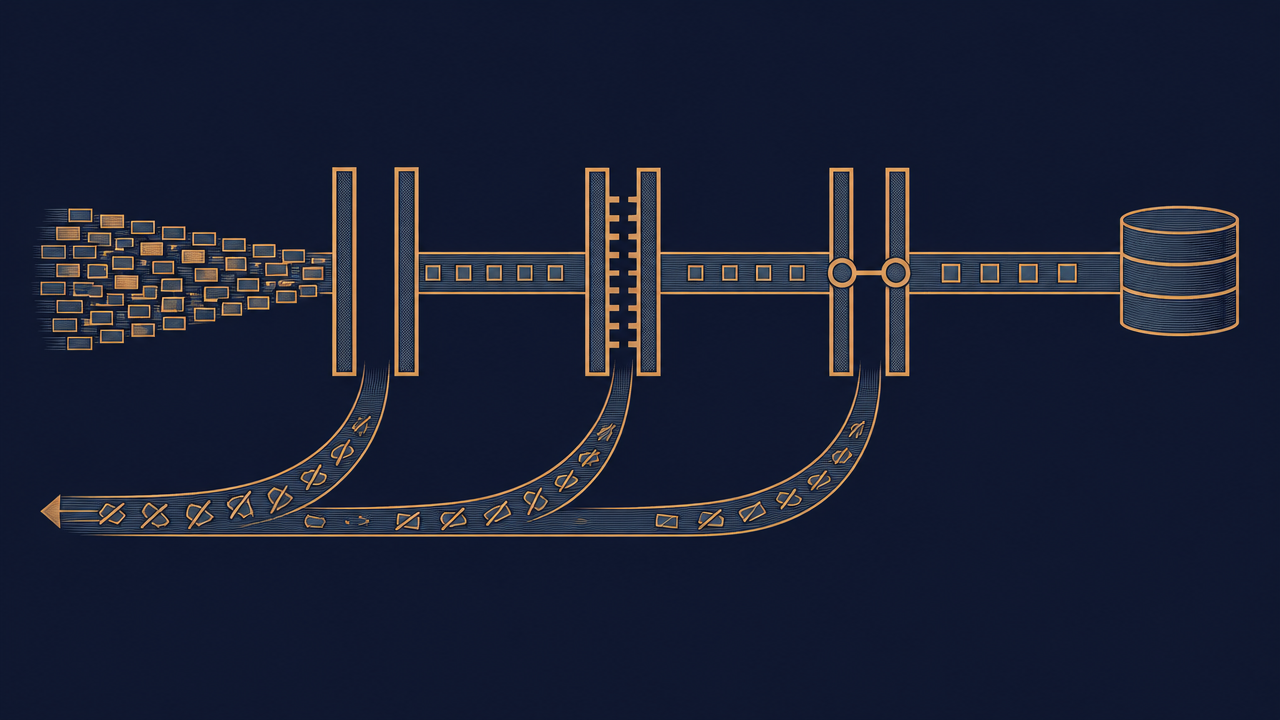
El modo de objeto JSON solo restringe la forma de la salida; el análisis aún puede fallar. La validación se ejecuta en orden: primero se confirma la integridad de la respuesta, después se realizan las validaciones de estructura y de negocio en el cliente y, por último, la comprobación de evidencias; si no se supera una capa, no se pasa a la siguiente.
Antes de analizar, comprueba: si la solicitud se devolvió correctamente, si hubo rechazo a responder, si el motivo de finalización indica truncamiento por longitud, si la respuesta en streaming terminó correctamente y si el contenido está vacío. Una vez confirmado que la respuesta se completó correctamente y que el contenido está completo, se ejecuta json.loads; si hay una excepción de análisis, se pasa directamente al tratamiento de fallo y no se envía contenido a medias a las validaciones posteriores. Solo después de un análisis correcto se entra en las tres capas de validación siguientes.
Primera capa: tipos y estructura
Si las claves están completas, si los tipos coinciden, si deadline cumple el formato de fecha y si budget es un número finito. Esta capa se resuelve con código normal, tiene bajo coste y la mayor tasa de intercepción.
Segunda capa: enumeraciones y dominio de valores
Se bloquean los valores imposibles en el negocio: importes negativos, fechas anteriores a hoy, cadenas vacías o duplicados en skills, longitudes de cadena que superan el límite del campo. Si el campo tiene un vocabulario controlado propio (como sector o nivel de puesto), aquí se hace la coincidencia contra la lista blanca y se reserva el lugar para la normalización de sinónimos.
Tercera capa: coherencia entre campos
Que un campo individual sea válido no significa que todo el registro lo sea. Las comprobaciones típicas incluyen: si cuando budget no está vacío deadline también debería estar no vacío (en muchos escenarios de negocio ambos están vinculados), si contact contradice el tipo de puesto que sugieren skills, o si la distribución de campos de registros con el mismo title dentro de un mismo lote está anormalmente concentrada. Esta capa es la más cercana a la semántica de negocio y también la que más necesita que escribas pruebas.
No olvides hacer una validación mecánica de evidence: cuando el valor no está vacío, evidence debe ser no vacío y debe poder encontrarse en el texto original de entrada mediante contención de cadenas o coincidencia difusa. Que no se encuentre no implica descartarlo directamente, pero al menos debe marcarse con baja confianza y enviarse a la cola de revisión manual.
Convertir el fallo de validación en el prompt de la siguiente ronda
Tras un fallo de validación, lo peor es reenviar la solicitud tal cual esperando que esta vez la extracción sea correcta. Es mejor reinyectar los motivos del fallo de forma estructurada:
La salida anterior no pasó la validación:
- El valor de deadline "cuanto antes" no cumple el formato YYYY-MM-DD
- No se pudo encontrar en el texto original la evidence de skills[2]
Corrige solo los problemas anteriores, mantén el resto de campos sin cambios y vuelve a generar el JSON completo.
Hay tres detalles que conviene tener en cuenta. Primero, el mensaje de error debe apuntar a la ruta concreta del campo para que el modelo pueda hacer una corrección localizada en lugar de rehacerlo todo. Segundo, hay que exigir explícitamente «mantén el resto de campos sin cambios»; de lo contrario es fácil introducir nuevos errores y provocar oscilaciones en las que se arregla uno y se rompe otro. Tercero, hay que fijar un límite de reintentos (por ejemplo, dos rondas); si se supera, el registro pasa a la cola de revisión manual en lugar de entrar en un bucle infinito: reintentar sin límite alarga la latencia y también dispara el coste.
Si el mismo tipo de error se repite en los reintentos, normalmente no es culpa del modelo, sino de un contrato redactado de forma ambigua. En ese caso conviene revisar la definición de los campos y los ejemplos, en lugar de seguir añadiendo texto al prompt.
Forma de invocación y alcance de este artículo
En HiAPI, glm-5.3 se invoca mediante el protocolo compatible con OpenAI Chat Completions; el modo de objeto JSON se activa estableciendo response_format con el tipo de objeto en la solicitud; los parámetros y nombres de campo concretos se rigen por la descripción de la interfaz en la página del modelo. La marca de capacidad jsonObject=true indica que el modelo admite el modo de objeto JSON, no que la interfaz admita el modo de respuesta JSON Schema ni que se pueda depender de que el servidor valide según el Schema; la estructura de campos, los tipos y las restricciones de negocio de este artículo se validan localmente en el cliente tras el análisis. La lógica de extracción, los campos de cita y la capa de validación se escriben en tu propio servidor; el modelo solo se encarga de producir texto según el contrato.
Este artículo solo trata el diseño del contrato y el flujo de validación, sin entrar en cifras de facturación ni promesas de rendimiento; para precios y cuotas en tiempo real, consulta el panel de precios del sitio. Solo cuando estén hechas las tres cosas —definición de campos, validación de citas y estrategia de reintentos— se pasa de «formato legal» a «semánticamente utilizable»; un formato correcto no equivale a hechos correctos, y fijar la seed tampoco garantiza una reproducción exacta, por lo que la estrategia de reintentos debe combinarse con un límite y una cola de revisión manual.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de generación de imágenes a partir de texto con Nano Banana Basic: formato, espacio en blanco y uso de prompts
Use los campos aspect_ratio y prompt de la interfaz de tareas para generar imágenes con composición clara para pancartas y tarjetas sociales
-

Guía de uso
Práctica de procesamiento de respuestas de Kimi K3: JSON completo, interrupciones de streaming y límites del reintento
-

Guía de uso
Guía para crear canciones cortas con MiniMax Music 3: cómo separar la letra, las etiquetas de sección y el brief de arreglos
Diseñar una solicitud de canción corta reproducible basándose en las dos entradas obligatorias del contrato actual