
Guía de uso
Guía de inicio con gpt-6.2-sol: límites de capacidad, integración vía API y consideraciones sobre el precio por token
Puntos clave de decisión e implementación de la integración para equipos de ingeniería

En esta página
Qué es gpt-6.2-sol y para quién es adecuado
gpt-6.2-sol es un modelo de texto lanzado por OpenAI, ya disponible en la interfaz unificada de HiAPI.ai. Es el nivel principal de uso diario de la serie GPT-6, y OpenAI lo posiciona como un modelo de uso común apto tanto para programación como para impulsar agentes a gran escala. Su tipo de salida es texto plano; este es el primer filtro para juzgar si es adecuado para ti, en lugar de tratarlo como una caja negra universal que «lo hace todo».
Sus escenarios más cómodos son: consolidación y fusión de resultados de preguntas y respuestas de conocimiento y recuperación, borradores y reescritura de contenido, extracción y clasificación de datos estructurados, juicio semántico en conversaciones multiturno, y toma de decisiones textuales como parte de un flujo (triaje, etiquetado, resumen, reconocimiento de intenciones). El punto en común de estas tareas es que la entrada es texto y la salida esperada también es texto, por lo que el modelo puede integrarse en un servicio existente como una llamada a función.
El público objetivo son los equipos de ingeniería: los que están evaluando introducir un nuevo modelo de texto o preparan migrar en lote las llamadas actuales al nuevo modelo. Si lo que necesitas es generar imágenes o audio, eso queda fuera de sus límites y debería descartarse ya en la fase de selección.
Un criterio práctico de decisión: primero escribe en una frase la tarea que quieres resolver y pregúntate «¿la entrada y la salida de esta tarea son ambas texto?». Si la respuesta es no, este modelo como mucho podrá encargarse del tramo textual del flujo.
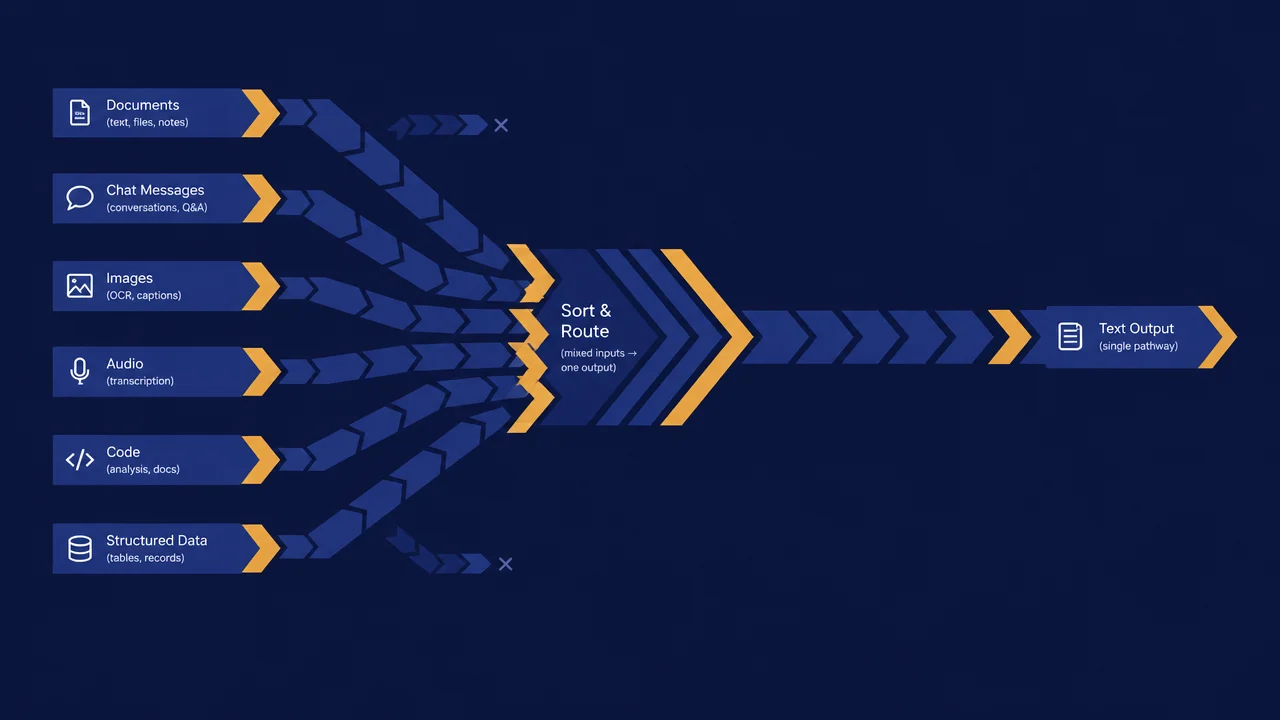
Límites de capacidad: lo que puede y no puede hacer la salida de texto
Concibe gpt-6.2-sol como una tubería de entrada de texto y salida de texto. Lo que la tubería puede hacer es claro: dado un contexto textual, produce un resultado textual. En torno a esto, las tareas que puede asumir directamente incluyen clasificación y etiquetado, resumen y reescritura, extracción de información, generación de preguntas y respuestas, conversión de formato (por ejemplo, de texto libre a texto estructurado según lo que acuerdes) y ordenación y explicación de resultados candidatos.
También hay que reconocer de antemano las partes que requieren un componente adicional:
- Las que necesitan salida estrictamente estructurada: al llamar mediante la Responses API se puede pasar un JSON Schema en
text.formaty activar strict para que la respuesta se genere directamente según la definición de campos; con Chat Completions no existe esta opción y solo se puede recurrir a restricciones en el prompt. Con Chat Completions hay que apoyarse en restricciones del prompt más validación y reintentos en el servidor; no se puede asumir que la primera respuesta sea necesariamente analizable. - Las que necesitan hechos actualizados: la salida del modelo no equivale a una fuente de verdad; los contenidos que impliquen datos, fechas o estado externo deben provenir de tu capa de recuperación o base de datos y luego entregarse al modelo para que organice el lenguaje.
- Las que necesitan productos no textuales: la generación de imágenes, voz, etc. queda fuera de su tipo de salida y debe conectarse a un componente específico aparte.
- Las que necesitan comportamiento determinista: no se garantiza que una misma solicitud se reproduzca palabra por palabra; las partes con lógica de consistencia fuerte deben residir en el código, no delegarse al juicio del modelo.
Escribir los límites en el documento de diseño sale mucho más barato que parchear después en producción. Todo tramo que exceda la capacidad textual debe marcarse explícitamente como «requiere componente externo», de modo que en la revisión no se produzcan desajustes de expectativas.
Parámetros clave y precio de gpt-6.2-sol
La siguiente es la información ya confirmada al llamar a gpt-6.2-sol a través de HiAPI; la integración y la estimación de costes posteriores se basan en ella.
- Posicionamiento: nivel principal de uso diario de la serie GPT-6. OpenAI lo posiciona como un modelo de uso común apto tanto para programación como para impulsar agentes a gran escala; es más inteligente y consume menos tokens que GPT-6.1 Sol.
- Contexto y salida: ventana de contexto de 1.050.000 tokens, salida máxima por llamada de 128.000 tokens.
- Corte de conocimiento: 2026-06-01.
- Salida y capacidades: salida de texto, compatible con salida en streaming y llamada a herramientas (
tools). - Formas de llamada: compatible con Responses API (
https://api.hiapi.ai/v1/responses) y Chat Completions (https://api.hiapi.ai/v1/chat/completions). El nivel de razonamientoreasoning.effort(low / medium / high / xhigh / max, por defecto medium) y la salida JSON estructuradatext.formatsolo están disponibles con Responses API. - Precio: el precio indicado actualmente en la página del modelo (por millón de tokens) es entrada $0.500, entrada en caché $0.025, salida $2.500 y escritura en caché (5 minutos) $0.625. La facturación se rige por lo que muestre en tiempo real la página del modelo gpt-6.2-sol.
Cómo elegir entre gpt-6.2-astra y este modelo
El gpt-6.2-astra de la misma serie es el nivel insignia, orientado a los proyectos más difíciles y de ciclo más largo, con un precio unitario más alto. Se recomienda usar Sol primero para la mayoría de tareas; cuando aparezca un problema difícil que Sol no maneje bien, como una refactorización compleja entre módulos o documentación profesional muy exigente, cambia entonces a Astra. Ambos se invocan igual; para cambiar solo hay que modificar el nombre del modelo.
Información de la interfaz que hay que confirmar antes de la integración
Al integrar en HiAPI.ai, la página del modelo /models/gpt-6.2-sol es el punto de entrada de información. Se recomienda verificar punto por punto la siguiente lista antes de escribir la primera línea de código de llamada, y guiarse por la documentación oficial y de la plataforma, sin adivinar a partir de publicaciones de la comunidad o configuraciones de proyectos antiguos:
- Credenciales y método de autenticación: de dónde proviene la clave, dónde se guarda, cómo se inyecta de forma segura en el servidor; nunca debe enviarse al navegador.
- Campos de la solicitud y obligatorios: nombres exactos y restricciones de valores de campos como el identificador del modelo, la estructura de mensajes y el límite de longitud de generación.
- Restricciones de contexto y longitud de salida: la ventana de contexto de gpt-6.2-sol es de 1.050.000 tokens y la salida máxima por llamada de 128.000 tokens; cómo se aplica el límite de salida determina directamente tu estrategia de fragmentación.
- Criterios de limitación de tasa y cuota: en qué dimensión se calculan los límites de tasa (número de solicitudes o cantidad de tokens) y qué forma tiene la respuesta al activarse.
- Semántica de los códigos de error: qué errores merecen reintento y cuáles son problemas de parámetros en los que reintentar no sirve; hay que distinguirlos.
- Criterio de facturación: este modelo se factura por token; la página del modelo indica por separado el precio unitario de entrada, entrada en caché, salida y escritura en caché.
Consolida estas conclusiones en la guía de integración interna del equipo, para que al cambiar de persona o de modelo se pueda reutilizar directamente esta lista de verificación. Si algún punto aún no está confirmado, no lo incorpores a la rama de producción.
Puntos clave de la llamada a la API y la organización de parámetros
El trabajo central del lado de la llamada no es enviar una solicitud, sino organizarla en una envoltura reutilizable, observable y degradable. Veamos primero un ejemplo mínimo: obtener JSON estructurado con la Responses API. Si usas el SDK oficial de OpenAI, basta con apuntar base_url a HiAPI:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Extrae campos del ticket; los campos ausentes se rellenan con null.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Si ya tienes un cliente de Chat Completions, basta con cambiar el nombre del modelo a gpt-6.2-sol para llamarlo, pero el nivel de razonamiento y la salida JSON estructurada no están disponibles con Chat Completions. A continuación, implementa en este orden:
Estructura de la solicitud
Divide los mensajes en dos capas: restricciones del sistema y contenido del usuario. En la capa del sistema van el rol, los requisitos de formato de salida y las prohibiciones; en la capa del usuario, los datos de negocio. No concatenes los datos de negocio con las instrucciones en un mismo párrafo; de lo contrario, cuando surja un problema no podrás determinar si es de datos o de instrucciones.
Contrato de salida
Especifica claramente la forma de salida esperada (por ejemplo, nombres de campos y si se permite texto explicativo). Aun así, realiza una validación de análisis en el servidor: si el análisis falla, se considera una llamada fallida y se aplica reintento o degradación, en lugar de pasar el producto a medias directamente al frontend.
Excepciones y reintentos
Los reintentos solo deben producirse ante errores recuperables, como un fallo de red transitorio o una limitación de tasa. Errores como parámetros inválidos o contenido demasiado largo no tienen sentido reintentarlos y deben reportarse directamente. Los reintentos deben tener un número máximo y un intervalo de retroceso, para evitar amplificar un fallo hasta convertirlo en una avalancha.
Conjunto mínimo de observabilidad
En cada llamada registra al menos: tiempo de ejecución, cantidad de tokens de entrada y salida, si se activó un reintento y si el resultado final fue éxito o degradación. Estos elementos determinan si después podrás calcular los costes y localizar problemas. Una integración sin registros equivale a no haber integrado nada.
Estructura de costes bajo el precio por token
gpt-6.2-sol se factura por token, lo que significa que el coste de una llamada no es un valor fijo, sino que se acumula linealmente con el volumen de entrada y salida. Lo que hay que establecer en ingeniería es un modelo de costes, no memorizar una cifra concreta:
- Lado de entrada: se contabilizan el prompt del sistema, el historial de conversación y el contexto recuperado. Si no se recorta una conversación multiturno, la entrada crece continuamente con cada turno.
- Lado de salida: cuanto más larga es la generación, más se factura. Pedir al modelo explicaciones extensas hace que el coste aumente de forma incontrolable.
- Coste total: el coste de una solicitud se compone de entrada y salida, por lo que la optimización debe mirar ambos extremos.
Medidas de control correspondientes: simplificar el prompt del sistema y reutilizarlo; aplicar ventana deslizante o compresión por resumen al historial de conversación; dividir primero los documentos largos y enviarlos según se necesiten; fijar un límite razonable de salida; aplicar deduplicación y caché a las tareas por lotes, para no pagar dos veces por la misma entrada.
La forma correcta de estimar el presupuesto es ejecutar una muestra real, calcular el promedio de tokens de entrada y salida y multiplicarlo por el volumen de llamadas para obtener un orden de magnitud. El precio indicado actual está en «Parámetros clave y precio» más arriba; los precios pueden ajustarse y la facturación se rige por lo que muestre en tiempo real la página del modelo.
Determinar si cambiar mediante una comparación transversal
La selección no debe basarse en una sola evaluación o en una única métrica. Una forma más segura es comparar gpt-6.2-sol con tu modelo candidato actual sobre el mismo lote de muestras de negocio reales:
- Muestreo: extrae de los registros de producción o de los datos etiquetados un lote de solicitudes representativas, que cubra tareas comunes y tareas de cola larga.
- Entrada unificada: el mismo prompt y el mismo lote de datos, cambiando solo el identificador del modelo, para excluir la interferencia de diferencias en el prompt.
- Puntuación multidimensional: no mires solo la puntuación, sino también la tasa de cumplimiento de formato, la tasa de fallos, el consumo medio de tokens y el tiempo medio de ejecución.
- Muestreo manual: la calidad de expresión y los errores de hecho que las métricas automáticas no detectan requieren revisión humana.
- Decisión: define líneas de admisión claras para el cambio, por ejemplo, qué niveles de cumplimiento de formato y de tasa de fallos deben alcanzarse para dar luz verde.
El objetivo de la comparación no es demostrar que el nuevo modelo es mejor, sino responder «en la tarea actual, ¿el beneficio del cambio cubre los costes de migración y operación?». Si la diferencia no es significativa, mantener el statu quo también es una decisión correcta. Dentro de la misma serie, para las tareas más difíciles y de ciclo más largo se puede incluir también gpt-6.2-astra en la comparación; para la mayoría de tareas se recomienda usar Sol primero.
Preguntas frecuentes y ruta de resolución de problemas
Para los problemas más frecuentes al inicio de la integración, normalmente lo más rápido es investigar en este orden:
- Tiempo de espera agotado: revisa primero si la entrada es demasiado larga y eleva el tiempo de procesamiento, y luego si se trata de un problema de red o de limitación de tasa del servidor. La solución de degradación debe estar preparada antes del fallo.
- Salida truncada: comprueba si el límite de longitud de generación está configurado demasiado bajo y si el prompt del sistema exige una salida demasiado larga. El truncamiento a menudo no es un problema del modelo, sino de los parámetros.
- Formato de salida incorrecto: confirma que los requisitos de formato del prompt son suficientemente concretos y que has añadido validación y reintentos en el servidor; si los fallos son continuos, considera usar ejemplos más explícitos como restricción.
- Fallo de autenticación: verifica si la clave se inyectó correctamente, si se expuso por error la clave del servidor al frontend y si falta alguna variable de entorno.
- Error de limitación de tasa: confirma la dimensión y el umbral de la limitación, añade retroceso y colas, y evita saturar con concurrencia instantánea.
La disciplina básica para resolver problemas es: primero localizar si es un problema de construcción de la solicitud, de restricción del servidor o de análisis en el código de negocio, y luego actuar. No confíes en ajustar parámetros a la ventura.
Monitorización e iteración tras el lanzamiento
El lanzamiento no es el final. Concibe la integración como una cadena en funcionamiento continuo y vigila al menos estas métricas: volumen de llamadas y tasa de éxito, tasa de cumplimiento de formato, cantidad media de tokens de entrada y salida, tiempo medio de ejecución, y proporción de degradaciones y reintentos. Corresponden a las cuatro dimensiones de capacidad, calidad, coste y estabilidad.
En el ritmo de iteración, se recomienda revisar periódicamente las muestras fallidas y los comentarios de los usuarios, consolidar los errores típicos en nuevos casos de evaluación y ajustar en consecuencia los prompts, la estrategia de fragmentación y los límites de salida. Cuando cambien el modelo o la configuración de la plataforma, ejecuta una regresión con el mismo lote de muestras de evaluación antes de decidir si ampliar el despliegue.
Un principio de lanzamiento útil: primero valida el efecto real con un despliegue gradual de poco tráfico y luego amplía progresivamente, manteniendo en todo momento un interruptor para volver al modelo antiguo. Si quieres ver primero los detalles del modelo y la información de integración, puedes empezar por /models/gpt-6.2-sol. Solo si consolidas a la vez los límites de capacidad, el modelo de costes y la monitorización, gpt-6.2-sol podrá convertirse en un eslabón textual estable y fiable dentro de tu sistema.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de inicio de gpt-6.2-astra: límites de capacidad del modelo de texto, puntos clave de integración y control de costes
-

Guía de uso
Guía de inicio de Tripo H3.1: cómo elegir entre tres modos de entrada, parámetros y precios
Guía práctica de decisiones de integración y control de costes de la generación 3D para desarrolladores
-

Guía de uso
Generación de imágenes de productos de comercio electrónico con qwen-image-2.1-turbo mediante la API de HiAPI
Flujo de trabajo visual de catálogo rápido para desarrolladores: salida PNG transparente y una solicitud de API ejecutable