
Alibaba
Wan 2.7 Image
wan2.7-image/text-to-image
Modelo de generación y edición de imágenes lanzado por Alibaba, que integra la generación de imágenes a partir de texto, la combinación de múltiples imágenes de referencia y la edición mediante instrucciones en un mismo flujo de trabajo, con soporte para la renderización de textos largos y el control de colores de marca
Probar wan2.7-image/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image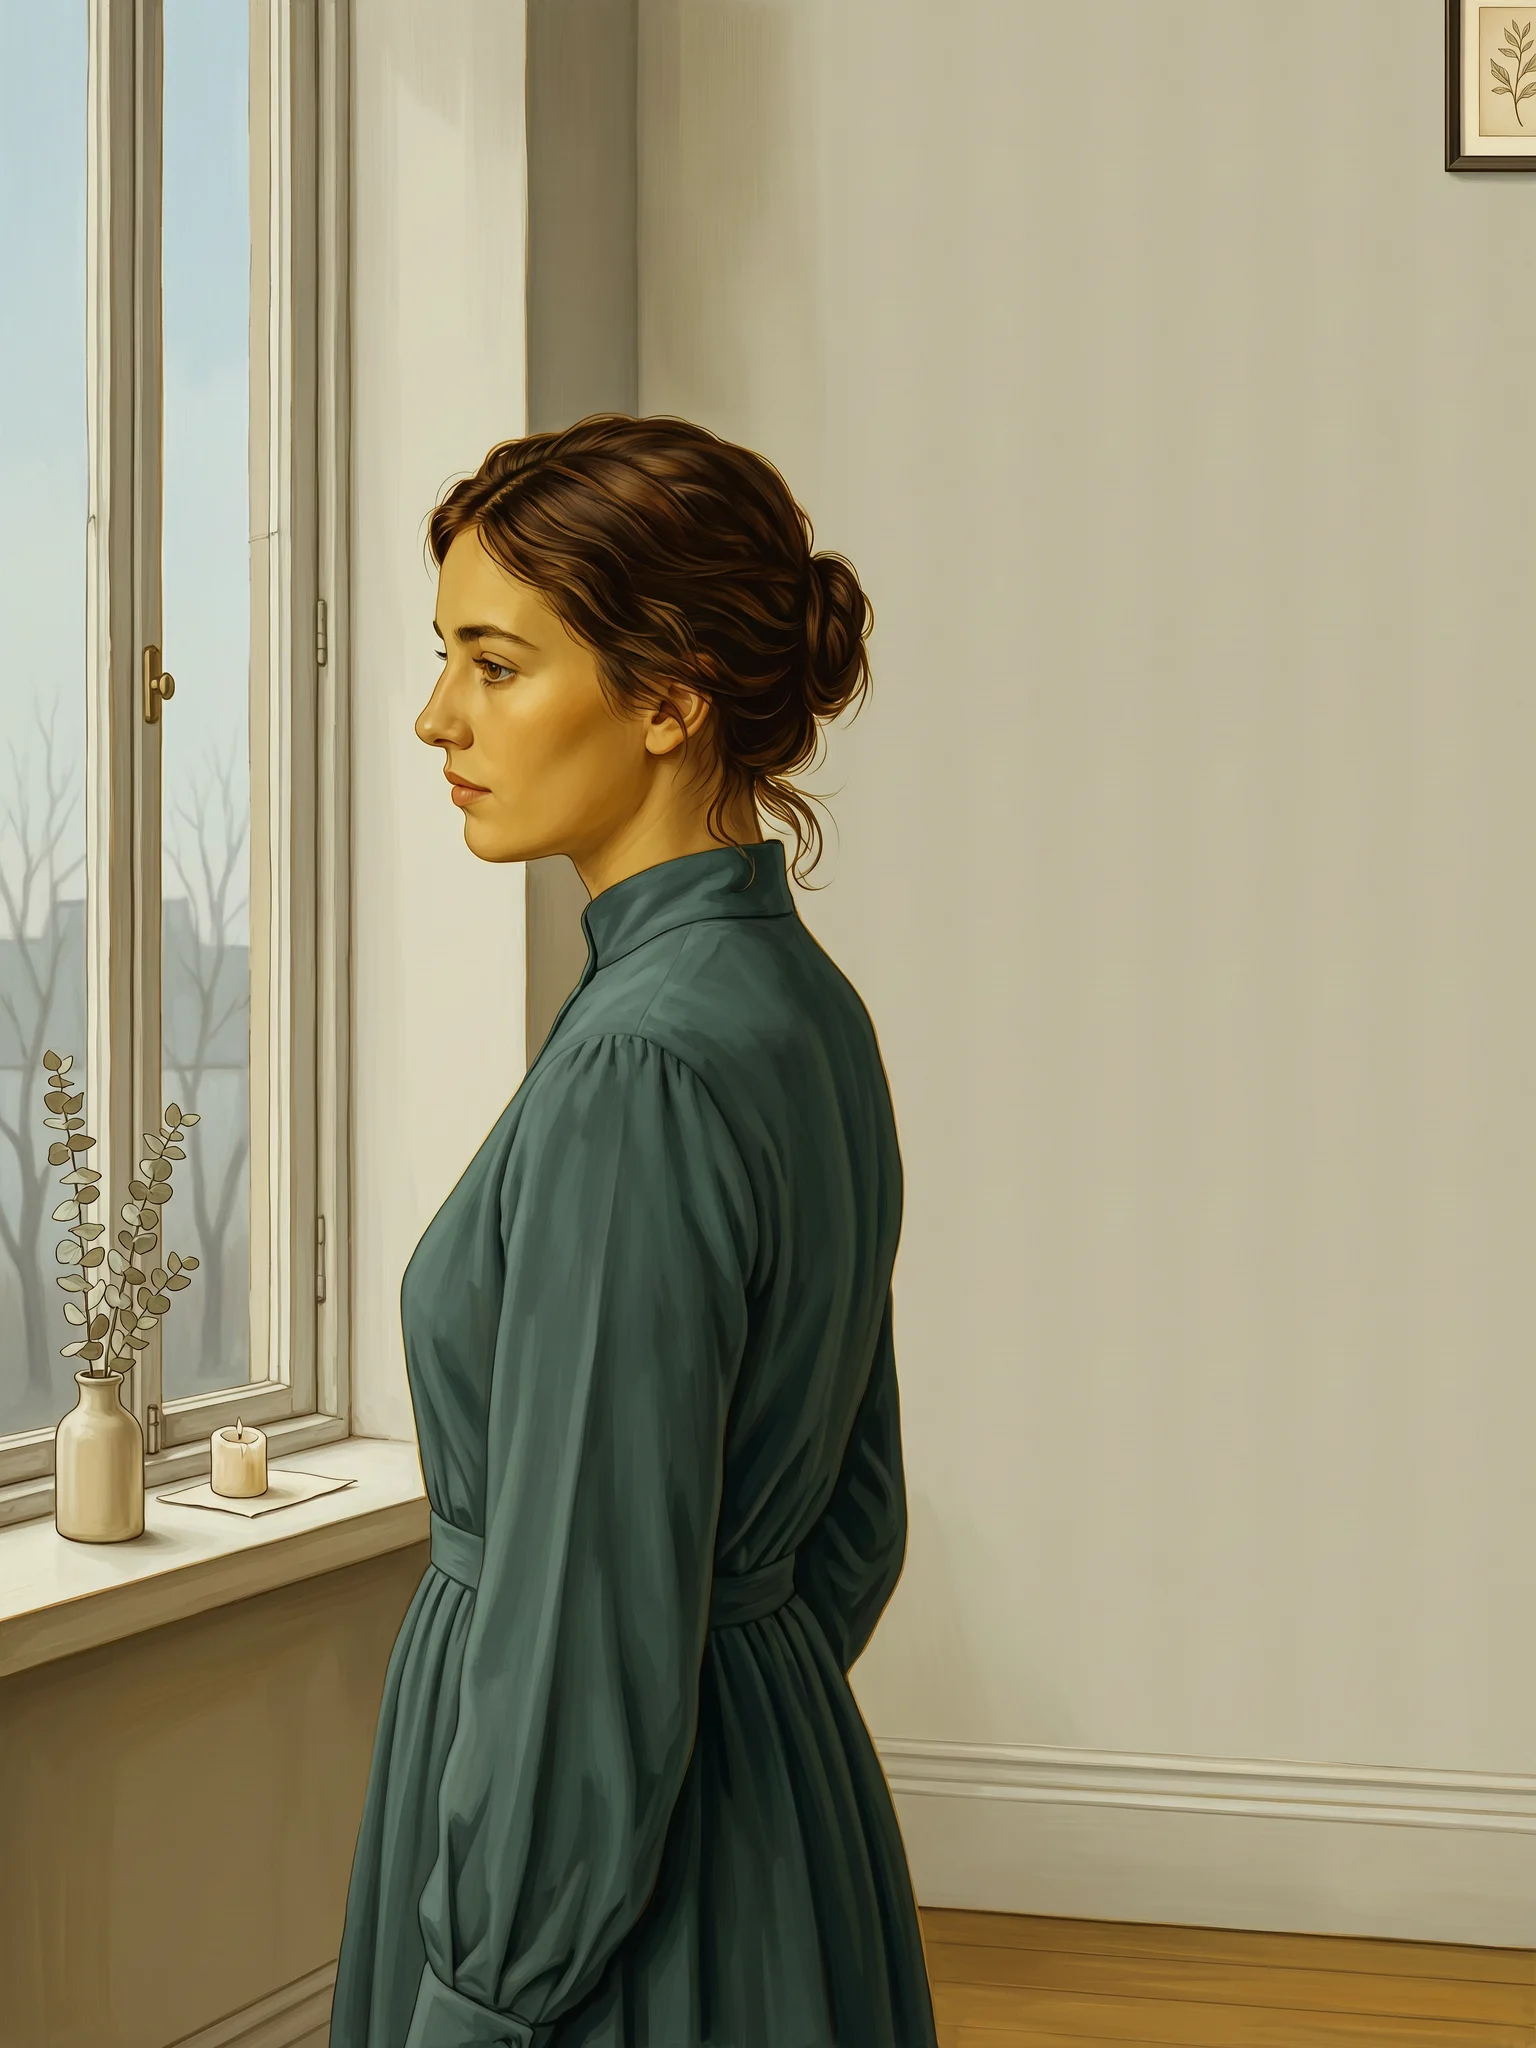
Del realismo al estilo plano: un solo prompt recorre todo el espectro de estilos de ilustración
Estilo Ilustración · style-spectrum · Diseño de personaje
Prompt
Retrato de perfil de una joven de pie junto a una ventana alta, con la cabeza ligeramente girada hacia el espectador, luz solar suave entrando desde la izquierda y un fondo interior sencillo y neutro. Composición de ilustración clásica unificada, contornos nítidos, encuadre de plano medio, con espacio negativo equilibrado a la derecha para colocar texto. Renderizado pictórico con textura de pincelada visible, tonos ocre cálido y verde azulado de baja saturación, proporciones anatómicas rigurosas, luz de contorno suave en el rostro y los hombros, sutil profundidad atmosférica en el interior, composición horizontal de 16:9, pliegues de la ropa y mechones de cabello ricos en detalle.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
wan2.7-image/text-to-image per image
| Precio unitario | $0.080 |
|---|
Descripción general
wan2.7-image/text-to-image es la línea de texto a imagen de la serie Wan de Alibaba, que se invoca en HiAPI.ai mediante una interfaz unificada. Recibe indicaciones en chino e inglés para generar imágenes, ofrece niveles de resolución opcionales de 1K y 2K y ocho relaciones de aspecto, y admite fijar una semilla aleatoria para reproducir el mismo resultado; al activar el modo de razonamiento mejorado, el modelo primero razona y luego genera la imagen, intercambiando un mayor tiempo de generación por calidad visual. Es adecuado para desarrolladores que necesitan producir material visual por lotes y que tienen requisitos sobre las especificaciones de la imagen y la reproducibilidad de los resultados, en flujos de producción como imágenes para carteles, imágenes de escenas para comercio electrónico y bocetos de guiones gráficos.
Puntos clave
- Interruptor de razonamiento mejorado, calidad y tiempo seleccionables: thinking_mode está desactivado de forma predeterminada; al activarlo, el modelo primero razona y luego genera la imagen, lo que permite alternar según los requisitos del negocio sobre la calidad de la imagen y el tiempo de espera.
- Semilla fija, resultados reproducibles: al pasar seed se puede reproducir la misma imagen, lo que facilita controlar las variables y obtener resultados estables al depurar indicaciones o generar imágenes por lotes.
- Relaciones de aspecto desde vertical hasta panorámica ultraancha: además de las proporciones habituales como 1:1, 16:9 y 9:16, también ofrece 21:9, 8:1 y 1:8, que se adaptan directamente a banners, materiales verticales y maquetaciones ultraanchas.
Descripción de capacidades
Texto a imagen en chino e inglés: las indicaciones admiten chino e inglés, con una longitud máxima de 5000 caracteres; los desarrolladores pueden describir la imagen directamente en chino o reutilizar indicaciones en inglés, lo que reduce el coste de reescritura entre idiomas.
Control de resolución y formato: la salida puede elegir niveles de 1K y 2K combinados con ocho relaciones de aspecto; una sola llamada permite obtener una imagen final que cumple las especificaciones del espacio publicitario, lo que reduce el recorte y el escalado posteriores.
Generación con razonamiento mejorado: al activar thinking_mode se mejora la calidad de la imagen pero aumenta el tiempo de generación; se puede elegir por niveles según la importancia del material, por ejemplo, desactivarlo en la fase de borrador y activarlo en la fase de versión final.
Resultados reproducibles: mediante seed se fija la aleatoriedad; la misma indicación y los mismos parámetros permiten obtener repetidamente el mismo resultado, lo que facilita la comparación de regresiones y la verificación de resultados en la producción por lotes.
Casos de uso
- Generación por lotes de imágenes para campañas por desarrolladores de marketing: se introduce el tema de la campaña y la descripción de la imagen y se genera en 16:9 o 1:1, produciendo imágenes que pueden colocarse directamente en páginas de destino y materiales publicitarios.
- Creación de imágenes de escena de productos para sistemas de comercio electrónico: se usan los textos de ventajas del producto como indicaciones para generar imágenes de escena, que sirven como material de exhibición en las páginas de detalle y de listado de productos.
- Bocetos de guiones gráficos y storyboards para equipos de contenido: se escriben indicaciones plano a plano según el guion y se fija seed, produciendo imágenes de referencia de guion gráfico reproducibles para la revisión creativa inicial.
- Adaptación de materiales a múltiples espacios publicitarios: la misma descripción se genera con proporciones como 21:9, 3:4 y 1:8, produciendo el conjunto de materiales necesario para banners, formatos verticales y espacios ultraanchos.
Limitaciones y recomendaciones de selección
Esta línea es puramente de texto a imagen: no acepta imágenes de referencia ni ofrece capacidad de edición de imágenes o repintado localizado; la resolución de salida máxima es 2K, por lo que si se necesita una imagen final en 4K debe usarse la línea Pro de la misma serie. Si la tarea depende de la consistencia entre varias imágenes, la modificación de imágenes mediante instrucciones o la edición por clics, esta línea no puede cubrirlo. El efecto de representación de texto dentro de las indicaciones no está garantizado; las imágenes finales con requisitos de maquetación precisa y colores de marca todavía requieren revisión humana. El resultado generado se ve muy afectado por la formulación de la indicación; se recomienda probar primero con un nivel inferior y una semilla fija, y luego generar imágenes por lotes.
Novedades
Ver el registro de cambios →- Nuevo modelo Ya está disponible el modelo de generación de imágenes wan2.7-image-standard
Preguntas frecuentes
Ver todas las preguntas →-
¿Qué relaciones de aspecto especiales admite Wan 2.7 Image?
Además de las versiones horizontales y verticales habituales, también admite relaciones de aspecto ultraanchas o ultraaltas como 21:9, 8:1 y 1:8.
-
¿Qué hace el Thinking Mode?
Al activarlo aumenta el tiempo de generación para mejorar el razonamiento y la organización visual de prompts complejos; para borradores rápidos puede permanecer desactivado.
-
¿Cómo elegir entre 1K, 2K y 4K?
Primero usa 1K o 2K para validar la dirección y, cuando finalmente necesites una salida mayor, elige 4K. El precio actual de la página es un precio fijo por imagen individual.
-
¿Admite imágenes de referencia?
El ID de modelo actual corresponde a una ruta de generación de imágenes puramente a partir de texto y no acepta imágenes de referencia.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: wan2.7-image/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para wan2.7-image/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria para reproducir el resultado de la generación; establecer la misma semilla permite obtener una salida idéntica.
promptstringObligatoriominLength 1maxLength 5000Indicación de texto para la generación de imágenes; admite entrada en chino e inglés y determina el contenido de la imagen generada.
resolutionstringOpcionalPredeterminado: "2K"Nivel de resolución de salida; Pro admite hasta 4K; por defecto 2K.
1K2K4Kaspect_ratiostringOpcionalPredeterminado: "1:1"Relación de aspecto de la imagen de salida; por defecto 1:1.
1:116:94:321:93:49:168:11:8thinking_modebooleanOpcionalPredeterminado: falseSi se activa el razonamiento mejorado para aumentar la calidad de la imagen generada, lo que incrementa el tiempo de generación; desactivado por defecto (false).
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "wan2.7-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "thinking_mode": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "wan2.7-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "wan2.7-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Grok Imagine xAI $0.011 /segundo
-
 Krea 3 Krea $0.036 /imagen
-
 Grok Imagine Image 2.0 xAI $0.052 /imagen
-
 GPT Image 2.5 OpenAI $0.017 /imagen
-
 FIBO 1.5 Bria $0.058 /imagen
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 FASHN Tryon v1.6 FASHN $0.107 /imagen
-
 Seedream 5.0 ByteDance $0.025 /imagen
-
 Nano Banana Pro Google $0.057 /imagen
-
 Recraft V4.1 Recraft $0.010 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 Ideogram V3 Character Ideogram $0.090 /imagen
Mismo proveedor
-
 Qwen Image 2.0 Alibaba $0.042 /imagen
-
 Qwen Image 2.1 Alibaba $0.020 /imagen
-
 Z-Image Alibaba $0.008 /imagen
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caracteres
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Wan 3.0 Video Alibaba $0.040 /segundo
- Qwen Image 3.0 Alibaba $0.036 /imagen
-
 HappyHorse 1.1 Alibaba $0.160 /segundo