
Alibaba
Z-Image
z-image
Modelo de texto a imagen de código abierto Tongyi de Alibaba, con arquitectura DiT de flujo único de aproximadamente 6 mil millones de parámetros, destacado en la renderización de texto en chino e inglés y en el seguimiento de instrucciones bilingües
Probar z-image
Entrada
Creaciones
Ver todas las creacionesSalida
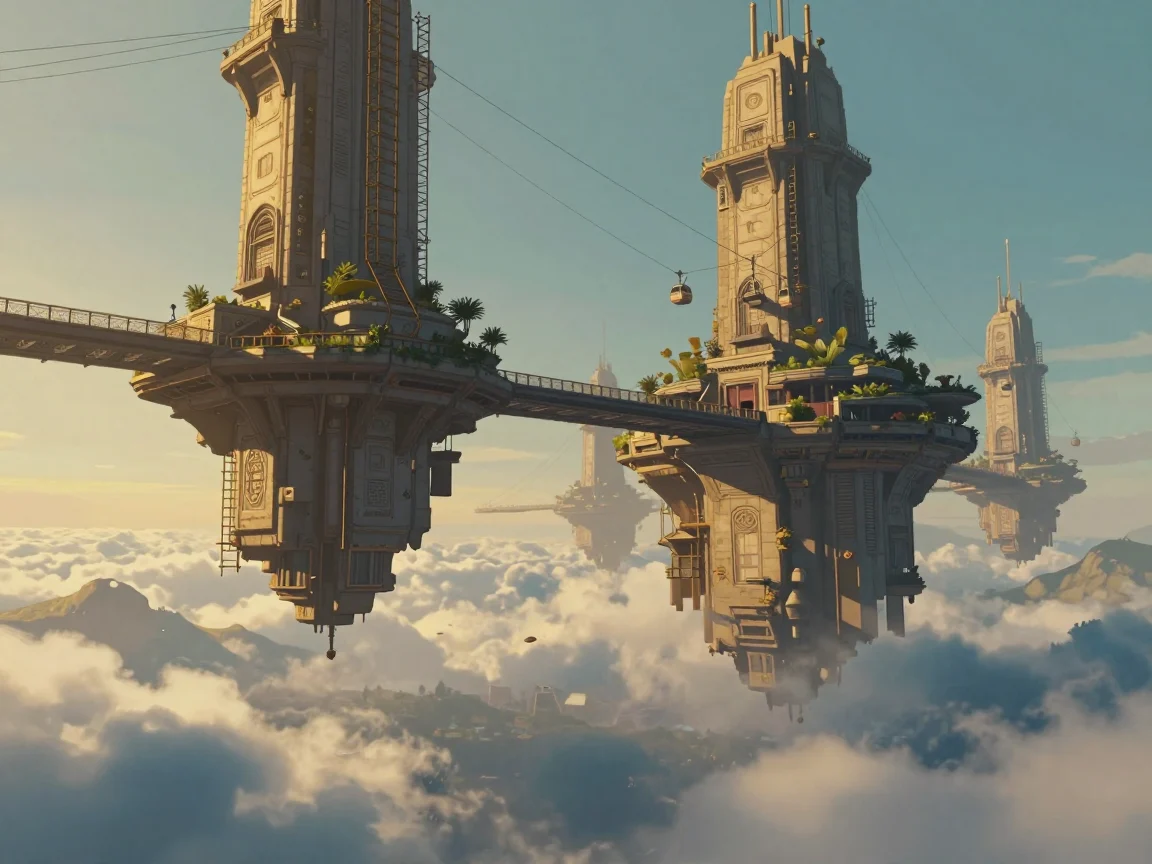
z-image 概念艺术 de universo: ciudad flotante al atardecer
Estilo Arte conceptual · Construcción del mundo · Matte painting
Prompt
Arte conceptual de entorno cinematográfico de una ciudad flotante en la hora dorada, amplio plano panorámico, con una ligera vista contrapicada. Enormes plataformas de piedra flotan sobre un mar de nubes, conectadas por puentes colgantes inclinados, ascensores de cable y jardines suspendidos; fachadas talladas y erosionadas se entrelazan con esbeltos andamios de latón. La cálida luz del sol poniente incide oblicuamente desde la izquierda, proyectando largas sombras, con niebla de luz volumétrica entre las plataformas y sombras de azul frío en el valle inferior. En la distancia, capas de mar de nubes y siluetas tenues de montañas crean profundidad; en primer plano, pequeñas figuras humanas sobre un puente sirven como referencia de escala. Acabado de pintura mate de estilo pictórico, gran riqueza de detalles, color contenido, dominado por ámbar, gris azulado y gris pizarra, perspectiva aérea natural, sin destellos de lente exagerados. Composición en 16:9, horizonte situado en el tercio inferior, con espacio negativo de cielo despejado en la zona superior.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
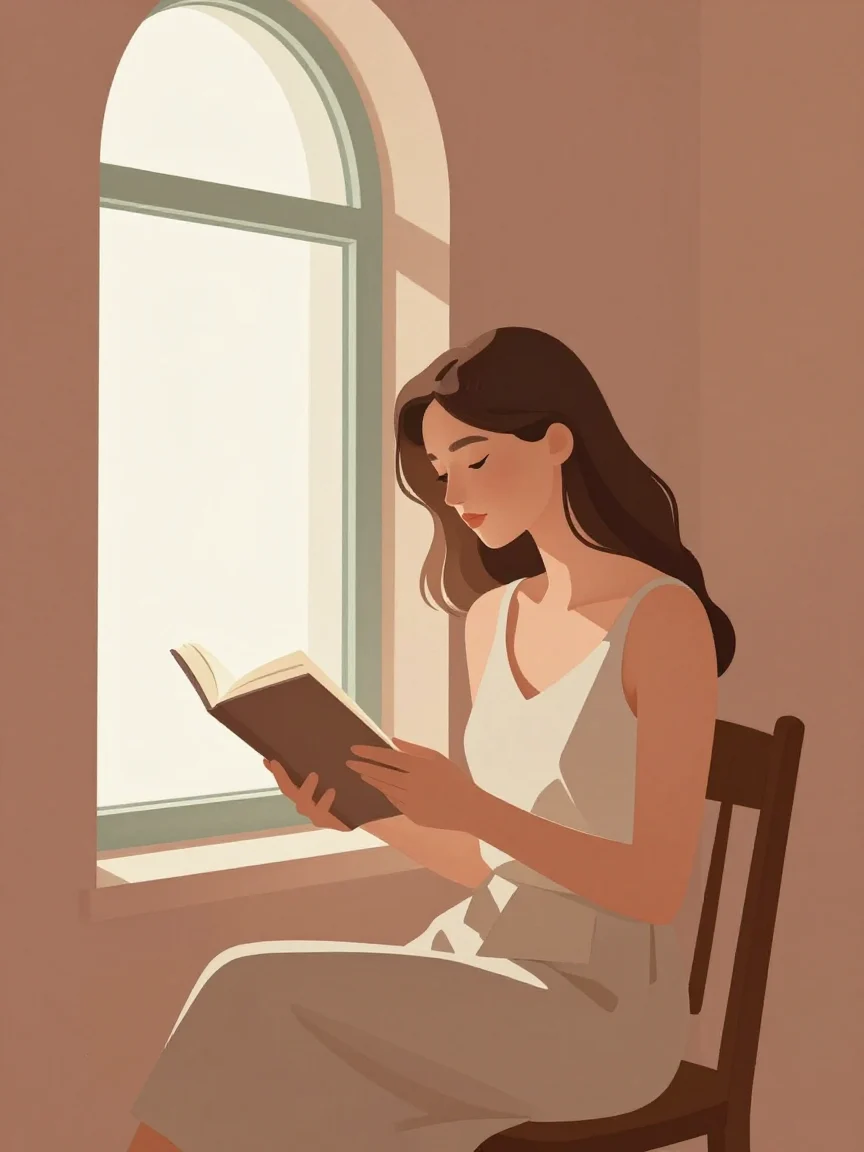
Espectro de estilos de z-image: del realismo al estilo plano sobre un mismo motivo
Estilo style-spectrum · Ilustración · Diseño de personaje
Prompt
Una joven sentada sola, leyendo junto a una ventana alta en arco, presentada como ilustración editorial estilizada. Composición: formato horizontal de 16:9, figura en tres cuartos ligeramente a la derecha del centro, luz de ventana entrando desde la izquierda, amplio espacio negativo en la esquina superior izquierda. Estilo: pintura digital semirrealista en transición hacia formas vectoriales planas — sombreado de piel con volumen suave y contenido, pliegues de ropa y fondo simplificados en grandes áreas de color limpio de bordes nítidos, paleta de terracota cálido y verde salvia grisáceo, sutil textura de grano de papel, brillos pictóricos conservados solo en rostro y manos. Iluminación: luz solar direccional con caída suave, luz de contorno tenue en hombros y mechones de pelo. Sin texto, sin marca de agua.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
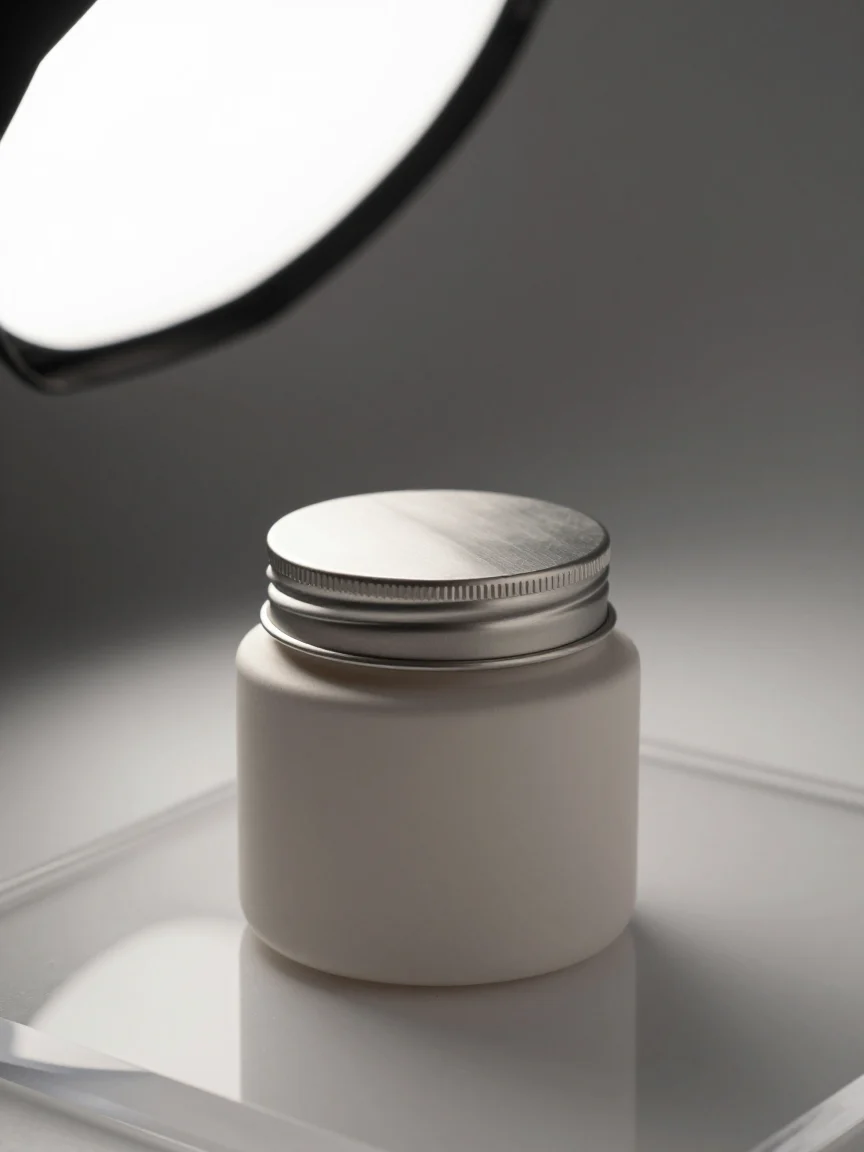
Fotografía de producto para e-commerce con la calidad visual de z-image
Estilo Imagen de producto · Iluminación de estudio · ecommerce
Prompt
Fotografía de producto comercial para e-commerce, tarro de cosmético de cerámica mate con tapa de metal cepillado, centrado sobre una superficie de papel de fondo gris cálido sin costuras, luz principal de softbox grande en la parte superior izquierda, sutil luz de contorno en el borde derecho del tarro, suave sombra degradada hacia la parte inferior derecha, tenue reflejo sobre la superficie de acrílico transparente, textura de cerámica y roscas de la tapa con detalle a nivel macro, sensación de objetivo de 85 mm, profundidad de campo reducida con bordes del producto nítidos, colorimetría neutra y equilibrada, espacio limpio en la parte superior para texto, sin texto, estética de catálogo de alta gama
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
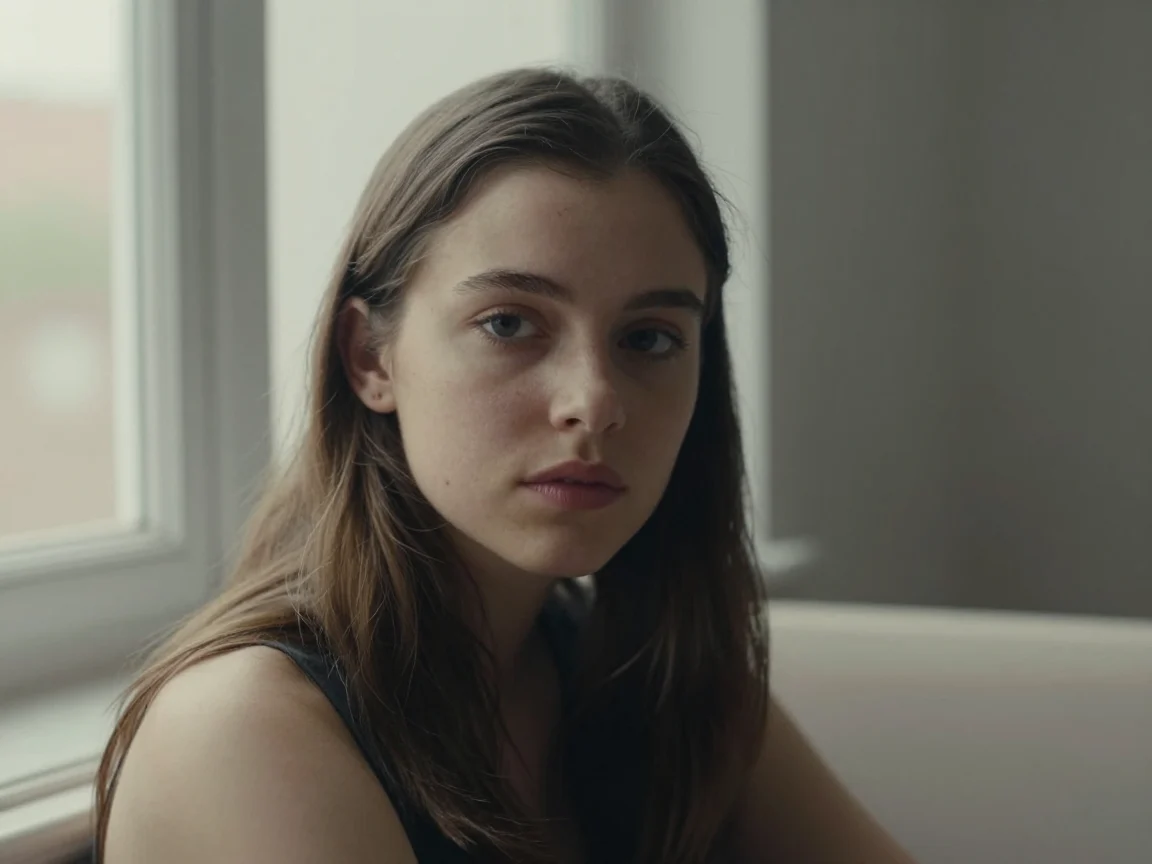
Generación de retratos con z-image: comparación de estilos realista y artístico
Estilo Retrato y fotografía · Fotorrealismo · Referencia de estilo
Prompt
Una imagen de retrato cinematográfica en 16:9: una joven sentada junto a una gran ventana, luz diurna difusa y suave que perfila su rostro desde la izquierda, textura de piel natural, poros visibles y cabellos finos, mirada serena y directa, poca profundidad de campo, fondo interior suavemente desenfocado, tonos neutros de baja saturación, grano de película delicado, calidad de objetivo de 85mm, alto detalle, realismo fotográfico
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
z-image per image
| Precio unitario | $0.008 |
|---|
Descripción general
z-image es un modelo de texto a imagen presentado por el laboratorio Tongyi de Alibaba, que se invoca mediante la interfaz unificada de HiAPI.ai y permite generar imágenes de estilo realista o artístico con indicaciones en chino e inglés, además de gestionar la composición tipográfica de texto en chino e inglés dentro de la imagen. Es adecuado para desarrolladores que necesitan producir rápidamente visuales creativos, carteles e imágenes ilustrativas estilizadas, y también para escenarios de evaluación de integración centrados en las capacidades de modelos de código abierto.
Características principales
- Indicaciones bilingües chino-inglés y renderizado de texto en la imagen: las indicaciones admiten entrada en chino e inglés y permiten renderizar texto en chino e inglés dentro de la imagen generada, lo que facilita la creación de materiales visuales con textos.
- Arquitectura DiT de flujo único, con alta eficiencia de parámetros: modela de forma unificada las condiciones de texto e imagen a nivel de secuencia, logrando una calidad visual útil con un tamaño de parámetros reducido.
- Varias relaciones de aspecto seleccionables a la vez: la salida admite cinco relaciones de aspecto: 1:1, 4:3, 3:4, 16:9 y 9:16, lo que cubre necesidades de publicación en formato cuadrado, horizontal y vertical.
- Generación de imágenes ligera con facturación por imagen: la interfaz factura según el número de imágenes generadas; la indicación y la relación de aspecto son las únicas entradas, lo que simplifica la integración y el cálculo de costes.
Descripción de capacidades
Texto a imagen en chino e inglés: basta con introducir una indicación en chino o inglés de hasta 1000 caracteres para generar imágenes, adecuado para validar rápidamente direcciones creativas o producir materiales ilustrativos en lote.
Renderizado de texto dentro de la imagen: puede mostrar texto en chino e inglés dentro de la imagen, adecuado para crear bocetos visuales con títulos o eslóganes y reducir la composición tipográfica posterior.
Control de la relación de aspecto: mediante aspect_ratio se especifica uno de los cinco formatos, por defecto 1:1, lo que permite ajustarse directamente a los requisitos de composición de distintos emplazamientos publicitarios.
Representación realista y estilizada: la misma interfaz cubre tanto escenas realistas como salidas artísticas estilizadas, abarcando desde visuales de producto hasta ilustraciones creativas.
Escenarios de uso
- Personal de operaciones crea imágenes para redes sociales: genera imágenes verticales o cuadradas con indicaciones en chino e inglés y un formato especificado, para publicarlas directamente en plataformas sociales.
- Diseñadores generan fondos de carteles y tipografía de títulos: introduce indicaciones que incluyan el texto del título para obtener imágenes con composición tipográfica, que sirven como borrador de cartel para su posterior retoque.
- Desarrolladores integran capacidades de texto a imagen: pasan la indicación y la relación de aspecto por la interfaz unificada e integran las imágenes generadas en sus propias aplicaciones o flujos de producción de contenido.
- Equipos creativos exploran estilos: con la misma indicación cambian rápidamente la descripción del estilo para generar imágenes, lo que sirve para comparar propuestas y confirmar la dirección visual.
Limitaciones y recomendaciones de selección
La interfaz solo admite actualmente dos entradas: la indicación de texto y la relación de aspecto; no permite editar imágenes ni usar referencias de múltiples imágenes mediante entrada de imagen, ni ofrece parámetros detallados como pasos o intensidad de estilo. Para tareas que requieran control preciso de la composición, edición por capas o reproducción consistente de personajes, debe recurrirse a modelos que admitan estas capacidades. El resultado generado depende en gran medida de cómo se redacte la indicación; se recomienda validar el efecto con un número reducido de imágenes antes de realizar llamadas masivas.
Preguntas frecuentes
Ver todas las preguntas →-
¿Para qué es adecuado Z-Image?
Es adecuado para la generación de imágenes con prompts en chino a bajo costo, retratos realistas, letreros, paisajes nocturnos urbanos y material gastronómico.
-
¿Qué relaciones de aspecto son compatibles?
Compatible con 1:1, 4:3, 3:4, 16:9 y 9:16.
-
¿Se puede controlar la resolución o el formato?
El contrato de solicitud público actual solo expone Prompt y aspect_ratio; no se deben añadir campos de resolución o formato no declarados en la solicitud.
-
¿Admite imágenes de referencia?
No. El ID actual del modelo Z-Image es de generación de imágenes solo a partir de texto.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: z-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para z-image y la ruta default; consulta la tabla de parámetros a continuación.
promptstringObligatoriomaxLength 1000Texto de indicación para la generación de imágenes, controla el contenido de la imagen de salida, admite chino e inglés.
aspect_ratiostringOpcionalPredeterminado: "1:1"Relación de aspecto de la imagen de salida, por defecto 1:1.
1:14:33:416:99:16callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "z-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "1:1"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "z-image",
input: {
"prompt": "…",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "z-image",
"input": {
"prompt": "…",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Qwen Image 2.1 Alibaba $0.020 /imagen
-
 Krea 2 Medium Turbo Krea $0.021 /imagen
-
 FLUX.1 Schnell Black Forest Labs $0.005 /imagen
-
 Krea 3 Krea $0.036 /imagen
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagen
-
 Nano Banana Google $0.021 /imagen
-
 FASHN Tryon v1.6 FASHN $0.107 /imagen
-
 FLUX 3 Image Black Forest Labs $0.041 /imagen
-
 BRIA Product Shot Bria $0.058 /imagen
-
 Muse Image 1.0 Meta $0.015 per task
-
 Seedream 5.0 ByteDance $0.025 /imagen
-
 Seedream 4.5 ByteDance $0.045 /imagen
Mismo proveedor
-
 Wan 3.0 Video Alibaba $0.040 /segundo
-
 Wan 2.7 Image Alibaba $0.035 /imagen
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Qwen Image 2.0 Alibaba $0.042 /imagen
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caracteres
-
 HappyHorse 1.1 Alibaba $0.160 /segundo
- Qwen Image 2.1 Alibaba $0.020 /imagen