
Alibaba
Z-Image
z-image
Modello open source text-to-image di Alibaba Tongyi, architettura DiT a flusso singolo con circa 6 miliardi di parametri, eccelle nel rendering di testo cinese e inglese e nella comprensione di istruzioni bilingui
Prova z-image
Input
Creazioni
Vedi tutte le creazioniOutput
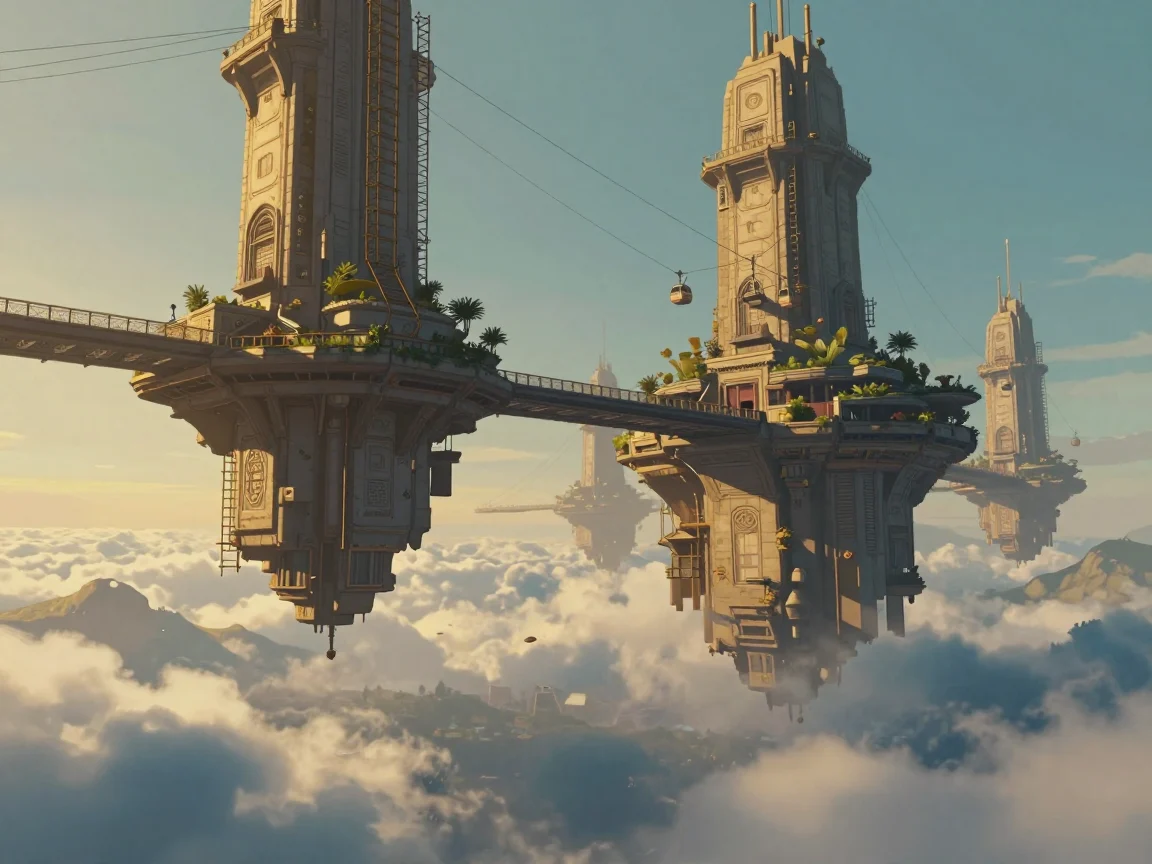
z-image Concept art sull'universo narrativo: città fluttuante al crepuscolo
Stile Concept art · Costruzione del mondo · Dipinto di sfondo
Prompt
Concept art ambientale cinematografica di una città sospesa nell'ora d'oro, ampia inquadratura panoramica, con angolazione leggermente dal basso. Enormi piattaforme di pietra fluttuano sopra un mare di nuvole, collegate da ponti sospesi inclinati, ascensori a fune e giardini pensili; facciate scolpite ed erose si intrecciano con esili impalcature di ottone. La calda luce del tramonto arriva obliqua da sinistra, proiettando ombre lunghe, una nebbia di luce volumetrica pervade lo spazio tra le piattaforme, mentre nella valle sottostante dominano ombre di un blu freddo. In lontananza strati di mare di nuvole e silhouette montuose appena percettibili creano profondità, mentre in primo piano piccole figure umane sul ponte servono da riferimento di scala. Finitura in stile pittorico matte painting, ricco di dettagli, colori sobri, dominati da ambra, grigio-verde e grigio ardesia, prospettiva atmosferica naturale, senza bagliori lens flare esagerati. Composizione 16:9, orizzonte nel terzo inferiore, con ampio spazio negativo di cielo limpido nella parte superiore.
Copia il prompt completo e adattalo alla tua generazione.
Tag
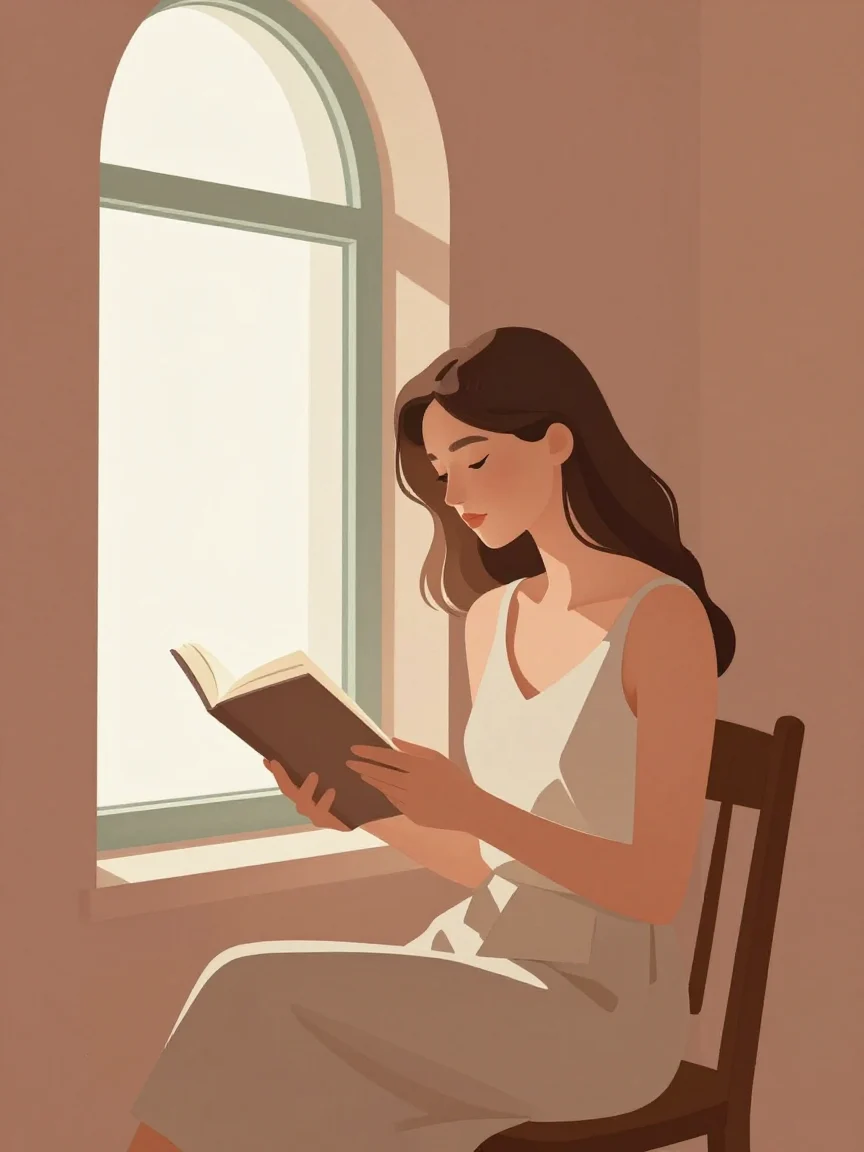
Spettro di stili di z-image: dal realismo al flat sullo stesso motivo
Stile spettro-di-stile · Illustrazione · Design dei personaggi
Prompt
Una giovane donna siede sola e legge accanto a un'alta finestra ad arco, in un'illustrazione editoriale stilizzata. Composizione: formato orizzontale 16:9, figura a tre quarti leggermente a destra rispetto al centro, luce della finestra proveniente da sinistra, ampio spazio negativo in alto a sinistra. Stile: transizione dalla pittura digitale semi-realistica alla forma vettoriale flat — chiaroscuro dell'incarnato dalla volumetria morbida e contenuto, pieghe degli abiti e sfondo semplificati in ampie campiture pulite dai contorni netti, palette di terracotta caldo e verde salvia dai toni grigi, sottile grana cartacea, riflessi pittorici preservati solo sul viso e sulle mani. Illuminazione: luce diurna direzionale, attenuazione morbida, delicata luce di contorno su spalle e ciocche di capelli. Nessun testo, nessuna filigrana.
Copia il prompt completo e adattalo alla tua generazione.
Tag
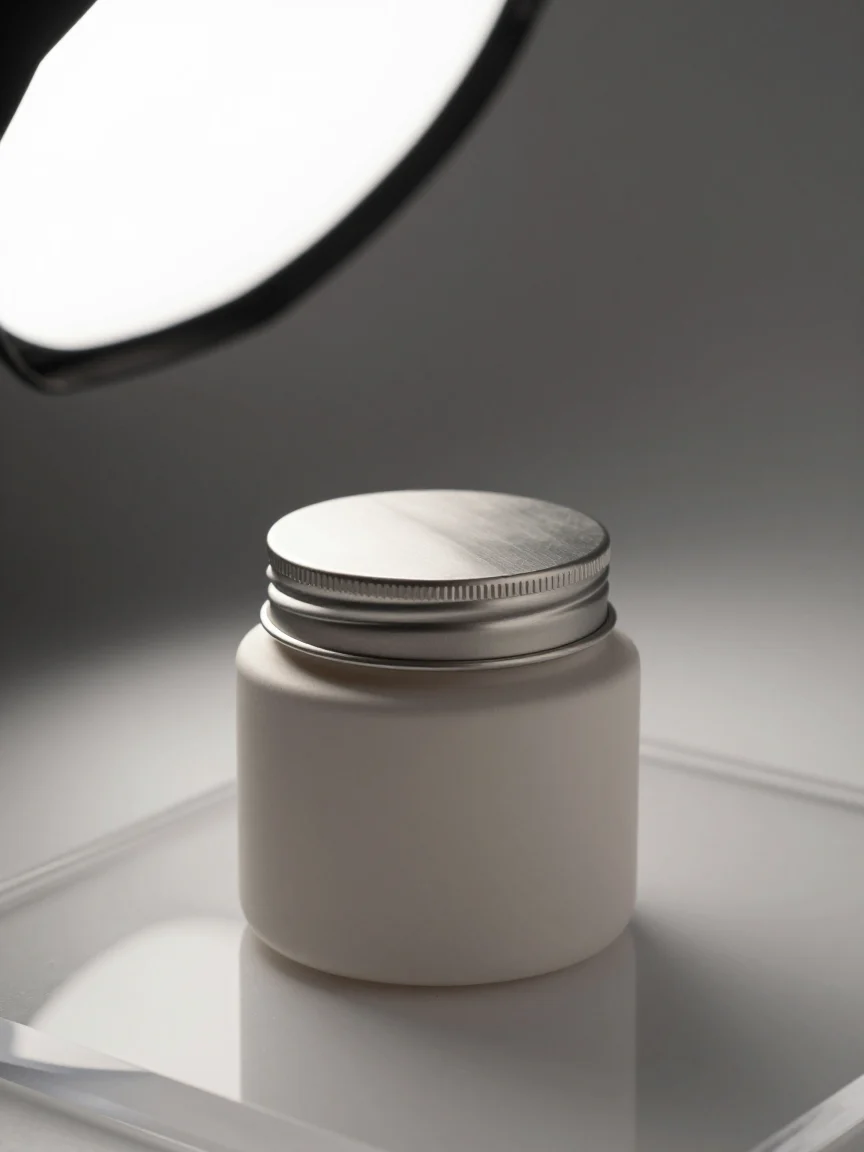
Qualità fotografica di prodotto e-commerce con z-image
Stile Immagine del prodotto · Illuminazione da studio · ecommerce
Prompt
Fotografia di prodotto commerciale e-commerce, vasetto cosmetico in ceramica opaca con coperchio in metallo spazzolato, centrato su un fondo in carta grigio caldo senza giunzioni, grande softbox come luce principale in alto a sinistra, sottile luce di contorno sul bordo destro del vasetto, ombra sfumata morbida che cade verso il basso a destra, tenue riflesso sulla superficie trasparente in acrilico, dettagli a livello macro della texture ceramica e della filettatura del coperchio, resa da obiettivo 85mm, profondità di campo ridotta con bordi del prodotto nitidi, color grading neutro ed equilibrato, spazio bianco pulito in alto per il testo, senza testo, estetica da catalogo di alta gamma
Copia il prompt completo e adattalo alla tua generazione.
Tag
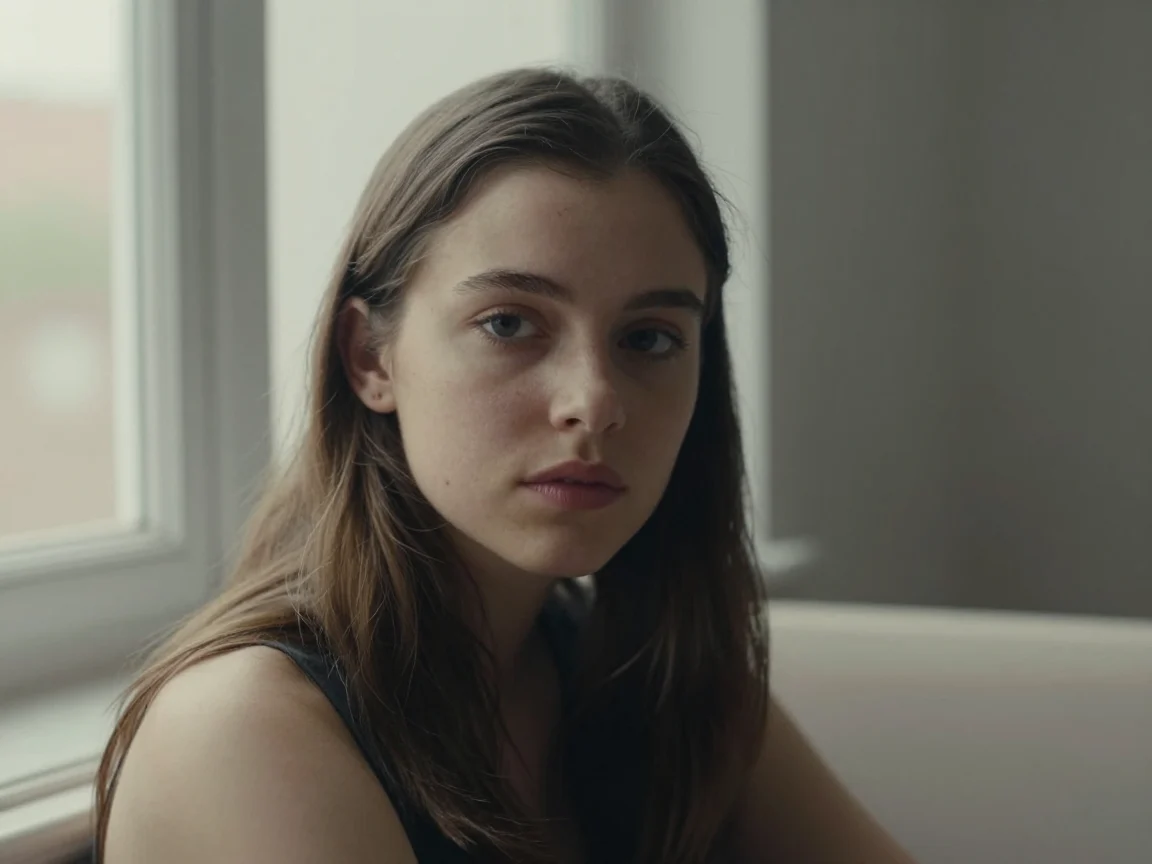
Generazione di ritratti con z-image: confronto tra stile realistico e artistico
Stile Ritratto e fotografia · Fotorealistico · Riferimento di stile
Prompt
Un ritratto cinematografico in 16:9: una giovane donna seduta accanto a una grande finestra, la luce diurna soffusa e diffusa proviene da sinistra e delinea il profilo del suo viso, texture cutanea naturale, pori visibili e capelli sottili, sguardo calmo e diretto, profondità di campo ridotta, sfondo interno dolcemente sfocato, tonalità neutre a bassa saturazione, grana fine da pellicola, resa di un obiettivo 85mm, alto dettaglio, fotorealistico
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
z-image per image
| Prezzo unitario | $0.008 |
|---|
Panoramica
z-image è un modello text-to-image sviluppato dal Tongyi Lab di Alibaba, richiamabile tramite l'interfaccia unificata di HiAPI.ai; consente di generare immagini realistiche o artistiche con prompt in cinese e inglese e gestisce l'impaginazione di testi cinesi e inglesi all'interno dell'immagine. È adatto a sviluppatori che necessitano di produrre rapidamente visual creativi, poster e illustrazioni stilizzate, e anche a scenari di valutazione dell'integrazione volti a esaminare le capacità dei modelli open source.
Punti di forza principali
- Prompt bilingue cinese-inglese e rendering del testo nell'immagine: i prompt supportano l'inserimento in cinese e inglese ed è possibile renderizzare testi cinesi e inglesi nelle immagini generate, facilitando la creazione di materiali visivi con copy.
- Architettura DiT a flusso singolo, elevata efficienza dei parametri: modella in modo unificato le condizioni testuali e visive a livello di sequenza, ottenendo una qualità visiva utilizzabile con una scala di parametri ridotta.
- Molteplici rapporti d'aspetto selezionabili in un'unica chiamata: l'output supporta cinque rapporti d'aspetto (1:1, 4:3, 3:4, 16:9, 9:16), coprendo esigenze di pubblicazione quadrate, orizzontali e verticali.
- Generazione leggera con tariffazione a immagine: l'interfaccia applica una tariffa in base al numero di immagini generate; prompt e rapporto d'aspetto sono gli unici input, semplificando integrazione e calcolo dei costi.
Descrizione delle capacità
Text-to-image in cinese e inglese: basta inserire un prompt in cinese o inglese fino a 1000 caratteri per generare un'immagine, ideale per validare rapidamente direzioni creative o produrre in batch materiali illustrativi.
Rendering del testo nell'immagine: consente di visualizzare testi cinesi e inglesi all'interno dell'immagine, adatto a creare bozze visive con titoli o slogan, riducendo la necessità di impaginazione successiva.
Controllo del rapporto d'aspetto: tramite aspect_ratio si specifica uno dei cinque formati, con impostazione predefinita 1:1, per soddisfare direttamente i requisiti compositivi dei diversi spazi pubblicitari.
Resa realistica e stilizzata: la stessa interfaccia copre sia output realistici sia stilizzazioni artistiche, rispondendo a esigenze che vanno dal visual di prodotto all'illustrazione creativa.
Scenari d'uso
- Operatori marketing che creano immagini per i social: generano immagini verticali o quadrate con prompt in cinese e inglese e formato specificato, da utilizzare direttamente per la pubblicazione di contenuti sui social.
- Designer che generano basi per poster e titoli: inserendo prompt contenenti il testo del titolo si ottengono immagini con impaginazione testuale, da usare come bozza del poster per poi rifinirla.
- Sviluppatori che integrano capacità text-to-image: tramite l'interfaccia unificata si passano prompt e rapporto d'aspetto per integrare le immagini generate in applicazioni proprie o nei flussi di produzione di contenuti.
- Team creativi che esplorano stili: con lo stesso prompt si alternano descrizioni stilistiche diverse per generare rapidamente immagini, utili al confronto di proposte e alla definizione della direzione visiva.
Limiti e consigli per la scelta
L'interfaccia attualmente supporta solo due input: prompt testuale e rapporto d'aspetto; non è possibile modificare immagini tramite input visivo né utilizzare più immagini di riferimento, e non offre parametri granulari come numero di passi o intensità dello stile. Per attività che richiedono controllo preciso della composizione, modifica per livelli o riproduzione coerente dei personaggi, occorre passare a modelli che supportino tali capacità. Il risultato generato è fortemente influenzato dalla formulazione del prompt: si consiglia di verificare l'effetto con un numero ridotto di immagini prima di procedere a chiamate in batch.
Domande frequenti
Vedi tutte le domande →-
A cosa è adatto Z-Image?
È adatto alla generazione di immagini da prompt in cinese a basso costo, ritratti realistici, insegne, panorami notturni urbani e materiali gastronomici.
-
Quali formati di immagine sono supportati?
Sono supportati 1:1, 4:3, 3:4, 16:9 e 9:16.
-
È possibile controllare la risoluzione o il formato?
L'attuale contratto pubblico delle richieste espone solo Prompt e aspect_ratio; non aggiungere campi di risoluzione o formato non dichiarati nella richiesta.
-
Supporta immagini di riferimento?
No. L'attuale ID del modello Z-Image è solo text-to-image.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: z-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per z-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriomaxLength 1000Prompt testuale per la generazione dell'immagine, controlla il contenuto della scena prodotta e supporta cinese e inglese.
aspect_ratiostringOpzionalePredefinito: "1:1"Rapporto larghezza-altezza dell'immagine di output, predefinito 1:1.
1:14:33:416:99:16callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "z-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "1:1"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "z-image",
input: {
"prompt": "…",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "z-image",
"input": {
"prompt": "…",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Recraft Crisp Upscale Recraft $0.004 /immagine
-
 Google Virtual Try-On Google $0.107 /immagine
-
 Recraft Creative Upscale Recraft $0.357 /immagine
-
 FASHN Tryon v1.6 FASHN $0.107 /immagine
-
 Seedream 5.0 ByteDance $0.025 /immagine
-
 Krea 2 Medium Turbo Krea $0.021 /immagine
-
 Grok Imagine xAI $0.011 /secondo
-
 Ideogram V4.5 Ideogram $0.011 /immagine
-
 GPT Image 2.5 OpenAI $0.017 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Nano Banana 2 Google $0.036 /immagine
-
 Ideogram V3 Character Ideogram $0.090 /immagine
Stesso fornitore
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Qwen Image 2.0 Alibaba $0.042 /immagine
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
- Wan 2.7 Image Alibaba $0.035 /immagine
-
 HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caratteri