
Guide d'utilisation
Quelle est l'API de génération d'images la plus rapide ? Chronométrage de bout en bout de 9 modèles
Même prompt, 1K, 3 exécutions par modèle : durée médiane, exécution la plus lente, prix par image, et comment choisir pour la génération en gros volume.
Nous avons chronométré 9 API de génération d'images sur HiAPI : même prompt, sortie en 1K, 3 exécutions par modèle, en mesurant depuis l'envoi de la requête jusqu'à l'obtention de l'URL de l'image générée.FLUX.2 Klein 4B est le plus rapide, avec une médiane d'environ 17 secondes, et c'est aussi le moins cher (0,00143 $ par image) ; FLUX Schnell, Grok Imagine et Z-Image suivent de près, tous entre 26 et 28 secondes. La série GPT Image et Qwen Image 3.0 demandent de 1 minute à 1 minute 30, et GPT Image 2 a connu une fois une longue traîne de plus de 6 minutes.
Résultats des tests
| Modèle | Durée médiane | Exécution la plus rapide / la plus lente | Prix par image en 1K |
|---|---|---|---|
flux-2-klein-4b/text-to-image (1 MP) |
16,6 s | 16,4 / 17,7 s | 0,00143 $ |
flux-schnell/text-to-image |
25,6 s | 17,5 / 27,1 s | 0,005 $ |
grok-imagine/text-to-image |
27,4 s | 27,0 / 47,5 s | 0,03 $ |
z-image |
27,9 s | 26,4 / 40,9 s | 0,008 $ |
nano-banana-2 |
53,7 s | 42,7 / 63,9 s | 0,036 $ (prix promo 0,018 $) |
gpt-image-2.5-flare/text-to-image |
56,7 s | 52,4 / 70,0 s | 0,05 $ (prix promo 0,025 $) |
gpt-image-2/text-to-image@ext (qualité low) |
66,9 s | 42,4 / 337,9 s | 0,007 $ |
gpt-image-2/text-to-image |
74,8 s | 74,4 / 380,9 s | 0,03 $ |
qwen-image-3.0/text-to-image |
82,3 s | 70,7 / 94,7 s | 0,0358 $ |
Testé le 15 octobre 2026 sur HiAPI : 1:1, 1K (1 MP pour Klein), 3 exécutions, avec les 9 modèles soumis simultanément à chaque exécution. La durée est mesurée depuis l'envoi de la requête de création jusqu'à l'apparition de success lors du polling (toutes les 2 secondes), temps d'attente en file inclus. Le prix promo correspond à -50 % pour la fête des programmeurs, jusqu'au 9 novembre 2026 à 0 h (heure de Pékin).
Comment lire ce tableau :
- Il s'agit du temps de bout en bout réellement attendu par votre application, pas du temps de calcul du GPU. Une exécution peut ralentir à cause de la file d'attente : la médiane de GPT Image 2 est de 75 secondes, mais une exécution a dépassé 6 minutes.
- 3 exécutions par jour, l'échantillon est petit. Il sert à classer par ordre de grandeur (moins de 30 secondes, environ 1 minute, plus de 1 minute), pas à comparer de quelques secondes deux modèles voisins.
Rendu des images
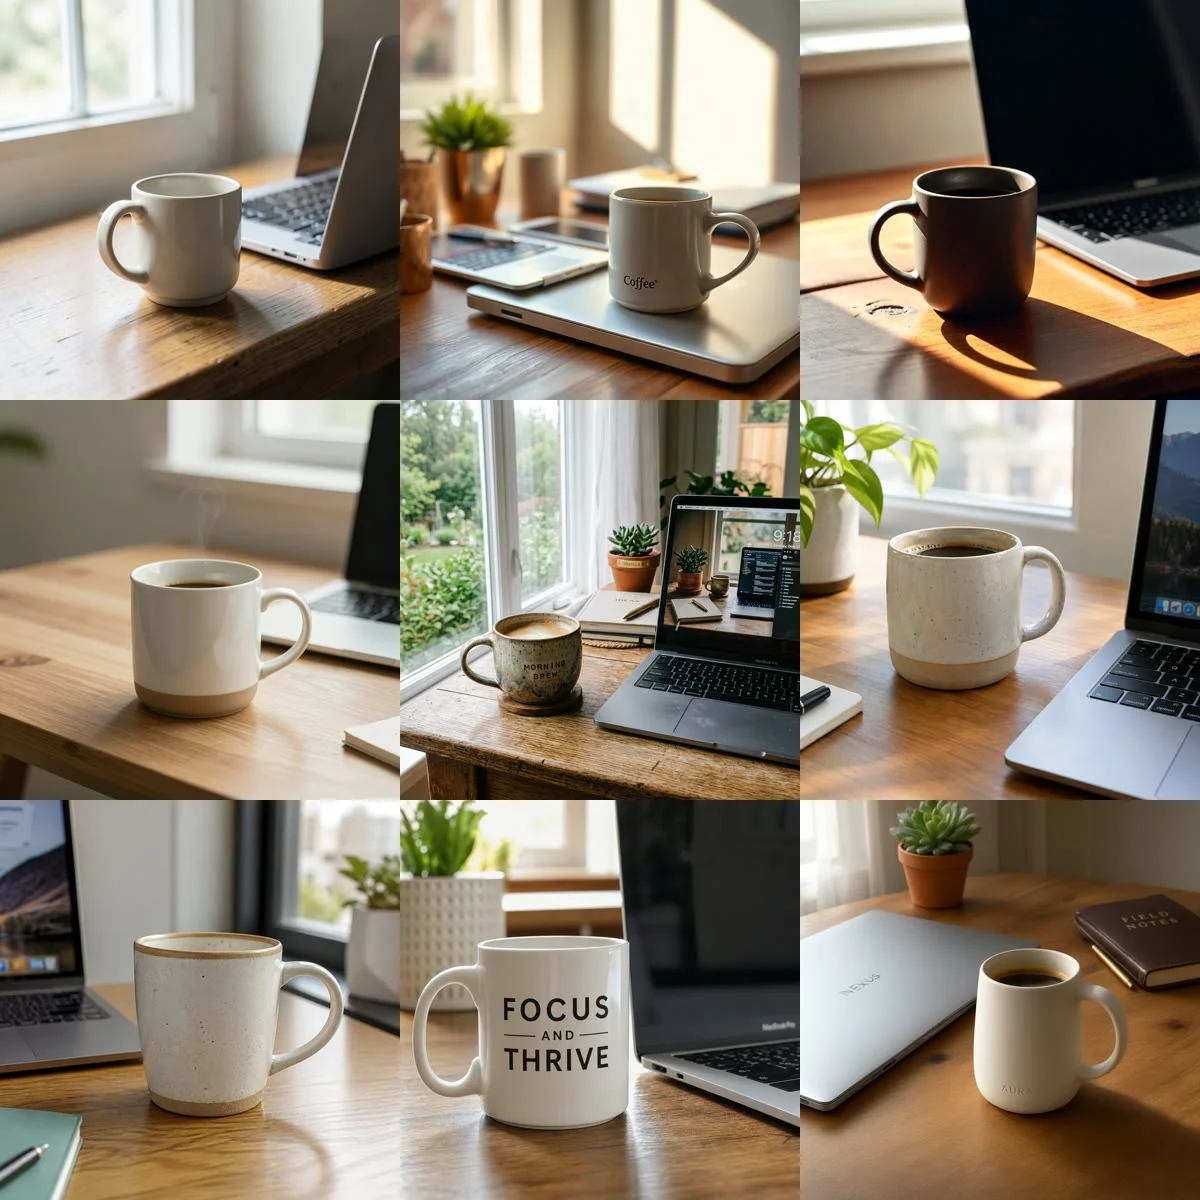
Les 9 modèles ont utilisé le même prompt ; voici les résultats de la première exécution :
A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo
Première ligne : FLUX.2 Klein 4B, FLUX Schnell, Grok Imagine ; deuxième ligne : Z-Image, Nano Banana 2, GPT Image 2.5 Flare ; troisième ligne : GPT Image 2 (qualité low, voie ext), GPT Image 2, Qwen Image 3.0. Sauf Grok Imagine en 960×960, toutes sont en 1024×1024.
Les 9 modèles ont généré une image conforme au prompt. Ceux de la catégorie rapide produisent des photos produit propres, directement utilisables ; les modèles plus lents ajoutent davantage de détails de scène (plantes vertes, ordinateur portable, vue par la fenêtre) et impriment parfois du texte sur la tasse sans qu'on l'ait demandé ("Coffee", "MORNING BREW", "FOCUS AND THRIVE"). Pour une tasse propre, ajoutez "no text, no logo" dans le prompt.
Comment choisir pour la génération en gros volume
- Vignettes, brouillons, nombreuses versions A/B : FLUX.2 Klein 4B. Rapide et bon marché dans ce test : 1 000 images en 1 MP pour seulement 1,43 $.
- Rapide, avec un rendu un peu plus soigné : FLUX Schnell (0,005 $) ou Z-Image (0,008 $), tous deux en moins de 30 secondes.
- Rapide, à prix moyen : Grok Imagine (0,03 $), environ 27 secondes.
- Images avec du texte, mise en page, visuels marketing produit : GPT Image 2 ou GPT Image 2.5, en prévoyant plus d'une minute par image. Utilisez un callback pour une livraison asynchrone, sans faire attendre l'utilisateur.
Comment obtenir plus vite un résultat avec n'importe quel modèle
- N'attendez pas dans la requête. Avec
POST /v1/tasks, rendez d'abord la main à l'utilisateur, puis récupérez le résultat via le callback ("callback": {"url": "https://votre-domaine/hiapi/callback"}). - Soumettez en parallèle. Chaque tâche est indépendante : soumettez 50 images ensemble, et la durée totale sera à peu près celle d'une seule exécution, pas de 50.
- Définissez un timeout et un plan de repli. GPT Image 2 a connu une longue traîne de 6 minutes : au-delà de quelques minutes, resoumettez ou passez à un modèle plus rapide.
- Utilisez le 1K pour les brouillons. Plus la résolution est élevée, plus c'est cher, et généralement plus c'est lent.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "flux-2-klein-4b/text-to-image",
    "input": {
      "prompt": "A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo",
      "aspect_ratio": "1:1",
      "resolution": "1 MP"
    },
    "callback": {"url": "https://votre-domaine/hiapi/callback"}
  }'
Tous les modèles ci-dessus passent par la même interface ; seuls model et les paramètres de input changent. Attention à quelques petites différences de paramètres : pour Klein, resolution s'écrit au format "1 MP", Grok Imagine prend "1k" en minuscules, et Z-Image et FLUX Schnell n'acceptent que aspect_ratio.
Questions fréquentes
Quelle est l'API de génération d'images la plus rapide ?
Dans notre test HiAPI, c'est FLUX.2 Klein 4B : en 1 MP, la durée médiane entre la requête et l'image générée est de 16,6 secondes, avec les 3 exécutions entre 16 et 18 secondes.
Le plus rapide est-il aussi le moins cher ?
Cette fois, oui. FLUX.2 Klein 4B coûte 0,00143 $ par image en 1 MP, soit le prix le plus bas du test.
Pourquoi GPT Image 2 est-il tellement plus lent ?
Nous ne voyons pas l'intérieur du modèle, seulement les durées : sa médiane est de 75 secondes, et une exécution a dépassé 6 minutes. Si vous l'utilisez, concevez votre intégration pour une livraison asynchrone.
La durée inclut-elle le réseau et la file d'attente ?
Oui. Elle est mesurée depuis notre client : requête, file d'attente, génération, plus jusqu'à environ 2 secondes de latence de polling.
Les prix de chaque modèle sont sur la page de tarifs ; pour essayer le plus rapide, ouvrez la page du modèle FLUX.2 Klein 4B.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax