
Guía de uso
¿Cuál es la API de generación de imágenes más rápida? Cronometraje de extremo a extremo de 9 modelos
Mismo prompt, 1K, 3 rondas por modelo: tiempo mediano, la ejecución más lenta, precio por imagen y cómo elegir para generar imágenes en gran volumen.
Cronometramos 9 API de generación de imágenes en HiAPI: el mismo prompt, todas generando en 1K, 3 rondas por modelo, contando desde el envío de la solicitud hasta obtener la URL de la imagen final.FLUX.2 Klein 4B es el más rápido, con una mediana de unos 17 segundos, y también el más barato ($0.00143 por imagen); FLUX Schnell, Grok Imagine y Z-Image le siguen de cerca, todos entre 26 y 28 segundos. La serie GPT Image y Qwen Image 3.0 tardan de 1 minuto a 1 minuto y medio, y GPT Image 2 registró una vez una cola larga de más de 6 minutos.
Resultados de la prueba
| Modelo | Tiempo mediano | Más rápido / más lento | Precio por imagen 1K |
|---|---|---|---|
flux-2-klein-4b/text-to-image (1 MP) |
16.6 segundos | 16.4 / 17.7 segundos | $0.00143 |
flux-schnell/text-to-image |
25.6 segundos | 17.5 / 27.1 segundos | $0.005 |
grok-imagine/text-to-image |
27.4 segundos | 27.0 / 47.5 segundos | $0.03 |
z-image |
27.9 segundos | 26.4 / 40.9 segundos | $0.008 |
nano-banana-2 |
53.7 segundos | 42.7 / 63.9 segundos | $0.036 (precio promocional $0.018) |
gpt-image-2.5-flare/text-to-image |
56.7 segundos | 52.4 / 70.0 segundos | $0.05 (precio promocional $0.025) |
gpt-image-2/text-to-image@ext (calidad low) |
66.9 segundos | 42.4 / 337.9 segundos | $0.007 |
gpt-image-2/text-to-image |
74.8 segundos | 74.4 / 380.9 segundos | $0.03 |
qwen-image-3.0/text-to-image |
82.3 segundos | 70.7 / 94.7 segundos | $0.0358 |
Probado en HiAPI el 15 de octubre de 2026: 1:1, 1K (Klein en 1 MP), 3 rondas en total, con los 9 modelos enviados simultáneamente en cada ronda. El tiempo se cuenta desde el envío de la solicitud de creación hasta que el sondeo (cada 2 segundos) muestra success, e incluye el tiempo en cola. El precio promocional es un 50 % de descuento por el Día del Programador, válido hasta las 0:00 (hora de Pekín) del 9 de noviembre de 2026.
Cómo leer esta tabla:
- Es el tiempo de extremo a extremo que tu aplicación realmente debe esperar, no el tiempo de cómputo de la GPU. Una ejecución individual puede ralentizarse por la cola, por eso la mediana de GPT Image 2 es de 75 segundos pero hubo una vez que superó los 6 minutos.
- 3 rondas en un día es una muestra pequeña. Sirve para clasificar por rangos (menos de 30 segundos, alrededor de 1 minuto, más de 1 minuto), no para comparar cuántos segundos es más rápido uno que el otro entre dos puestos adyacentes.
Resultados de generación
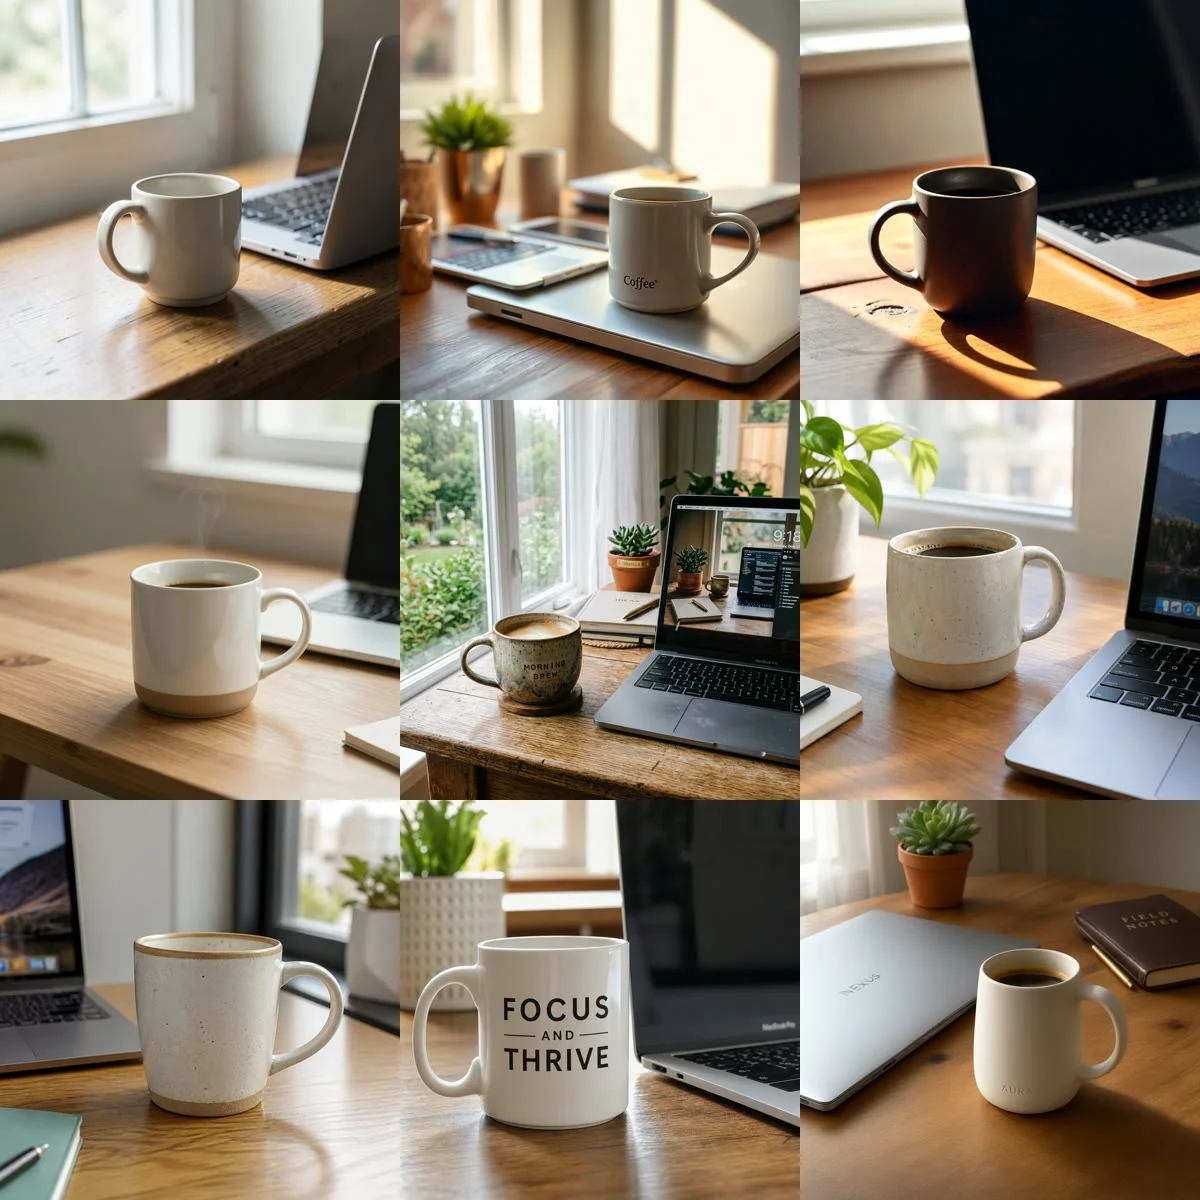
Los 9 modelos usaron el mismo prompt; estos son los resultados de la primera ronda:
A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo
Primera fila: FLUX.2 Klein 4B, FLUX Schnell, Grok Imagine; segunda fila: Z-Image, Nano Banana 2, GPT Image 2.5 Flare; tercera fila: GPT Image 2 (calidad low, ruta ext), GPT Image 2, Qwen Image 3.0. Salvo Grok Imagine, que es 960×960, el resto son 1024×1024.
Los 9 modelos generaron imágenes según el prompt. Los de la gama rápida producen fotos de producto limpias y listas para usar; los modelos más lentos añaden más detalles de escena (plantas, portátiles, vistas por la ventana) y además imprimen texto en la taza sin que se les pida ("Coffee", "MORNING BREW", "FOCUS AND THRIVE"). Si quieres una taza limpia, añade al prompt la frase "no text, no logo".
Cómo elegir para generar imágenes en gran volumen
- Miniaturas, borradores, muchas versiones A/B: FLUX.2 Klein 4B. En esta prueba fue rápido y barato; 1,000 imágenes en 1 MP cuestan solo $1.43.
- Rápido y con una imagen algo más refinada: FLUX Schnell ($0.005) o Z-Image ($0.008), ambos por debajo de 30 segundos.
- Rápido y a precio medio: Grok Imagine ($0.03), unos 27 segundos.
- Imágenes con texto, maquetación o imágenes de marketing de producto: GPT Image 2 o GPT Image 2.5, planifica más de 1 minuto por imagen. Usa entrega asíncrona mediante callback, no hagas esperar al usuario en seco.
Cómo obtener resultados más rápido con cualquier modelo
- No esperes en seco dentro de la solicitud. Envía con
POST /v1/tasksy devuelve primero al usuario; obtén el resultado desde el callback ("callback": {"url": "https://tu-dominio/hiapi/callback"}). - Envía en paralelo. Cada tarea es independiente; si envías 50 imágenes juntas, el tiempo total será aproximadamente el de una ronda, no el de 50.
- Configura timeouts y respaldo. GPT Image 2 registró una cola larga de 6 minutos; si supera unos minutos, reenvía la solicitud o cambia a un modelo más rápido.
- Usa 1K para borradores. A mayor resolución, mayor coste y normalmente también mayor lentitud.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "flux-2-klein-4b/text-to-image",
    "input": {
      "prompt": "A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo",
      "aspect_ratio": "1:1",
      "resolution": "1 MP"
    },
    "callback": {"url": "https://tu-dominio/hiapi/callback"}
  }'
Todos los modelos anteriores usan la misma interfaz; solo cambia el model y los parámetros dentro de input. Ojo con algunas pequeñas diferencias en los parámetros: el resolution de Klein se escribe en formato como "1 MP", Grok Imagine usa "1k" en minúsculas, y Z-Image y FLUX Schnell solo aceptan aspect_ratio.
Preguntas frecuentes
¿Cuál es la API de generación de imágenes más rápida?
En nuestra prueba en HiAPI fue FLUX.2 Klein 4B: 1 MP, tiempo mediano de 16.6 segundos desde la solicitud hasta la imagen, con las 3 ejecuciones entre 16 y 18 segundos.
¿El más rápido es también el más barato?
En esta ocasión, sí. FLUX.2 Klein 4B cuesta $0.00143 por imagen en 1 MP, el precio más bajo de la prueba.
¿Por qué GPT Image 2 es tanto más lento?
No podemos ver el interior del modelo, solo los tiempos: su mediana es de 75 segundos y una vez superó los 6 minutos. Si lo usas, diseña con entrega asíncrona.
¿El tiempo incluye red y cola?
Sí. Está medido desde nuestro cliente: solicitud, cola, generación y hasta unos 2 segundos adicionales de latencia de sondeo.
Consulta los precios de cada modelo en la página de precios; si quieres probar el más rápido, abre la página del modelo FLUX.2 Klein 4B.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores