
Guia de uso
Qual é a API de geração de imagens mais rápida? Cronometragem ponta a ponta de 9 modelos
Mesmo prompt, 1K, 3 rodadas por modelo: tempo mediano, execução mais lenta, preço por imagem e como escolher para geração em grande volume.
Cronometramos 9 APIs de geração de imagens no HiAPI: o mesmo prompt, todas gerando em 1K, 3 rodadas cada, contando desde o envio da requisição até o recebimento do endereço da imagem gerada.O FLUX.2 Klein 4B é o mais rápido, com mediana de cerca de 17 segundos, e também tem o preço unitário mais baixo ($0.00143 por imagem); FLUX Schnell, Grok Imagine e Z-Image vêm logo depois, todos entre 26 e 28 segundos. A série GPT Image e o Qwen Image 3.0 levam de 1 minuto a 1 minuto e meio, e o GPT Image 2 teve uma vez uma cauda longa acima de 6 minutos.
Resultados do teste
| Modelo | Tempo mediano | Mais rápido / mais lento | Preço por imagem em 1K |
|---|---|---|---|
flux-2-klein-4b/text-to-image (1 MP) |
16,6 segundos | 16,4 / 17,7 segundos | $0.00143 |
flux-schnell/text-to-image |
25,6 segundos | 17,5 / 27,1 segundos | $0.005 |
grok-imagine/text-to-image |
27,4 segundos | 27,0 / 47,5 segundos | $0.03 |
z-image |
27,9 segundos | 26,4 / 40,9 segundos | $0.008 |
nano-banana-2 |
53,7 segundos | 42,7 / 63,9 segundos | $0.036 (preço promocional $0.018) |
gpt-image-2.5-flare/text-to-image |
56,7 segundos | 52,4 / 70,0 segundos | $0.05 (preço promocional $0.025) |
gpt-image-2/text-to-image@ext (qualidade low) |
66,9 segundos | 42,4 / 337,9 segundos | $0.007 |
gpt-image-2/text-to-image |
74,8 segundos | 74,4 / 380,9 segundos | $0.03 |
qwen-image-3.0/text-to-image |
82,3 segundos | 70,7 / 94,7 segundos | $0.0358 |
Testado no HiAPI em 15 de outubro de 2026: 1:1, 1K (Klein em 1 MP), 3 rodadas, com os 9 modelos submetidos simultaneamente em cada rodada. O tempo é contado desde o envio da requisição de criação até a visualização de success na consulta periódica (a cada 2 segundos), incluindo o tempo de fila. O preço promocional é 50% de desconto do Dia do Programador, válido até 0h de 9 de novembro de 2026, horário de Pequim.
Como ler esta tabela:
- Este é o tempo ponta a ponta que sua aplicação realmente vai esperar, não o tempo de computação da GPU. Uma execução pode ficar mais lenta por causa da fila, por isso a mediana do GPT Image 2 é de 75 segundos, mas houve uma vez acima de 6 minutos.
- 3 rodadas em um dia é uma amostra pequena. Serve para classificar por faixas (menos de 30 segundos, cerca de 1 minuto, mais de 1 minuto), mas não para comparar quantos segundos um vizinho de ranking é mais rápido que outro.
Resultado das imagens geradas
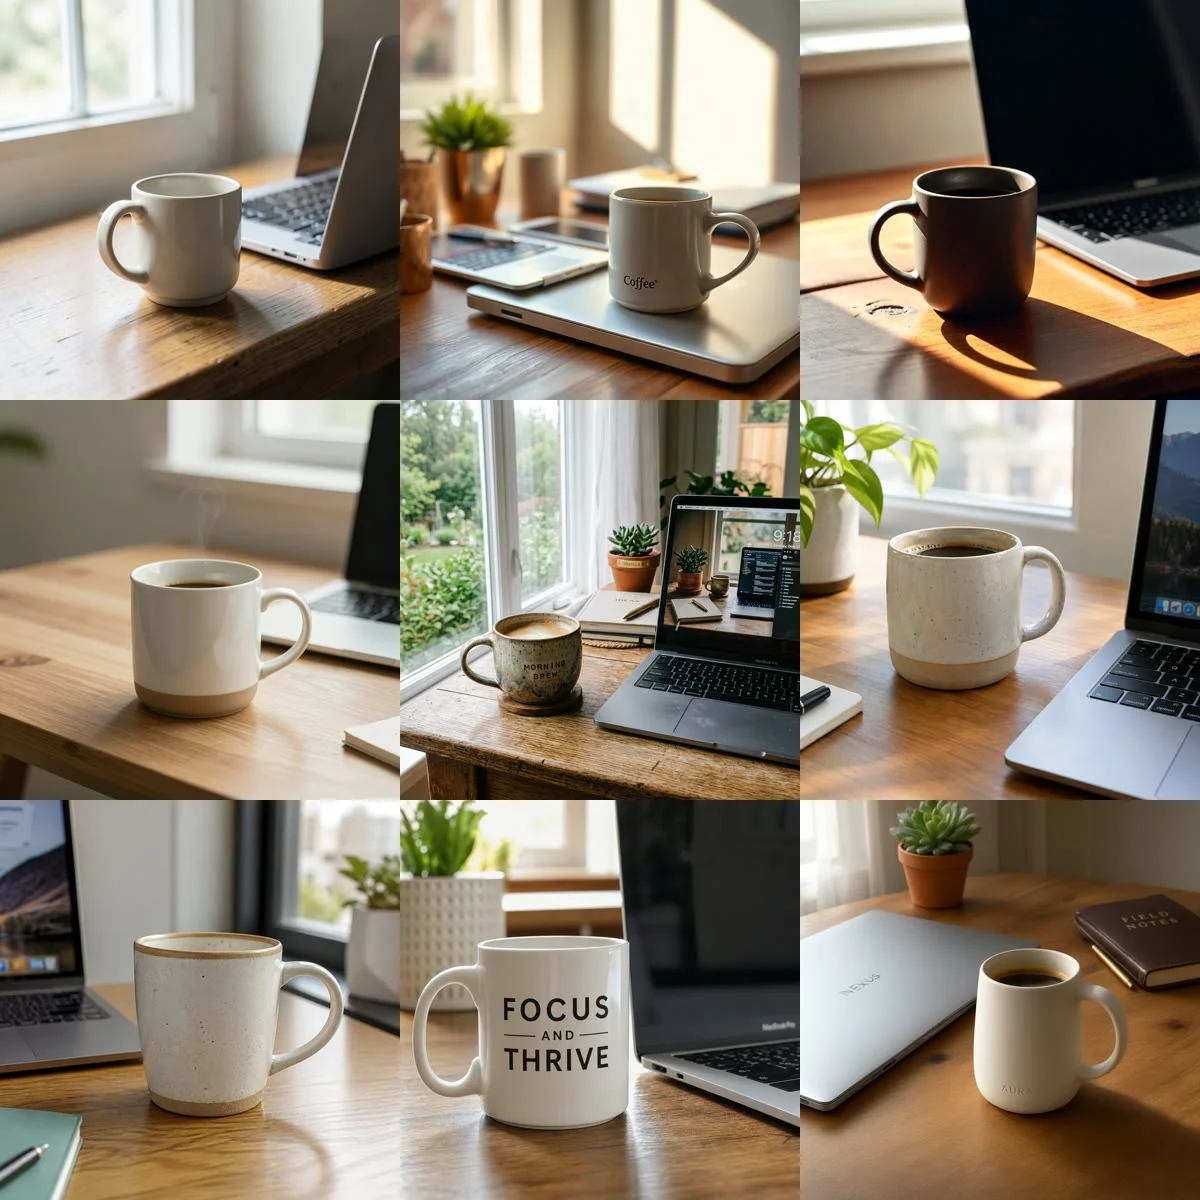
Os 9 modelos usaram o mesmo prompt; abaixo estão os resultados da primeira rodada:
A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo
Primeira linha: FLUX.2 Klein 4B, FLUX Schnell, Grok Imagine; segunda linha: Z-Image, Nano Banana 2, GPT Image 2.5 Flare; terceira linha: GPT Image 2 (qualidade low, rota ext), GPT Image 2, Qwen Image 3.0. Exceto Grok Imagine, que é 960×960, todas as demais são 1024×1024.
Os 9 modelos geraram imagens conforme o prompt. A faixa mais rápida produziu fotos de produto limpas e prontas para uso; os modelos mais lentos adicionaram mais detalhes de cenário (plantas, notebook, vista pela janela) e até imprimiram texto na caneca sem que fosse pedido ("Coffee", "MORNING BREW", "FOCUS AND THRIVE"). Se quiser uma caneca limpa, adicione ao prompt a frase "no text, no logo".
Como escolher para geração em grande volume
- Miniaturas, rascunhos, muitos testes A/B: FLUX.2 Klein 4B. Neste teste foi rápido e barato; 1 MP, 1.000 imagens custam apenas $1.43.
- Precisa de rapidez com imagem um pouco mais refinada: FLUX Schnell ($0.005) ou Z-Image ($0.008), ambos em menos de 30 segundos.
- Precisa de rapidez com preço intermediário: Grok Imagine ($0.03), cerca de 27 segundos.
- Imagens com texto, diagramação, material de marketing de produto: GPT Image 2 ou GPT Image 2.5, planeje 1 minuto ou mais por imagem. Use entrega assíncrona via callback, não deixe o usuário esperando.
Como obter resultados mais rápido com qualquer modelo
- Não fique esperando na requisição. Use
POST /v1/taskspara enviar e retornar ao usuário primeiro; obtenha o resultado pelo callback ("callback": {"url": "https://seu-dominio/hiapi/callback"}). - Envie em paralelo. Cada tarefa é independente; envie 50 imagens juntas e o tempo total será aproximadamente o de uma rodada, não de 50.
- Defina timeout e fallback. O GPT Image 2 teve uma cauda longa de 6 minutos; se ultrapassar alguns minutos, reenvie ou troque para um modelo mais rápido.
- Use 1K para rascunhos. Quanto maior a resolução, mais caro e geralmente mais lento.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "flux-2-klein-4b/text-to-image",
    "input": {
      "prompt": "A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo",
      "aspect_ratio": "1:1",
      "resolution": "1 MP"
    },
    "callback": {"url": "https://seu-dominio/hiapi/callback"}
  }'
Todos os modelos acima usam a mesma interface, basta trocar model e os parâmetros em input. Atenção a pequenas diferenças nos parâmetros: o resolution do Klein usa o formato "1 MP", o Grok Imagine usa "1k" em minúsculas, e Z-Image e FLUX Schnell aceitam apenas aspect_ratio.
Perguntas frequentes
Qual é a API de geração de imagens mais rápida?
No nosso teste no HiAPI foi o FLUX.2 Klein 4B: 1 MP, tempo mediano de 16,6 segundos da requisição à imagem gerada, com as 3 execuções entre 16 e 18 segundos.
A mais rápida também é a mais barata?
Neste caso, sim. O FLUX.2 Klein 4B custa $0.00143 por imagem em 1 MP, o preço mais baixo do teste.
Por que o GPT Image 2 é tão mais lento?
Não temos visibilidade interna do modelo, só podemos observar o tempo: sua mediana é de 75 segundos, com uma execução acima de 6 minutos. Se for usá-lo, projete para entrega assíncrona.
O tempo inclui rede e fila?
Inclui. Foi medido do nosso cliente: requisição, fila, geração e até cerca de 2 segundos de latência da consulta periódica.
Os preços de cada modelo estão na página de preços; para testar o mais rápido, abra a página do modelo FLUX.2 Klein 4B.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores