
Guida all'uso
Qual è l'API di generazione immagini più veloce? Tempi end-to-end di 9 modelli
Stesso prompt, 1K, 3 esecuzioni per modello: tempo mediano, esecuzione più lenta, prezzo per immagine e come scegliere per grandi volumi.
Abbiamo cronometrato 9 API di generazione immagini su HiAPI: stesso prompt, tutte in 1K, 3 esecuzioni ciascuna, misurando dal momento dell'invio della richiesta fino all'ottenimento dell'URL dell'immagine generata.FLUX.2 Klein 4B è il più veloce, con una mediana di circa 17 secondi, e ha anche il prezzo unitario più basso ($0.00143 per immagine); FLUX Schnell, Grok Imagine e Z-Image seguono a ruota, tutti tra i 26 e i 28 secondi. La serie GPT Image e Qwen Image 3.0 richiedono da 1 minuto a 1 minuto e mezzo, e GPT Image 2 ha registrato una coda lunga di oltre 6 minuti.
Risultati del test
| Modello | Tempo mediano | Più veloce / più lento | Prezzo per immagine 1K |
|---|---|---|---|
flux-2-klein-4b/text-to-image (1 MP) |
16,6 secondi | 16,4 / 17,7 secondi | $0.00143 |
flux-schnell/text-to-image |
25,6 secondi | 17,5 / 27,1 secondi | $0.005 |
grok-imagine/text-to-image |
27,4 secondi | 27,0 / 47,5 secondi | $0.03 |
z-image |
27,9 secondi | 26,4 / 40,9 secondi | $0.008 |
nano-banana-2 |
53,7 secondi | 42,7 / 63,9 secondi | $0.036 (prezzo promozionale $0.018) |
gpt-image-2.5-flare/text-to-image |
56,7 secondi | 52,4 / 70,0 secondi | $0.05 (prezzo promozionale $0.025) |
gpt-image-2/text-to-image@ext (qualità low) |
66,9 secondi | 42,4 / 337,9 secondi | $0.007 |
gpt-image-2/text-to-image |
74,8 secondi | 74,4 / 380,9 secondi | $0.03 |
qwen-image-3.0/text-to-image |
82,3 secondi | 70,7 / 94,7 secondi | $0.0358 |
Testato su HiAPI il 15 ottobre 2026: 1:1, 1K (1 MP per Klein), 3 esecuzioni, con 9 modelli inviati contemporaneamente in ogni esecuzione. Il tempo è misurato dall'invio della richiesta di creazione fino a quando il polling (ogni 2 secondi) rileva success, includendo il tempo in coda. Il prezzo promozionale è il 50% di sconto per la Festa dei Programmer, valido fino alle 0:00 del 9 novembre 2026 (ora di Pechino).
Come leggere questa tabella:
- È il tempo end-to-end che la tua applicazione deve effettivamente attendere, non il tempo di calcolo della GPU. Una singola esecuzione può rallentare per la coda, ecco perché la mediana di GPT Image 2 è di 75 secondi ma un'esecuzione ha superato i 6 minuti.
- 3 esecuzioni in un giorno, campione ridotto. Adatto a classificare per fasce (entro 30 secondi, circa 1 minuto, oltre 1 minuto), non a confrontare quanti secondi è più veloce un modello rispetto al vicino.
Qualità delle immagini
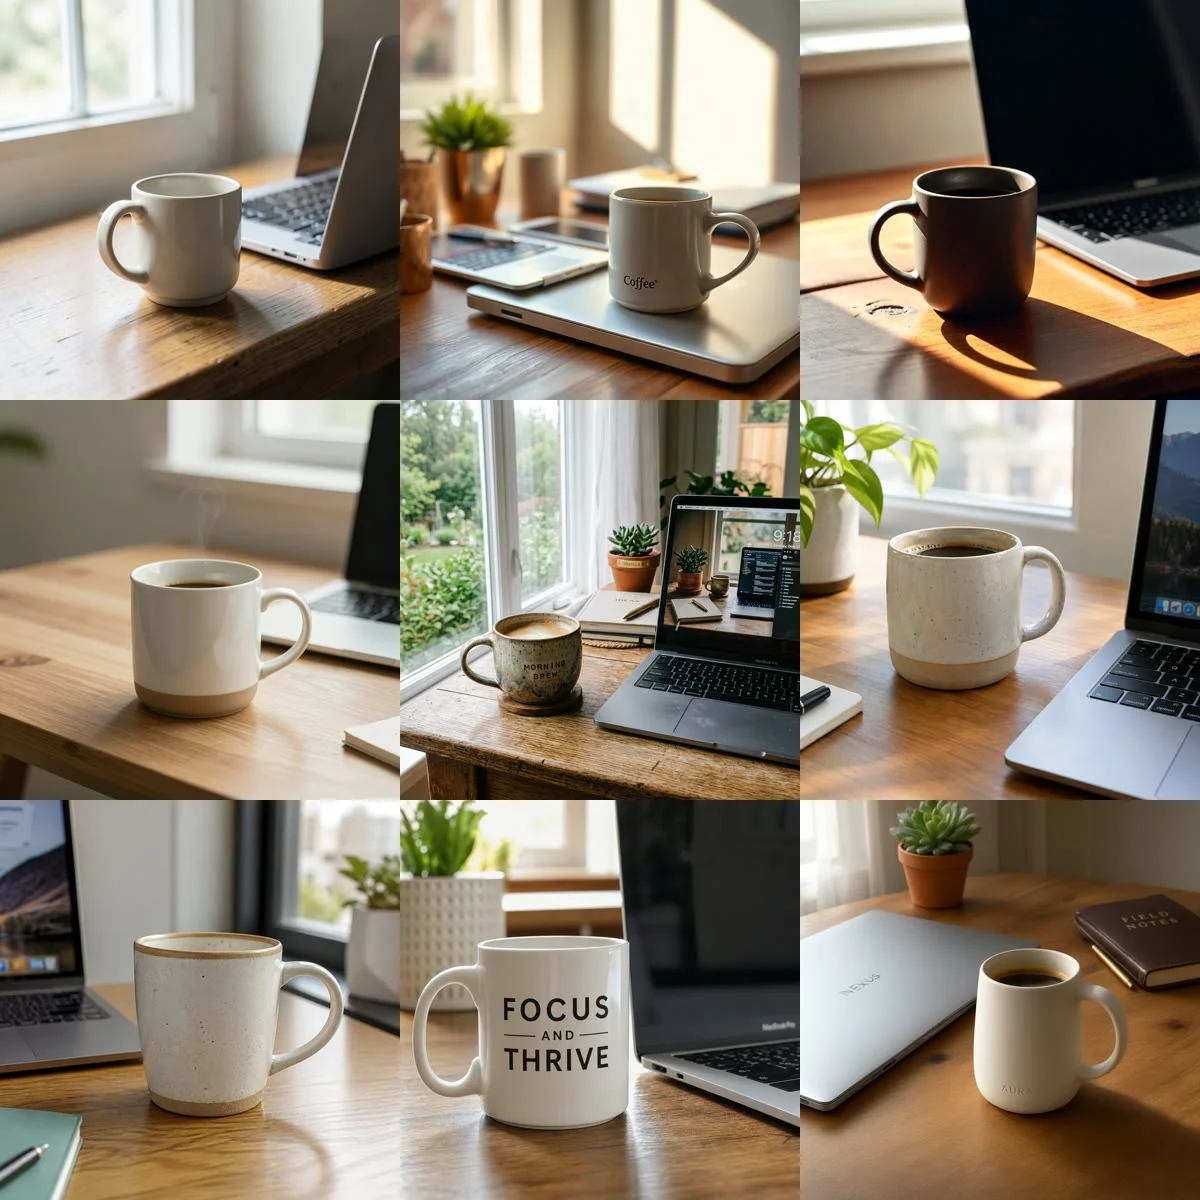
I 9 modelli hanno usato lo stesso prompt; di seguito i risultati della prima esecuzione:
A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo
Prima riga: FLUX.2 Klein 4B, FLUX Schnell, Grok Imagine; seconda riga: Z-Image, Nano Banana 2, GPT Image 2.5 Flare; terza riga: GPT Image 2 (qualità low, linea ext), GPT Image 2, Qwen Image 3.0. Tranne Grok Imagine a 960×960, tutte le altre sono 1024×1024.
Tutti i 9 modelli hanno generato immagini seguendo il prompt. La fascia veloce produce foto di prodotto pulite e utilizzabili direttamente; i modelli più lenti aggiungono più dettagli di scenario (piante, laptop, il paesaggio fuori dalla finestra) e scrivono parole sulla tazza senza che venga richiesto ("Coffee", "MORNING BREW", "FOCUS AND THRIVE"). Per avere una tazza pulita, aggiungi al prompt la frase "no text, no logo".
Come scegliere per grandi volumi
- Miniature, bozze, molte versioni A/B: FLUX.2 Klein 4B. Nel test è stato il più veloce ed economico; 1 MP per 1.000 immagini costa solo $1.43.
- Velocità con un'immagine un po' più curata: FLUX Schnell ($0.005) o Z-Image ($0.008), entrambi entro 30 secondi.
- Velocità a prezzo medio: Grok Imagine ($0.03), circa 27 secondi.
- Immagini con testo, impaginazione, grafiche di marketing prodotto: GPT Image 2 o GPT Image 2.5, pianificando oltre 1 minuto per immagine. Usa la consegna asincrona tramite callback, non far aspettare l'utente.
Come ottenere risultati più rapidamente con qualsiasi modello
- Non attendere in modo bloccante nella richiesta. Invia con
POST /v1/taskse restituisci subito il controllo all'utente, recuperando il risultato dal callback ("callback": {"url": "https://tuo-dominio/hiapi/callback"}). - Invia in parallelo. Ogni task è indipendente; inviando 50 immagini insieme, il tempo totale è più o meno quello di una singola esecuzione, non di 50.
- Imposta timeout e fallback. GPT Image 2 ha mostrato una coda lunga di 6 minuti; oltre qualche minuto, reinvia o passa a un modello più veloce.
- Usa 1K per le bozze. Più alta è la risoluzione, più costa e di solito più è lenta.
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "flux-2-klein-4b/text-to-image",
    "input": {
      "prompt": "A ceramic coffee mug on a wooden desk next to a laptop, soft morning window light, photorealistic product photo",
      "aspect_ratio": "1:1",
      "resolution": "1 MP"
    },
    "callback": {"url": "https://tuo-dominio/hiapi/callback"}
  }'
Tutti i modelli sopra usano la stessa interfaccia; cambia solo model e i parametri in input. Attenzione ad alcune piccole differenze nei parametri: resolution di Klein si scrive nel formato "1 MP", Grok Imagine usa "1k" minuscolo, mentre Z-Image e FLUX Schnell accettano solo aspect_ratio.
Domande frequenti
Qual è l'API di generazione immagini più veloce?
Nel nostro test su HiAPI è FLUX.2 Klein 4B: 1 MP, tempo mediano dalla richiesta all'immagine di 16,6 secondi, con tutte e 3 le esecuzioni tra 16 e 18 secondi.
Il più veloce è anche il più economico?
In questo caso sì. FLUX.2 Klein 4B costa $0.00143 per immagine a 1 MP, il prezzo più basso del test.
Perché GPT Image 2 è così lento?
Non vediamo l'interno del modello, possiamo solo osservare i tempi: la sua mediana è di 75 secondi, con un'esecuzione oltre i 6 minuti. Se lo usi, progetta la consegna in modo asincrono.
I tempi includono rete e coda?
Sì. Sono misurati dal nostro client: richiesta, coda, generazione e fino a circa 2 secondi di latenza del polling.
I prezzi dei vari modelli sono nella pagina dei prezzi; per provare il più veloce, apri la pagina del modello FLUX.2 Klein 4B.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori