
Guide d'utilisation
API Ideogram : génération d'images Ideogram V4 centrée sur la typographie
Quand le choisir, ce que le schéma vous permet réellement de contrôler, et deux rendus réels avec leurs prompts complets
La plupart des modèles d'image traitent le texte comme une texture, qu'ils ne rendent que par chance. Ideogram V4, lui, traite le texte comme le sujet principal. Si votre besoin implique des titres, des lockups de logo, des affiches ou des étiquettes produit — tout cas où le texte doit être réellement lisible —, envisagez-le avant de vous rabattre sur un modèle généraliste en espérant un coup de chance.
Cette page est le point central pour utiliser ideogram-v4 sur hiapi : quand il mérite une place dans votre stack, ce que l'API vous permet ou non de contrôler, les prompts exacts de deux rendus réels, et où aller ensuite pour une démonstration complète en code.
Quand la typographie doit décider du choix du modèle
Les modèles d'image généralistes sont entraînés à être bons partout, ce qui signifie que le rendu de texte n'est qu'une compétence parmi des centaines — solides sur les mots courts, ils deviennent instables dès qu'il faut une accroche complète ou un logo composé de deux lignes à des tailles différentes. Les modèles Ideogram ont la typographie comme objectif d'entraînement central, si bien que le mode d'échec diffère : plutôt que des glyphes déformés, on observe plus souvent un texte correct mais légèrement décalé par rapport à la position demandée.
Choisissez ideogram-v4 lorsque le livrable est d'abord jugé sur sa lisibilité — affiches, enseignes, maquettes de packaging, captures d'écran d'App Store avec de vrais textes d'interface, concepts de logo. Continuez avec un modèle généraliste lorsque le texte n'est qu'un élément accessoire de la scène (enseignes en arrière-plan, détails d'ambiance) et que le photoréalisme ou la complexité de la scène importe davantage que la formulation exacte.
Mise en pratique : deux rendus réels
Nous avons exécuté le même schéma de requête sur deux tâches différentes — une scène avec une enseigne à plusieurs lignes de texte, et un lockup de logo avec du texte incurvé — pour observer comment le modèle gère chacune.
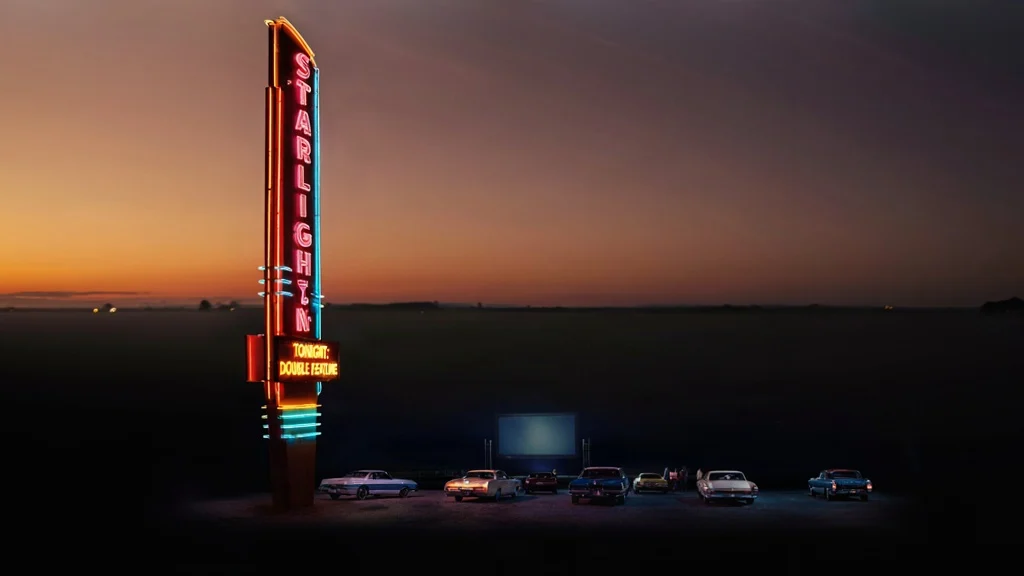
Enseigne rétro avec deux lignes de texte néon
Prompt (rendering_speed : QUALITY, aspect_ratio : 16:9) :
A retro 1970s American drive-in movie theater at dusk, tall neon marquee sign
reading "STARLIGHT DRIVE-IN" in glowing pink and cyan tube-light letters,
below it in smaller warm-yellow neon "TONIGHT: DOUBLE FEATURE", rows of
classic cars parked facing a giant outdoor screen in the distance, warm dusk
sky gradient from orange to deep purple, wide cinematic photograph, sharp
focus on the marquee lettering.
Les deux lignes de texte étaient lisibles et correctement orthographiées dès le premier rendu — sans nouvelle tentative. Le principal levier que nous avons actionné a été de placer le texte exact entre guillemets et de décrire le style des lettres à proximité immédiate ("glowing pink and cyan tube-light letters"), plutôt que de décrire vaguement l'enseigne en espérant que le modèle invente un texte plausible.
Logo circulaire avec texte incurvé
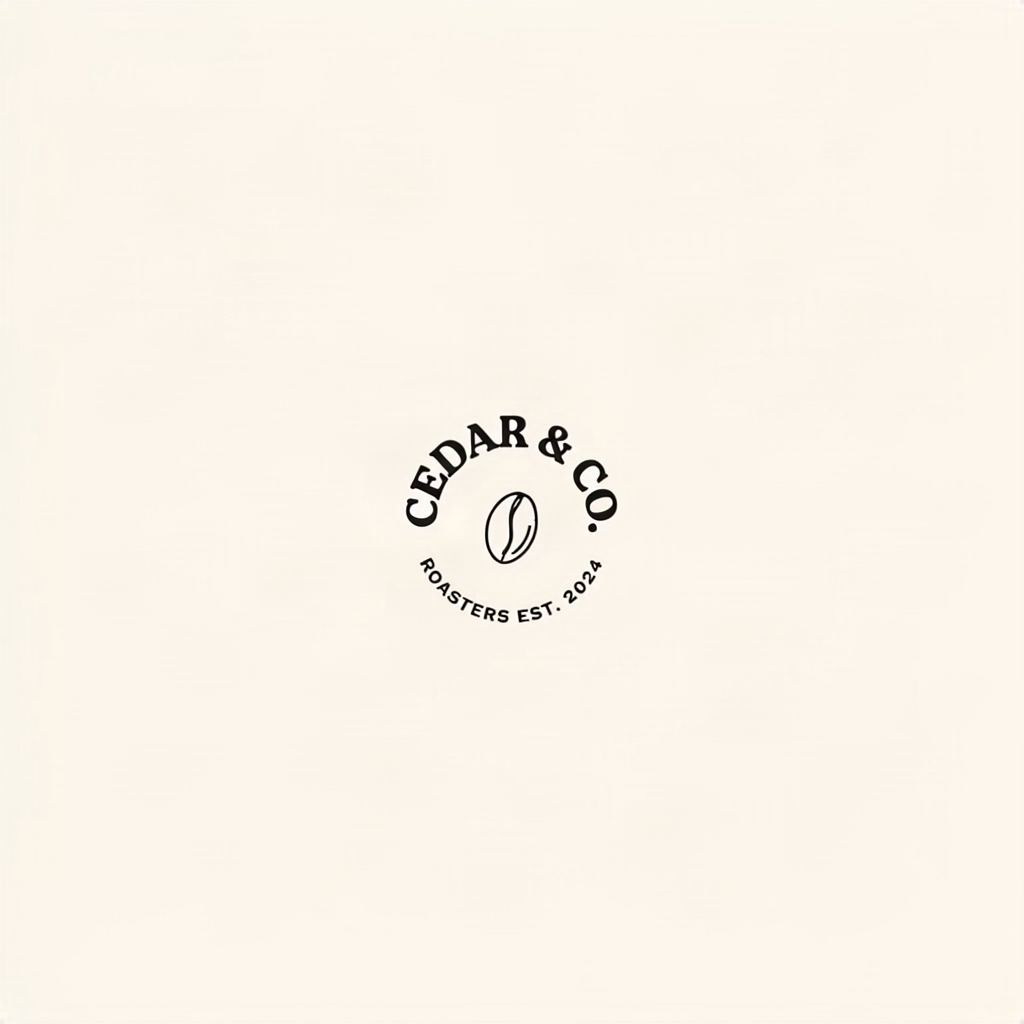
Prompt (rendering_speed : BALANCED, aspect_ratio : 1:1) :
A minimalist coffee brand logo lockup on a flat cream background: a circular
badge emblem with the words "CEDAR & CO." in bold serif letters arcing
around the top of the circle, and "ROASTERS EST. 2024" in small sans-serif
letters arcing along the bottom, a simple line-art coffee bean icon centered
inside the circle, flat vector illustration style, single dark-brown ink
color, crisp clean linework.
C'est le cas plus difficile : deux éléments de texte incurvé indépendants à des tailles différentes disposés le long d'un anneau, plus une icône qui doit rester centrée sans entrer en collision avec le texte. BALANCED a géré correctement la courbure et l'espacement du premier coup — ce placement du texte sensible à la mise en page est précisément le point de défaillance habituel des modèles qui traitent le texte comme une décoration plutôt que comme une structure.
Ce que vous pouvez (et ne pouvez pas) contrôler
Le schéma d'entrée d'ideogram-v4 est volontairement étroit — seulement quatre champs, rien d'autre :
prompt(obligatoire) — votre description complète, avec le texte littéral à rendre entre guillemets.rendering_speed(obligatoire) —TURBO,BALANCEDouQUALITY. C'est le principal levier qualité/coût/latence.aspect_ratio(facultatif) —1:1,16:9,4:3,9:16ou3:4.seed(facultatif) — entier, pour reproduire un résultat.
Pas de negative_prompt, pas de style_type, pas de num_images, et aucune entrée d'édition d'image — le modèle ne fait que du texte-vers-image. Si vous avez l'habitude de guider la génération avec des prompts négatifs ou des préréglages de style, ce contrôle doit passer dans le prompt principal : décrivez positivement ce que vous voulez ("flat vector illustration, single ink color") plutôt que ce qu'il faut éviter.
Le flux de travail qui a fonctionné pour nous : itérer la formulation et la composition avec TURBO, car c'est le moyen le moins cher et le plus rapide de vérifier si le texte est bien placé ; puis relancer le prompt gagnant sur QUALITY avec le même seed pour produire l'asset final.
Aperçu des tarifs
ideogram-v4 est facturé par palier de rendu — TURBO est le moins cher, QUALITY le plus cher des trois, ce qui correspond globalement à l'écart de latence entre eux. Les tarifs exacts actuels, ainsi que ceux des autres modèles, figurent sur la page de tarification ; vérifiez-y avant de budgéter des tâches par lots, car les tarifs peuvent évoluer.
Questions fréquentes
ideogram-v4 prend-il en charge l'édition d'image ou l'image-vers-image ? Non — le modèle ne fait que du texte-vers-image. Son schéma ne comporte aucun champ d'image d'entrée ; ce modèle précis ne réalise donc ni édition ni restylage d'images existantes.
Puis-je désactiver le rendu de texte et obtenir une scène ordinaire ? Oui, il suffit de ne mettre aucun texte entre guillemets dans le prompt. Le modèle ne force pas le texte dans la composition — il rend ce que vous décrivez.
Quel est le moyen le plus rapide d'itérer sur une création riche en texte ?
Faites quelques passes avec TURBO, peu coûteux, pour arrêter la formulation et la mise en page, puis, une fois satisfait, passez à QUALITY en fixant le seed pour que le rendu final corresponde à la composition approuvée.
Quels formats d'image sont pris en charge ?
1:1, 16:9, 4:3, 9:16 et 3:4. Pas de format libre — choisissez le format pris en charge le plus proche de votre emplacement de diffusion.
Existe-t-il un moyen de corriger un mot mal rendu sur un rendu ? Aucun paramètre d'édition locale — comme le modèle ne fait que du texte-vers-image, il faut relancer le prompt (éventuellement avec un nouveau seed, ou en réécrivant la phrase problématique). Un exemple complet de requête API (avec gestion d'erreurs) est disponible dans le tutoriel API pas à pas.
À retenir
- Choisissez ideogram-v4 lorsque le texte clairement lisible et correctement orthographié est le livrable et non un détail d'arrière-plan — affiches, logos, enseignes, étiquettes.
- Mettez le texte exact entre guillemets dans le prompt et décrivez le style de ses lettres à proximité immédiate ; en l'absence de paramètre dédié au texte, c'est le principal levier pour une typographie précise.
- Pas de prompt négatif ni de préréglage de style — guidez le modèle uniquement par des descriptions positives et précises dans le
prompt. - Itérez à faible coût sur
TURBO, puis finalisez surQUALITYavec unseedfixe pour verrouiller la composition approuvée. - Le schéma est strict (seulement 4 champs) et uniquement texte-vers-image — pas d'édition, pas de
resolution, pas denum_images.
Prêt à essayer ? Rendez-vous sur la page du modèle ideogram-v4 pour tester vos prompts dans le playground, ou, si vous intégrez à un pipeline, passez directement à la démonstration curl et Python. Si vos prompts ont besoin de détails descriptifs plus riches avant d'être envoyés au modèle, l'expansion de prompt vaut aussi la peine d'être associée aux requêtes à forte densité typographique.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax