
Guia de uso
Ideogram API: geração de imagens Ideogram V4 com foco em tipografia
Quando escolhê-lo, o que o schema realmente permite controlar e duas renderizações reais com seus prompts completos
A maioria dos modelos de imagem trata o texto como uma textura, algo que só é renderizado com sorte. O Ideogram V4, por sua vez, trata o texto como o elemento principal. Se a sua necessidade envolve títulos, combinações de logo, pôsteres ou rótulos de produto — qualquer cenário em que o texto precise ser de fato legível —, considere-o antes de recorrer a uma alternativa e torcer para que um modelo genérico acerte.
Esta página é o ponto central para usar o ideogram-v4 na hiapi: quando ele vale a pena entrar no seu stack, o que a API permite e não permite controlar, os prompts exatos de duas renderizações reais e para onde ir em seguida para ver o passo a passo completo do código.
Quando deixar a tipografia decidir a escolha do modelo
Modelos de imagem genéricos são treinados para fazer de tudo, o que significa que a renderização de texto é apenas uma entre centenas de habilidades — eles se saem bem com palavras curtas, mas ficam instáveis quando precisam de um slogan completo ou de um logo composto por duas linhas com tamanhos de fonte diferentes. Os modelos da Ideogram têm a tipografia como objetivo central de treinamento, então o modo de falha é diferente: em vez de glifos corrompidos, é mais comum o texto estar correto, mas com posição um pouco diferente da solicitada.
Escolha o ideogram-v4 quando o entregável for avaliado primeiramente pela legibilidade — pôsteres, logotipos, mockups de embalagem, capturas de tela de loja de aplicativos com texto de UI real, conceitos de logo. Continue usando modelos genéricos quando o texto for apenas um elemento acessório da cena (letreiros de fundo, detalhes de ambientação) e o fotorrealismo ou a complexidade da cena importarem mais do que a redação exata.
Mão na massa: duas renderizações reais
Executamos o mesmo padrão de requisição para dois tipos diferentes de tarefa — uma cena com letreiro de várias linhas e uma combinação de logo com texto em arco — para observar como o modelo lidava com cada caso.
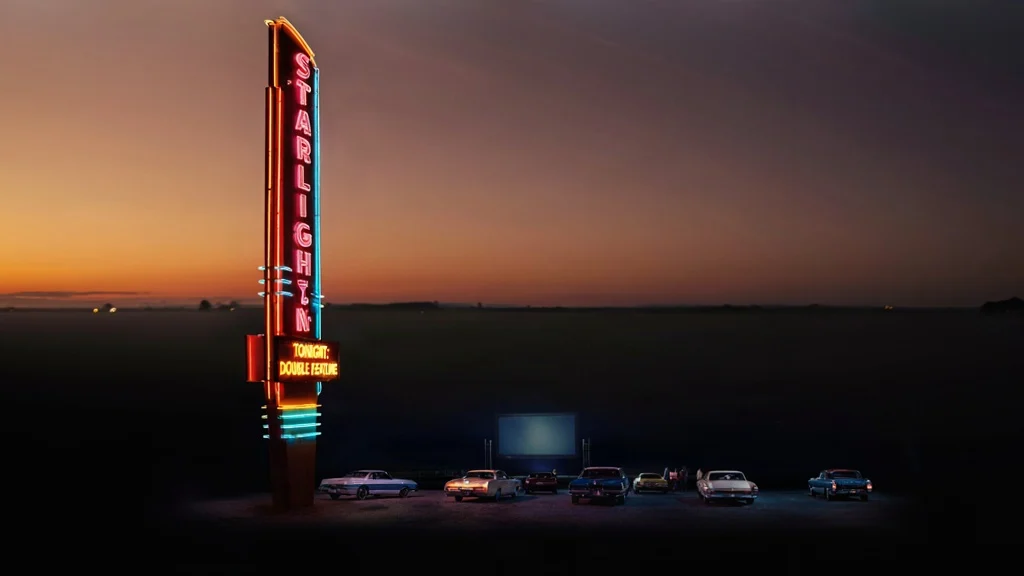
Letreiro retrô com duas linhas de neon
Prompt (rendering_speed: QUALITY, aspect_ratio: 16:9):
A retro 1970s American drive-in movie theater at dusk, tall neon marquee sign
reading "STARLIGHT DRIVE-IN" in glowing pink and cyan tube-light letters,
below it in smaller warm-yellow neon "TONIGHT: DOUBLE FEATURE", rows of
classic cars parked facing a giant outdoor screen in the distance, warm dusk
sky gradient from orange to deep purple, wide cinematic photograph, sharp
focus on the marquee lettering.
As duas linhas de texto saíram nítidas, legíveis e com a grafia correta já na primeira renderização — sem necessidade de nova tentativa. A principal alavanca que usamos foi colocar o texto exato entre aspas duplas e descrever o estilo das letras logo ao lado ("glowing pink and cyan tube-light letters"), em vez de descrever o letreiro de forma genérica e esperar que o modelo inventasse um texto plausível.
Logo circular com texto em arco
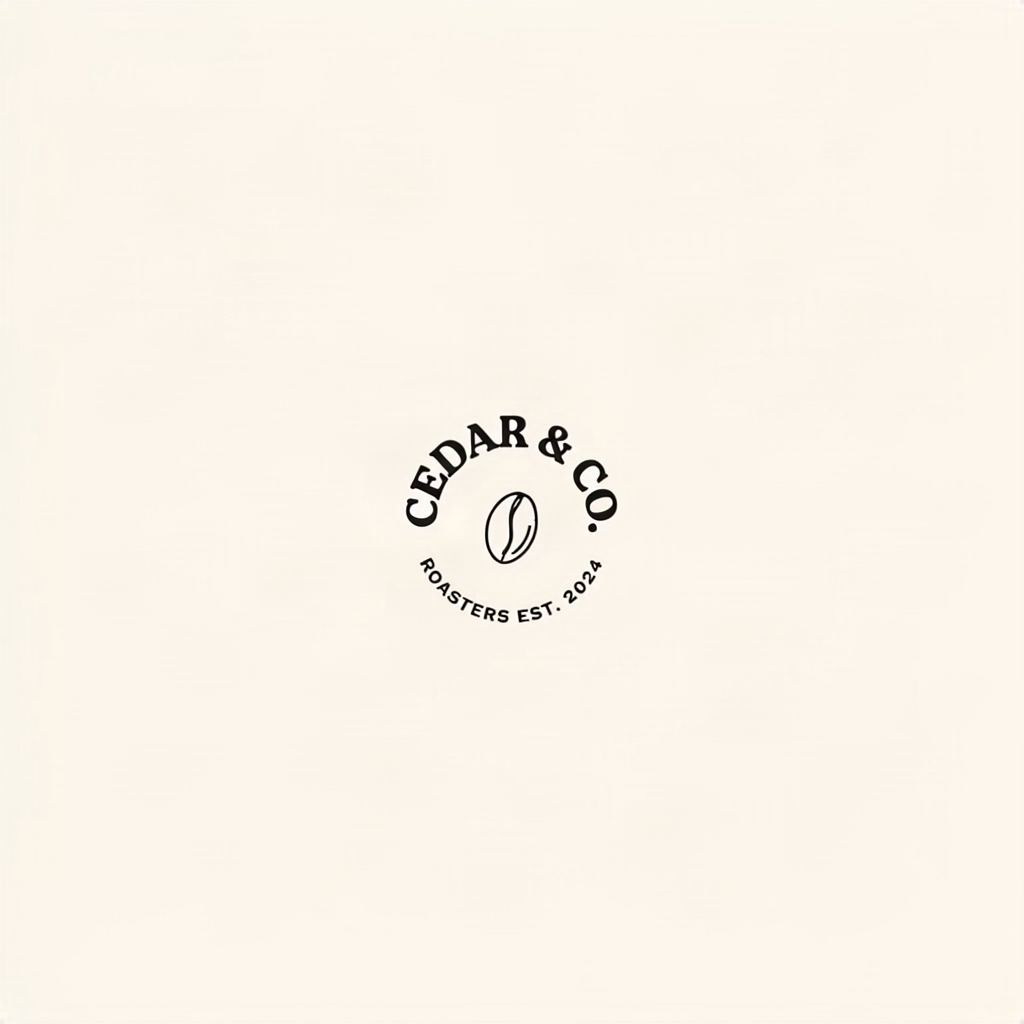
Prompt (rendering_speed: BALANCED, aspect_ratio: 1:1):
A minimalist coffee brand logo lockup on a flat cream background: a circular
badge emblem with the words "CEDAR & CO." in bold serif letters arcing
around the top of the circle, and "ROASTERS EST. 2024" in small sans-serif
letters arcing along the bottom, a simple line-art coffee bean icon centered
inside the circle, flat vector illustration style, single dark-brown ink
color, crisp clean linework.
Este é o caso mais difícil: dois elementos de texto em arco independentes, com tamanhos de fonte diferentes, dispostos ao longo de um anel, além de um ícone que precisa ficar centralizado e não colidir com o texto. O BALANCED acertou o arco e o espaçamento já na primeira tentativa — esse posicionamento de texto consciente do layout é justamente o ponto de falha comum em modelos que tratam o texto como decoração e não como estrutura.
O que você pode (e não pode) controlar
O schema de entrada do ideogram-v4 é intencionalmente enxuto — apenas quatro campos, nada mais:
prompt(obrigatório) — sua descrição completa, com o texto literal a ser renderizado entre aspas.rendering_speed(obrigatório) —TURBO,BALANCEDouQUALITY. É o principal botão de qualidade/custo/latência.aspect_ratio(opcional) —1:1,16:9,4:3,9:16ou3:4.seed(opcional) — inteiro, para reproduzir resultados.
Não há negative_prompt, não há style_type, não há num_images, e não há entrada para edição de imagem — o modelo suporta apenas texto para imagem. Se você está acostumado a guiar a geração com prompts negativos ou presets de estilo, esse controle precisa ser movido para o prompt principal: descreva positivamente o que você quer ("flat vector illustration, single ink color") em vez de descrever o que evitar.
O fluxo de trabalho prático que funcionou para nós: iterar a redação e a composição com TURBO, porque é a forma mais barata e rápida de ver se o texto está bem posicionado; depois, rodar novamente o prompt vencedor em QUALITY com o mesmo seed para produzir o material final.
Visão geral de preços
O ideogram-v4 é cobrado por faixa de renderização — TURBO é o mais barato, QUALITY é o mais caro dos três, o que corresponde aproximadamente à diferença de latência entre eles. As tarifas exatas atuais e os preços de outros modelos estão na página de preços; confirme por lá antes de orçar tarefas em lote, pois as tarifas podem mudar.
Perguntas frequentes
O ideogram-v4 suporta edição de imagem ou imagem para imagem? Não — o modelo suporta apenas texto para imagem. Não há campo de imagem de entrada no schema, portanto esse modelo específico não faz edição de imagens existentes nem repintura de estilo.
Posso desativar a renderização de texto e obter apenas uma cena comum? Sim, basta não colocar nenhum texto entre aspas no prompt. O modelo não força a inclusão de texto na composição — ele renderiza o que você descreve.
Qual é a forma mais rápida de iterar em designs com muito texto?
Faça algumas rodadas com o TURBO, que é barato, para definir a redação e o layout; quando estiver satisfeito, mude para QUALITY e fixe o seed, para que a renderização final corresponda à composição que você já aprovou.
Quais proporções de tela são suportadas?
1:1, 16:9, 4:3, 9:16 e 3:4. Não há proporção livre — escolha a proporção suportada mais próxima do seu ponto de veiculação.
Há alguma forma de corrigir uma palavra renderizada errada? Não há parâmetro de edição local — como o modelo suporta apenas texto para imagem, é preciso rodar o prompt novamente (opcionalmente com um novo seed, ou reescrevendo a frase problemática). Exemplos completos de requisição à API (com tratamento de erros) estão no tutorial passo a passo da API.
Resumo dos pontos principais
- Escolha o ideogram-v4 quando o texto nítido, legível e com grafia correta for o entregável, e não um detalhe de fundo — pôsteres, logos, letreiros, rótulos.
- Coloque o texto exato entre aspas no prompt e descreva o estilo das letras logo ao lado; como não há parâmetro específico de texto, essa é a principal alavanca para obter tipografia precisa.
- Não há prompts negativos nem presets de estilo — guie o modelo inteiramente por meio de descrições positivas e específicas no
prompt. - Itere com baixo custo no
TURBOe finalize noQUALITYcom umseedfixo, travando a composição que você já aprovou. - O schema é estrito (apenas 4 campos) e suporta apenas texto para imagem — sem edição, sem
resolution, semnum_images.
Pronto para experimentar? Acesse a página do modelo ideogram-v4 para testar prompts no playground ou, se você vai integrar a um pipeline, vá direto para o passo a passo com curl e Python. Se os seus prompts precisarem de detalhes descritivos mais ricos antes de serem enviados ao modelo, a expansão de prompt também vale ser combinada com requisições de tipografia intensiva.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores