
Guía de uso
Ideogram API: generación de imágenes Ideogram V4 centrada en la tipografía
Cuándo elegirlo, qué te permite controlar realmente el schema y dos renderizaciones reales con sus prompts completos
La mayoría de los modelos de imagen tratan el texto como una textura y solo lo renderizan bien si tienen suerte. Ideogram V4 trata el texto como el sujeto principal. Si tu necesidad implica titulares, combinaciones de logo, carteles o etiquetas de producto —cualquier escenario en el que el texto deba ser realmente legible— considéralo antes de recurrir a una alternativa y confiar en la suerte de un modelo generalista.
Esta página es el punto de entrada para usar ideogram-v4 en hiapi: cuándo merece la pena incorporarlo a tu stack, qué te permite y qué no te permite controlar la API, los prompts exactos de dos renderizaciones reales y dónde consultar a continuación el recorrido completo con código.
Cuándo debe la tipografía decidir la elección del modelo
Los modelos de imagen generalistas se entrenan para hacerlo todo bien, lo que significa que el renderizado de texto es solo una de cientos de habilidades: rinden bien con palabras cortas, pero empiezan a fallar en cuanto necesitan un eslogan completo o un logo de dos líneas con tamaños de fuente distintos. Los modelos de Ideogram tienen la tipografía como objetivo central de entrenamiento, así que el modo de fallo es distinto: en lugar de glifos deformados, lo más habitual es que el texto sea correcto pero esté colocado con una ligera desviación respecto a lo que pediste.
Elige ideogram-v4 cuando el entregable se juzgue ante todo por su legibilidad —carteles, logotipos, mockups de packaging, capturas de tiendas de aplicaciones con texto real de UI, conceptos de logo—. Sigue usando un modelo generalista cuando el texto sea solo un elemento accesorio de la escena (rótulos de fondo, detalles ambientales) y el fotorrealismo o la complejidad de la escena importen más que la redacción exacta.
Práctica: dos renderizaciones reales
Ejecutamos el mismo patrón de petición para dos tareas distintas —una escena con rótulos de varios niveles de texto y una combinación de logo con texto en arco— para observar cómo gestionaba el modelo cada caso.
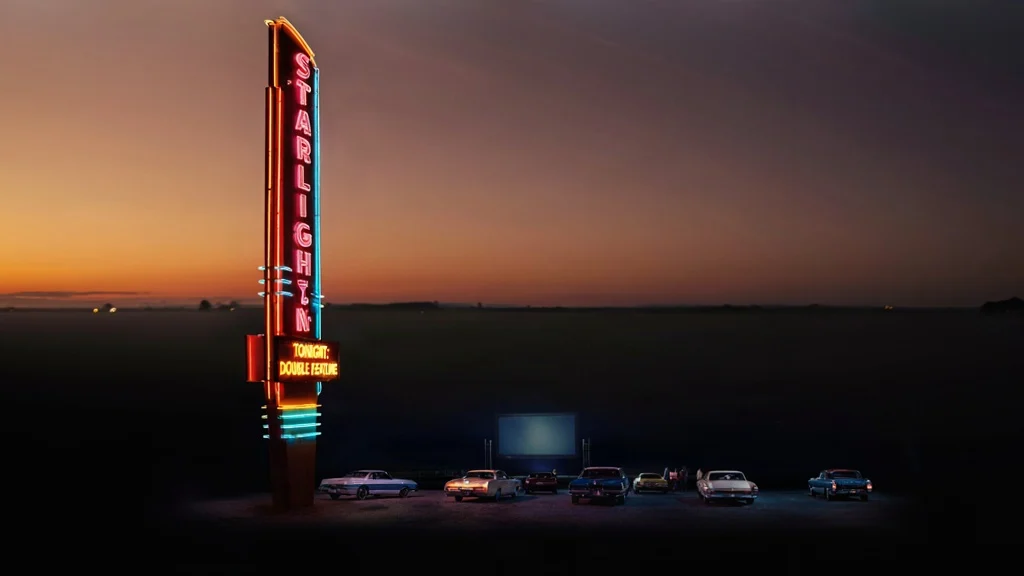
Rótulo vintage con dos líneas de texto de neón
Prompt (rendering_speed: QUALITY, aspect_ratio: 16:9):
Un autocine estadounidense retro de los años 70 al atardecer, un alto rótulo
marquesina de neón que dice "STARLIGHT DRIVE-IN" en letras de tubo de neón
rosa y cian, debajo, en neón amarillo cálido más pequeño, "TONIGHT: DOUBLE
FEATURE", filas de coches clásicos aparcados frente a una enorme pantalla de
exterior a lo lejos, gradiente de cielo cálido al atardecer de naranja a morado
profundo, fotografía cinematográfica amplia, enfoque nítido en las letras de la
marquesina.
Las dos líneas de texto salieron legibles y bien escritas en el primer renderizado —sin necesidad de reintentar—. La principal palanca que aplicamos fue poner el texto exacto entre comillas dobles y describir justo al lado el estilo de las letras ("letras de tubo de neón rosa y cian"), en lugar de describir el rótulo de forma genérica y confiar en que el modelo inventara un texto verosímil por su cuenta.
Logo circular con texto en arco
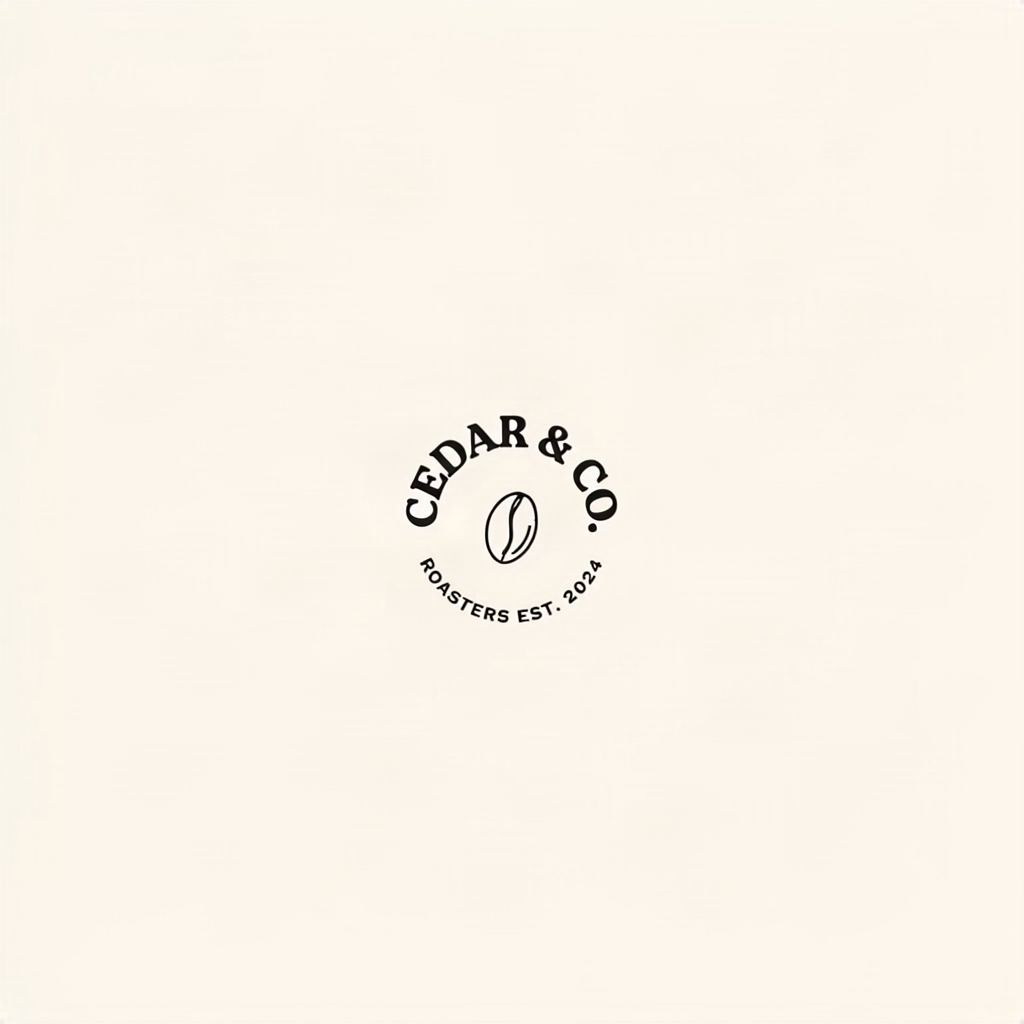
Prompt (rendering_speed: BALANCED, aspect_ratio: 1:1):
Una combinación de logotipo minimalista de marca de café sobre un fondo liso
color crema: un emblema circular tipo insignia con las palabras "CEDAR &
CO." en letras serif en negrita formando un arco por la parte superior del
círculo, y "ROASTERS EST. 2024" en letras sans-serif pequeñas formando un arco
por la parte inferior, un sencillo icono de grano de café de arte lineal
centrado dentro del círculo, estilo de ilustración vectorial plana, un único
color de tinta marrón oscuro, trazos limpios y nítidos.
Este es el caso más difícil: dos elementos de texto en arco independientes con tamaños de fuente distintos dispuestos a lo largo del anillo, más un icono que debe quedar centrado y no chocar con el texto. BALANCED acertó con la curvatura y el espaciado a la primera —esta colocación del texto consciente del diseño es precisamente el punto de fallo habitual de los modelos que tratan el texto como decoración en lugar de como estructura—.
Qué puedes (y qué no puedes) controlar
El schema de entrada de ideogram-v4 es deliberadamente estrecho: solo cuatro campos y nada más:
prompt(obligatorio) — tu descripción completa; pon entre comillas el texto literal que quieres renderizar.rendering_speed(obligatorio) —TURBO,BALANCEDoQUALITY. Es el principal control de calidad/coste/latencia.aspect_ratio(opcional) —1:1,16:9,4:3,9:16o3:4.seed(opcional) — entero, para reproducir resultados.
No hay negative_prompt, ni style_type, ni num_images, ni entrada de edición de imágenes: el modelo solo admite texto a imagen. Si sueles guiar la generación con prompts negativos o presets de estilo, ese control debe trasladarse al prompt principal: describe positivamente lo que quieres ("ilustración vectorial plana, un solo color de tinta") en lugar de describir lo que quieres evitar.
El flujo de trabajo que nos funcionó en la práctica: iterar la redacción y la composición con TURBO, porque es la forma más barata y rápida de ver si el texto está bien colocado; después, volver a ejecutar el prompt ganador en QUALITY con el mismo seed para producir el material final.
Precios de un vistazo
ideogram-v4 se factura por nivel de renderizado —TURBO es el más barato y QUALITY el más caro de los tres, en consonancia con la diferencia de latencia entre ellos—. Consulta las tarifas exactas actuales y los precios de otros modelos en la página de precios; confírmalo allí antes de presupuestar tareas por lotes, ya que las tarifas pueden cambiar.
Preguntas frecuentes
¿ideogram-v4 admite edición de imágenes o imagen a imagen? No — el modelo solo admite texto a imagen. Su schema no incluye ningún campo de imagen de entrada, así que este modelo concreto no edita ni reestiliza imágenes existentes.
¿Puedo desactivar el renderizado de texto y obtener solo una escena normal? Sí, basta con no incluir ningún texto entre comillas en el prompt. El modelo no fuerza la inclusión de texto en la composición — renderiza lo que describes.
¿Cuál es la forma más rápida de iterar en diseños con mucho texto?
Haz varias rondas con el económico TURBO para fijar la redacción y el diseño; cuando estés satisfecho, cambia a QUALITY y fija el seed para que el renderizado final coincida con la composición que ya aprobaste.
¿Qué relaciones de aspecto se admiten?
1:1, 16:9, 4:3, 9:16 y 3:4. No hay relación de aspecto libre: elige la proporción admitida más cercana a tu ubicación de destino.
¿Hay alguna forma de corregir una palabra mal renderizada? No hay parámetros de edición local — como el modelo solo admite texto a imagen, hay que volver a ejecutar el prompt (opcionalmente con un nuevo seed, o reescribiendo la frase problemática). Encuentra ejemplos completos de peticiones a la API (con manejo de errores) en el tutorial paso a paso de la API.
Resumen de puntos clave
- Elige ideogram-v4 cuando el texto claro, legible y bien escrito sea el entregable y no un detalle de fondo —carteles, logos, rótulos, etiquetas—.
- Pon el texto exacto entre comillas en el prompt y describe su estilo de letras justo al lado; como no hay parámetros específicos de texto, esta es la principal palanca para lograr una tipografía precisa.
- No hay prompts negativos ni presets de estilo — guía el modelo únicamente mediante descripciones positivas y concretas en el
prompt. - Itera a bajo coste con
TURBOy finaliza conQUALITYusando unseedfijo para bloquear la composición que ya aprobaste. - El schema es estricto (solo 4 campos) y solo admite texto a imagen — sin edición, sin
resolution, sinnum_images.
¿Listo para probarlo? Ve a la página del modelo ideogram-v4 para probar prompts en el playground o, si vas a integrarlo en un pipeline, salta directamente al recorrido con curl y Python. Si tus prompts necesitan detalles descriptivos más ricos antes de enviarlos al modelo, la expansión de prompts también merece combinarse con peticiones de alta densidad tipográfica.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores