
Comparatif et évaluation
seedream-5.0-lite/text-to-image comparatif : comment choisir un modèle texte-image, comment l'intégrer, comment migrer
Commençons par la conclusion : dans quels cas faut-il essayer seedream-5.0-lite en priorité
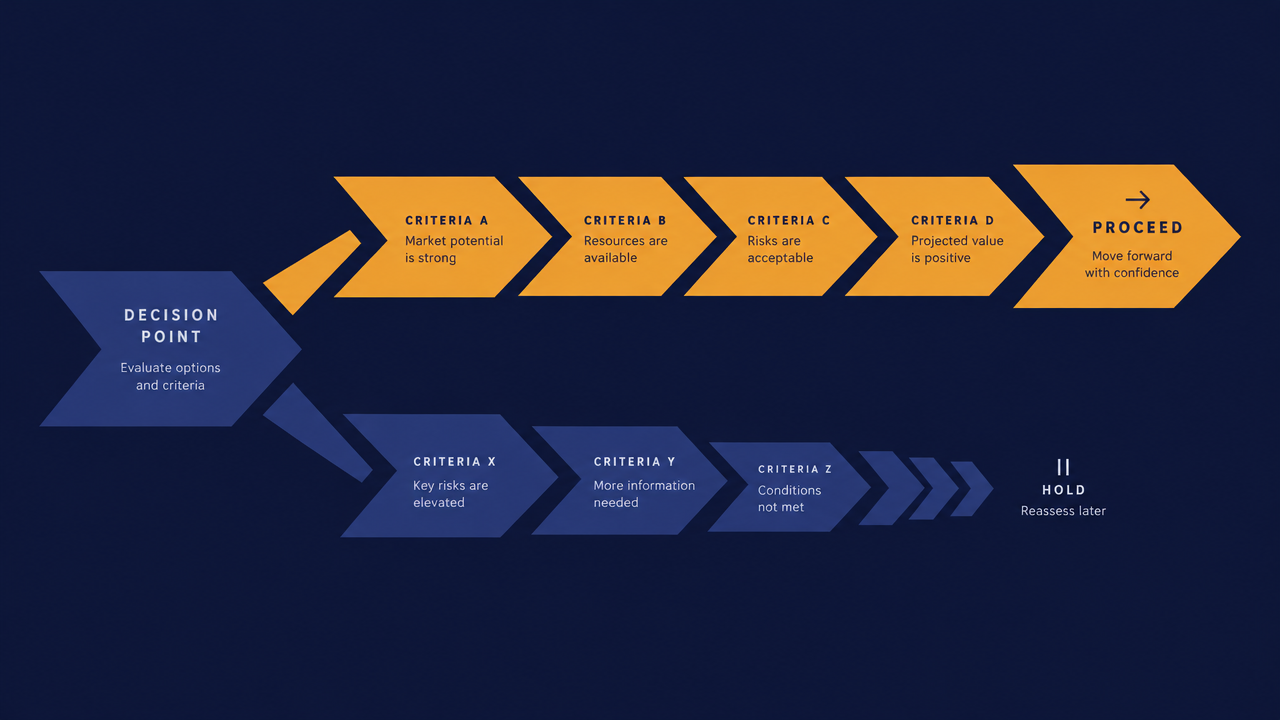
Si vous êtes développeur et cherchez un modèle candidat pour une chaîne de génération d'images, vous pouvez d'abord utiliser l'arbre de décision ci-dessous pour vous situer rapidement.
Cas où un essai prioritaire est pertinent :
- Génération d'images en grand volume et sensible aux coûts : production massive d'images produits, illustrations pour plateformes de contenu, premières ébauches de supports marketing. Dans ces cas, la valeur d'une requête est faible et le volume d'appels élevé, ce qui amplifie l'écart de coût par image ; le modèle seedream-5.0-lite/text-to-image, facturé à l'image, est un excellent candidat de premier choix.
- Cas où une qualité de génération « suffisante » est acceptable : brouillons, vignettes, visuels de remplacement pour pages de liste, aperçus internes.
- Projets précoces qui doivent valider rapidement la forme du produit : faire d'abord fonctionner la chaîne, peaufiner les prompts et la logique métier, puis passer à un modèle plus puissant selon les résultats.
- Équipes qui veulent éviter le verrouillage par un fournisseur unique : elles souhaitent un mode d'appel unifié et ne changer qu'un identifiant lors d'un futur changement de modèle.
Cas où il vaut mieux attendre ou choisir un autre modèle :
- Scénarios de niveau production avec des exigences strictes sur les détails, le rendu du texte et la composition complexe.
- Scénarios nécessitant une très forte concurrence en peu de temps et sensibles aux variations de latence — pour ces besoins, il faut examiner les performances réelles en matière de limitation de débit et de quotas, et non se fier au seul prix affiché.
- Équipes disposant déjà d'un pipeline de génération mature, dont le modèle actuel offre des résultats et des coûts acceptables : le gain d'un changement ne couvre pas le coût de migration.
Conclusion en une phrase : considérez seedream-5.0-lite comme le premier candidat pour la « génération d'images en lot sensible aux coûts », et non comme la réponse par défaut à tous les scénarios.
Dimensions de comparaison : ce qu'un développeur doit examiner pour choisir un modèle texte-image
Ne choisissez pas un modèle en vous demandant « quelle image d'exemple est la plus belle ». Les six dimensions ci-dessous sont directement réutilisables pour comparer n'importe quel modèle texte-image.
1. Coût par image (et non prix affiché)
Le vrai coût est le « coût effectif par image » : prix affiché ÷ taux d'utilisabilité. Si un modèle ne produit que six images directement utilisables sur dix, et que la moitié restante nécessite des relances, le coût réel dépasse largement le prix affiché. seedream-5.0-lite facture à l'image, et le calcul est direct : il suffit de multiplier par le taux de relance et le taux d'images rebutées.
2. Concurrence, latence et limitation de débit
Le goulot d'étranglement des tâches par lots n'est souvent pas la qualité du modèle, mais la limitation de débit. Il faut clarifier : la limite de requêtes par seconde, le comportement de la file d'attente, les modalités de timeout et de retour d'échec. Ces éléments influencent directement la conception de votre ordonnanceur de tâches.
3. Dimensions de sortie et contrôlabilité des paramètres
Les ratios d'aspect pris en charge, les paliers de résolution, la prise en charge des prompts négatifs et les paramètres d'échantillonnage réellement effectifs. Si une dimension n'est pas prise en charge, vous ne pouvez que recadrer ou redimensionner après génération, ce qui revient à augmenter implicitement le coût.
4. Cohérence de style et reproductibilité
Avec le même prompt répété, quelle est l'ampleur des écarts entre les images générées ? Peut-on reproduire de manière stable en fixant une graine, par exemple ? Pour créer une identité visuelle de marque ou des séries d'images cohérentes, cette dimension détermine directement le volume de reprises.
5. Conformité et modération de contenu
La politique de modération côté modèle, la forme du retour en cas de refus de génération, et la nécessité d'ajouter ou non une couche de filtrage côté métier. Cette partie est souvent négligée, mais peut devenir un point de blocage après la mise en production.
6. Complexité d'intégration
Le mode d'authentification, l'écosystème SDK, la structure de réponse, la conception des codes d'erreur. Plus l'intégration est complexe, plus le coût irrécupérable d'un futur changement de modèle est élevé — c'est aussi le point développé dans la section suivante.
Comparatif tarifaire : que signifie 0,035 $/image
Le mode de facturation de seedream-5.0-lite/text-to-image est à l'image, à 0,035 dollar par image. Ce chiffre n'est pas l'essentiel ; l'essentiel est son poids dans la structure de coûts de votre activité.
Convertir le prix affiché en coût effectif
Coût effectif par image ≈ prix unitaire affiché × (1 + taux de relance) ÷ taux d'utilisabilité.
Prenons un exemple purement logique (données non réelles) : si un pipeline a 20 % de requêtes à relancer et que 25 % des résultats générés doivent être refaits manuellement, alors le coût par image utilisable produite est d'environ 1,6 fois le prix affiché. Donc, pour évaluer seedream-5.0-lite, ne regardez pas seulement le chiffre de 0,035 : mesurez d'abord ces deux taux dans votre propre chaîne.
Quand l'écart de coût compte vraiment
- Scénarios à faible fréquence : quelques dizaines d'images par jour ; l'écart de coût entre modèles peut être ignoré, et il faut alors privilégier la qualité et la contrôlabilité.
- Scénarios à fréquence moyenne ou élevée : de mille à plusieurs dizaines de milliers d'images par jour ; le coût devient perceptible, mais doit encore être calculé avec le coût humain des reprises qualité.
- Scénarios de génération par lots : dès que la production quotidienne atteint l'ordre de cent mille images, l'écart de coût unitaire est amplifié linéairement, et la complexité de limitation de débit et d'ordonnancement devient le nouveau goulot d'étranglement — l'optimisation des coûts doit alors se faire conjointement avec la conception du débit, et non en regardant seulement le devis.
Le mode de facturation est lui-même un critère de choix
L'avantage de la facturation à l'image est la prévisibilité budgétaire : une requête correspond à une image, le coût est linéaire au volume d'activité, ce qui facilite le contrôle des quotas et la mesure côté utilisateur. En comparaison, les modalités facturées à la seconde de sortie ou au token nécessitent un modèle de conversion supplémentaire. Si votre système de facturation doit rester simple et explicable, la facturation à l'image est plus pratique.
Mode d'intégration : arbitrage entre connexion directe et API agrégée
Pour intégrer un modèle texte-image, deux voies existent : se connecter directement au fournisseur du modèle, ou passer par une API agrégée pour des appels unifiés. Les deux ne sont pas dans un rapport purement bon/mauvais, mais pour les équipes qui doivent tester fréquemment des modèles, l'arbitrage est clair.
Connexion directe au fournisseur du modèle
- Authentification, SDK, codes d'erreur, politique de limitation de débit : chaque fournisseur a son propre système ; chaque nouveau modèle intégré ajoute un jeu d'identifiants et de dépendances.
- Avantage : le chemin le plus court, permettant d'obtenir immédiatement les capacités exclusives et les nouveautés du fournisseur.
- Inconvénient : coût de changement élevé : une fois le modèle inscrit dans le code métier, en changer revient à refaire la couche d'intégration.
Intégration via une API agrégée
- Adresse de base, mode d'authentification et structure de réponse unifiés ; les modèles se distinguent par leur identifiant. Changer de modèle ne demande généralement que de modifier un champ, sans réécrire la logique de requête.
- Avec plusieurs modèles en parallèle, les tests A/B, le déploiement progressif et le routage par scénario sont plus faciles : vous pouvez faire passer les scénarios sensibles au prix par seedream-5.0-lite et les scénarios sensibles à la qualité par un autre modèle, tout en partageant le même code d'appel.
- Contrepartie : une couche supplémentaire, dont il faut surveiller la disponibilité et le rythme de mise à jour de la couverture des modèles.
Recommandations d'ingénierie
Quelle que soit la voie choisie, encapsulez les appels de modèle dans votre propre couche d'adaptation : définissez une structure de requête interne unifiée (prompt, dimensions, nombre, paramètres optionnels) et une structure de retour unifiée (URL ou binaire de l'image, statut, cause d'erreur). Ainsi, la couche d'agrégation n'est qu'une implémentation de la couche d'adaptation ; à l'avenir, que vous changiez d'agrégateur ou passiez en direct, le code métier ne bouge pas.
Pour les équipes qui préparent une sélection de grands modèles, la valeur la plus concrète de l'agrégation est la suivante : faire passer le « quel modèle choisir » du statut de décision d'architecture à celui de décision de configuration.
Comment vérifier les différences lors d'une comparaison avec des modèles similaires
La comparaison d'images d'exemple n'a presque aucune valeur décisionnelle — les plateformes choisissent toujours les plus belles. La méthode de validation exécutable consiste à construire votre propre petit jeu d'évaluation.
Étape 1 : construire un échantillon avec de vrais prompts métier
Extrayez 50 à 200 prompts réels des journaux de production, couvrant vos principaux types d'activité (personnages, produits, scènes, éléments textuels, etc.), et répartissez les quantités selon le poids de chaque activité. N'utilisez pas les jolis prompts des démonstrations.
Étape 2 : uniformiser les variables
Tous les modèles doivent utiliser les mêmes paliers de dimensions, le même nombre d'images et, autant que possible, les mêmes paramètres d'échantillonnage. Une comparaison avec des paramètres différents n'a aucun sens. Appelez chaque modèle avec le même lot de prompts, dans le même ordre.
Étape 3 : définir des indicateurs quantifiables
- Taux de réussite des requêtes : proportion de retours valides, pour calculer le coût des relances.
- Taux d'images rebutées : proportion jugée inutilisable manuellement, un élément clé de la formule de coût.
- Temps de sélection manuelle : combien de minutes humaines sont nécessaires pour produire N images utilisables. Souvent négligé, ce poste coûte fréquemment plus cher que l'API elle-même.
- Cohérence : stabilité des résultats pour un même prompt généré plusieurs fois.
Étape 4 : test A/B à petit trafic
Le jeu d'évaluation ne répond qu'à la question « est-ce utilisable » ; seul le trafic réel répond à « vaut-il la peine de généraliser ». Faites basculer 5 % à 10 % du trafic de production vers le nouveau modèle, sur un cycle métier complet, et comparez les indicateurs en aval (clics utilisateurs, volume de tickets de reprise manuelle, nombre d'alertes d'échec). La conclusion de cette étape est plus fiable que toute comparaison hors ligne.
Ce à quoi il faut faire attention lors d'une migration depuis un modèle existant
Les risques de migration ne résident presque jamais dans « l'appel fonctionne-t-il », mais dans les différences de détail. Alignez-les point par point ci-dessous.
Adaptation du style de prompt
Les préférences de prompt varient fortement selon les modèles : certains acceptent de longues descriptions, d'autres sont plus sensibles aux listes de mots-clés. Ne codez pas les prompts en dur dans le code métier ; placez-les dans une couche de configuration ou de modèles, afin de pouvoir les remplacer globalement et les comparer en parallèle lors d'une migration, plutôt que de modifier des chaînes de caractères dans tout le dépôt.
Différences de paramètres et de dimensions
Les noms de champs peuvent différer, tout comme les plages de valeurs. Avant de migrer, vérifiez :
- la liste des ratios d'aspect et des paliers de résolution pris en charge ;
- si une dimension non prise en charge provoque une erreur ou est silencieusement remplacée par la valeur la plus proche ;
- les valeurs par défaut des paramètres d'échantillonnage et leur effectivité.
La réécriture silencieuse des dimensions est le problème le plus insidieux — l'appel réussit, mais le ratio de l'image est incorrect, et la logique de recadrage en aval se trompe en cascade.
Structure de retour et statuts
L'image est-elle renvoyée sous forme d'URL ou de binaire ? L'URL a-t-elle une durée de validité ? Quels statuts expriment la génération en cours et l'échec ? Traitez séparément les quatre cas « appel réussi », « génération en cours », « contenu refusé » et « erreur serveur », sans tout englober dans un seul try-catch.
Codes d'erreur et stratégie de relance
Quelles erreurs méritent une relance (limitation de débit, défaillance transitoire), lesquelles ne doivent pas être relancées (refus de modération de contenu, paramètres invalides). Relancer ce qui ne devrait pas l'être revient à payer deux fois. Ajoutez également un backoff exponentiel et une limite supérieure aux relances.
Conception des clés de cache et de stockage des ressources
La clé de cache doit inclure l'identifiant du modèle et les paramètres clés ; sinon, après migration, l'ancien cache serait touché à tort et on croirait que « le nouveau modèle ne change rien ». Nommez les chemins de stockage objet avec un préfixe de modèle distinct, pour faciliter la comparaison et le retour arrière.
Étapes de bascule progressive
- Ajouter l'implémentation du nouveau modèle dans la couche d'adaptation, sans toucher au code métier ;
- Faire fonctionner l'environnement interne et confirmer la structure de retour et les branches d'erreur ;
- Déployer progressivement sur un petit pourcentage de trafic et observer le taux de réussite et les indicateurs en aval ;
- Conserver l'ancien modèle comme chemin de repli, pendant au moins un cycle métier complet ;
- Une fois les indicateurs conformes, définir le nouveau modèle par défaut et rétrograder l'ancien chemin en secours.
Check-list de sélection et recommandations de mise en œuvre
Terminons par une check-list à cocher point par point.
Avant l'intégration
- Clarifier la position métier de cette chaîne : brouillons en lot ou sortie de niveau production ?
- Mesurer le taux de réussite des requêtes et le taux d'images rebutées de la chaîne existante, et calculer la base de coût effectif par image.
- Extraire des journaux de production un jeu d'échantillons de prompts réels couvrant les principaux types d'activité.
- Vérifier que les dimensions et paramètres pris en charge par seedream-5.0-lite/text-to-image couvrent vos besoins.
Pendant l'intégration
- Ajouter une couche d'adaptation entre le métier et le modèle ; prompts, paramètres et structure de retour ne doivent pas être codés en dur.
- Unifier l'authentification et l'adresse de base ; le modèle n'est transmis que comme identifiant, pour laisser de la marge aux futurs changements.
- Distinguer les erreurs relançables des non relançables ; la stratégie de relance doit inclure un backoff et une limite supérieure.
- Inclure l'identifiant du modèle et les paramètres clés dans la clé de cache.
Après la mise en production
- Faire tourner le test A/B à petit trafic sur un cycle métier complet avant de décider d'une généralisation.
- Surveiller trois indicateurs : taux de réussite, taux d'images rebutées, volume de tickets de reprise manuelle.
- Conserver un chemin de repli jusqu'à ce que les indicateurs du nouveau modèle soient stables.
- Lorsque le volume d'appels augmente, réévaluer le débit et la structure de coûts au lieu de reconduire les anciennes conclusions.
La valeur de seedream-5.0-lite/text-to-image est d'avoir ramené la dépense unitaire de la « génération d'images en lot sensible aux coûts » à un niveau simple à budgétiser ; mais la véritable conclusion de sélection dépendra de votre propre jeu d'échantillons et du trafic réel. En plaçant le modèle derrière une couche d'adaptation unifiée, vous pouvez changer de réponse à tout moment sans réécrire le métier.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Comparatif horizontal de Recraft v4.1 Flash en génération d'images à partir de texte : guide de sélection et de migration pour les développeurs
Avec un coût de 0,01 $ par image et ses capacités de génération pure à partir de texte, déterminez s'il convient à votre pipeline de génération d'images
-

Comparatif et évaluation
Comparatif transversal de hailuo-2.3-fast/image-to-video : comment choisir un modèle image-to-video et les points clés de migration
-

Comparatif et évaluation
Seedream 5.0 Pro image-to-image comparatif horizontal : capacités, tarification et recommandations de choix