
Confronto e valutazione
seedream-5.0-lite/text-to-image a confronto: come scegliere un modello text-to-image, come integrarlo, come migrare
Prima le conclusioni: in quali scenari vale la pena provare seedream-5.0-lite per primo
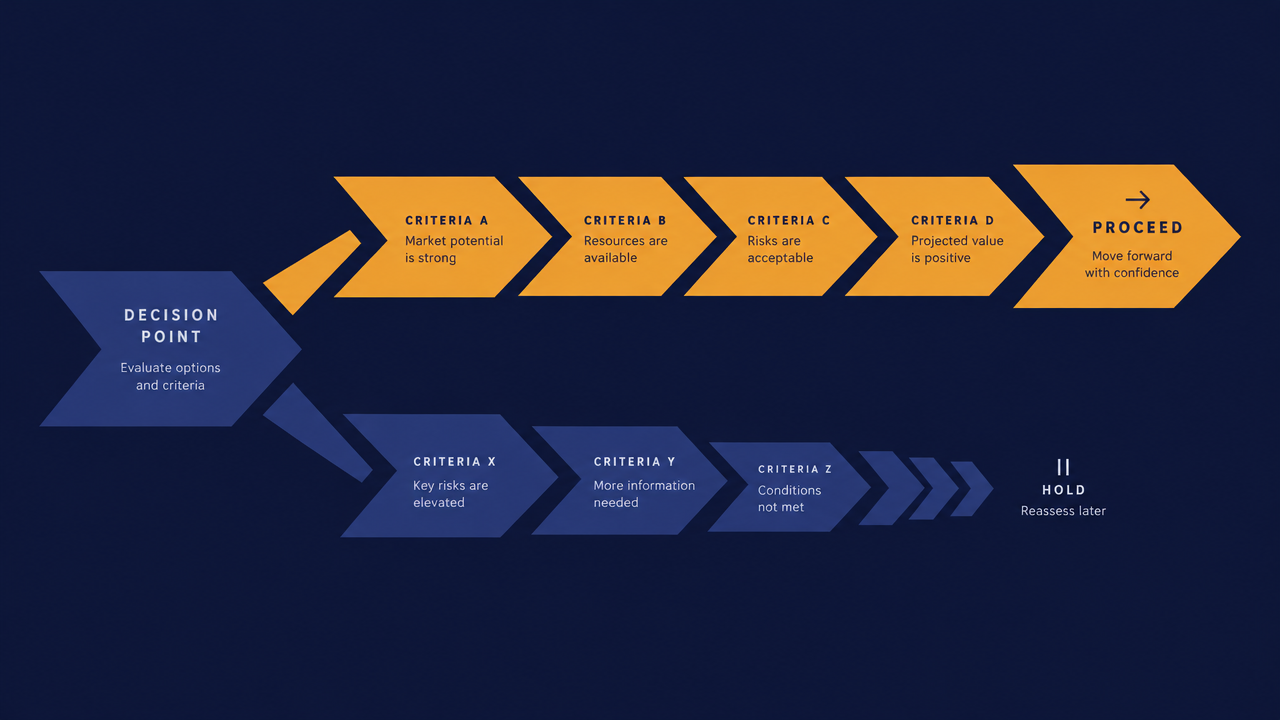
Se sei uno sviluppatore e stai cercando modelli candidati per una pipeline di generazione di immagini, puoi usare il seguente albero decisionale per un rapido posizionamento.
Scenari adatti a una prova prioritaria:
- Generazione di immagini in grandi volumi e sensibile ai costi: produzione massiva di immagini prodotto, illustrazioni per piattaforme di contenuti, bozze di materiali marketing. In questi scenari il valore della singola richiesta è basso e il volume di chiamate elevato, quindi le differenze di costo per immagine si amplificano; la tariffazione a immagine di seedream-5.0-lite/text-to-image lo rende un candidato di prima scelta.
- Scenari con tolleranza elevata verso una qualità "sufficiente": bozze, thumbnail, visual segnaposto nelle pagine elenco, anteprime interne.
- Progetti iniziali che devono validare rapidamente la forma del prodotto: prima si mette in piedi la pipeline, si affinano prompt e logica di business, poi si passa a modelli più potenti in base ai risultati.
- Team che vogliono evitare il lock-in con un singolo fornitore: desiderano un metodo di chiamata uniforme e poter cambiare modello in futuro modificando solo un identificatore.
Consigliato attendere o scegliere altri modelli:
- Scenari di livello produttivo con requisiti stringenti su dettagli, rendering del testo e composizioni complesse.
- Scenari che richiedono concorrenza molto elevata in tempi brevi e sensibilità alle fluttuazioni di latenza: per queste esigenze bisogna guardare ai limiti di rate e alle quote effettive, non solo al prezzo di listino.
- Team che hanno già una pipeline di generazione matura e il cui modello attuale offre effetti e costi in un intervallo accettabile: il beneficio del cambio non copre i costi di migrazione.
Conclusione in una frase: considera seedream-5.0-lite come primo candidato per la "generazione di immagini in grandi volumi sensibile ai costi", non come risposta predefinita per tutti gli scenari.
Dimensioni di confronto: cosa deve guardare uno sviluppatore nella scelta di un modello text-to-image
Non scegliere un modello in base a "quale immagine di esempio è più bella". Le sei dimensioni seguenti sono direttamente riutilizzabili per confrontare in modo orizzontale qualsiasi modello text-to-image.
1. Costo per immagine (non il prezzo di listino)
Il vero costo è il "costo effettivo per immagine": prezzo di listino ÷ tasso di utilizzo. Se un modello produce solo sei immagini utilizzabili su dieci e le altre richiedono nuovi tentativi, il costo reale è molto superiore al prezzo di listino. seedream-5.0-lite fattura a immagine e la logica di conversione è diretta: basta moltiplicare per il tasso di retry e il tasso di scarti.
2. Concorrenza, latenza e rate limiting
Il collo di bottiglia dei task batch spesso non è la qualità del modello, ma il rate limiting. Bisogna chiarire: limite di richieste al secondo, comportamento della coda, modalità di timeout e restituzione degli errori. Tutto ciò influenza direttamente come progettare lo scheduler dei task.
3. Dimensioni di output e controllabilità dei parametri
Rapporti d'aspetto supportati, livelli di risoluzione, supporto dei negative prompt e parametri di campionamento effettivamente applicati. Se le dimensioni non sono supportate, puoi solo ritagliare o ridimensionare dopo la generazione, il che aumenta implicitamente i costi.
4. Coerenza di stile e riproducibilità
Con lo stesso prompt ripetuto, quanto variano le immagini generate? È possibile riprodurre in modo stabile fissando il seed o altri mezzi? Per la visual identity del brand o set di immagini multiple, questa dimensione determina direttamente il volume di rilavorazioni.
5. Conformità e moderazione dei contenuti
Le politiche di moderazione lato modello, la forma di risposta in caso di rifiuto della generazione e se il tuo lato business deve aggiungere un ulteriore livello di filtraggio. Questa parte è spesso trascurata, ma può trasformarsi improvvisamente in un blocco dopo il lancio.
6. Complessità di integrazione
Metodo di autenticazione, ecosistema SDK, struttura delle risposte, design dei codici di errore. Più l'integrazione è complessa, maggiore è il costo sommerso di un futuro cambio di modello — ed è anche il punto chiave della prossima sezione.
Uno sguardo orizzontale ai prezzi: cosa significa $0,035/immagine
La modalità di tariffazione di seedream-5.0-lite/text-to-image è a immagine, 0,035 dollari per immagine. Il numero in sé non è il punto: il punto è quanto pesa nella struttura dei costi del tuo business.
Convertire il prezzo di listino in costo effettivo
Costo effettivo per immagine ≈ prezzo unitario × (1 + tasso di retry) ÷ tasso di utilizzo.
Un esempio puramente logico (non dati reali di business): se una pipeline ha il 20% delle richieste che richiedono retry e il 25% dei risultati generati necessita di rifacimento manuale, il costo per produrre un'immagine utilizzabile è circa 1,6 volte il prezzo di listino. Quindi, nel valutare seedream-5.0-lite, non guardare solo il 0,035: misura prima questi due rapporti nella tua pipeline.
Quando la differenza di costo conta davvero
- Scenari a bassa frequenza: poche decine di immagini al giorno, qualsiasi differenza di costo tra modelli è trascurabile; in questo caso vanno privilegiate qualità e controllabilità.
- Scenari a media-alta frequenza: da migliaia a decine di migliaia di immagini al giorno, il costo inizia a essere percepibile, ma va comunque calcolato insieme al costo del personale per le rilavorazioni di qualità.
- Scenari di generazione batch: quando la produzione giornaliera raggiunge l'ordine delle centomila immagini, le differenze di costo unitario si amplificano linearmente e, allo stesso tempo, il rate limiting e la complessità dello scheduling diventano nuovi colli di bottiglia — in questo caso l'ottimizzazione dei costi va fatta insieme alla progettazione del throughput, non guardando solo il listino.
La modalità di tariffazione è essa stessa un fattore di scelta
Il vantaggio della tariffazione a immagine è la prevedibilità del budget: una richiesta corrisponde a un'immagine, il costo è lineare rispetto al volume di business, è facile fare controllo delle quote e misurazione lato utente. Al contrario, le modalità fatturate a secondi di output o a token richiedono modelli di conversione aggiuntivi. Se il tuo sistema di fatturazione deve essere semplice e spiegabile, la tariffazione a immagine è più comoda.
Modalità di integrazione: compromesso tra connessione diretta e API aggregata
L'integrazione di un modello text-to-image ha due strade: connessione diretta al fornitore del modello oppure chiamata unificata tramite API aggregata. Non è una relazione puramente bianco o nero, ma per i team che devono provare frequentemente modelli diversi il compromesso è chiaro.
Connessione diretta al fornitore del modello
- Autenticazione, SDK, codici di errore e politiche di rate limiting sono una serie per ciascuno; ogni nuovo modello integrato aggiunge un set di credenziali e dipendenze.
- Il vantaggio è il percorso più breve: si ottengono subito le capacità esclusive e le novità di quel fornitore.
- Lo svantaggio è l'alto costo di cambio: una volta che il modello è scritto nel codice di business, cambiare modello equivale a riscrivere il livello di integrazione.
Integrazione tramite API aggregata
- Indirizzo base, autenticazione e struttura delle risposte unificati; i modelli si distinguono tramite l'identificatore del modello. Il cambio di modello di solito richiede la modifica di un solo campo, senza riscrivere la logica di richiesta.
- Con più modelli coesistenti, A/B test, rilascio graduale e routing per scenario sono più facili: puoi far usare seedream-5.0-lite agli scenari sensibili al prezzo e altri modelli agli scenari sensibili alla qualità, condividendo lo stesso codice di chiamata.
- Il costo è un livello in più: bisogna monitorare la disponibilità del livello di aggregazione e il ritmo di aggiornamento della copertura dei modelli.
Consigli ingegneristici
Qualunque strada si scelga, incapsula le chiamate ai modelli in un proprio livello di adattamento: definisci una struttura interna di richiesta uniforme (prompt, dimensioni, quantità, parametri opzionali) e una struttura di risposta uniforme (URL o binario dell'immagine, stato, motivo dell'errore). Così il livello di aggregazione è solo un'implementazione del livello di adattamento e, in futuro, qualunque sia il cambio di aggregatore o di connessione diretta, il codice di business non cambia.
Per i team che si preparano alla selezione di modelli di grandi dimensioni, il valore più concreto dell'approccio aggregato è: degradare "quale modello scegliere" da decisione architetturale a decisione di configurazione.
Come verificare le differenze nel confronto orizzontale con modelli simili
Il confronto tra immagini di esempio non ha quasi alcun valore decisionale — le piattaforme scelgono sempre le più belle. Il metodo di verifica eseguibile è costruire un proprio piccolo set di valutazione.
Primo passo: costruire il campione con prompt reali di business
Estrai dai log di produzione 50–200 prompt reali, coprendo i tuoi principali tipi di business (persone, prodotti, immagini di scenario, elementi testuali, ecc.), distribuendo le quantità in base al peso del business. Non usare i bei prompt delle demo.
Secondo passo: uniformare le variabili
Tutti i modelli con gli stessi livelli di dimensione, lo stesso numero di immagini e, per quanto possibile, gli stessi parametri di campionamento. Conclusioni di confronto con parametri non uniformi non hanno senso. Per ogni modello usa lo stesso set di prompt e lo stesso ordine di chiamata.
Terzo passo: definire metriche quantificabili
- Tasso di successo delle richieste: percentuale di risposte valide, per calcolare il costo dei retry.
- Tasso di scarti: percentuale giudicata inutilizzabile manualmente, voce chiave nella formula dei costi.
- Tempo di selezione manuale: quanti minuti di lavoro umano servono per produrre N immagini utilizzabili. Spesso trascurata, ma spesso più costosa del costo API.
- Coerenza: stabilità dei risultati con lo stesso prompt ripetuto più volte.
Quarto passo: A/B a basso traffico
Il set di valutazione risponde solo a "se è utilizzabile", ma è il traffico reale a rispondere a "se vale la pena passare al 100%". Sposta il 5%–10% del traffico di produzione sul nuovo modello per almeno un ciclo di business e confronta le metriche a valle (clic degli utenti, numero di ticket di rilavorazione manuale, numero di allerte di errore). Le conclusioni di questo passo sono più affidabili di qualsiasi confronto offline.
Cosa tenere presente nella migrazione da un modello esistente
I rischi della migrazione non stanno quasi mai nel "se la chiamata funziona", ma nelle differenze di dettaglio. Allinea punto per punto i seguenti aspetti.
Adattamento dello stile dei prompt
Le preferenze di prompt variano molto tra modelli: alcuni gradiscono descrizioni lunghe, altri sono più sensibili a elenchi di parole chiave. Non codificare i prompt nel codice di business: mettili in configurazione o in un livello di template, così in fase di migrazione puoi sostituirli in blocco e confrontarli in parallelo, invece di modificare stringhe in tutto il repository.
Differenze di parametri e dimensioni
I nomi dei campi possono essere diversi e anche gli intervalli di valori. Prima della migrazione verifica:
- l'elenco dei rapporti d'aspetto e dei livelli di risoluzione supportati;
- se le dimensioni non supportate generano un errore o vengono silenziosamente riscritte al valore più vicino;
- i valori predefiniti dei parametri di campionamento e se sono effettivamente applicati.
La riscrittura silenziosa delle dimensioni è il problema più nascosto: la chiamata riesce, ma il rapporto dell'immagine è sbagliato e la logica di ritaglio a valle si rompe di conseguenza.
Struttura delle risposte e stati
L'immagine viene restituita come URL o come binario? L'URL ha una scadenza? Con quali stati si esprimono generazione in corso e fallimento? Tratta separatamente le quattro situazioni "chiamata riuscita", "generazione in corso", "contenuto rifiutato", "errore del server", senza un unico try-catch.
Codici di errore e strategia di retry
Quali errori meritano un retry (rate limiting, guasti transitori) e quali no (rifiuto per moderazione dei contenuti, parametri non validi). Fare retry su casi che non lo meritano equivale a pagare due volte. Aggiungi anche backoff esponenziale e limite massimo ai retry.
Progettazione delle chiavi per cache e storage degli asset
La chiave di cache deve includere l'identificatore del modello e i parametri chiave, altrimenti dopo la migrazione la vecchia cache verrebbe colpita erroneamente e sembrerebbe che "il nuovo modello non ha cambiato gli effetti". Il percorso nello storage oggetti deve avere un prefisso separato per il modello, per facilitare confronti e rollback.
Passi per il passaggio graduale
- Aggiungi l'implementazione del nuovo modello nel livello di adattamento, senza toccare il codice di business;
- Esegui nell'ambiente interno e verifica la struttura delle risposte e i rami di errore;
- Rilascia con una piccola percentuale di traffico e osserva tasso di successo e metriche a valle;
- Mantieni il vecchio modello come percorso di fallback per almeno un ciclo di business completo;
- Quando le metriche sono a target, imposta il nuovo modello come predefinito e degrada il vecchio percorso a backup.
Checklist di selezione e consigli operativi
Infine, una lista che puoi spuntare punto per punto.
Prima dell'integrazione
- Chiarisci il posizionamento di business di questa pipeline: bozze in batch o output di livello produttivo?
- Misura il tasso di successo delle richieste e il tasso di scarti della pipeline esistente, calcola la baseline del costo effettivo per immagine.
- Estrai dai log di produzione un set di prompt reali che copra i principali tipi di business.
- Verifica se le dimensioni e i parametri supportati da seedream-5.0-lite/text-to-image coprono le tue esigenze.
Durante l'integrazione
- Aggiungi un livello di adattamento tra business e modello; prompt, parametri e struttura delle risposte non devono essere codificati in modo fisso.
- Unifica autenticazione e indirizzo base; il modello viene passato solo come identificatore, lasciando spazio per cambi futuri.
- Distingui gli errori ritentabili da quelli non ritentabili; la strategia di retry deve avere backoff e limite massimo.
- La chiave di cache deve includere l'identificatore del modello e i parametri chiave.
Dopo il lancio
- Esegui l'A/B a basso traffico per un ciclo di business completo prima di decidere il passaggio al 100%.
- Monitora tre metriche: tasso di successo, tasso di scarti, numero di ticket di rilavorazione manuale.
- Mantieni il percorso di fallback finché le metriche del nuovo modello non sono stabili.
- Quando il volume di chiamate cresce, rivaluta throughput e struttura dei costi invece di riutilizzare le vecchie conclusioni.
Il valore di seedream-5.0-lite/text-to-image sta nel portare la spesa per immagine della "generazione di immagini in grandi volumi sensibile ai costi" a un livello facile da preventivare; ma la vera conclusione di selezione deve venire dal tuo set di campioni e dal traffico reale. Integrando il modello dietro un livello di adattamento unificato, puoi cambiare risposta in qualsiasi momento senza riscrivere il business.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Confronto e valutazione
Confronto orizzontale di Seedream 5.0 Pro image-to-image: capacità, prezzi e consigli per la scelta