
Avaliação comparativa
seedream-5.0-lite/text-to-image comparação横向: como escolher, integrar e migrar modelos de texto para imagem
Primeiro a conclusão: em quais cenários vale a pena testar o seedream-5.0-lite com prioridade
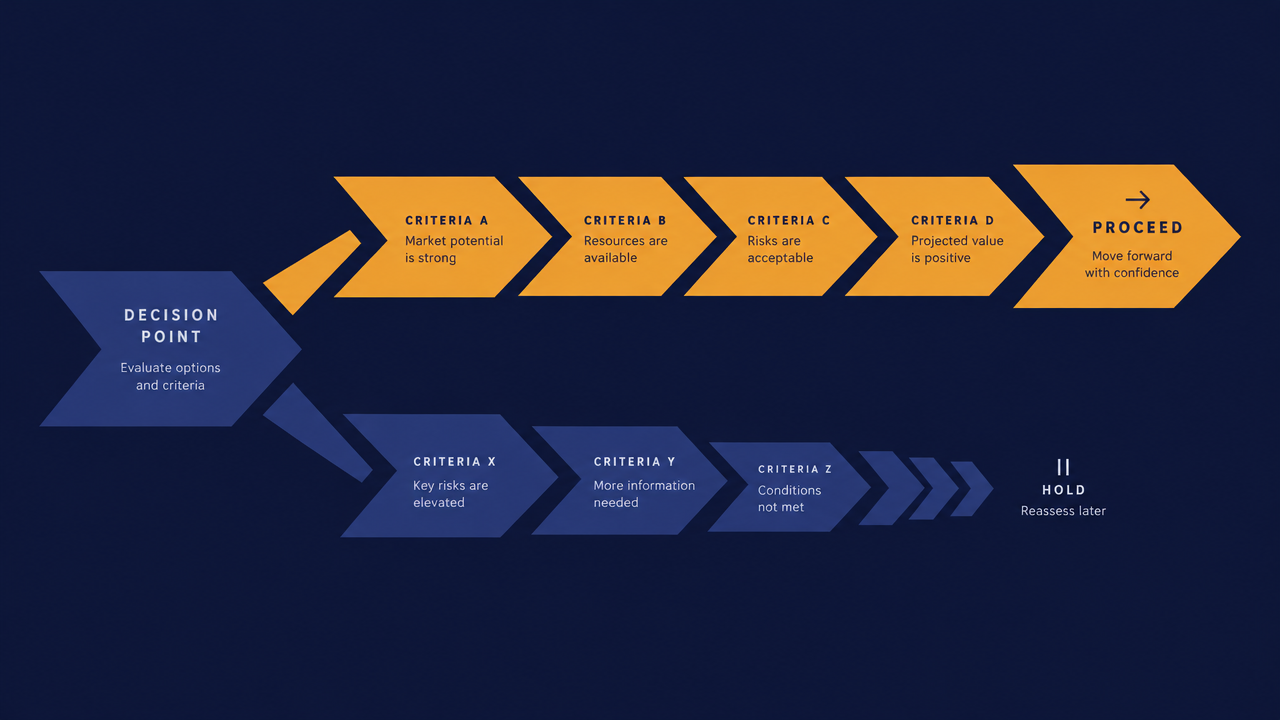
Se você é desenvolvedor e está procurando modelos candidatos para um pipeline de geração de imagens, pode usar a árvore de decisão abaixo para fazer um enquadramento rápido.
Cenários em que vale a pena testar com prioridade:
- Geração em lote de grande volume e sensível a custo: produção em massa de imagens de produtos, ilustrações para plataformas de conteúdo, rascunhos iniciais de materiais de marketing. Nesses cenários o valor por requisição é baixo e o volume de chamadas é alto, então a diferença de custo por imagem é amplificada; o formato de cobrança por imagem do seedream-5.0-lite/text-to-image é bastante adequado como candidato preferencial.
- Cenários com alta tolerância a uma qualidade de geração "suficientemente boa": imagens de rascunho, miniaturas, visuais de placeholder para páginas de listagem, pré-visualizações internas.
- Projetos iniciais que precisam validar rapidamente o formato do produto: primeiro colocar o pipeline para funcionar, refinar os prompts e a lógica de negócio, e depois fazer upgrade para modelos mais fortes conforme os resultados.
- Equipes que querem evitar ficar presas a um único fornecedor: desejam um modo de chamada unificado, de forma que, no futuro, trocar de modelo exija apenas alterar um identificador.
Recomenda-se continuar observando ou escolher outro modelo:
- Cenários de nível de produto final com requisitos rígidos de detalhes, renderização de texto e composição complexa.
- Cenários que exigem altíssima concorrência em pouco tempo e são sensíveis à variação de latência — esses requisitos dependem do comportamento real de limitação de taxa e cotas, não apenas do preço de tabela.
- Equipes que já têm um pipeline maduro de geração de imagens e cujo modelo atual tem efeito e custo em faixa aceitável, nas quais o ganho da troca não cobre o custo de migração.
Conclusão em uma frase: trate o seedream-5.0-lite como o primeiro candidato para "geração em lote sensível a custo", e não como a resposta padrão para todos os cenários.
Dimensões de comparação: o que um desenvolvedor deve observar ao escolher um modelo de texto para imagem
Não escolha um modelo com base em "qual imagem de exemplo é mais bonita". As seis dimensões abaixo podem ser reutilizadas diretamente para comparar horizontalmente qualquer modelo de texto para imagem.
1. Custo por imagem (não o preço de tabela)
O custo real é o "custo efetivo por imagem": preço de tabela ÷ taxa de utilização. Se de cada dez imagens geradas por um modelo apenas seis podem ser usadas diretamente e a outra metade depende de novas tentativas, o custo real é muito maior que o preço de tabela. O seedream-5.0-lite cobra por imagem, e a lógica de conversão é direta — basta multiplicar pela taxa de repetição e pela taxa de imagens descartadas.
2. Concorrência, latência e limitação de taxa
O gargalo de tarefas em lote muitas vezes não é a qualidade do modelo, mas a limitação de taxa. É preciso perguntar com clareza: limite de requisições por segundo, comportamento de fila, forma de retorno em timeout e falha. Isso afeta diretamente como seu agendador de tarefas deve ser projetado.
3. Tamanhos de saída e controlabilidade de parâmetros
Proporções de aspecto suportadas, faixas de resolução, se há suporte a prompts negativos e quais parâmetros de amostragem realmente têm efeito. Quando o tamanho não é suportado, você só pode recortar ou redimensionar após a geração, o que equivale a um aumento implícito de custo.
4. Consistência de estilo e reprodutibilidade
Qual é a variação das imagens ao chamar repetidamente o mesmo prompt? É possível reproduzir de forma estável usando seed fixa ou outros meios? Ao produzir visuais de marca ou conjuntos de materiais com várias imagens, essa dimensão determina diretamente o volume de retrabalho.
5. Conformidade e moderação de conteúdo
A estratégia de moderação do lado do modelo, a forma de retorno quando a geração é recusada e se o seu lado de negócio ainda precisa adicionar uma camada de filtragem. Essa parte costuma ser ignorada, mas pode se tornar um bloqueio repentino depois do lançamento.
6. Complexidade de integração
Forma de autenticação, ecossistema de SDK, estrutura de resposta, design de códigos de erro. Quanto mais complexa a integração, maior o custo irrecuperável de trocar de modelo depois — este também é o ponto central da próxima seção.
Olhar horizontal sobre o preço: o que significa US$ 0,035/imagem
A base de cobrança do seedream-5.0-lite/text-to-image é cobrança por imagem, US$ 0,035 por imagem. O número em si não é o ponto principal; o importante é quanto ele representa na estrutura de custos do seu negócio.
Converter o preço de tabela em custo efetivo
Custo efetivo por imagem ≈ preço de tabela por imagem × (1 + taxa de repetição) ÷ taxa de utilização.
Um exemplo puramente lógico (não são dados reais de negócio): se um pipeline tem 20% das requisições exigindo nova tentativa e, entre os resultados gerados, 25% precisam ser refeitos manualmente, então o custo para produzir cada imagem utilizável é cerca de 1,6 vez o preço de tabela. Portanto, ao avaliar o seedream-5.0-lite, não olhe apenas o número 0,035; primeiro meça essas duas taxas no seu próprio pipeline.
Quando a diferença de custo realmente importa
- Cenários de baixa frequência: dezenas de imagens por dia; a diferença de custo entre modelos pode ser ignorada, e nesse caso deve-se priorizar qualidade e controlabilidade.
- Cenários de média e alta frequência: de milhares a dezenas de milhares de imagens por dia; o custo começa a entrar em faixa perceptível, mas ainda deve ser calculado junto com o custo de mão de obra para retrabalho de qualidade.
- Cenários de geração em lote: quando a produção diária entra na casa das cem mil imagens, a diferença de custo por imagem é amplificada linearmente, e ao mesmo tempo a limitação de taxa e a complexidade de agendamento se tornam novos gargalos — nesse momento, a otimização de custo deve ser feita junto com o design de throughput, e não apenas olhando a cotação.
A própria base de cobrança também é fator de escolha
A vantagem da cobrança por imagem é o orçamento previsível: uma requisição corresponde a uma imagem, a despesa corresponde linearmente ao volume de negócio e é fácil fazer controle de cota e medição no lado do usuário. Em comparação, modalidades cobradas por segundo de saída ou por token exigem modelos adicionais de conversão. Se o seu sistema de cobrança precisa ser simples e explicável, a cobrança por imagem dá menos trabalho.
Modo de integração: trade-offs entre conexão direta e API agregadora
Há dois caminhos para integrar um modelo de texto para imagem: conectar-se diretamente ao provedor do modelo ou chamar de forma unificada por meio de uma API agregadora. Os dois não são uma relação pura de bom ou ruim, mas para equipes que precisam testar modelos com frequência, o trade-off é claro.
Conexão direta com o provedor do modelo
- Autenticação, SDK, códigos de erro e estratégias de limitação de taxa são um conjunto para cada fornecedor; a cada novo modelo integrado, surge mais um conjunto de credenciais e dependências.
- Vantagem: o caminho é o mais curto, permitindo obter imediatamente capacidades exclusivas e novos recursos daquele provedor.
- Desvantagem: alto custo de troca; uma vez que o modelo entra no código de negócio, trocar de modelo equivale a refazer a camada de integração.
Integração via API agregadora
- Endereço base, forma de autenticação e estrutura de resposta unificados, com os modelos diferenciados por identificador. Trocar de modelo geralmente exige alterar apenas um campo, sem reescrever a lógica de requisição.
- Com vários modelos coexistindo, testes A/B, liberação gradual e roteamento por cenário ficam mais fáceis: você pode direcionar cenários sensíveis a preço para o seedream-5.0-lite e cenários sensíveis a qualidade para outros modelos, compartilhando o mesmo código de chamada.
- Custo: há uma camada adicional, sendo necessário acompanhar a disponibilidade da própria camada agregadora e o ritmo de atualização da cobertura de modelos.
Recomendações de engenharia
Independentemente do caminho escolhido, envolva a chamada do modelo na sua própria camada de adaptação: defina uma estrutura interna unificada de requisição (prompt, tamanho, quantidade, parâmetros opcionais) e uma estrutura unificada de resposta (endereço ou binário da imagem, status, motivo do erro). Assim, a camada agregadora será apenas uma implementação da camada de adaptação, e no futuro, seja trocando o agregador ou a conexão direta, o código de negócio não precisará mudar.
Para equipes que se preparam para fazer seleção de grandes modelos, o valor mais prático do modo agregado é: rebaixar "qual modelo escolher" de decisão de arquitetura para decisão de configuração.
Como validar diferenças ao comparar horizontalmente com modelos semelhantes
A comparação de imagens de exemplo quase não tem valor de decisão — as plataformas escolhem as mais bonitas. O método de validação executável é construir seu próprio pequeno conjunto de avaliação por amostragem.
Primeiro passo: construir amostras com prompts reais de negócio
Extraia de 50 a 200 prompts reais dos logs de produção, cobrindo os principais tipos de negócio (pessoas, produtos, imagens de cena, elementos de texto etc.) e distribua as quantidades conforme a proporção de negócio. Não use prompts bonitos de demonstração.
Segundo passo: unificar variáveis
Todos os modelos devem usar a mesma faixa de tamanho, a mesma quantidade de imagens e, na medida do possível, os mesmos parâmetros de amostragem. Conclusões de comparação com parâmetros inconsistentes não têm significado. Chame cada modelo com o mesmo conjunto de prompts e na mesma ordem.
Terceiro passo: definir métricas quantificáveis
- Taxa de sucesso de requisições: proporção de retornos válidos, usada para calcular o custo de repetição.
- Taxa de imagens descartadas: proporção julgada inutilizável manualmente; é um item-chave na fórmula de custo.
- Tempo de seleção manual: quantos minutos de trabalho manual são necessários para cada N imagens utilizáveis produzidas. Esse item costuma ser ignorado, mas muitas vezes é mais caro que o custo da API.
- Consistência: os resultados gerados várias vezes com o mesmo prompt são estáveis.
Quarto passo: A/B com pequeno volume de tráfego
O conjunto de avaliação só responde "dá para usar"; o tráfego real é que responde "vale a pena usar em escala total". Direcione de 5% a 10% do tráfego de produção para o novo modelo, execute por um ciclo completo de negócio e compare indicadores downstream (cliques de usuários, volume de tickets de retrabalho manual, número de alertas de falha). A conclusão desse passo é mais confiável que qualquer comparação offline.
O que observar ao migrar de um modelo existente
Os riscos da migração quase nunca estão em "se a chamada funciona", mas nas diferenças de detalhe. Alinhe item a item conforme abaixo.
Adaptação do estilo de prompt
As preferências de prompt variam muito entre modelos: alguns aceitam bem descrições longas, outros são mais sensíveis a listas de palavras-chave. Não codifique prompts diretamente no código de negócio; coloque-os em configuração ou camada de template, para que na migração seja possível substituir em bloco e comparar em paralelo, em vez de alterar strings por todo o repositório.
Diferenças de parâmetros e tamanhos
Os nomes dos campos podem ser diferentes e as faixas de valores também. Antes de migrar, confirme:
- A lista de proporções de aspecto e faixas de resolução suportadas;
- Se tamanhos não suportados geram erro ou são silenciosamente reescritos para o valor mais próximo;
- Os valores padrão dos parâmetros de amostragem e se eles têm efeito.
A reescrita silenciosa de tamanho é o problema mais oculto — a chamada é bem-sucedida, mas a proporção da imagem gerada está errada, e a lógica de recorte downstream erra junto.
Estrutura de resposta e status
A imagem é retornada como URL ou binário? A URL tem prazo de validade? Quais status expressam geração em andamento e falha? Trate separadamente as quatro situações "chamada bem-sucedida", "geração em andamento", "conteúdo recusado" e "erro do servidor"; não coloque tudo em um único try-catch.
Códigos de erro e estratégia de repetição
Quais erros valem nova tentativa (limitação de taxa, falhas transitórias) e quais não valem (recusa por moderação de conteúdo, parâmetros inválidos). Fazer nova tentativa em casos que não deveriam ser repetidos equivale a pagar duas vezes. Ao mesmo tempo, adicione backoff exponencial e limite máximo às repetições.
Design de chaves de cache e armazenamento de materiais
A chave de cache deve incluir o identificador do modelo e os parâmetros-chave; caso contrário, após a migração o cache antigo será atingido por engano, e parecerá que "o efeito do novo modelo não mudou". Nomeie os caminhos de armazenamento de objetos com um prefixo separado do modelo, para facilitar comparação e rollback.
Passos de troca gradual
- Adicionar a implementação do novo modelo na camada de adaptação, sem alterar o código de negócio;
- Executar no ambiente interno, confirmando a estrutura de resposta e os ramos de erro;
- Liberar com uma pequena proporção de tráfego, observando taxa de sucesso e indicadores downstream;
- Manter o modelo antigo como caminho de fallback por pelo menos um ciclo completo de negócio;
- Depois que os indicadores forem atingidos, definir o novo modelo como padrão e rebaixar o caminho antigo para reserva.
Checklist de seleção e recomendações de implementação
Por fim, consolidamos em uma lista que pode ser marcada item a item.
Antes da integração
- Definir claramente o posicionamento de negócio desse pipeline: é rascunho em lote ou saída de nível de produto final?
- Medir a taxa de sucesso de requisições e a taxa de imagens descartadas do pipeline existente, calculando a linha de base do custo efetivo por imagem.
- Extrair dos logs de produção um conjunto de amostras de prompts reais, cobrindo os principais tipos de negócio.
- Confirmar se os tamanhos e parâmetros suportados pelo seedream-5.0-lite/text-to-image cobrem suas necessidades.
Durante a integração
- Adicionar uma camada de adaptação entre o negócio e o modelo, sem codificar prompts, parâmetros e estrutura de resposta diretamente.
- Unificar autenticação e endereço base, passando o modelo apenas como identificador, deixando espaço para trocas futuras.
- Distinguir erros repetíveis e não repetíveis, com estratégia de repetição contendo backoff e limite máximo.
- Incluir o identificador do modelo e os parâmetros-chave na chave de cache.
Após o lançamento
- Executar A/B com pequeno volume de tráfego por um ciclo completo de negócio antes de decidir pela escala total.
- Monitorar três indicadores: taxa de sucesso, taxa de imagens descartadas e volume de tickets de retrabalho manual.
- Manter o caminho de fallback até que os indicadores do novo modelo estejam estáveis.
- Quando o volume de chamadas crescer, reavaliar throughput e estrutura de custos, em vez de reutilizar conclusões antigas.
O valor do seedream-5.0-lite/text-to-image está em colocar o gasto por imagem da "geração em lote sensível a custo" em uma faixa fácil de orçar; a conclusão real de seleção deve ser dada pelo seu próprio conjunto de amostras e pelo tráfego real. Com o modelo integrado atrás de uma camada de adaptação unificada, você pode trocar a resposta a qualquer momento, sem reescrever o negócio.
Artigos relacionados
Ver todos os artigos →-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
-

Avaliação comparativa
Comparativo horizontal de image-to-image do Seedream 5.0 Pro: capacidades, preços e recomendações de seleção