
比較レビュー
seedream-5.0-lite/text-to-image 横向对比:文生图模型怎么选、怎么接、怎么迁移
先説結論:什麼場景值得優先嘗試 seedream-5.0-lite
如果你是開發者,正在為一條圖像生成鏈路尋找候選模型,可以先用下面的判斷樹做一次快速歸位。
適合優先試用的場景:
- 大批量、成本敏感的批量出圖:商品圖批量鋪量、內容平台配圖、營銷素材的初篩稿。這類場景單次請求價值低、調用量大,單圖成本的差異會被放大,seedream-5.0-lite/text-to-image 按張計價的形態很適合作為首選候選。
- 對「夠用就好」的生成質量容忍度較高的場景:草稿圖、縮略圖、列表頁佔位視覺、內部預覽。
- 需要快速驗證產品形態的早期項目:先把鏈路跑通、把提示詞與業務邏輯打磨好,後續再按效果升級到更強的模型。
- 想避免被單一供應商鎖定的團隊:希望調用方式統一、未來換模型只改一個標識符。
建議繼續觀望或選別的模型:
- 對細節、文字渲染、複雜構圖有硬性要求的成品級場景。
- 需要短時間內極高並發、且對延遲抖動敏感的場景——這類需求要看實際的限流與配額表現,不能只看標價。
- 已經有成熟出圖流水線、且當前模型效果與成本都在可接受區間的團隊,切換收益不足以覆蓋遷移成本。
一句話結論:把 seedream-5.0-lite 當作「成本敏感的批量出圖」的第一候選,而不是所有場景的默認答案。
對比維度:開發者選文生圖模型該看什麼
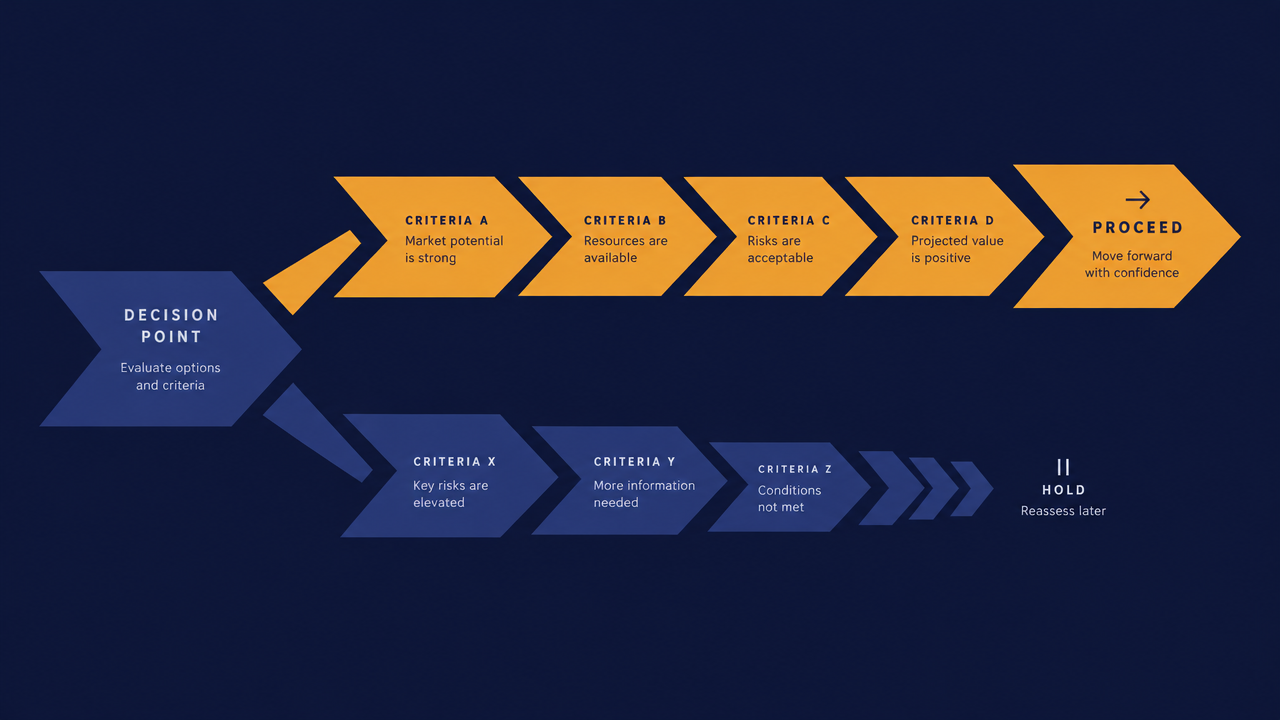
不要用「哪張樣例圖更好看」來選模型。下面六個維度可以直接複用,用來橫向比較任意文生圖模型。
1. 單圖成本(不是標價)
真正的成本是「有效單張成本」:標價 ÷ 可用率。如果某個模型十張裡只有六張能直接用,剩下一半靠重試,實際成本遠高於標價。seedream-5.0-lite 按張計費,折算邏輯很直接——把重試率與廢片率乘上去即可。
2. 並發、延遲與限流
批量任務的瓶頸常常不是模型質量,而是限流。要問清楚:每秒請求上限、隊列行為、超時與失敗返回方式。這些直接影響你的任務調度器怎麼設計。
3. 輸出尺寸與參數可控性
支持的寬高比、分辨率檔位、是否支持負向提示詞與實際生效的採樣參數。尺寸不支持時,你只能生成後裁切或縮放,等於隱性增加成本。
4. 風格一致性與可復現性
同一個提示詞重複調用,出圖差異有多大?能否通過固定種子等方式穩定復現?做品牌視覺或多圖成組素材時,這個維度會直接決定返工量。
5. 合規與內容審核
模型側的審核策略、拒絕生成時的回傳形式,以及你的業務側是否還需要加一層過濾。這部分常被忽略,卻會在上線後突然變成阻塞項。
6. 接入複雜度
鑑權方式、SDK 生態、響應結構、錯誤碼設計。接入越複雜,後續切換模型的沉沒成本越高——這也是下一節要展開的重點。
定價橫向看:$0.035/張 意味著什麼
seedream-5.0-lite/text-to-image 的計價口徑是按張計費,每張 0.035 美元。這個數字本身不是重點,重點是它在你的業務成本結構裡佔多大比重。
把標價折算成有效成本
有效單圖成本 ≈ 單張標價 × (1 + 重試率) ÷ 可用率。
舉個純邏輯的例子(非真實業務數據):如果一條流水線有 20% 的請求需要重試,生成結果裡又有 25% 需要人工重做,那麼每產出一張可用圖的成本大約是標價的 1.6 倍。所以在評估 seedream-5.0-lite 時,不要只看 0.035 這個數,要先把你自己鏈路的這兩個比率測出來。
什麼時候成本差異才真正重要
- 低頻場景:一天出幾十張圖,任何模型的成本差異都可以忽略,此時應該優先看質量與可控性。
- 中高頻場景:每天上千到上萬張,成本開始進入可感知區間,但仍要和质量返工的人力成本放在一起算。
- 批量生成場景:一旦單日產出進入十萬張量級,單張成本差異會被線性放大,同時限流與調度複雜度成為新瓶頸——此時成本優化必須和吞吐設計一起做,而不是單看報價。
計費口徑本身也是選型因素
按張計費的好處是預算可預測:一次請求對應一張圖,費用與業務量線性對應,容易做配額控制和用戶側計量。相比之下,按輸出秒數或按 token 計費的模態需要額外的換算模型。如果你的計費系統需要簡單可解釋,按張計費會更省事。
接入方式:直連與聚合 API 的取捨
接入文生圖模型有兩條路:直連模型提供方,或通過聚合 API 統一調用。兩者不是純粹的好壞關係,但對需要頻繁試模型的團隊,取捨很清楚。
直連模型提供方
- 鑑權、SDK、錯誤碼、限流策略都是各家一套;每接入一個新模型,就多一套憑據與依賴。
- 優點是鏈路最短,能第一時間拿到該提供方的獨有能力與新特性。
- 缺點是切換成本高:模型一旦寫進業務代碼,換模型等於改一遍集成層。
通過聚合 API 接入
- 統一的基礎地址、鑑權方式與響應結構,模型之間靠模型標識區分。切換模型通常只改一個字段,不用重寫請求邏輯。
- 多模型並存時,A/B 測試、灰度放量、按場景路由都更容易實現:你可以讓價格敏感的場景走 seedream-5.0-lite,讓質量敏感的場景走別的模型,而調用代碼共享同一套。
- 代價是多了一層,需要關注聚合層本身的可用性與模型覆蓋更新節奏。
工程上的建議
無論走哪條路,都把模型調用包在自己的適配層裡:定義統一的內部請求結構(提示詞、尺寸、數量、可選參數)和統一的返回結構(圖像地址或二進制、狀態、錯誤原因)。這樣聚合層只是適配層的一個實現,將來無論換聚合還是換直連,業務代碼都不動。
對準備做大模型選型的團隊,聚合方式最實際的價值是:把「選哪個模型」從架構決策降級成配置決策。
與同類模型橫向對比時如何驗證差異
樣例圖對比幾乎不具備決策價值——平台挑的都是最好看的那幾張。可執行的驗證方法是構造你自己的小樣本評測集。
第一步:用真實業務提示詞構樣本
從線上日誌裡抽 50–200 條真實提示詞,覆蓋你的主要業務類型(人物、商品、場景圖、文字元素等),並按業務佔比分配數量。不要用演示用的漂亮提示詞。
第二步:統一變量
所有模型固定相同的尺寸檔位、相同張數、盡可能相同的採樣參數。參數不一致的對比結論沒有意義。對每個模型都用同一批提示詞、同一順序調用。
第三步:定義可量化的指標
- 請求成功率:有效返回佔比,用於核算重試成本。
- 廢片率:人工判定不可用的比例,這是成本公式裡的關鍵一項。
- 人工挑選耗時:每產出 N 張可用圖需要多少人工分鐘。這項常被忽略,但往往比 API 成本更貴。
- 一致性:同提示詞多次生成的結果是否穩定。
第四步:小流量 A/B
評測集只回答「能不能用」,真實流量才回答「值不值得全量」。把 5%–10% 的線上流量切到新模型,跑夠一個業務週期,對比下游指標(用戶點擊、人工返工工單量、失敗告警數)。這一步的結論比任何離線對比都更可靠。
從現有模型遷移過來要注意什麼
遷移的風險幾乎都不在「調用能不能通」,而在細節差異。按下面幾項逐條對齊。
提示詞風格適配
不同模型的提示詞偏好差異很大:有的吃長描述,有的對關鍵詞列表更敏感。不要把提示詞硬編碼在業務代碼裡,放到配置或模板層,遷移時能整體替換、並行對比,而不是滿倉庫改字符串。
參數與尺寸差異
字段名可能叫法不同,取值範圍也不同。遷移前先確認:
- 支持的寬高比與分辨率檔位清單;
- 不支持的尺寸是報錯還是被靜默改寫成最接近值;
- 採樣類參數的默認值與是否生效。
尺寸被靜默改寫是最隱蔽的問題——調用成功,但出圖比例不對,下游裁切邏輯跟著錯。
返回結構與狀態
圖像以 URL 還是二進制返回?URL 是否有時效?生成中與失敗分別用什麼狀態表達?把「調用成功」「生成中」「內容被拒絕」「服務端錯誤」四類情況分開處理,不要統統一一把 try-catch。
錯誤碼與重試策略
哪些錯誤值得重試(限流、瞬時故障),哪些不該重試(內容審核拒絕、參數非法)。對不該重試的情況做重試,等於重複付費。同時給重試加指數退避與上限。
緩存與素材存儲的鍵設計
緩存鍵裡必須包含模型標識與關鍵參數,否則遷移後舊緩存會被誤命中,看起來是「新模型效果沒變」。對象存儲的路徑命名單獨帶模型前綴,方便對比與回滾。
灰度切換步驟
- 適配層裡新增模型實現,業務代碼不動;
- 內部環境跑通,確認返回結構與錯誤分支;
- 按小比例流量放量,觀察成功率與下游指標;
- 保留舊模型作為回退路徑,至少保留一個完整業務週期;
- 指標達標後再把新模型設為默認,舊路徑降級為備用。
選型清單與落地建議
最後收束成一份可以逐條勾選的清單。
接入前
- 明確這條鏈路的業務定位:是批量草稿,還是成品級輸出?
- 測出現有鏈路的請求成功率與廢片率,算出有效單圖成本基線。
- 從線上日誌抽出真實提示詞樣本集,覆蓋主要業務類型。
- 確認 seedream-5.0-lite/text-to-image 支持的尺寸與參數是否覆蓋你的需求。
接入時
- 在業務與模型之間加一層適配層,提示詞、參數、返回結構都不硬編碼。
- 統一鑑權與基礎地址,模型只作為標識符傳入,為後續切換留出空間。
- 區分可重試與不可重試錯誤,重試策略帶退避與上限。
- 緩存鍵包含模型標識與關鍵參數。
上線後
- 小流量 A/B 跑滿一個業務週期再決定是否全量。
- 監控成功率、廢片率、人工返工工單量三項指標。
- 保留回退路徑,直到新模型指標穩定。
- 當調用量增長時,重新評估吞吐與成本結構,而不是沿用舊結論。
seedream-5.0-lite/text-to-image 的價值在於把「成本敏感的批量出圖」這件事的單張支出壓到了一個容易做預算的位置,而真正的選型結論要靠你自己的樣本集和真實流量給出。把模型接在統一適配層之後,你隨時可以換答案,而不必重寫業務。


