
Comparativa
seedream-5.0-lite/text-to-image comparativa horizontal: cómo elegir un modelo de texto a imagen, cómo integrarlo y cómo migrar
Primero la conclusión: en qué escenarios conviene probar seedream-5.0-lite como prioridad
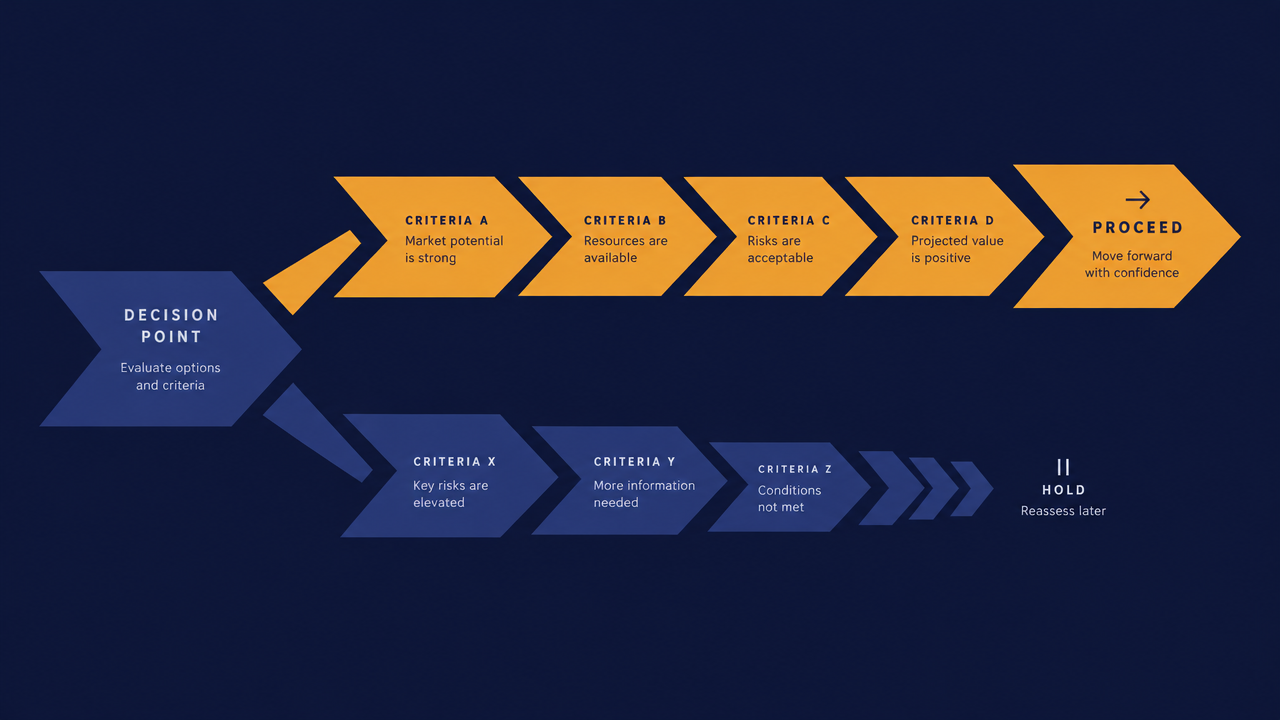
Si eres desarrollador y estás buscando modelos candidatos para una cadena de generación de imágenes, puedes usar el siguiente árbol de decisión para hacer una ubicación rápida.
Escenarios adecuados para probarlo como prioridad:
- Generación de imágenes por lotes a gran escala y sensible al costo: publicación masiva de imágenes de producto, ilustraciones para plataformas de contenido, borradores de preselección de materiales de marketing. En estos escenarios el valor de una sola solicitud es bajo y el volumen de llamadas es alto, por lo que la diferencia de costo por imagen se amplifica; la forma de facturación por imagen de seedream-5.0-lite/text-to-image encaja muy bien como candidato principal.
- Escenarios con alta tolerancia a una calidad de generación de "suficientemente buena": imágenes de borrador, miniaturas, visuales de relleno en páginas de listado, previsualizaciones internas.
- Proyectos tempranos que necesitan validar rápidamente la forma del producto: primero hacer funcionar la cadena, pulir los prompts y la lógica de negocio, y luego escalar a un modelo más potente según los resultados.
- Equipos que quieren evitar quedar atados a un único proveedor: desean un método de llamada unificado y que, al cambiar de modelo en el futuro, solo haya que modificar un identificador.
Se recomienda seguir esperando o elegir otro modelo:
- Escenarios de nivel producto final con requisitos estrictos de detalle, renderizado de texto o composición compleja.
- Escenarios que necesitan una concurrencia muy alta en poco tiempo y son sensibles a la variación de latencia: este tipo de necesidades requiere observar el comportamiento real de límites de tasa y cuotas, no solo el precio de lista.
- Equipos que ya tienen una canalización de generación de imágenes madura y cuyo modelo actual tanto en resultados como en costo está en un rango aceptable, donde el beneficio de cambiar no compensa el costo de migración.
Conclusión en una frase: trata a seedream-5.0-lite como el primer candidato para "generación de imágenes por lotes sensible al costo", no como la respuesta predeterminada para todos los escenarios.
Dimensiones de comparación: qué debe mirar un desarrollador al elegir un modelo de texto a imagen
No elijas un modelo por "qué imagen de ejemplo se ve mejor". Las siguientes seis dimensiones se pueden reutilizar directamente para comparar horizontalmente cualquier modelo de texto a imagen.
1. Costo por imagen (no el precio de lista)
El costo real es el "costo efectivo por imagen": precio de lista ÷ tasa de utilización. Si de cada diez imágenes de un modelo solo seis se pueden usar directamente y la otra mitad depende de reintentos, el costo real es muy superior al precio de lista. seedream-5.0-lite factura por imagen y la lógica de cálculo es directa: basta con multiplicar por la tasa de reintentos y la tasa de imágenes descartadas.
2. Concurrencia, latencia y límites de tasa
El cuello de botella de las tareas por lotes a menudo no es la calidad del modelo, sino el límite de tasa. Hay que preguntar con claridad: límite de solicitudes por segundo, comportamiento de la cola, tiempos de espera y forma de devolución de fallos. Esto afecta directamente cómo diseñar tu planificador de tareas.
3. Tamaños de salida y controlabilidad de parámetros
Relaciones de aspecto admitidas, niveles de resolución, si admite prompts negativos y qué parámetros de muestreo tienen efecto real. Cuando un tamaño no es compatible, solo puedes recortar o escalar después de generar, lo que equivale a un aumento oculto del costo.
4. Consistencia de estilo y reproducibilidad
Si se llama repetidamente con el mismo prompt, ¿qué tan grande es la diferencia entre imágenes generadas? ¿Se puede reproducir de forma estable mediante semillas fijas u otros medios? Para visuales de marca o materiales compuestos por varias imágenes, esta dimensión determina directamente la cantidad de retrabajo.
5. Cumplimiento y moderación de contenido
Política de moderación del lado del modelo, forma de devolución cuando se rechaza la generación y si tu lado de negocio necesita además una capa de filtrado. Esta parte suele pasarse por alto, pero puede convertirse de repente en un bloqueo después del lanzamiento.
6. Complejidad de integración
Método de autenticación, ecosistema de SDK, estructura de respuesta, diseño de códigos de error. Cuanto más compleja sea la integración, mayor será el costo hundido de cambiar de modelo después; este es también el punto central que se desarrollará en la siguiente sección.
Mirada horizontal a los precios: qué significa $0.035/imagen
La base de facturación de seedream-5.0-lite/text-to-image es facturación por imagen, 0.035 USD por imagen. La cifra en sí no es lo importante; lo importante es qué proporción ocupa dentro de la estructura de costos de tu negocio.
Convertir el precio de lista en costo efectivo
Costo efectivo por imagen ≈ precio de lista por imagen × (1 + tasa de reintentos) ÷ tasa de utilización.
Un ejemplo puramente lógico (no son datos reales de negocio): si en una canalización el 20% de las solicitudes requiere reintento y, además, el 25% de los resultados generados necesita rehacerse manualmente, entonces el costo de producir cada imagen utilizable es aproximadamente 1.6 veces el precio de lista. Por eso, al evaluar seedream-5.0-lite, no mires solo el 0.035; primero mide estas dos tasas en tu propia cadena.
Cuándo importa realmente la diferencia de costo
- Escenarios de baja frecuencia: decenas de imágenes al día; la diferencia de costo entre modelos es insignificante y en este caso deben priorizarse la calidad y la controlabilidad.
- Escenarios de frecuencia media-alta: de miles a decenas de miles al día; el costo empieza a entrar en un rango perceptible, pero aún debe calcularse junto con el costo laboral del retrabajo por calidad.
- Escenarios de generación por lotes: una vez que la producción diaria entra en la escala de cientos de miles de imágenes, la diferencia de costo por imagen se amplifica linealmente y, al mismo tiempo, la complejidad de los límites de tasa y la programación se convierte en un nuevo cuello de botella; en este momento la optimización de costos debe hacerse junto con el diseño de rendimiento, no mirando solo la cotización.
La propia base de facturación también es un factor de selección
La ventaja de la facturación por imagen es que el presupuesto es predecible: una solicitud corresponde a una imagen, el costo se corresponde linealmente con el volumen de negocio y es fácil hacer control de cuotas y medición del lado del usuario. En cambio, las modalidades que facturan por segundos de salida o por tokens requieren modelos de conversión adicionales. Si tu sistema de facturación necesita ser simple y explicable, la facturación por imagen resulta más cómoda.
Formas de integración: disyuntiva entre conexión directa y API agregadora
Hay dos caminos para integrar un modelo de texto a imagen: conectarse directamente al proveedor del modelo o llamar de forma unificada a través de una API agregadora. No es una relación pura de bueno o malo, pero para equipos que necesitan probar modelos con frecuencia, la disyuntiva es clara.
Conexión directa al proveedor del modelo
- Autenticación, SDK, códigos de error y políticas de límite de tasa son distintos en cada proveedor; cada nuevo modelo implica un conjunto adicional de credenciales y dependencias.
- La ventaja es que la cadena es la más corta y se obtienen de inmediato las capacidades exclusivas y las novedades de ese proveedor.
- La desventaja es el alto costo de cambio: una vez que el modelo queda escrito en el código de negocio, cambiar de modelo equivale a modificar toda la capa de integración.
Integración mediante API agregadora
- Dirección base, método de autenticación y estructura de respuesta unificados; los modelos se distinguen por un identificador de modelo. Cambiar de modelo normalmente solo requiere modificar un campo, sin reescribir la lógica de la solicitud.
- Con varios modelos coexistiendo, las pruebas A/B, el despliegue gradual y el enrutamiento por escenario son más fáciles de implementar: puedes hacer que los escenarios sensibles al precio usen seedream-5.0-lite y que los sensibles a la calidad usen otro modelo, compartiendo el mismo código de llamada.
- El costo es una capa adicional: hay que vigilar la disponibilidad de la propia capa agregadora y el ritmo de actualización de la cobertura de modelos.
Recomendaciones de ingeniería
Sea cual sea el camino, encapsula la llamada al modelo en tu propia capa de adaptación: define una estructura interna de solicitud unificada (prompt, tamaño, cantidad, parámetros opcionales) y una estructura de respuesta unificada (dirección o binario de la imagen, estado, motivo del error). Así, la capa agregadora será solo una implementación de la capa de adaptación y, en el futuro, tanto si cambias de agregador como si pasas a conexión directa, el código de negocio no se toca.
Para equipos que se preparan para una selección de modelos a gran escala, el valor más práctico del enfoque agregador es: degradar "qué modelo elegir" de decisión de arquitectura a decisión de configuración.
Cómo verificar diferencias al comparar horizontalmente con modelos similares
La comparación de imágenes de ejemplo casi no tiene valor para decidir: las plataformas eligen las que mejor se ven. El método de verificación ejecutable es construir tu propio conjunto de evaluación de muestra pequeña.
Primer paso: construir muestras con prompts reales de negocio
Extrae de 50 a 200 prompts reales de los registros en línea, cubriendo tus principales tipos de negocio (personas, productos, imágenes de escena, elementos de texto, etc.) y distribuyendo las cantidades según la proporción del negocio. No uses prompts bonitos de demostración.
Segundo paso: unificar variables
Todos los modelos con el mismo nivel de tamaño, la misma cantidad de imágenes y, en lo posible, los mismos parámetros de muestreo. Conclusiones comparativas con parámetros inconsistentes no tienen sentido. Llama a cada modelo con el mismo lote de prompts y en el mismo orden.
Tercer paso: definir métricas cuantificables
- Tasa de éxito de solicitudes: proporción de respuestas válidas, usada para calcular el costo de reintentos.
- Tasa de imágenes descartadas: proporción determinada manualmente como no utilizable; es un elemento clave en la fórmula de costo.
- Tiempo de selección manual: cuántos minutos de trabajo humano se necesitan por cada N imágenes utilizables. Suele pasarse por alto, pero a menudo cuesta más que el costo de API.
- Consistencia: si los resultados generados varias veces con el mismo prompt son estables.
Cuarto paso: A/B con poco tráfico
El conjunto de evaluación solo responde "si sirve"; el tráfico real es lo que responde "si vale la pena ir a plena escala". Dirige del 5% al 10% del tráfico en línea al nuevo modelo, ejecútalo durante un ciclo de negocio completo y compara métricas posteriores (clics de usuarios, volumen de tickets de retrabajo manual, número de alertas de fallo). La conclusión de este paso es más fiable que cualquier comparación offline.
Qué tener en cuenta al migrar desde un modelo existente
Casi todos los riesgos de la migración no están en "si la llamada funciona", sino en las diferencias de detalle. Alinea punto por punto los siguientes aspectos.
Adaptación del estilo de prompt
Las preferencias de prompt varían mucho entre modelos: algunos aceptan descripciones largas, otros son más sensibles a listas de palabras clave. No codifiques los prompts en el código de negocio; ponlos en una capa de configuración o plantillas para que, al migrar, se puedan reemplazar en bloque y comparar en paralelo, en lugar de cambiar cadenas por todo el repositorio.
Diferencias de parámetros y tamaños
Los nombres de los campos pueden variar y los rangos de valores también. Antes de migrar, confirma:
- La lista de relaciones de aspecto y niveles de resolución admitidos;
- Si los tamaños no admitidos devuelven error o se reescriben silenciosamente al valor más cercano;
- Los valores predeterminados de los parámetros de muestreo y si tienen efecto.
La reescritura silenciosa del tamaño es el problema más oculto: la llamada se realiza correctamente, pero la proporción de la imagen generada no es la correcta y la lógica de recorte posterior falla en cadena.
Estructura de respuesta y estados
¿La imagen se devuelve como URL o como binario? ¿La URL tiene caducidad? ¿Con qué estados se expresan la generación en curso y el fallo? Trata por separado las cuatro situaciones "llamada exitosa", "generación en curso", "contenido rechazado" y "error del servidor"; no las metas todas en un único try-catch.
Códigos de error y estrategia de reintentos
Qué errores merecen reintento (límite de tasa, fallos transitorios) y cuáles no (rechazo por moderación de contenido, parámetros inválidos). Reintentar casos que no deberían reintentarse equivale a pagar dos veces. Además, añade retroceso exponencial y un límite máximo a los reintentos.
Diseño de claves de caché y almacenamiento de materiales
La clave de caché debe incluir el identificador del modelo y los parámetros clave; de lo contrario, tras la migración se acertará por error la caché antigua y parecerá que "el nuevo modelo no ha cambiado los resultados". Nombra las rutas en el almacenamiento de objetos con un prefijo de modelo separado para facilitar la comparación y la reversión.
Pasos del cambio gradual
- Añadir en la capa de adaptación la implementación del nuevo modelo sin tocar el código de negocio;
- Hacerlo funcionar en el entorno interno y confirmar la estructura de respuesta y las ramas de error;
- Desplegar gradualmente con una proporción pequeña de tráfico y observar la tasa de éxito y las métricas posteriores;
- Mantener el modelo antiguo como ruta de reversión durante al menos un ciclo de negocio completo;
- Cuando las métricas cumplan los objetivos, establecer el nuevo modelo como predeterminado y degradar la ruta antigua a respaldo.
Lista de selección y recomendaciones de implementación
Por último, condensamos todo en una lista que se puede ir marcando punto por punto.
Antes de la integración
- Definir el posicionamiento de negocio de esta cadena: ¿es borrador por lotes o salida de nivel producto final?
- Medir la tasa de éxito de solicitudes y la tasa de imágenes descartadas de la cadena actual para calcular la línea base de costo efectivo por imagen.
- Extraer de los registros en línea un conjunto de muestras de prompts reales que cubra los principales tipos de negocio.
- Confirmar si los tamaños y parámetros admitidos por seedream-5.0-lite/text-to-image cubren tus necesidades.
Durante la integración
- Añadir una capa de adaptación entre el negocio y el modelo; prompts, parámetros y estructura de respuesta no deben estar codificados de forma rígida.
- Unificar autenticación y dirección base, pasando el modelo solo como identificador para dejar espacio a futuros cambios.
- Distinguir errores reintentables y no reintentables, con estrategia de reintentos con retroceso y límite máximo.
- Incluir en la clave de caché el identificador del modelo y los parámetros clave.
Después del lanzamiento
- Ejecutar A/B con poco tráfico durante un ciclo de negocio completo antes de decidir si ir a plena escala.
- Monitorizar tres métricas: tasa de éxito, tasa de imágenes descartadas y volumen de tickets de retrabajo manual.
- Mantener la ruta de reversión hasta que las métricas del nuevo modelo se estabilicen.
- Cuando crezca el volumen de llamadas, reevaluar el rendimiento y la estructura de costos en lugar de reutilizar conclusiones antiguas.
El valor de seedream-5.0-lite/text-to-image está en llevar el gasto por imagen de "generación de imágenes por lotes sensible al costo" a una posición donde el presupuesto es fácil de elaborar; pero la conclusión real de selección deben darla tu propio conjunto de muestras y el tráfico real. Con el modelo integrado detrás de una capa de adaptación unificada, puedes cambiar la respuesta en cualquier momento sin reescribir el negocio.
Artículos relacionados
Ver todos los artículos →-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Comparativa
Comparativa horizontal de Seedream 5.0 Pro image-to-image: capacidades, precios y recomendaciones de selección