
Black Forest Labs
FLUX 3 Image Klein
flux-3-image-klein
Essayer flux-3-image-klein
Entrée
Créations
Voir toutes les créationsSortie
image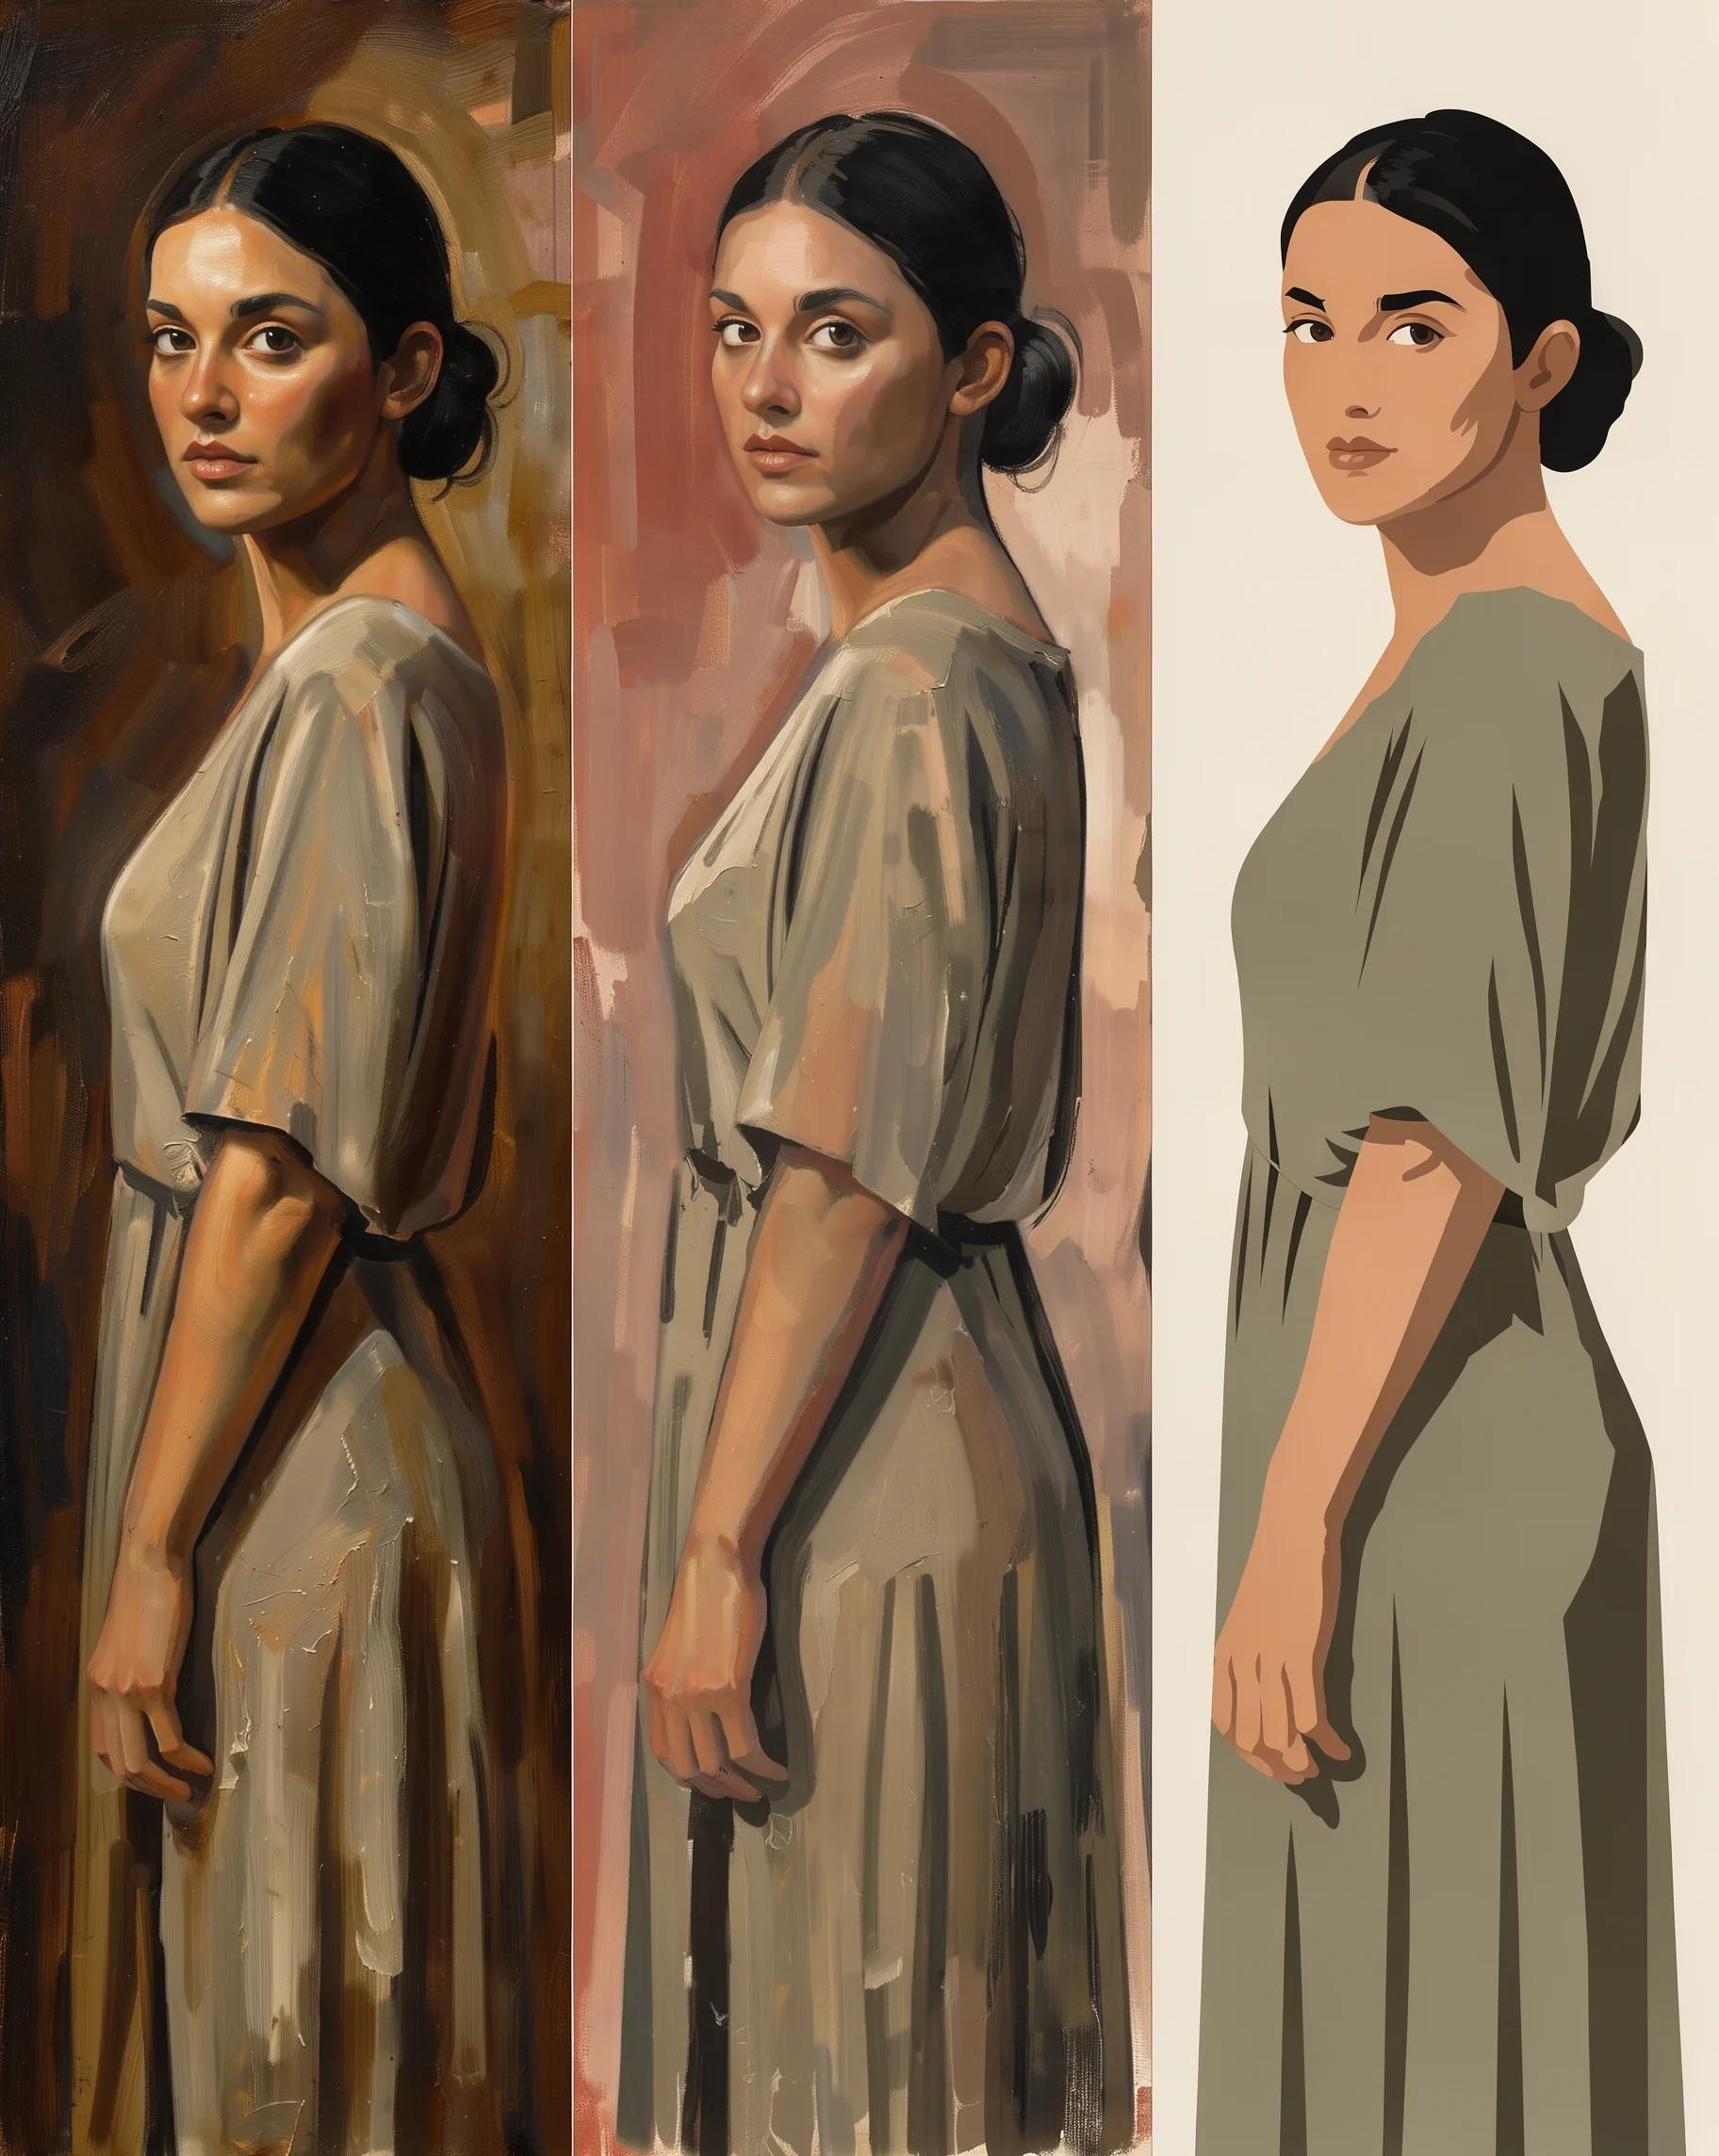
La même femme · Évolution stylistique en trois panneaux, de la peinture à l'huile réaliste à l'illustration plate
Style Évolution du style · Portrait et photographie · Illustration plate
Prompt
Présenter dans une seule image une composition en triptyque : la même jeune femme, debout de profil, tourne la tête et regarde par-dessus son épaule ; elle est répétée trois fois côte à côte, avec une pose et un cadrage presque identiques. Le panneau de gauche est une peinture à l'huile réaliste riche en texture, aux carnations finement nuancées, au clair-obscur doux, avec des touches épaisses visibles sur les plis des tissus et un fond aux tons chauds et profonds. Le panneau central glisse vers une peinture moderne semi-abstraite : le même personnage est construit par de plus larges aplats de couleur, les détails du visage sont simplifiés, les touches plus libres, dans une gamme de tons terreux désaturés. Le panneau de droite devient une illustration vectorielle entièrement plate : le personnage est réduit à des formes aux couleurs unies et nettes, sans ombres ni textures, sur un fond uni n'utilisant que deux ou trois couleurs saturées. La progression d'un style réaliste texturé vers un style graphique plat se lit clairement sur l'ensemble de la disposition horizontale.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
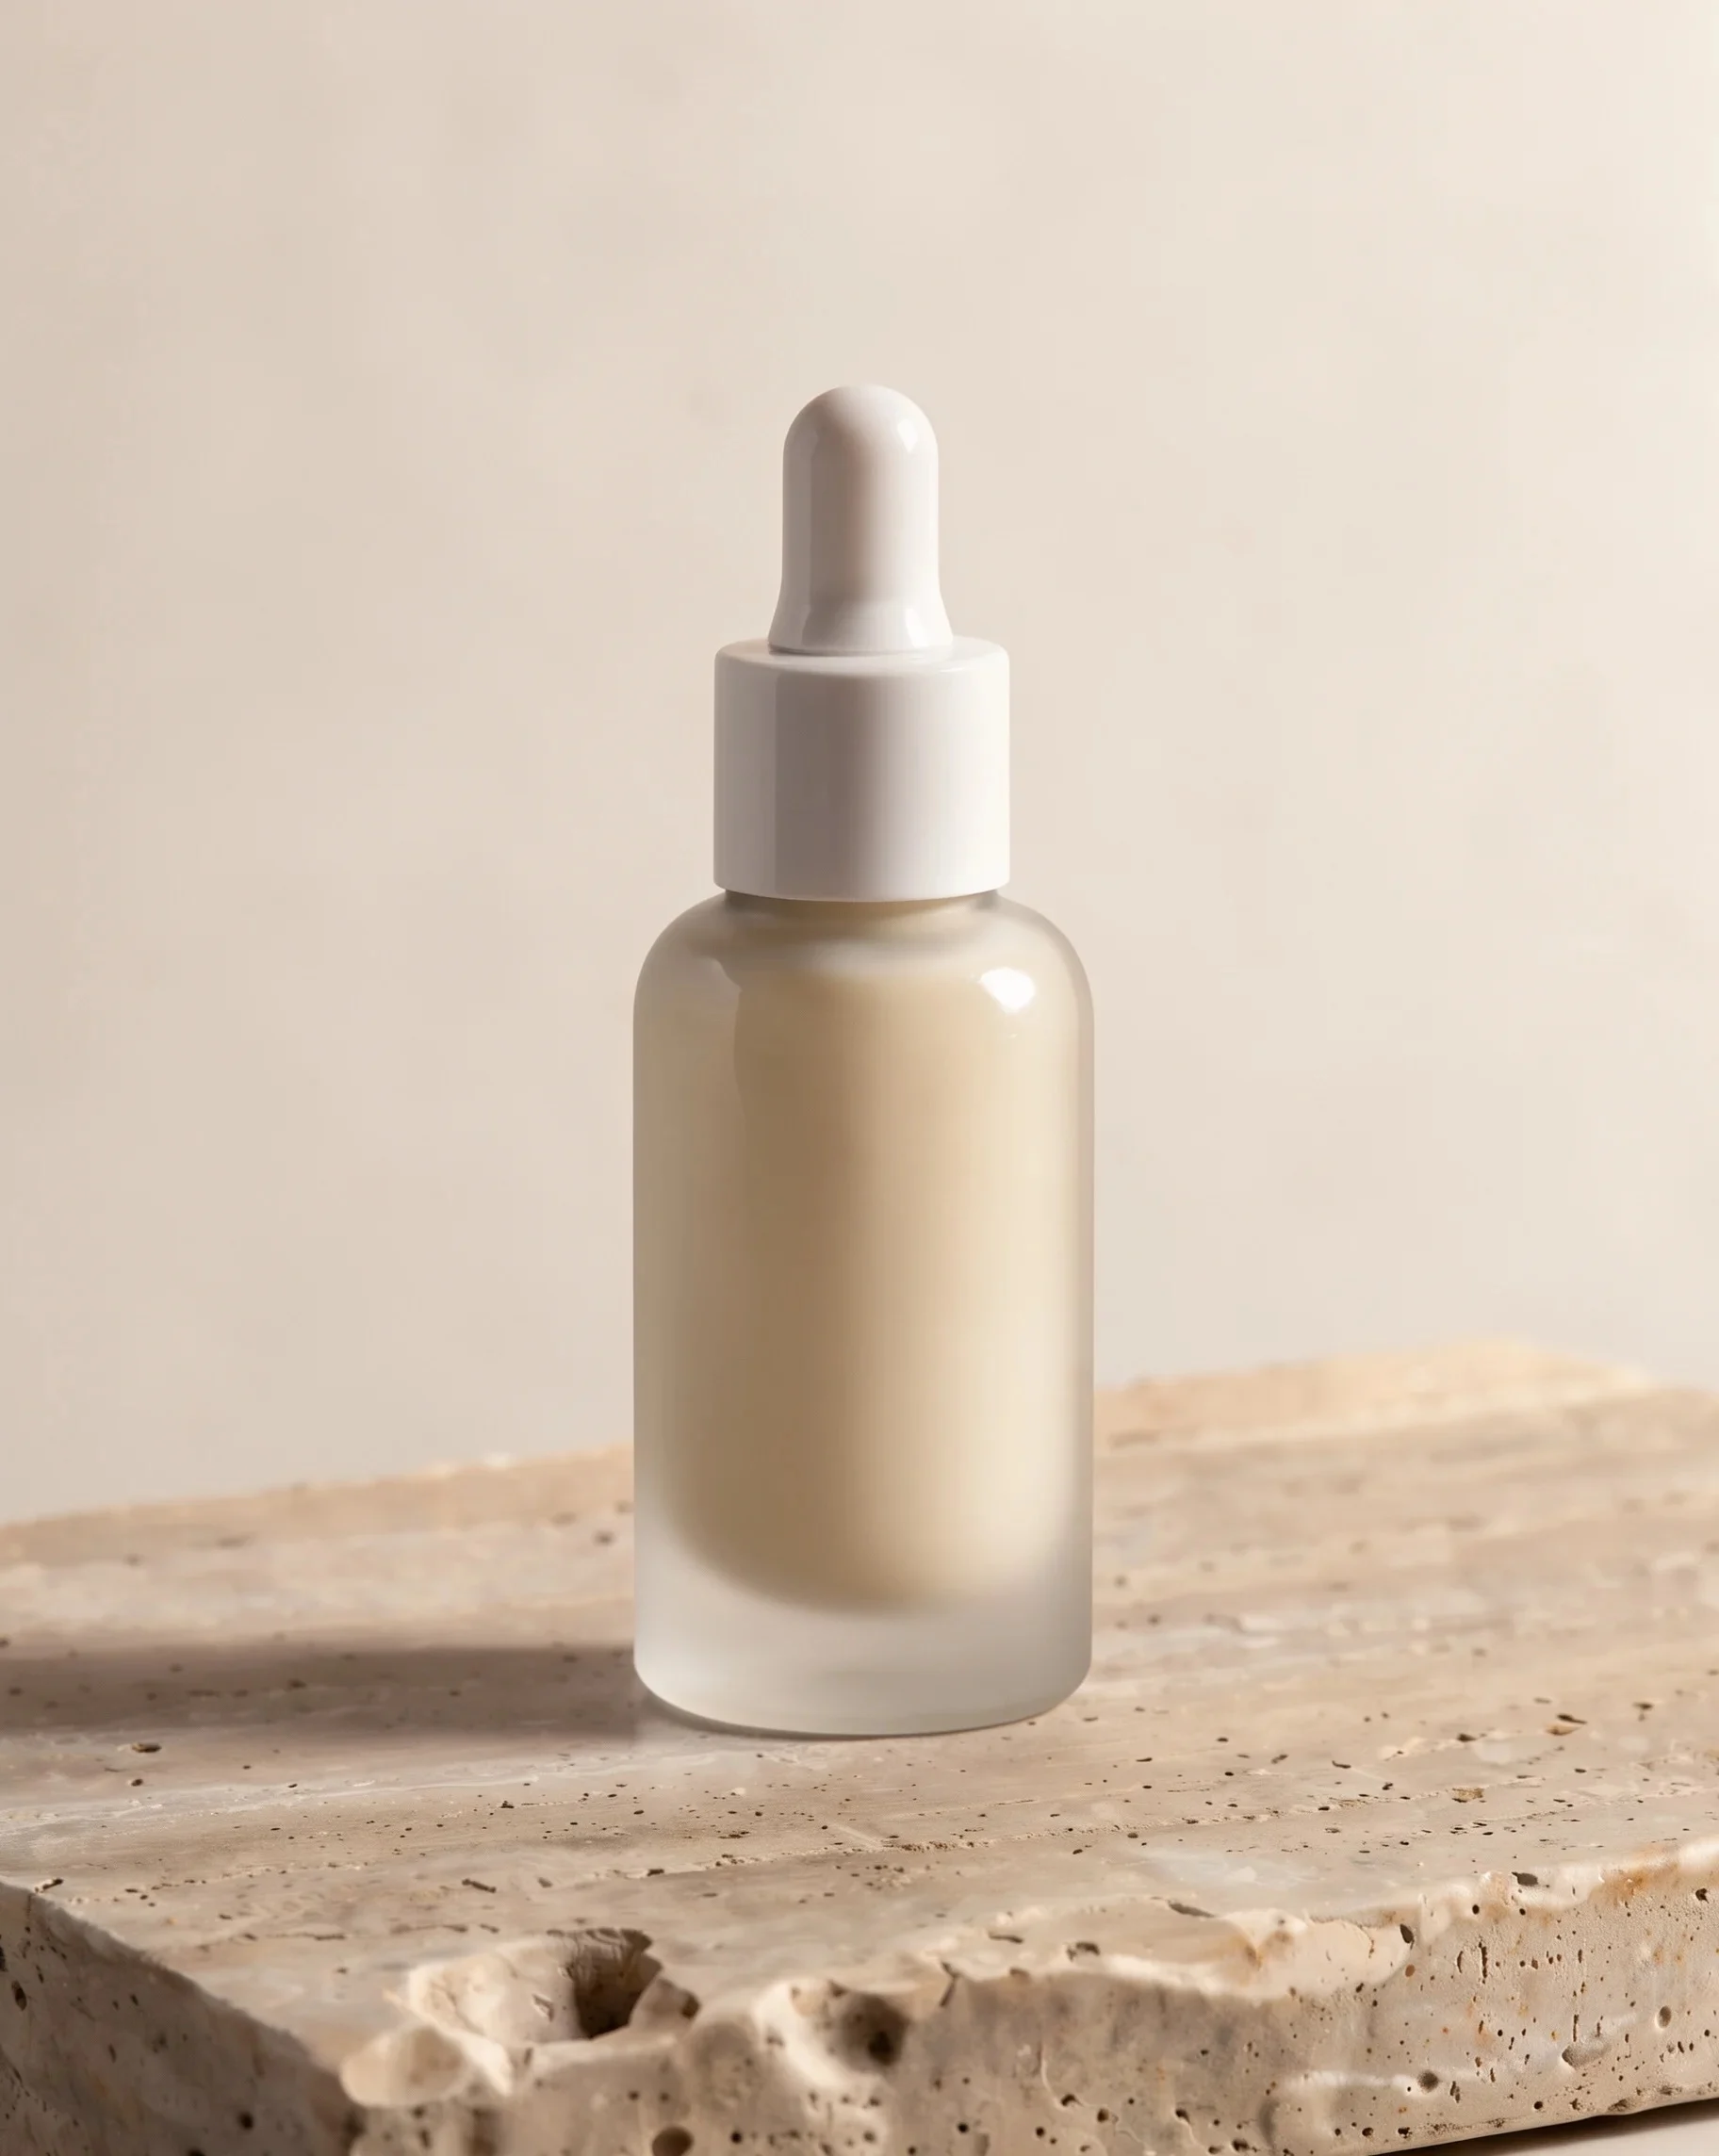
Flacon de sérum en verre dépoli sur un plateau en travertin
Style Image produit · Nature morte · minimal
Prompt
Un flacon de sérum de soin pour la peau en verre dépoli, muni d'un compte-gouttes à capuchon blanc mat, se tient debout sur une dalle de travertin beige dont la surface montre des pores fins et de douces stries horizontales. L'arrière-plan est un fond sans couture blanc ivoire aux tons chauds, avec un large espace vide autour du flacon. Une lumière directionnelle douce venant de la droite supérieure rase la surface dépoli, révélant une texture translucide blanc laiteux et chaleureuse ainsi qu'une transition progressive du reflet brillant à l'ombre ; une ombre courte et diffuse se projette sur la dalle. De légers reflets apparaissent sur les épaules du flacon en verre, les bords sont nets et précis, la texture des matériaux est réaliste, la palette générale est un camaïeu neutre et apaisé de crème, de sable et de gris chaud clair : photographie de nature morte de cosmétique haut de gamme.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
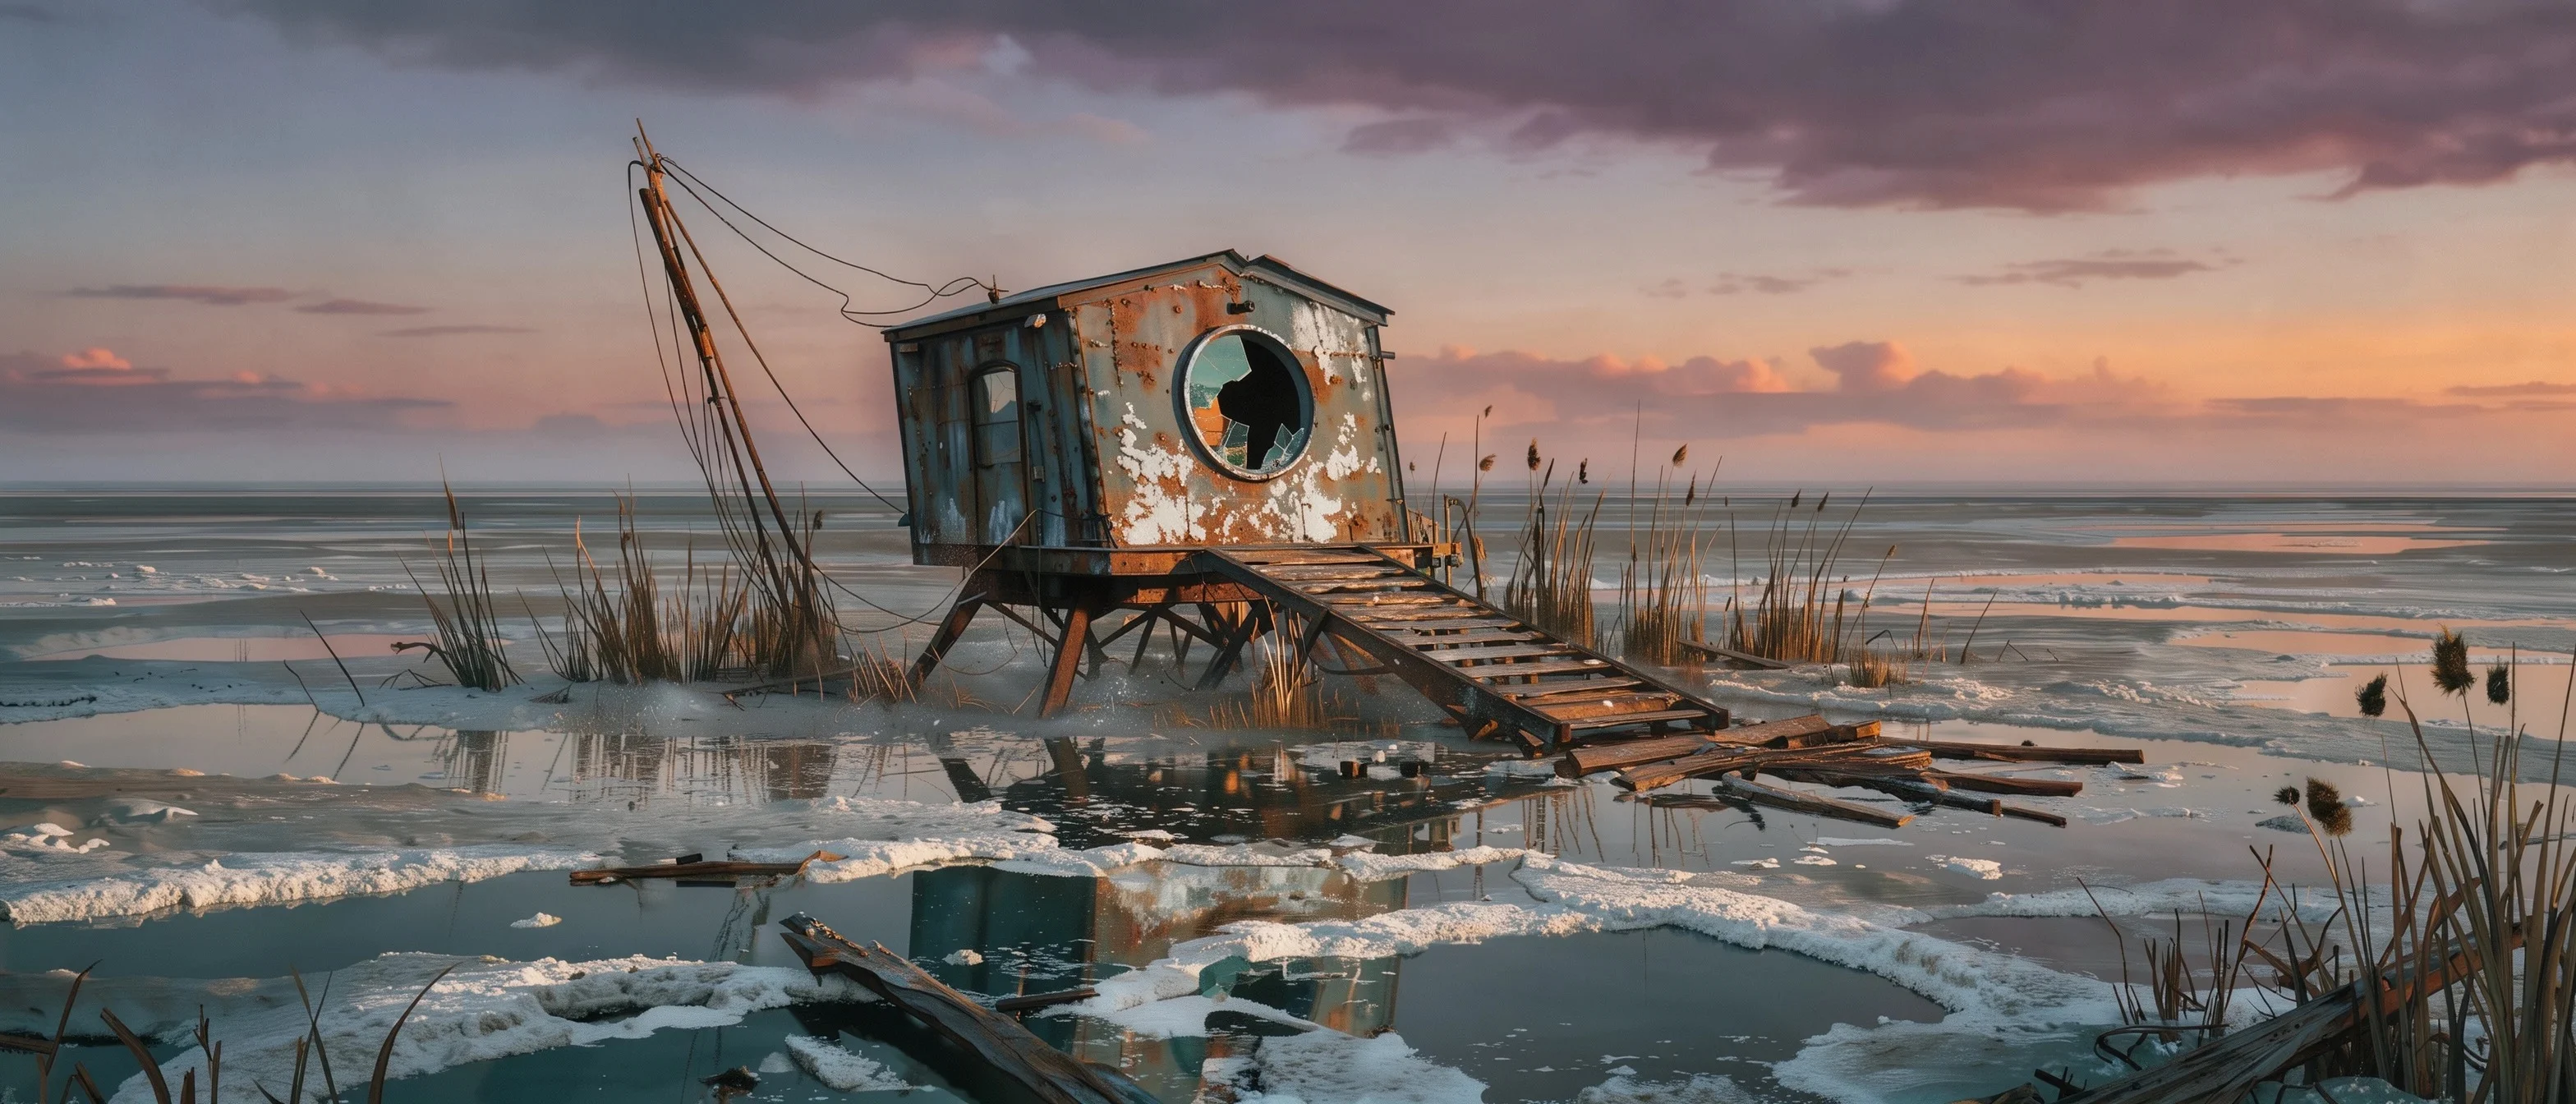
Marais salants au crépuscule · Vue lointaine d'une station d'observation des marées abandonnée
Style Art conceptuel · Construction de l'univers · plan large
Prompt
Au crépuscule, un plan panoramique cinématographique au format large d'une station d'observation des marées abandonnée, solitaire au milieu d'un vaste marais salant. La station est une structure basse et légèrement inclinée, faite de pieds en acier rouillés et de panneaux corrodés couverts d'une croûte de sel blanche ; sa fenêtre d'observation circulaire s'ouvre vers la mer au loin, et une passerelle en bois endommagée s'avance dans l'eau peu profonde. Autour, des étendues de sel pâles et des mares de marée sombres reflètent le ciel ; de nuages bas s'embrasent d'orange à l'horizon et passent au violet au-dessus de nos têtes. Des roseaux secs épars, un mât météorologique penché, de fins câbles d'antenne. Un crépuscule doux rase le métal corrodé, une fine poussière de sel flotte dans l'air, et la brume marine lointaine comprime l'horizon. Une palette douce de cyan-vert et de rouille contraste avec le ciel chaud, rendu de concept art pictural, avec des détails matériels nets, composition large 21:9, la station petite et centrée au milieu de la vaste zone humide.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
flux-3-image-klein per image
| Spécifications | Prix unitaire |
|---|---|
| 768 | $0.0092 |
| 1K | $0.0103 |
| 1.5K | $0.0126 |
| 2K | $0.016 |
| 4K | $0.0412 |
Présentation
Il s'agit d'un modèle destiné aux scénarios de génération et d'édition d'images, capable de générer une image à partir d'un simple prompt, mais aussi de modifier ou de composer une scène selon des instructions à partir d'une image de référence fournie. L'entrée peut contenir jusqu'à 10 images de référence, et des balises associées à des cadres de délimitation peuvent décrire la mise en page et les zones locales. La sortie est une image statique, avec des paliers de 768 à 4K pixels et divers formats horizontaux et verticaux. Il convient aux développeurs et aux équipes de design ayant besoin de produire des visuels en série, d'assurer la continuité de style d'une image de référence ou de contrôler la mise en page.
Points clés
- Génération texte-image et édition par image de référence réunies — le même modèle accepte aussi bien la génération à partir d'un prompt seul que la modification et la composition à partir d'images de référence accompagnées d'instructions.
- Combinaison de jusqu'à dix images de référence — une requête peut transmettre plusieurs images de référence, pour une composition multi-images ou pour attribuer à différentes images des rôles de sujet et de style distincts.
- Paliers de sortie jusqu'à 4K — la résolution se choisit parmi 768, 1K, 1,5K, 2K et 4K, la largeur et la hauteur variant selon le rapport d'image sélectionné.
- Contrôle de la mise en page par cadres de délimitation — dans le prompt, des balises associées à un JSON de cadres de délimitation permettent de préciser la position des éléments et d'éditer des zones locales.
Description des capacités
Génération d'images à partir d'un prompt seul : il suffit de soumettre un prompt pour produire une image, le prompt pouvant atteindre 5000 caractères ; sans image de référence, on est en mode texte-image, adapté à la construction d'une scène à partir de zéro.
Édition par instructions sur image de référence : en transmettant une image de référence et en précisant dans le prompt les éléments à modifier et ceux à conserver, il est possible d'ajuster de manière ciblée la scène ; jusqu'à 10 images de référence.
Images de référence multiples et contrôle de la mise en page : plusieurs images de référence peuvent assumer respectivement les rôles de sujet, de style ou de composition, et des balises associées à un JSON de cadres de délimitation précisent le placement des éléments, ce qui facilite l'organisation de scènes complexes.
Choix du format d'image et du format de fichier : le rapport d'image peut être choisi parmi de nombreux cadrages horizontaux et verticaux allant de 21:9 à 9:21, ou en mode automatique ; le format de sortie est jpeg ou png.
Nombre de pas et graine aléatoire réglables : le nombre de pas de diffusion est réglable de 1 à 16 ; un nombre de pas plus faible génère plus vite mais peut réduire les détails ; spécifier une graine de 0 à 4294967295 permet de reproduire autant que possible le résultat obtenu avec les mêmes paramètres.
Cas d'usage
- Retouche de visuels pour le e-commerce et le marketing — les opérateurs téléversent une image de référence de produit avec des instructions de modification et obtiennent une image principale ou une variante ajustée, pour les pages de détail produit et les emplacements de visuels d'campagne.
- Composition de styles à partir de plusieurs images de référence — les designers transmettent une image de sujet et une image de référence de style pour composer un visuel à l'identité cohérente, destiné aux visuels de marque et aux illustrations pour les réseaux sociaux.
- Génération d'affiches avec contrôle de la mise en page — les équipes marketing utilisent un prompt accompagné de cadres de délimitation pour décrire la position du titre et des éléments, et produisent des visuels publicitaires horizontaux ou verticaux, pour la diffusion et l'aperçu avant impression.
- Production de visuels finaux haute résolution — les équipes de contenu choisissent le palier 2K ou 4K pour générer des visuels finaux, destinés aux pages de présentation et aux supports nécessitant des dimensions en pixels élevées.
- Validation rapide de prototypes d'images en série — les développeurs génèrent rapidement plusieurs séries d'esquisses avec une graine fixe et un faible nombre de pas, pour filtrer les directions créatives et comparer les premières propositions.
Limites et conseils de sélection
Le prompt d'entrée doit comporter de 1 à 5000 caractères, les images de référence doivent être des liens d'image http ou https accessibles, dans la limite de 10. Pour chaque requête, la résolution, le rapport d'image et le format de sortie sont des réglages à choix unique. Le nombre de pas de diffusion est limité à 16 ; un nombre de pas plus faible peut réduire les détails. Les paliers de résolution décrivent le niveau de pixels en sortie, la largeur et la hauteur concrètes variant selon le format d'image. La graine sert uniquement à reproduire autant que possible le résultat obtenu avec les mêmes paramètres, sans garantie d'identité parfaite ; la tolérance de sécurité du contenu va de 0 à 4, 0 étant le plus strict.
Nouveautés
Voir le journal des modifications →- Nouveau modèle Nouveau modèle disponible : FLUX 3 Image Klein
Questions fréquentes
Voir toutes les questions →-
Pourquoi un prompt court produit-il des images si vagues ?
Un prompt court contient trop peu d'informations : le modèle ne peut que compléter selon les interprétations courantes, ce qui donne des résultats vagues. Rédiger le prompt sous forme de description complète est bien plus stable : ① sujet et détails d'apparence ② scène et environnement ③ lumière et tonalité ④ composition et point de vue ⑤ style et exigences de qualité d'image. Le prompt est limité à 5000 caractères, largement suffisant pour tout détailler point par point.
-
Comment basculer entre la génération texte-vers-image et l'édition d'image ?
Le même modèle offre deux usages, la seule différence étant la présence ou non d'une image de référence. Omettre image_urls correspond à la génération texte-vers-image, qui génère uniquement à partir du prompt ; fournir image_urls bascule vers une édition par instruction, et le prompt doit alors préciser clairement quelles parties de l'image de référence doivent être modifiées et lesquelles doivent être conservées. Lors de l'édition, il est recommandé d'énumérer une par une les zones à modifier et l'effet souhaité, plutôt que d'écrire une seule phrase sur le style global.
-
Combien d'images de référence puis-je utiliser au maximum ?
image_urls accepte au maximum 10 images et au minimum 1 ; dès qu'une image de référence est fournie, le mode édition ou composition multi-références est activé. Il faut préciser le rôle de chaque image dans le prompt, par exemple la première est le personnage, la deuxième le produit, la troisième le style d'arrière-plan. Cette limite convient aux scénarios de composition nécessitant une cohérence des personnages ou des produits entre les images.
-
Comment contrôler la mise en page ?
Utilisez les balises du prompt accompagnées d'un JSON bbox pour spécifier la position des éléments. Dans le prompt, écrivez des espaces réservés de la forme <balise> et joignez le JSON de boîte englobante correspondant, en indiquant dans quelle zone placer chaque élément, puis écrivez la description concrète dans le contenu associé à la balise. Cela convient aux images comme les affiches ou les bannières qui nécessitent des positions de mise en page fixes.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : flux-3-image-klein
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour flux-3-image-klein et la route default — voir le tableau des paramètres ci-dessous.
seedintegerOptionnelmin 0max 4294967295Graine aléatoire, utilisée pour reproduire autant que possible le même résultat avec les mêmes paramètres ; valeur entière, générée aléatoirement si omise.
stepsintegerOptionnelDéfaut: 16min 1max 16Nombre d'étapes de diffusion, valeur de 1 à 16, par défaut 16 ; plus la valeur est faible, plus la génération est rapide, les détails peuvent être réduits, sans impact sur le prix.
promptstringRequisminLength 1maxLength 5000Décrit l'image à générer, ou précise les éléments à modifier et à conserver dans l'image de référence ; peut être combiné avec <标签> et un JSON bbox pour spécifier la mise en page et les zones d'édition locales.
image_urlsarrayOptionnelminItems 1maxItems 10Tableau d'images de référence, dont chaque élément est une adresse d'image ; il faut préciser dans le prompt le sujet, le style ou le rôle de composition de chaque image, l'omettre équivaut à une génération texte-image.
Array [ string ]
resolutionstringOptionnelDéfaut: "1K"Niveau de pixels de sortie, la largeur et la hauteur varient selon le format ; par défaut 1K.
7681K1.5K2K4Kaspect_ratiostringOptionnelDéfaut: "auto"Format de sortie, paysage, portrait ou carré possible ; par défaut auto, le mode automatique détermine le format selon le prompt et les images de référence.
21:92:116:93:27:54:35:41:1Tout afficher (8)Afficher moins
4:53:45:72:39:161:29:21autooutput_formatstringOptionnelDéfaut: "jpeg"Format de l'image de sortie, par défaut jpeg.
jpegpngsafety_toleranceintegerOptionnelDéfaut: 2min 0max 4Tolérance de sécurité du contenu, valeur entière, 0 étant le plus strict ; par défaut 2.
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-3-image-klein",
  "input": {
    "steps": 16,
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "auto",
    "output_format": "jpeg",
    "safety_tolerance": 2
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-3-image-klein",
input: {
"steps": 16,
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto",
"output_format": "jpeg",
"safety_tolerance": 2
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-3-image-klein",
"input": {
"steps": 16,
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto",
"output_format": "jpeg",
"safety_tolerance": 2
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →
Modèles associés
Voir tous les modèles →Même type
-
 Nano Banana 2 Google $0.018 /image
-
 Ideogram V4.5 Ideogram $0.011 /image
-
 Seedream 5.0 ByteDance $0.025 /image
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /image
-
 Recraft Creative Upscale Recraft $0.357 /image
-
 Krea 3 Krea $0.036 /image
-
 FLUX.2 Black Forest Labs $0.035 /image
-
 BRIA Product Shot Bria $0.058 /image
-
 FIBO 2.0 Bria $0.057 /image
-
 Z-Image Alibaba $0.008 /image
-
 FIBO 1.5 Bria $0.058 /image
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /image
Même fournisseur
- FLUX.2 Klein 4B Black Forest Labs $0.0004 /image
- FLUX.1 Fill Pro Black Forest Labs $0.071 /image
-
 FLUX 3 Video Black Forest Labs $0.090 /seconde
-
 FLUX 3 Max Black Forest Labs $0.121 /seconde
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /image
- FLUX.2 Black Forest Labs $0.035 /image
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /image
-
 FLUX.1 Schnell Black Forest Labs $0.005 /image
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /image
-
 FLUX 3 Image Black Forest Labs $0.041 /image