
Guida all'uso
Estrazione strutturata con GLM 5.3 in pratica: dare a ogni campo JSON una base nel testo originale
Estrarre campi con la modalità JSON object, affidandosi a valori mancanti, citazioni e validazione di business per fermare gli errori prima dell'inserimento nel database

In questa pagina
Perché anche l'output strutturato ha bisogno di una "base nel testo originale"
La modalità JSON object (response_format: {"type": "json_object"}) risolve il problema di «se la forma dell'output è un oggetto JSON», non quello di «se questa richiesta andrà a buon fine, se il contenuto sarà completo, se il parsing non solleverà eccezioni». La richiesta può fallire, il modello può rifiutarsi di rispondere, l'output può essere troncato per limiti di lunghezza, lo streaming può interrompersi, il contenuto restituito può essere incompleto o malformato; il client deve gestire queste situazioni e le eccezioni di json.loads. Bisogna prima accertarsi che la risposta sia completata correttamente e che il contenuto sia integro, poi passare al parsing. Riuscire a fare il parsing non significa poter usare il risultato: un formato corretto non implica correttezza fattuale. Che il valore di un campo sia stato estratto dal testo originale, che non sia stato completato d'ufficio dal modello, e se un campo significhi «il testo originale non lo dice» oppure «il testo originale dice vuoto», tutto questo non rientra nella copertura dei vincoli di formato.
Scrivere un modello di campi nel prompt significa in sostanza dare al modello un «modulo da compilare», non un «elenco di prove». Quando un campo manca di supporto nel testo originale, il modello tende a fornire un valore apparentemente ragionevole: è la modalità di fallimento più pericolosa nei compiti di estrazione, perché non genera errori, ma inquina silenziosamente i dati a valle.
Per questo il contratto di estrazione di questo articolo è composto da tre parti: definizione dei campi e dei tipi, citazione dal testo originale associata a ogni valore, e modellazione esplicita dei valori mancanti. Insieme fanno sì che «da dove viene questa frase» diventi parte dell'output, invece di una congettura a posteriori.
Progettare il contratto di estrazione: campi, tipi e convenzioni sulla nullabilità
Il contratto parte dall'elenco dei campi. Supponiamo che il compito sia estrarre informazioni strutturate da una descrizione di offerta di lavoro/collaborazione; per prima cosa fissiamo i campi obiettivo:
title: stringa, obbligatoriobudget: numero, annullabiledeadline: stringa (data ISO), annullabilecontact: stringa, annullabileskills: array di stringhe, può essere un array vuoto
Il punto chiave è che «annullabile» non significa «si può omettere». La convenzione è che ogni campo deve comparire nell'output e, quando sconosciuto, si dia esplicitamente null o un array vuoto; non è consentito omettere le chiavi. Omettere una chiave impedisce a valle di distinguere «il modello ha giudicato vuoto» da «il modello non ha affatto gestito questo campo».
Sul piano dei tipi bisogna inoltre restringere a una granularità verificabile dalla macchina: budget accetta solo numeri, non stringhe come "da concordare"; deadline segue il formato YYYY-MM-DD; skills deve essere un array di stringhe, non è ammessa un'unica stringa con valori separati da virgole per cavarsela. Più i tipi sono specifici, più lo strato di validazione descritto sotto riuscirà a fermare i problemi.
Il blocco seguente è la descrizione dei campi da scrivere nel prompt, non parametri della richiesta; i parametri della richiesta servono solo ad attivare la modalità JSON object.
Restituisci un oggetto JSON che contenga ed esclusivamente i seguenti campi:
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
Tutte le chiavi devono essere presenti. Quando non è determinabile dal testo originale, inserisci null (per gli array un array vuoto), non tirare a indovinare.
Associare a ogni campo il frammento citato
Dare solo il valore senza la fonte equivale a rinunciare alla tracciabilità. Il metodo consiste nel trasformare ogni campo estraibile in una struttura a coppie: valore e citazione emessi insieme.
{
  "title": {"value": "Tirocinante in analisi dati", "evidence": "Cerchiamo 2 tirocinanti in analisi dati"},
  "budget": {"value": 300, "evidence": "300 yuan al giorno"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "Inviare il curriculum a hr@example.com"},
  "skills": [
    {"value": "SQL", "evidence": "È richiesta familiarità con SQL"},
    {"value": "Python", "evidence": "La conoscenza di Python è preferenziale"}
  ]
}
Alcuni punti importanti. Primo, evidence deve essere un frammento continuo del testo originale, non una parafrasi o un riassunto del modello: la parafrasi fa perdere alla citazione il valore di confronto. Secondo, quando il valore è null anche evidence deve essere null; questo vincolo di per sé contiene una parte delle invenzioni: se il modello inventa un valore, di solito non riesce a inventare il frammento corrispondente nel testo originale, e il formato diventa autocontraddittorio. Terzo, i campi array forniscono una citazione per elemento, non una citazione unica per l'intero array, altrimenti un elemento errato inquina la credibilità di tutto il gruppo. Quarto, i frammenti citati devono essere il più brevi possibile, coprendo solo il testo minimo che sostiene il valore, per agevolare il successivo confronto per inclusione di stringhe.
L'output diventa così più voluminoso, ma in cambio ogni record inserito nel database può rispondere alla domanda «su quale frase del testo originale si basa questo campo».
Gestire esplicitamente valori mancanti e incertezza
Nei compiti di estrazione l'errore più frequente del modello non è estrarre male, ma «completare». Bisogna modellare separatamente a livello di contratto tre situazioni.
Mancanza. Il testo originale non contiene informazioni pertinenti; il campo va impostato a null. Questa semantica va distinta da «valore stringa vuota»: la stringa vuota è un valore estratto, null è un valore non estraibile. Se la convenzione a monte è chiara, a valle si può decidere se saltare o segnalare.
Ambiguità. Il testo originale contiene un'espressione pertinente ma insufficiente a determinare il valore. Per esempio se c'è solo «stipendio da concordare», budget deve essere null, e nel prompt va specificato chiaramente: non convertire descrizioni qualitative in numeri e non mappare «da concordare» su 0.
Molteplici candidati. Il testo originale presenta due recapiti o due date, mentre il contratto accetta un solo valore. In tal caso le opzioni sono far supportare alla struttura del campo un elenco di candidati, oppure stabilire nel prompt una priorità (ad esempio prendere il primo che compare). Qualunque si scelga, va scritto nel contratto; altrimenti la strategia di scelta del modello può variare ogni volta e i risultati diventano difficilmente riproducibili.
Aggiungiamo una rete di sicurezza: consentire al modello di produrre un array unresolved che elenchi le informazioni chiave che non riesce a ricondurre a nessun campo. È molto più sicuro che forzarle dentro un campo qualsiasi e ti offre anche un punto di osservazione sulle modalità di fallimento del modello.
Tre livelli di validazione di business prima dell'inserimento nel database
La modalità JSON object vincola solo la forma dell'output; il parsing può comunque fallire. La validazione si esegue in ordine: prima si accerta l'integrità della risposta, poi si eseguono le validazioni strutturali e di business lato client, infine la verifica delle citazioni; se un livello non passa, non si procede al successivo.
Prima del parsing si controlla: se la richiesta è stata restituita correttamente, se c'è stato un rifiuto, se il motivo di conclusione indica un troncamento per lunghezza, se la risposta in streaming è terminata correttamente, se il contenuto è vuoto. Dopo aver accertato che la risposta è completata correttamente e che il contenuto è integro, si esegue json.loads; un'eccezione di parsing porta direttamente alla gestione del fallimento, senza inviare contenuti parziali alle validazioni successive. Solo dopo il successo del parsing si entra nei tre livelli di validazione seguenti.
Primo livello: tipi e struttura
Se le chiavi sono complete, se i tipi corrispondono, se deadline rispetta il formato data, se budget è un numero finito. Questo livello si implementa con codice normale, ha basso costo e il più alto tasso di intercettazione.
Secondo livello: enumerazioni e domini di valore
Si bloccano i valori impossibili a livello di business: importi negativi, date precedenti a oggi, stringhe vuote o duplicati in skills, lunghezze di stringa oltre il limite del campo. Se il campo ha un vocabolario controllato (come settore, livello professionale), qui si fa il matching con la whitelist, riservando un punto per la normalizzazione dei sinonimi.
Terzo livello: coerenza tra campi
La validità di un singolo campo non implica che l'intero record sia valido. I controlli tipici includono: se budget non è nullo, anche deadline è non nulla (in molti scenari di business i due sono legati), se contact contraddice il tipo di posizione suggerito da skills, se nello stesso lotto la distribuzione dei campi dei record con lo stesso title è anormalmente concentrata. Questo livello è il più vicino alla semantica di business ed è quello che richiede più test.
Non dimenticare di eseguire una verifica meccanica su evidence: quando il valore non è nullo, evidence deve essere non nullo e deve poter essere trovato nel testo originale in input tramite inclusione di stringhe o matching fuzzy. Un mancato riscontro non deve necessariamente portare allo scarto immediato, ma almeno va marcato come bassa confidenza e inserito in una coda per la revisione manuale.
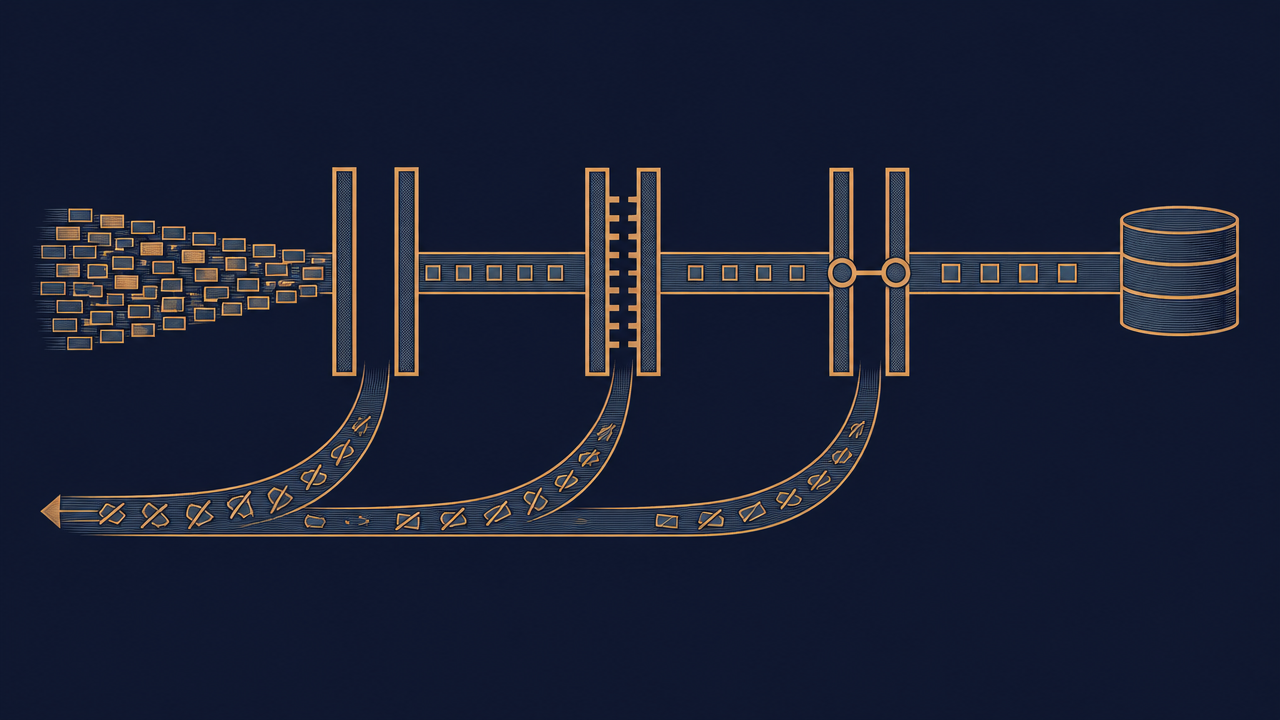
Trasformare i fallimenti di validazione nel prompt del turno successivo
Dopo un fallimento di validazione la cosa peggiore è rinviare la richiesta tale e quale sperando che questa volta estragga bene. Meglio reimmettere in modo strutturato il motivo del fallimento:
L'output precedente non ha superato la validazione:
- il valore di deadline "al più presto" non rispetta il formato YYYY-MM-DD
- l'evidence di skills[2] non è stato trovato nel testo originale
Correggi solo i problemi sopra indicati, lascia invariati gli altri campi e restituisci nuovamente il JSON completo.
Tre dettagli meritano attenzione. Primo, il messaggio di errore deve indicare il percorso specifico del campo, così il modello può fare una correzione locale invece di ricominciare da capo. Secondo, va richiesto esplicitamente di «lasciare invariati gli altri campi», altrimenti è facile introdurre nuovi errori, con oscillazioni in cui si sistema uno e se ne rompe un altro. Terzo, va fissato un limite di tentativi (ad esempio due cicli); superato il limite si passa alla coda per la revisione manuale, invece di un ciclo infinito: i tentativi infiniti allungano la latenza e fanno salire i costi.
Se lo stesso tipo di errore si ripete nei tentativi, di solito non è un problema del modello, ma di un contratto scritto in modo ambiguo. In tal caso bisogna tornare a rivedere le definizioni dei campi e gli esempi, non continuare ad aggiungere prompt.
Modalità di chiamata e limiti di questo articolo
Su HiAPI, glm-5.3 si chiama tramite il protocollo compatibile OpenAI Chat Completions; per attivare la modalità JSON object si imposta response_format al tipo oggetto nella richiesta. I parametri concreti e i nomi dei campi fanno fede secondo la documentazione dell'interfaccia nella pagina del modello. Il flag di capacità jsonObject=true indica che il modello supporta la modalità JSON object, non che l'interfaccia supporti la modalità di risposta JSON Schema, né che ci si possa affidare alla validazione lato server secondo lo Schema; la struttura dei campi, i tipi e i vincoli di business di questo articolo vengono validati localmente dopo il parsing lato client. La logica di estrazione, i campi di citazione e lo strato di validazione risiedono tutti nel tuo server; il modello si limita a produrre testo secondo il contratto.
Questo articolo tratta solo la progettazione del contratto e il flusso di validazione, senza entrare in cifre di fatturazione o promesse di prestazioni; per prezzi e quote in tempo reale fai riferimento al pannello dei prezzi del sito. Solo dopo aver completato le tre cose — definizione dei campi, verifica delle citazioni, strategia di retry — si passa da «formato legale» a «semanticamente utilizzabile»; un formato corretto non equivale a correttezza fattuale, e anche un seed fisso non garantisce una riproduzione perfetta: la strategia di retry deve comunque essere accompagnata da un limite e da una coda per la revisione manuale.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida alla generazione di immagini da testo con Nano Banana versione base: formato, spazio negativo e uso dei prompt
Usare i campi aspect_ratio e prompt dell'API delle attività per generare immagini con composizione chiara per banner e card social
-

Guida all'uso
Gestione delle risposte di Kimi K3 in pratica: JSON completo, interruzioni dello streaming e limiti dei tentativi
-

Guida all'uso
Guida alla produzione di brani brevi con MiniMax Music 3: come scrivere separatamente testo, tag di sezione e brief di arrangiamento
Progettare una richiesta per un brano breve riproducibile partendo dai due input obbligatori previsti dal contratto attuale