
Guida all'uso
Guida introduttiva a gpt-6.2-sol: limiti delle capacità, integrazione API e note sui prezzi per token
Punti decisionali e pratici per l'integrazione rivolti ai team di ingegneria

In questa pagina
Che cos'è gpt-6.2-sol e a chi è adatto
gpt-6.2-sol è un modello testuale rilasciato da OpenAI, già disponibile tramite l'interfaccia unificata di HiAPI.ai. È il modello di punta quotidiano della serie GPT-6, posizionato da OpenAI come modello di uso comune adatto dal coding fino alla guida di agent su larga scala. Il suo tipo di output è testo puro: questo è il primo filtro per capire se fa al caso vostro, invece di trattarlo come una scatola nera universale capace di fare qualsiasi cosa.
Gli scenari in cui è più a suo agio sono: risposta a domande di conoscenza e consolidamento dei risultati di ricerca, stesura e riscrittura di contenuti, estrazione e classificazione di dati strutturati, valutazione semantica in conversazioni multi-turno, e come anello di un processo per decisioni testuali (triage, etichettatura, riassunto, riconoscimento delle intenzioni). Il tratto comune di questi compiti è che l'input è testo e l'output atteso è testo: il modello può essere incorporato nei servizi esistenti come una chiamata a funzione.
Il pubblico di riferimento sono i team di ingegneria: chi sta valutando l'introduzione di un nuovo modello testuale o si prepara a spostare in blocco le chiamate esistenti sul nuovo modello. Se vi serve generare immagini o audio, non rientra nei suoi limiti e va escluso già in fase di selezione.
Un criterio pratico di valutazione: scrivete in una frase il compito che dovete risolvere e chiedetevi «l'input e l'output di questo compito sono entrambi testuali?». Se la risposta è no, questo modello può al massimo occuparsi della parte testuale del processo.
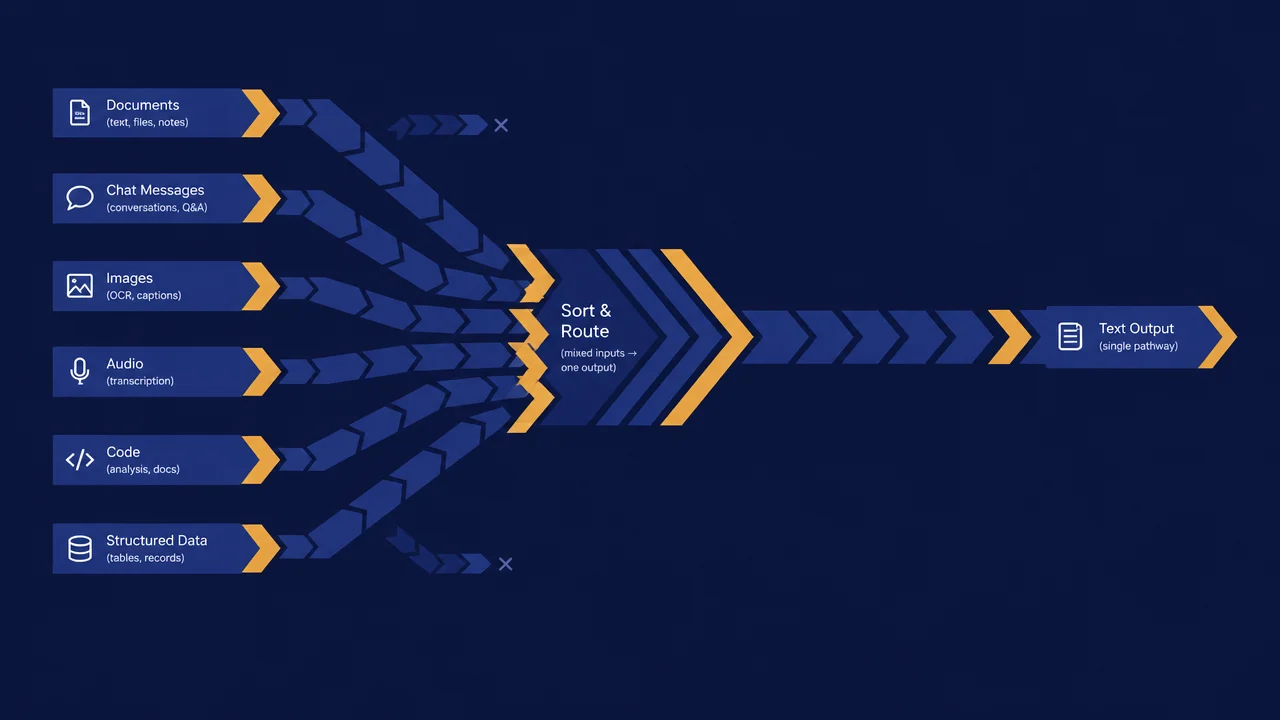
Limiti delle capacità: cosa può e cosa non può fare l'output testuale
Considerate gpt-6.2-sol come una conduttura che riceve testo e restituisce testo. Ciò che la conduttura sa fare è chiaro: dato un contesto testuale, produce un risultato testuale. Su questa base, i compiti che può gestire direttamente includono classificazione ed etichettatura, riassunto e riscrittura, estrazione di informazioni, generazione di risposte, conversione di formato (ad esempio da testo libero al testo strutturato concordato) e ordinamento con spiegazione di risultati candidati.
Anche le parti che richiedono componenti aggiuntivi vanno riconosciute in anticipo:
- Output strettamente strutturato: chiamando tramite Responses API si può passare uno JSON Schema in
text.formate attivare strict, così la risposta viene generata direttamente secondo la definizione dei campi; con Chat Completions questa opzione non esiste e ci si può affidare solo ai vincoli del prompt. Con Chat Completions servono vincoli nel prompt più validazione e retry lato server: non si può dare per scontato che la prima risposta sia sempre interpretabile. - Fatti aggiornati: l'output del modello non equivale a una fonte di verità; i contenuti che riguardano dati, date e stati esterni devono essere forniti dal vostro livello di retrieval o database, e solo successivamente passati al modello per la formulazione.
- Prodotti non testuali: generazione di immagini, voce e simili non rientra nel suo tipo di output e richiede componenti dedicati separati.
- Comportamento deterministico: la stessa richiesta non è garantita identica alla lettera; le parti con logica a forte consistenza vanno messe nel codice, non delegate al giudizio del modello.
Scrivere i limiti nel documento di progettazione costa molto meno che rattopparli in produzione. Ogni passaggio che va oltre le capacità testuali va esplicitamente contrassegnato come «richiede componenti esterni», così in fase di revisione non si creano aspettative disallineate.
Parametri chiave e prezzi di gpt-6.2-sol
Quelle che seguono sono le informazioni già definite per chiamare gpt-6.2-sol tramite HiAPI; l'integrazione e la stima dei costi nei paragrafi successivi si basano su queste.
- Posizionamento: modello di punta quotidiano della serie GPT-6. OpenAI lo posiziona come modello di uso comune adatto dal coding fino alla guida di agent su larga scala, più intelligente e più parco di token rispetto a GPT-6.1 Sol.
- Contesto e output: finestra di contesto di 1.050.000 token, output massimo per singola chiamata di 128.000 token.
- Data di conoscenza: 2026-06-01.
- Output e capacità: output testuale, supporta streaming e chiamata di strumenti (
tools). - Modalità di chiamata: supporta Responses API (
https://api.hiapi.ai/v1/responses) e Chat Completions (https://api.hiapi.ai/v1/chat/completions). Il livello di ragionamentoreasoning.effort(low / medium / high / xhigh / max, default medium) e l'output JSON strutturatotext.formatsono disponibili solo con Responses API. - Prezzo: listino attuale sulla pagina del modello (per milione di token): input $0.500, input in cache $0.025, output $2.500, scrittura in cache (5 minuti) $0.625. La fatturazione fa fede a quanto mostrato in tempo reale sulla pagina del modello gpt-6.2-sol.
Come scegliere tra questo modello e gpt-6.2-astra
Nella stessa serie, gpt-6.2-astra è il modello di punta, pensato per i progetti più difficili e di più lunga durata, con prezzo unitario più alto. Si consiglia per la maggior parte dei compiti di partire con Sol; quando si incontra un problema che Sol non gestisce bene, come un refactoring complesso tra moduli o documenti professionali molto esigenti, si passa ad Astra. Le modalità di chiamata sono identiche e il passaggio richiede solo di cambiare il nome del modello.
Informazioni sull'interfaccia da verificare prima dell'integrazione
Per l'integrazione su HiAPI.ai, il punto d'ingresso informativo è la pagina del modello /models/gpt-6.2-sol. Si consiglia di verificare voce per voce la checklist seguente prima di scrivere la prima riga di codice di chiamata, facendo riferimento alla documentazione ufficiale e della piattaforma, senza indovinare da post della community o configurazioni di progetti precedenti:
- Credenziali e modalità di autenticazione: da dove proviene la chiave, dove viene conservata, come viene iniettata in modo sicuro lato server; non deve mai essere esposta al browser.
- Campi della richiesta e obbligatorietà: denominazione esatta e vincoli di valore di campi come identificativo del modello, struttura dei messaggi e limite di lunghezza della generazione.
- Vincoli di contesto e lunghezza dell'output: la finestra di contesto di gpt-6.2-sol è di 1.050.000 token e l'output massimo per singola chiamata è di 128.000 token; come si applica il limite di output determina direttamente la strategia di suddivisione in blocchi.
- Criteri di rate limiting e quota: su quale dimensione si calcola il limite (numero di richieste o quantità di token) e quale forma assume la risposta quando viene superato.
- Semantica dei codici di errore: quali errori meritano un retry e quali sono problemi di parametri per cui il retry è inutile; vanno distinti.
- Criteri di fatturazione: questo modello è fatturato per token; la pagina del modello indica separatamente i prezzi unitari di input, input in cache, output e scrittura in cache.
Raccogliete queste conclusioni nelle note di integrazione interne al team, così in caso di cambio di persona o di modello la checklist resta riutilizzabile. Finché un punto non è confermato, non scrivetelo nel branch di produzione.
Punti chiave per la chiamata API e l'organizzazione dei parametri
Il lavoro centrale lato chiamata non è inviare una richiesta, ma organizzarla in un wrapper riutilizzabile, osservabile e in grado di degradare. Vediamo un esempio minimo: ottenere JSON strutturato con Responses API. Con l'SDK ufficiale OpenAI è sufficiente puntare base_url a HiAPI:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Estrai i campi dal ticket; per i campi mancanti inserisci null.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Chi ha già un client Chat Completions può chiamarlo cambiando il nome del modello in gpt-6.2-sol, ma il livello di ragionamento e l'output JSON strutturato non sono disponibili con Chat Completions. Di seguito i passi da implementare nell'ordine indicato:
Struttura della richiesta
Separate i messaggi in due livelli: vincoli di sistema e contenuto utente. Nel livello di sistema mettete ruolo, requisiti di formato dell'output e divieti; nel livello utente mettete i dati di business. Non concatenate dati di business e istruzioni in un unico blocco, altrimenti in caso di problemi non si distingue se la causa è nei dati o nelle istruzioni.
Contratto di output
Scrivete in modo esplicito la forma di output attesa (ad esempio i nomi dei campi, se è ammesso testo esplicativo). Anche così, eseguite comunque una validazione di parsing lato server: se il parsing fallisce, trattatela come una chiamata fallita, con retry o degradazione, invece di passare direttamente al frontend un risultato incompleto.
Eccezioni e retry
Il retry va eseguito solo su errori recuperabili, come un guasto di rete transitorio o un rate limit. Per errori come parametri non validi o contenuto troppo lungo il retry è inutile e va segnalato direttamente. Il retry deve avere un numero massimo di tentativi e un intervallo di backoff, per evitare che un singolo guasto si trasformi in una valanga.
Set minimo di osservabilità
Per ogni chiamata registrate almeno: tempo di esecuzione, quantità di token in input e output, se è stato effettuato un retry, se il risultato finale è successo o degradazione. Questi dati determinano se in seguito sarà possibile calcolare i costi e individuare i problemi. Un'integrazione senza log equivale a nessuna integrazione.
Struttura dei costi con prezzi per token
gpt-6.2-sol è fatturato per token, il che significa che il costo di una singola chiamata non è un valore fisso, ma cresce linearmente con la quantità di input e output. A livello ingegneristico occorre costruire un modello di costo, non memorizzare un numero:
- Lato input: system prompt, cronologia della conversazione e contesto recuperato vengono tutti contati. In una conversazione multi-turno, senza potatura l'input continua a gonfiarsi di turno in turno.
- Lato output: più lunga è la generazione, più si paga. Chiedere al modello spiegazioni prolisse fa aumentare i costi in modo incontrollato.
- Costo totale: il costo di una richiesta è dato da input e output insieme, quindi l'ottimizzazione va guardata da entrambi i lati.
Le contromisure corrispondenti: snellire i system prompt e riutilizzarli; applicare una finestra scorrevole o compressione tramite riassunto alla cronologia; suddividere i documenti lunghi e inviarli solo su richiesta; impostare un limite ragionevole all'output; deduplicare e mettere in cache i compiti in batch, perché input identici non vanno pagati due volte.
Il modo corretto di stimare il budget è eseguire una prova su campioni reali, calcolare la media di token in input e output, moltiplicarla per il volume di chiamate e ottenere una stima d'ordine di grandezza. Il listino attuale è riportato sopra in «Parametri chiave e prezzi»; i prezzi possono cambiare e la fatturazione fa fede a quanto mostrato in tempo reale sulla pagina del modello.
Usare un confronto trasversale per decidere se cambiare
La selezione non dovrebbe basarsi su una sola valutazione o su un singolo indicatore. Il modo più solido è mettere gpt-6.2-sol e i modelli attualmente candidati nello stesso lotto di campioni di business reale e confrontarli:
- Campionamento: estrarre da log di produzione o dati etichettati un insieme rappresentativo di richieste, che copra compiti comuni e casi di coda lunga.
- Input uniforme: stessi prompt, stesso lotto di dati, cambiando solo l'identificativo del modello, per escludere l'interferenza delle differenze nei prompt.
- Punteggio multidimensionale: non guardare solo il punteggio, ma anche il tasso di conformità al formato, il tasso di fallimento, il consumo medio di token e il tempo medio di esecuzione.
- Controllo manuale a campione: la qualità espressiva e gli errori fattuali che le metriche automatiche non colgono vanno esaminati da una persona.
- Decisione: definire una soglia di ammissione al cambio, ad esempio il livello di conformità al formato e di tasso di fallimento da raggiungere per procedere.
Lo scopo del confronto non è dimostrare che il nuovo modello è migliore, ma rispondere alla domanda «sui compiti attuali, i benefici del cambio coprono i costi di migrazione e operativi?». Se la differenza non è significativa, mantenere lo stato attuale è anch'essa una decisione corretta. Nella stessa serie, per i compiti più difficili e di più lunga durata si può includere nel confronto anche gpt-6.2-astra; per la maggior parte dei compiti si consiglia di partire con Sol.
Domande frequenti e percorso di troubleshooting
Per i problemi frequenti della fase iniziale di integrazione, l'ordine di indagine seguente è di solito il più rapido:
- Timeout: verificare prima se l'input è troppo lungo e allunga i tempi di elaborazione, poi se si tratta di rete o rate limit lato server. Il piano di degradazione va preparato prima del guasto.
- Output troncato: controllare se il limite di lunghezza della generazione è troppo basso e se il prompt di sistema richiede un output troppo lungo. Il troncamento spesso non è un problema del modello, ma dei parametri.
- Formato di output non conforme: verificare che i requisiti di formato nel prompt siano sufficientemente specifici e che lato server siano presenti validazione e retry; in caso di fallimenti consecutivi, considerare esempi di vincolo più espliciti.
- Autenticazione fallita: verificare che la chiave sia iniettata correttamente, che non si sia esposta per errore la chiave lato server al frontend e che non manchino variabili d'ambiente.
- Errore di rate limit: verificare dimensione e soglia del limite, aggiungere backoff e coda, evitare che la concorrenza istantanea saturi la quota.
La disciplina di base del troubleshooting è: individuare prima se si tratta di un problema di costruzione della richiesta, di un vincolo lato server o di parsing nel codice di business, e solo dopo intervenire. Non affidarsi al caso modificando i parametri.
Monitoraggio e iterazione dopo il rilascio
Il rilascio non è il traguardo. Considerate l'integrazione come una catena in funzionamento continuo e monitorate almeno queste categorie di metriche: volume di chiamate e tasso di successo, tasso di conformità al formato, token medi in input e output, tempo medio di esecuzione, quota di degradazioni e retry. Esse corrispondono rispettivamente alle quattro dimensioni di capacità, qualità, costo e stabilità.
Sul ritmo di iterazione, si consiglia di rivedere a intervalli regolari i campioni falliti e il feedback degli utenti, raccogliere gli errori tipici come nuovi casi di valutazione e, sulla base di questi, regolare prompt, strategia di suddivisione e limite di output. Quando cambiano il modello o la configurazione della piattaforma, eseguire una regressione sullo stesso lotto di campioni di valutazione prima di decidere se aumentare il traffico.
Un principio di rilascio utilizzabile: verificare prima l'effettivo comportamento con un rilascio graduale a basso traffico, poi ampliare progressivamente, mantenendo sempre un interruttore per tornare al modello precedente. Per dare un'occhiata ai dettagli del modello e alle informazioni di integrazione, si può partire da /models/gpt-6.2-sol. Solo consolidando insieme limiti delle capacità, modello di costo e monitoraggio, gpt-6.2-sol può diventare un anello testuale stabile e affidabile nel vostro sistema.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a gpt-6.2-astra: confini delle capacità del modello testuale, punti di integrazione e controllo dei costi
-

Guida all'uso
Guida introduttiva a Tripo H3.1: come scegliere tra tre modalità di input, parametri e prezzi
Guida pratica per sviluppatori: decisioni di integrazione e controllo dei costi nella generazione 3D
-

Guida all'uso
Generare immagini di prodotto e-commerce con qwen-image-2.1-turbo tramite l'API HiAPI
Un flusso di lavoro rapido per immagini di catalogo per sviluppatori: output PNG trasparente e richieste API eseguibili