
Kuaishou
Kling 3.0
kling-3.0/motion-control
Serie unificata di generazione video multimodale, supporta la generazione di video da testo, da immagine, da riferimento e il montaggio all'interno del video, con sincronizzazione labiale nativa e audio multilingue
Prova kling-3.0/motion-control
Input
Creazioni
Vedi tutte le creazioniOutput
Dal testo all'immagine: concept di storyboard con controllo del movimento di Kling 3.0
Stile Storyboard · Trasferimento di movimento · Coerenza dei personaggi
Input di riferimento
image_url
video_url
Prompt
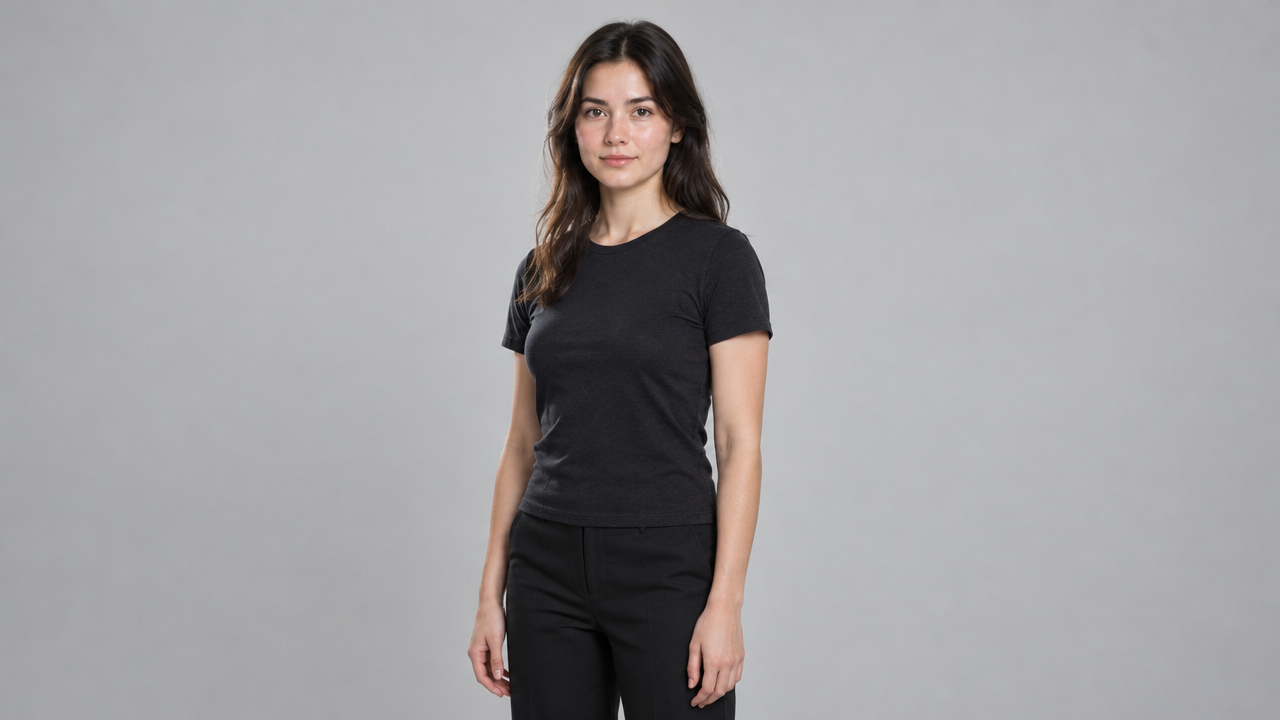
Concept di controllo del movimento per uno storyboard di livello registico: un riferimento del personaggio dalla composizione chiara guida la coerenza dell'identità, una singola clip di riferimento continua guida postura, gesti e ritmo temporale. Il prompt descrive una transizione neutra dallo studio alla scena stradale, luce principale direzionale morbida con una delicata luce di contorno, texture cutanea naturale, resa da obiettivo 35mm, leggera sensazione di respiro a mano libera, soggetto centrato in inquadratura media, testa, spalle e torso visibili per tutta la durata. Mantieni il movimento fisicamente plausibile e chiaramente leggibile, preserva la coerenza di abbigliamento e identità facciale per tutta la clip, color grading sobrio, ombre fredde e alte luci calde, nessun montaggio, nessun artefatto di stilizzazione.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Note visive sul linguaggio di ripresa: riprodurre cinque movimenti di camera di base con motion-control
Stile Movimento della camera · Storyboard · Video di riferimento
Input di riferimento
image_url
video_url
Prompt
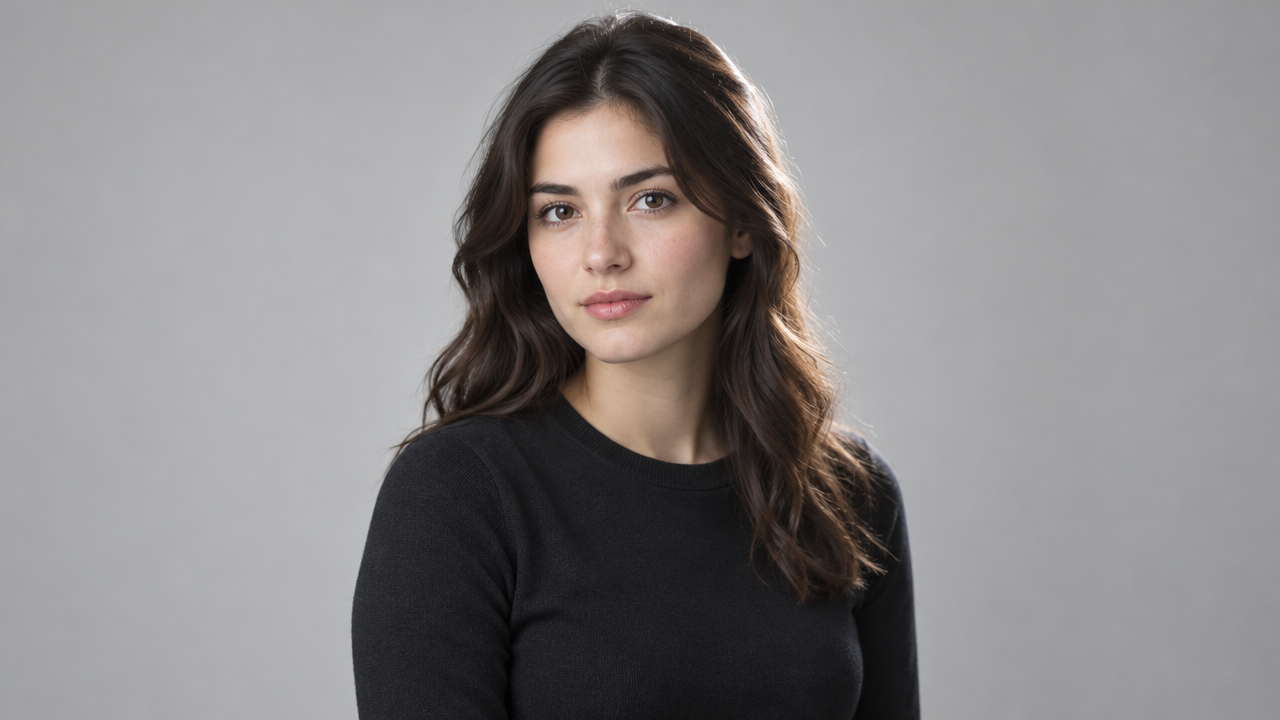
Un'inquadratura continua a piano medio che riprende una figura inquadrata dal capo alle spalle, su uno sfondo neutro da studio, per studiare il movimento di camera: la cinepresa avanza lentamente e stabilmente dal piano medio al primo piano, mantenendo il soggetto centrato e la linea d'orizzonte in piano. Luce principale morbida e direzionale proveniente da sinistra della cinepresa, integrata da una leggera luce di riempimento, per una sottile separazione del contorno, profondità di campo ridotta, color grading cinematografico, contrasto contenuto. Movimento meccanico fluido, nessun taglio, nessuna vibrazione a mano libera, identità del personaggio coerente per tutta l'inquadratura.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Scheda formula prompt di Kling 3.0 Motion Control: dimostrazione della scrittura strutturata delle riprese
Stile Trasferimento di movimento · Ingegneria dei prompt · Storyboard
Input di riferimento
image_url
video_url
Prompt
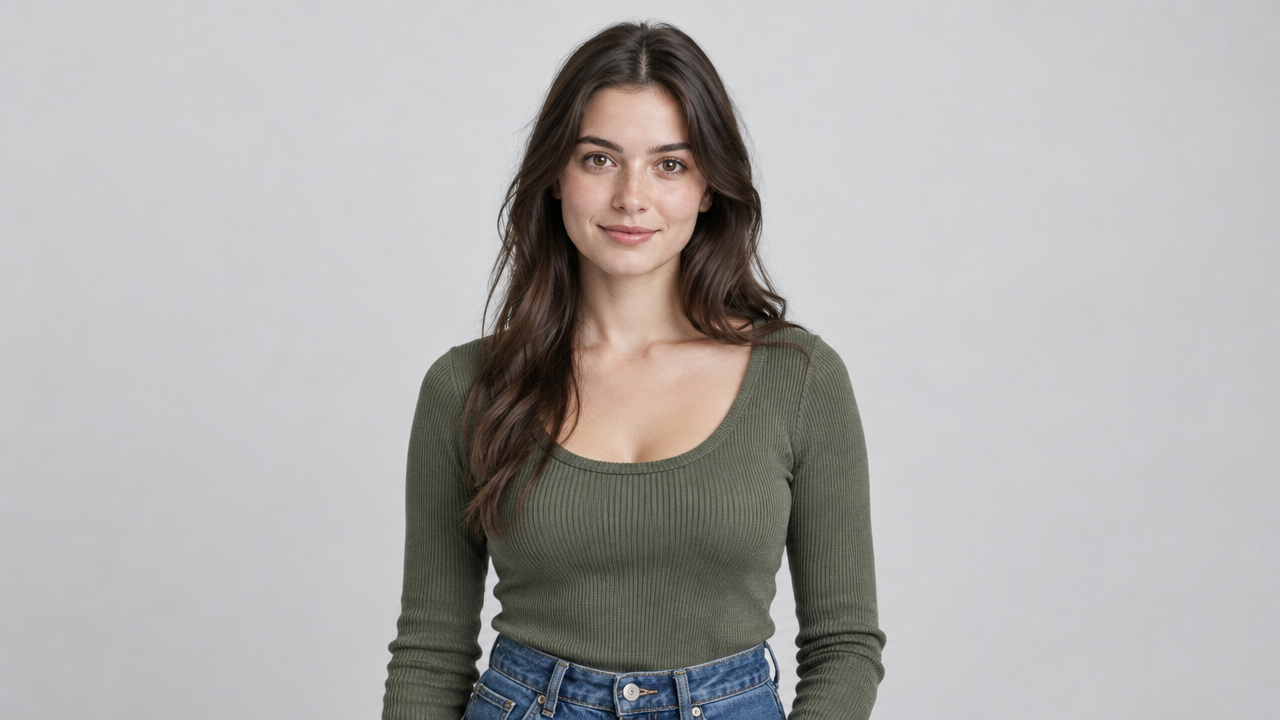
Inquadratura a mezzo busto del personaggio nell'immagine di riferimento, in piedi in un moderno studio fotografico dalla luce morbida, con un'ampia finestra diffusiva come luce principale e una debole luce di contorno fredda proveniente da dietro. Assicurarsi sempre che testa, spalle e torso del soggetto siano completamente visibili e centrati nell'inquadratura, con uno spazio negativo pulito nella parte superiore. Color grading cinematografico, profondità di campo ridotta, texture della pelle naturale, grana sottile della pellicola, obiettivo equivalente a 35mm. Macchina da presa fissa, con carrellata in avanti a velocità estremamente lenta; postura, espressioni e ritmo seguono completamente il video di riferimento e il prompt non descrive alcuna azione aggiuntiva.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Kling 3.0 Motion Control:parametri e capacità per scenari illustrati
Stile Trasferimento di movimento · Coerenza dei personaggi · Sotto-competenza
Input di riferimento
image_url
video_url
Prompt
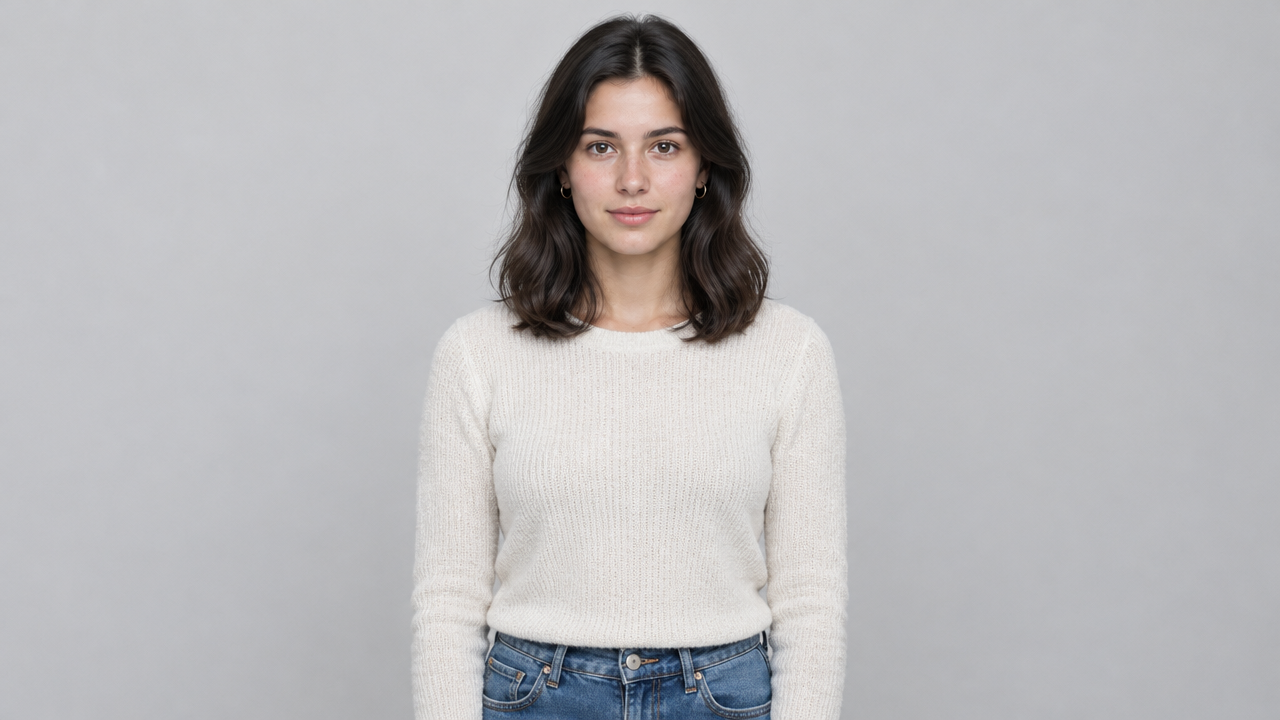
Trasferimento di azioni del personaggio: un'unica inquadratura continua a mezzo busto di una giovane donna con capelli scuri lunghi fino alle spalle, che indossa una maglia leggera in maglia, in piedi in uno studio fotografico luminoso e minimalista, con una morbida luce proveniente da una finestra sulla sinistra. La donna esegue una sequenza di movimenti naturali e rilassati: si gira leggermente verso la fotocamera, si sposta i capelli dietro un orecchio, poi annuisce dolcemente con un sorriso lieve. La fotocamera rimane sostanzialmente fissa, con una sottile sensazione di respiro tipica della ripresa a mano, inquadrando per tutta la durata testa, spalle e busto. Pelle e tessuti mantengono una texture realistica, profondità di campo ridotta, sfondo dai toni freddi e neutri, ritmo dei movimenti naturale, con una credibile sensazione di peso e movimento della testa, nessun taglio, nessun trattamento stilizzato.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
kling-3.0/motion-control per second
| Specifiche | Prezzo unitario |
|---|---|
| 720P | $0.100 |
| 1080P | $0.172 |
Panoramica della posizione
kling-3.0/motion-control è una linea di generazione video guidata dal movimento: si inseriscono un'immagine di riferimento di una persona e un video di riferimento con movimento, e si ottiene un nuovo video orchestrato da quel movimento. L'aspetto del personaggio deriva dall'immagine, il movimento e le espressioni dal video, mentre il prompt opzionale serve ad aggiungere scena, stile e inquadratura. È adatto a sviluppatori che necessitano di trasferire performance di persone reali su un personaggio specifico, ad esempio in scenari come miniserie, contenuti parlati o presentazioni e-commerce in cui occorre riutilizzare lo stesso materiale di movimento.
Punti chiave
- Input disaccoppiati di personaggio e movimento — l'aspetto della persona è determinato dall'immagine di riferimento, il ritmo del movimento dal video di riferimento; la stessa performance può essere applicata a materiali di personaggi diversi.
- Durata dell'output adattiva in base alla modalità di orientamento del personaggio — seguendo il video, il personaggio può essere emesso fino a 30 secondi; seguendo l'immagine, fino a 10 secondi; si può scegliere in base al tipo di inquadratura.
- Supporto per conservare l'audio originale del video di riferimento — per impostazione predefinita viene mantenuta la traccia audio del video di riferimento, con movimento e suono sincronizzati in uscita, evitando la fase di sincronizzazione separata.
Descrizione delle capacità
Trasferimento di movimento guidato da due materiali: è necessario fornire due input, immagine della persona e video del movimento; l'immagine determina l'aspetto del personaggio, il video determina movimento ed espressioni, e il risultato generato eredita entrambi.
Commutazione della modalità di orientamento del personaggio: character_orientation può essere video o image: la prima è adatta a movimenti complessi, con durata massima di 30 secondi; la seconda è adatta al movimento di camera, con durata massima di 10 secondi.
Il prompt integra scena e inquadratura: il prompt opzionale può arrivare a 2500 caratteri ed è usato per aggiungere scena, stile e direzione dell'inquadratura, senza modificare movimento ed espressioni determinati dal video di riferimento.
Risoluzione selezionabile e conservazione della traccia audio: l'output può essere 720p o 1080p ed è possibile scegliere se conservare l'audio originale del video di riferimento; la risoluzione più alta comporta un costo maggiore.
Scenari d'uso
- Creatori di miniserie e contenuti parlati che riutilizzano materiale di movimento — caricando una foto del personaggio e un video di performance si ottiene un prodotto finito con lo stesso movimento per quel personaggio, utile alla produzione di contenuti seriali.
- E-commerce e brand per dimostrazioni di prodotto con personaggi — abbinando l'immagine di una modella o di un avatar a un video di dimostrazione del prodotto si produce un breve filmato dimostrativo con persona, da usare nelle pagine di dettaglio e nelle campagne.
- Contenuti di movimento che richiedono di conservare l'audio originale — attivando la conservazione dell'audio si ottiene direttamente un video con traccia audio sincronizzata, da pubblicare come breve video sui social.
Limiti e consigli di scelta
Entrambi i materiali di input hanno requisiti obbligatori: nell'immagine della persona testa, spalle e busto devono essere chiaramente visibili, con rapporto d'aspetto tra 2:5 e 5:2 e dimensione non superiore a 10MB; il video di riferimento deve durare da 3 a 30 secondi, essere una ripresa continua a inquadratura singola con soggetto visibile e non superare 100MB. Movimento ed espressioni sono determinati dal video di riferimento; il prompt può regolare solo scena e stile, non riscrivere il movimento stesso. Per la generazione da solo testo o da immagine a video occorre scegliere altre linee della stessa famiglia; i contenuti narrativi lunghi richiedono comunque una generazione a segmenti e un successivo montaggio.
Novità
Vedi il changelog →- Nuovo modello Nuovo modello: Kling 3.0 Omni (可灵 O3), richiamabile tramite POST /v1/tasks. kling-3.0-omn…
Domande frequenti
Vedi tutte le domande →-
Kling 3.0 Image-to-Video richiede il caricamento di un'immagine?
Sì. Attualmente kling-3.0/image-to-video è una pipeline image-to-video: l'immagine di input definisce il soggetto e la composizione iniziale, mentre il Prompt gestisce i movimenti, la telecamera e i cambiamenti dell'ambiente.
-
Quali durate e risoluzioni supporta Kling 3.0 Image-to-Video?
L'attuale contratto di richiesta di HiAPI supporta 3–15s, con risoluzioni di output 720p, 1080p e 4K. I valori disponibili sono quelli indicati nel pannello dei parametri della pagina e nella documentazione API.
-
Come viene fatturato Kling 3.0 Image-to-Video?
Le attività vengono fatturate in base alla durata dell'output e al livello selezionato. La pagina mostra il prezzo in tempo reale seguendo l'unità monetaria globale; l'addebito finale fa riferimento al record delle attività completate con successo.
-
Come migliorare la stabilità del soggetto nella generazione di video da immagine?
Usa un'immagine di input con un soggetto chiaro, poche occlusioni e una composizione completa; nel Prompt descrivi prima l'azione principale e la ripresa, poi elenca gli aspetti dell'aspetto, i materiali e le relazioni con lo sfondo che devono essere preservati. Per il primo test si consiglia una durata breve.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: kling-3.0/motion-control
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per kling-3.0/motion-control e la route default — vedi la tabella dei parametri sotto.
promptstringOpzionalemaxLength 2500Prompt facoltativo per descrivere scena, stile e inquadratura. I movimenti e le espressioni del personaggio provengono dal video di riferimento, l'aspetto del personaggio proviene dall'immagine di riferimento; se non compilato, si fa affidamento sui materiali di riferimento stessi.
image_urlstringObbligatorioImmagine di riferimento del personaggio, supporta i formati jpeg/png/jpg, dimensione non superiore a 10MB, larghezza e altezza entrambe maggiori di 340px, rapporto d'aspetto tra 2:5 e 5:2; testa, spalle e busto devono essere chiaramente visibili.
video_urlstringObbligatorioVideo di riferimento per i movimenti, supporta i formati mp4/mov, dimensione non superiore a 100MB, durata da 3 a 30 secondi, deve essere una ripresa continua a inquadratura singola con testa, spalle e busto del soggetto visibili; la durata dell'output segue quella del video, con un massimo di 10 secondi quando character_orientation è image e di 30 secondi quando è video.
resolutionstringOpzionalePredefinito: "720p"Risoluzione dell'output, più alta è la risoluzione maggiore è il costo; predefinita 720p.
720p1080pkeep_original_soundbooleanOpzionalePredefinito: trueIndica se mantenere l'audio originale del video di riferimento nell'output; predefinito true, ovvero mantenuto per impostazione predefinita.
character_orientationstringOpzionalePredefinito: "video"Origine dell'orientamento del personaggio: con video l'orientamento segue il video di riferimento, adatto a movimenti complessi, supporta fino a 30 secondi; con image l'orientamento segue l'immagine di riferimento, adatto ai movimenti di camera, supporta fino a 10 secondi. Predefinito video.
videoimagecallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0/motion-control",
  "input": {
    "image_url": "…",
    "video_url": "…",
    "resolution": "720p",
    "keep_original_sound": true,
    "character_orientation": "video"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "kling-3.0/motion-control",
input: {
"image_url": "…",
"video_url": "…",
"resolution": "720p",
"keep_original_sound": true,
"character_orientation": "video"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "kling-3.0/motion-control",
"input": {
"image_url": "…",
"video_url": "…",
"resolution": "720p",
"keep_original_sound": True,
"character_orientation": "video"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Kling 3.0 Turbo Kuaishou $0.130 /secondo
-
 Veo 3.1 Lite Google $0.060 /secondo
-
 Kling 3.0 Kuaishou $0.100 /secondo
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 FLUX 3 Video Black Forest Labs $0.090 /secondo
-
 Vidu Q4 Preview Vidu $0.051 /secondo
-
 LTX 2.5 Fast Lightricks $0.086 /secondo
-
 HeyGen Avatar V HeyGen $0.150 /secondo
-
 Veo 3.1 Google $0.290 /secondo
-
 Kling AI Avatar Kuaishou --
-
 Seedance 2.5 ByteDance $0.121 /secondo
-
 HappyHorse 1.0 Alibaba $0.168 /secondo

