
Kuaishou
Kling 3.0
kling-3.0-omni/image-to-video
Serie unificata di generazione video multimodale, supporta la generazione di video da testo, da immagine, da riferimento e il montaggio all'interno del video, con sincronizzazione labiale nativa e audio multilingue
Prova kling-3.0-omni/image-to-video
Input
Creazioni
Vedi tutte le creazioniOutput
videoNote visive di movimento di camera: esempi di linguaggio cinematografico da immagine a video
Stile Movimento della camera · Storyboard · Linguaggio cinematografico
Input di riferimento
image_urls
Prompt
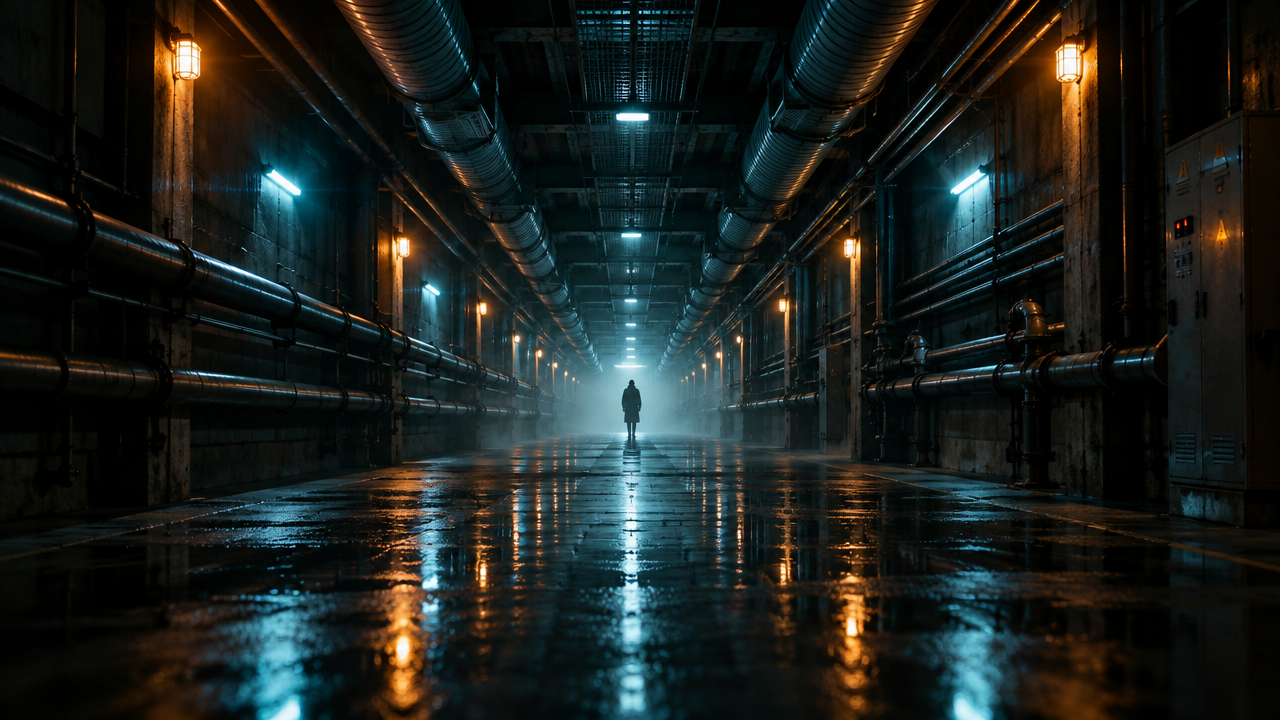
Lenta carrellata cinematografica in avanti, la camera punta su una figura sola in fondo a un corridoio industriale bagnato dalla pioggia, la cinepresa scivola in avanti a velocità costante con un leggero tremolio da camera a mano, profondità di campo ridotta che mette a fuoco gradualmente dal primo piano dei tubi fino al soggetto, luci pratiche color ciano freddo e ambra che tremolano lungo le pareti, nebbia volumetrica che si sposta nell'inquadratura, bagliori di lente anamorfica, motion blur cinematografico a 24fps, piano sequenza stabile, nessun taglio, tono trattenuto e osservativo
Copia il prompt completo e adattalo alla tua generazione.
Tag
Kling 3.0 Omni da immagine a video: parametri chiave e scenari d'uso illustrati
Stile Spiegazione · i2v · Demo del prodotto
Input di riferimento
image_urls
Prompt
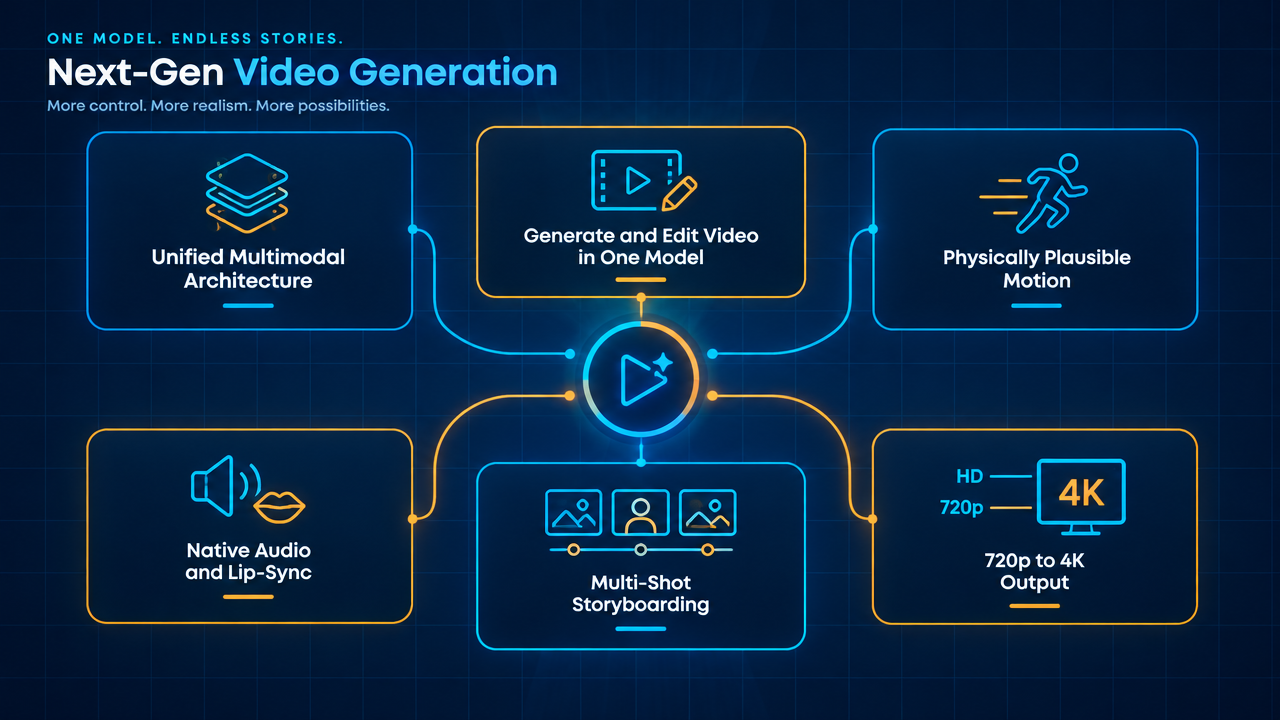
Trasforma un semplice diagramma tecnico delle capacità in 16:9 in un breve video esplicativo. La scena iniziale mostra già un layout a griglia blu navy profondo con sei schede di parametri etichettate: architettura multimodale unificata, generazione video da testo / da immagine / da riferimento ed editing all'interno del video, attenzione congiunta spazio-temporale tridimensionale per generare movimenti fisicamente plausibili, audio nativo e sincronizzazione labiale multilingue, storyboard multi-inquadratura fino a 15 secondi e output da 720p a 4K. La camera avanza lentamente e con stabilità, con una leggera deriva parallattica; le schede si evidenziano in sequenza con una morbida transizione a tendina da sinistra a destra e un tenue alone luminoso, mentre le linee di collegamento tra le schede vengono tracciate progressivamente come sottili filamenti luminosi. Mantieni tutto il testo nitido, leggibile e invariato, senza ridisegno del testo o glifi corrotti. Estetica tecnologica aziendale sobria, sfondo blu navy profondo, luci d'accento ciano e ambra caldo, nebbia volumetrica soffice, profondità di campo ridotta sugli strati di sfondo, illuminazione da studio ad alto contrasto, composizione stabile, etichette non deformate, nessuna aggiunta di persone o oggetti.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Concetto di storyboard: la trasformazione dal testo all'immagine nella costruzione delle inquadrature
Stile Storyboard · Concept art · Cinematografico
Input di riferimento
image_urls
Prompt
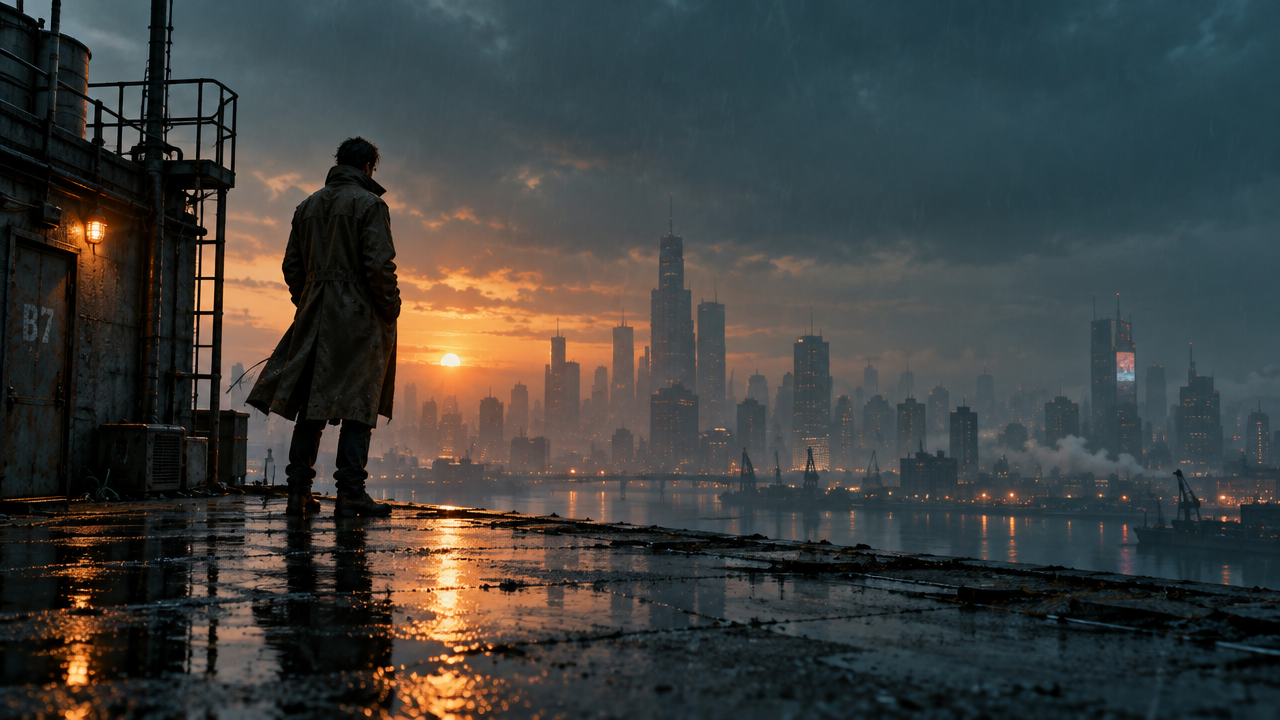
Inquadratura concettuale dal taglio cinematografico: al crepuscolo, una figura solitaria avvolta in un cappotto logoro se ne sta sul bordo di un tetto industriale bagnato dalla pioggia, mentre in lontananza le luci della città appaiono soffuse nella foschia. Da un ampio piano d'insieme la macchina da presa avanza lentamente, per poi sollevarsi con un leggero movimento di gru sul finale; profondità di campo ridotta, bagliori di lenti anamorfiche, ombre in ciano freddo e controluce caldo di lampade al sodio, sottili fili di pioggia che brillano nella luce, lieve respiro di camera a mano, movimento cinematografico a 24fps, che trasforma lo storyboard di concept art nel ritmo di una ripresa dal vivo.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
kling-3.0-omni/image-to-video per second
Panoramica della posizione
kling-3.0-omni/image-to-video è la versione Omni della serie kling-3.0 orientata alla generazione video da immagine, richiamabile tramite l'interfaccia unificata di HiAPI.ai. Gli sviluppatori inseriscono una o più immagini di fotogramma e, insieme a un prompt testuale, possono generare video da 3 a 15 secondi, da 720p a 4k, con l'opzione di attivare audio nativo, multi-inquadratura intelligente e soggetti riutilizzabili. È adatta a sviluppatori che devono convertire rapidamente immagini statiche in video dinamici in scenari come esposizione e-commerce, brevi video per i social e previsualizzazione di storyboard, richiedendo coerenza degli elementi e durata e qualità dell'immagine controllabili.
Punti di forza principali
- Controllo a due immagini per primo e ultimo fotogramma — supporta 1 immagine come primo fotogramma, oppure 2 immagini che specificano rispettivamente primo e ultimo fotogramma, dando al processo di generazione un punto di inizio e di fine chiari.
- Soggetti riutilizzabili per mantenerne la coerenza — definisci fino a 3 soggetti, ciascuno descritto con 2–4 immagini e citato nel prompt come @nome, riducendo la deriva del soggetto tra inquadrature diverse.
- Uscita audio nativa opzionale — attivando audio, il video viene generato insieme al suono sincronizzato, eliminando le fasi separate di doppiaggio e allineamento audio-video in post-produzione.
- Durata e risoluzione regolabili — la durata di uscita copre da 3 a 15 secondi e la risoluzione è selezionabile tra 720p, 1080p e 4k, adattandosi alle diverse fasi, dall'anteprima al prodotto finito.
Descrizione delle capacità
Guida tramite primo fotogramma o primo e ultimo fotogramma: inserendo 1 immagine si genera un video che parte da essa, oppure inserendo 2 immagini si controllano primo e ultimo fotogramma; il rapporto d'aspetto dell'output segue il primo fotogramma, facilitando l'abbinamento con la composizione del materiale esistente.
Riferimento ai soggetti e coerenza: tramite elements si definiscono fino a 3 soggetti nominati, ciascuno con 2–4 immagini di riferimento e una breve descrizione, citati nel prompt come @nome, per mantenere stabile l'aspetto dei soggetti tra più inquadrature.
Generazione audio nativa: attivando il parametro audio, il video viene prodotto insieme a un suono sincronizzato, adatto a prodotti finiti che richiedono battute o suoni ambientali, riducendo i passaggi di composizione audio-video.
Pianificazione multi-inquadratura intelligente: attivando prefer_multi_shots, il modello suddivide automaticamente il prompt in più inquadrature, ottenendo con una sola chiamata un breve video con cambi di inquadratura anziché un'unica scena continua.
Scenari applicativi
- Conversione di immagini di prodotto e-commerce in video dimostrativi — usando l'immagine principale del prodotto come primo fotogramma, si genera un breve video con movimento di camera da usare in pagine di dettaglio prodotto o materiali per il feed.
- Conversione di poster statici per i social in brevi video dinamici — inserendo primo e ultimo fotogramma del progetto grafico, si produce un video dinamico verticale o orizzontale da pubblicare direttamente sulle piattaforme social.
- Previsualizzazione di storyboard tramite primo e ultimo fotogramma — per i fotogrammi chiave di storyboard cinematografici o di animazione si abbinano primo e ultimo fotogramma, generando inquadrature di transizione utili a confermare ritmo e movimento di camera in fase preliminare.
- Brevi video con personaggi in più inquadrature — usando elements per fissare l'aspetto dei personaggi e attivando la multi-inquadratura, si generano in batch brevi video narrativi con personaggi coerenti, per pubblicità o contenuti seriali.
Limiti e consigli per la scelta
La durata massima per singola generazione è di 15 secondi; narrazioni più lunghe richiedono generazioni segmentate e successivo montaggio; il rapporto d'aspetto dell'output è determinato dal primo fotogramma, quindi le proporzioni dei materiali vanno uniformate in anticipo. I soggetti citabili sono al massimo 3 e ciascuno richiede 2–4 immagini dello stesso soggetto, con un costo di preparazione degli input più elevato. Audio nativo e multi-inquadratura intelligente sono opzioni attivabili; una volta attivate, la qualità della generazione dipende maggiormente dalla qualità della descrizione nel prompt. Se serve solo una generazione guidata da testo puro, conviene scegliere la linea text-to-video della stessa serie; se invece serve una sostituzione locale basata su un video esistente, non rientra nell'ambito image-to-video di questa linea.
Novità
Vedi il changelog →- Nuovo modello Nuovo modello: Kling 3.0 Omni (可灵 O3), richiamabile tramite POST /v1/tasks. kling-3.0-omn…
Domande frequenti
Vedi tutte le domande →-
Kling 3.0 Image-to-Video richiede il caricamento di un'immagine?
Sì. Attualmente kling-3.0/image-to-video è una pipeline image-to-video: l'immagine di input definisce il soggetto e la composizione iniziale, mentre il Prompt gestisce i movimenti, la telecamera e i cambiamenti dell'ambiente.
-
Quali durate e risoluzioni supporta Kling 3.0 Image-to-Video?
L'attuale contratto di richiesta di HiAPI supporta 3–15s, con risoluzioni di output 720p, 1080p e 4K. I valori disponibili sono quelli indicati nel pannello dei parametri della pagina e nella documentazione API.
-
Come viene fatturato Kling 3.0 Image-to-Video?
Le attività vengono fatturate in base alla durata dell'output e al livello selezionato. La pagina mostra il prezzo in tempo reale seguendo l'unità monetaria globale; l'addebito finale fa riferimento al record delle attività completate con successo.
-
Come migliorare la stabilità del soggetto nella generazione di video da immagine?
Usa un'immagine di input con un soggetto chiaro, poche occlusioni e una composizione completa; nel Prompt descrivi prima l'azione principale e la ripresa, poi elenca gli aspetti dell'aspetto, i materiali e le relazioni con lo sfondo che devono essere preservati. Per il primo test si consiglia una durata breve.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: kling-3.0-omni/image-to-video
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per kling-3.0-omni/image-to-video e la route default — vedi la tabella dei parametri sotto.
audiobooleanOpzionalePredefinito: falseInterruttore booleano che controlla se generare effetti sonori sincronizzati insieme al video; il valore predefinito è false, ovvero l'audio non viene generato.
promptstringObbligatoriominLength 1maxLength 3072Descrive il contenuto del video che si desidera generare; per fare riferimento a un soggetto in subjects, è possibile menzionarne il nome nel prompt nella forma @name.
durationintegerOpzionalePredefinito: 5min 3max 15Durata del video di output, in secondi, con valori da 3 a 15; predefinito 5.
elementsarrayOpzionalemaxItems 3
Elenco di soggetti riutilizzabili, massimo 3; ogni elemento contiene un nome, una breve descrizione e 2-4 immagini, e viene referenziato nel prompt tramite @name.
Array [ object ]
Elementi dell'array
namestringObbligatoriominLength 1Nome del soggetto, deve essere univoco e non contenere spazi; nel prompt si fa riferimento al soggetto nella forma @name.
descriptionstringObbligatoriominLength 1Breve testo descrittivo del soggetto, utile ad aiutare il modello a riconoscerne le caratteristiche.
element_input_urlsarrayObbligatoriominItems 2maxItems 4Array di URL di 2-4 immagini dello stesso soggetto, in formato JPG/PNG.
Array [ string ]
image_urlsarrayObbligatoriominItems 1maxItems 2Array di URL delle immagini del primo e dell'ultimo fotogramma: 1 immagine indica il primo fotogramma, 2 immagini indicano in ordine il primo e l'ultimo fotogramma; JPG/PNG, ciascuna non superiore a 50MB, almeno 300 pixel, rapporto d'aspetto 0.4-2.5; il rapporto d'aspetto dell'output segue quello del primo fotogramma.
Array [ string ]
resolutionstringOpzionalePredefinito: "720p"Risoluzione del video di output; predefinita 720p.
720p1080p4kprefer_multi_shotsbooleanOpzionalePredefinito: falseInterruttore booleano che controlla se consentire al modello di pianificare automaticamente più inquadrature in base al prompt; predefinito false.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0-omni/image-to-video",
  "input": {
    "audio": false,
    "prompt": "…",
    "duration": 5,
    "image_urls": "…",
    "resolution": "720p",
    "prefer_multi_shots": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "kling-3.0-omni/image-to-video",
input: {
"audio": false,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "kling-3.0-omni/image-to-video",
"input": {
"audio": False,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Creatify Boreal Creatify $0.015 /secondo
-
 Vidu Q4 Preview Vidu $0.051 /secondo
-
 HeyGen Avatar V HeyGen $0.150 /secondo
-
 Gemini Omni 1.1 Flash Google $0.450 /video
-
 Veo 3.1 Google $0.290 /secondo
-
 Kandinsky 6.0 Pro $1.93 /video
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 MiniMax H3 MiniMax $0.072 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Veo 3.1 Lite Google $0.060 /secondo
-
 PixVerse V6 PixVerse $0.036 /secondo
-
 Wan 3.0 Video Alibaba $0.040 /secondo



