
使用ガイド
Kling 3.0 Turbo 画像から動画:hiapi API でショート動画を制作する
静的な写真1枚と API 呼び出し1回だけで、hiapi 上の Kling 3.0 Turbo 画像から動画 を使って、思わずスクロールを止めてしまうショート動画を生成できます。タイムラインエディタも、モーションバインディングも、グリーンスクリーンも不要——最初のフレーム画像と短い動きのプロンプトを送信すれば、数分後に 8 秒、10 秒、または 15 秒の .mp4 が手に入ります。本チュートリアルでは、実際の /v1/tasks API を使ってエンドツーエンドで1本の動画を制作し、実際の費用内訳を示したうえで、同じコードを静的画像フォルダ全体を対象にできるループへ改造し、TikTok や Reels 向けの動画をバッチ生成します。
以下は、本記事で1枚の最初のフレーム写真から生成した動画です:
Kling 3.0 Turbo 画像から動画が実際に必要とするもの
このモデルの入力スキーマはごく短く、まさにそれが要点です——カメラのセッティングやキーフレームを考える必要はなく、必須フィールド2つと任意フィールド2つだけです:
prompt(文字列、必須)——シーン全体ではなく、実現したい動きを記述します。シーンは最初のフレームがすでに定義しているので、プロンプトはモデルに何を動かすべきかを伝えます。image_urls(配列、必須)——最初のフレーム画像を指す公開 URL(JPEG または PNG、最大 10MB)。これはモデルが受け付ける唯一の画像であり、ここに複数参照画像モードはありません。duration(整数、任意、デフォルト5)——動画の長さ(秒)、3から15。resolution(文字列、任意、デフォルト720p)——720pまたは1080p。
事前に計画しておくべき点が1つあります:aspect_ratio パラメータは存在しません。 出力画面は常に入力画像の構図を継承します——9:16 の最初のフレームは 9:16 の動画をレンダリングし、上書きはできません。TikTok や Reels 向けのコンテンツを制作する場合は、動画エンドポイントを呼び出す前に最初のフレームを 9:16 で生成(またはトリミング)してください。そうしないと、構図を修正するために $0.65〜$1.60 の生成をもう一度実行することになります。完全なパラメータリファレンスとオンライン試用パネルはモデルページにあります。
ステップ1:優れた最初のフレームから始める
新しいコンテンツを生成する前に、利用可能な静的画像がすでにあるか確認しましょう——商品写真、以前 AI で生成した画像、ブランドの撮影素材などです。Kling 3.0 Turbo 画像から動画は最初のフレームだけを読み取ってシーン全体を定義するため、既存の画像を再利用しても動画ステップで追加費用は発生しません。生成された動きの秒数分だけ支払えばよいのです。
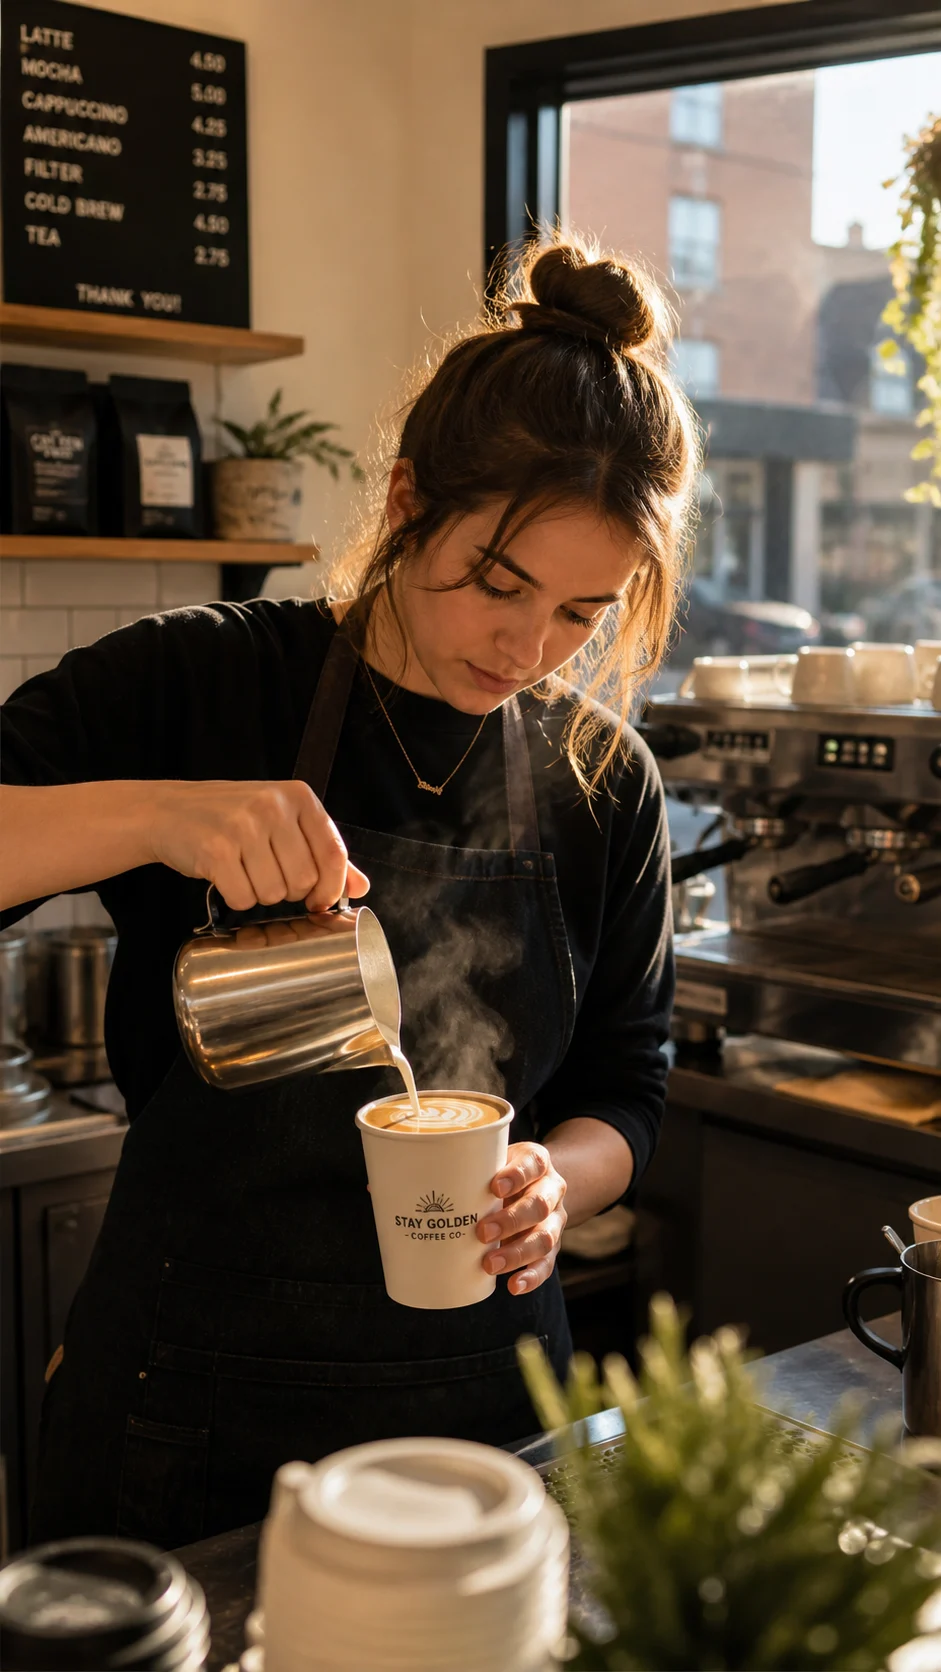
もしなければ、最初のフレームの生成は通常のテキストから画像への呼び出しになります。本記事の最初のフレームは gpt-image-2/text-to-image から取得し、最初から縦向きの構図にしているので、動画は正しいアスペクト比を継承します:
import requests

resp = requests.post(
    "https://api.hiapi.ai/v1/tasks",
    headers={"Authorization": f"Bearer {HIAPI_API_KEY}"},
    json={
        "model": "gpt-image-2/text-to-image",
        "input": {
            "prompt": (
                "Vertical smartphone-shot photo of a barista in a small specialty "
                "coffee shop pouring steaming latte art into a white ceramic to-go "
                "cup, warm golden morning light streaming through a large window "
                "behind her, steam curling upward, shallow depth of field, cozy "
                "minimalist cafe aesthetic, natural candid framing typical of a "
                "TikTok food video, photorealistic, high detail, 9:16 vertical composition"
            ),
            "aspect_ratio": "9:16",
            "resolution": "1K",
        },
    },
)
task_id = resp.json()["data"]["taskId"]
これが以下で使用する正確な最初のフレームで、1回生成した後に動画ステップへ入力します:
ステップ2:静的画像を動画に変える
hiapi 上のすべてのモデルは同じ非同期タスクパターンに従います:POST でタスクを作成し、完了するまで GET でポーリングし、一時リンクが期限切れになる前に出力をダウンロードします。画像から動画の場合、唯一の違いは input ペイロードです:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kling-3.0-turbo/image-to-video",
    "input": {
      "prompt": "The barista continues pouring steamed milk in a slow spiral, latte art rosetta blooming across the surface of the coffee, steam swirling upward and catching the warm morning light, her hand moves the pitcher in a smooth steady motion, camera holds a subtle slow push-in, natural handheld micro-movement, shallow depth of field, cozy cafe ambience, smooth natural motion, stable cinematic camera movement",
      "image_urls": ["https://static.hiapi.ai/blog/kling-3-0-turbo-image-to-video-short-form-video/first-frame.jpg"],
      "duration": 8,
      "resolution": "1080p"
    }
  }'
その後、結果をポーリングして取得します:
import time, requests

def wait_task(task_id, token, timeout_s=600, poll_interval=5):
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        r = requests.get(
            f"https://api.hiapi.ai/v1/tasks/{task_id}",
            headers={"Authorization": f"Bearer {token}"},
        ).json()
        task = r.get("data") or {}
        if task.get("status") == "success":
            return task
        if task.get("status") == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(poll_interval)
    raise TimeoutError(task_id)

task = wait_task(task_id, HIAPI_API_KEY)
video_url = task["output"][0]["url"]  # temporary link — download it immediately
上に埋め込まれた 8 秒、1080p の動画はこの呼び出しから直接得られたもので、送信からダウンロード可能な .mp4 になるまでおよそ2分半かかりました——手動編集も後処理もありません。
実際の費用
Kling 3.0 Turbo 画像から動画は秒単位で課金され、解像度によって段階的に設定されています(hiapi の料金 に基づき 2026 年 8 月時点で確認済み):
| 解像度 | 1秒あたりの価格 | 5秒動画 | 8秒動画 | 15秒動画 |
|---|---|---|---|---|
| 720p | $0.13/秒 | $0.65 | $1.04 | $1.95 |
| 1080p | $0.16/秒 | $0.80 | $1.28 | $2.40 |
本記事のメイン動画——8 秒 1080p——の費用は $1.28 です。最終レンダリングの前にプロンプトをテストしたり動きの効果を反復したりする場合は、これらの試運転を 720p で行い、動きの効果が期待どおりになってから "resolution": "1080p" にアップグレードしてください。これだけで反復コストを約20%削減できます。
バッチ処理:単一動画からコンテンツカレンダーへ
個別の「バッチ」エンドポイントは存在しないため——同じタスク呼び出しをループで実行するだけです——これをショート動画コンテンツのパイプラインにするのは主に記録作業です:
clips = [
    {"image_url": "https://your-bucket/product-a.jpg", "prompt": "..."},
    {"image_url": "https://your-bucket/product-b.jpg", "prompt": "..."},
    {"image_url": "https://your-bucket/product-c.jpg", "prompt": "..."},
]

results = []
for clip in clips:
    resp = requests.post(
        "https://api.hiapi.ai/v1/tasks",
        headers={"Authorization": f"Bearer {HIAPI_API_KEY}"},
        json={
            "model": "kling-3.0-turbo/image-to-video",
            "input": {
                "prompt": clip["prompt"],
                "image_urls": [clip["image_url"]],
                "duration": 8,
                "resolution": "1080p",
            },
        },
    )
    task_id = resp.json()["data"]["taskId"]
    results.append(wait_task(task_id, HIAPI_API_KEY))
商品画像、人物写真、シーン撮影のフォルダに対してこのコードを一晩中実行すれば、目覚めたときにはすぐに公開できる動画が山ほど手に入ります——各動画の費用は上表のとおりで、予期しない課金項目はありません。既存の写真ではなくテキスト記述から始めたい場合は、対応する Kling 3.0 Turbo テキストから動画ガイド が、同じタスク API を使ってその入り口を紹介しています。
よくある質問
Kling 3.0 Turbo 画像から動画のレンダリングにはどのくらいかかりますか? このテストでは、8 秒 1080p の動画がタスク送信からダウンロード可能なファイルになるまでおよそ2分半かかりました。720p のより短い動画は通常もっと早く完了します。
9:16 の縦向き出力は得られますか?
はい、ただし間接的に実現します——このモデルには aspect_ratio パラメータがありません。出力は常に入力画像のアスペクト比に一致するため、動画タスクを送信する前に最初のフレームを 9:16 で生成またはトリミングしてください。
最初のフレームはどの画像形式に対応していますか?
JPEG または PNG、最大 10MB で、image_urls 配列内に公開 URL として指定します。このモデルの配列は受け付ける画像が1枚だけです。
8 秒 1080p 動画の費用はいくらですか? 確認済みの 1080p 1秒あたり $0.16 の料金に基づき $1.28 です。同じ動画を 720p にすると $1.04 です。
プロンプトは会話やリップシンクに対応していますか?
はい——prompt フィールド(最大 2,500 文字)は会話の引用に対応しており、モデルはそれを使って最初のフレーム内で話している対象のリップシンクアニメーションを駆動できます。
実際に試してみる
上記のすべては実際の /v1/tasks エンドポイントを実際のキーで実行したものです——モック応答もプレースホルダーアセットもありません。眠っている画像ライブラリがあるなら、自分の被写体でモデルの動きの品質を最も早く確かめる方法は、動画を1本試してみることです:Kling 3.0 Turbo 画像から動画モデルページ にアクセスし、最初のフレーム画像を入れるだけで、数分以内に最初の結果が得られます。


