
チュートリアル
seedance-2.0-mini 実践:5 つの高価値な動画生成ユースケースと実装の要点
なぜ動画モデルは単独でユースケース選定を行う価値があるのか
テキストモデルを導入する際、チームは通常コンテキスト長と出力品質だけを気にします。画像モデルでは解像度とスタイル制御にもう少し注意を払います。しかし動画モデルはまったく異なります。入力モダリティと出力時間という 2 つの次元に同時に制約され、この 2 つの次元が素材準備のフロー、呼び出しチェーン、コスト構造を直接決定するからです。
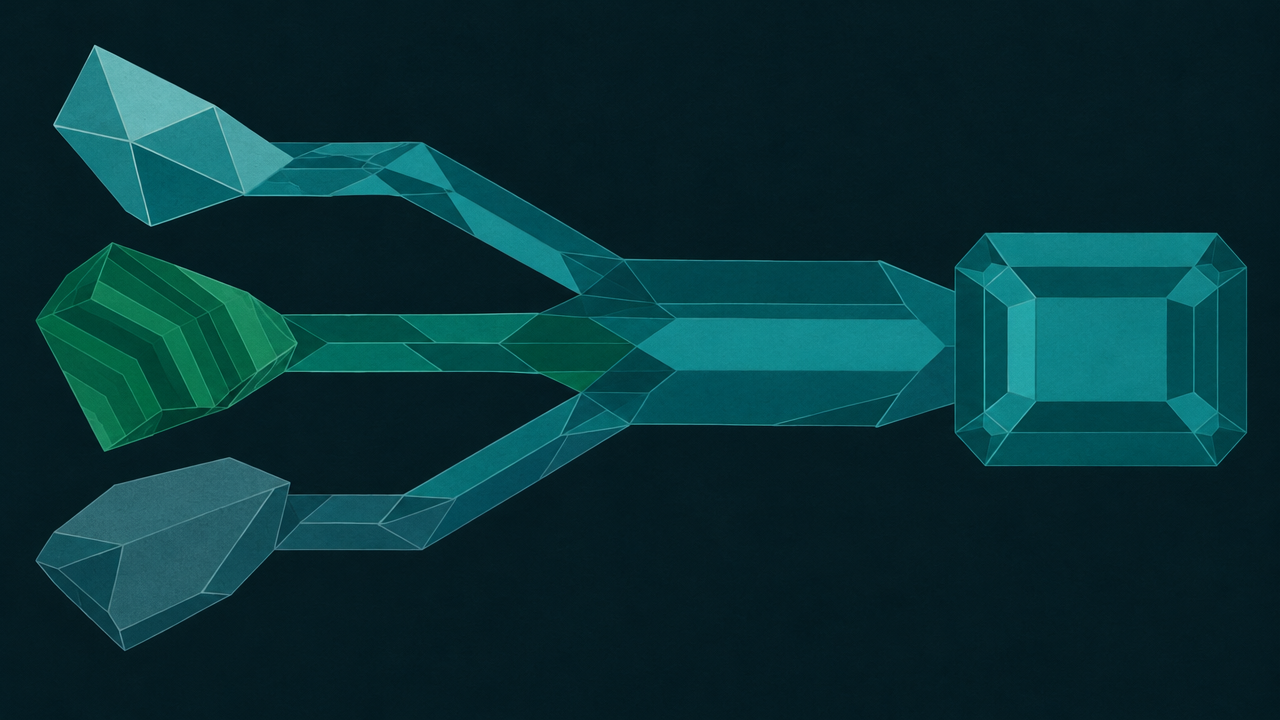
ByteDance の seedance-2.0-mini を例にとると、text-to-video、image-to-video、reference-to-video の 3 つの入力方式をサポートしています。この 3 つは同じインターフェースの 3 つのパラメータではなく、3 つの異なる創作パラダイムです:
- text-to-video はゼロから生成し、自由度が最も高く、制御性が最も低く、探索やバッチバリエーションに適しています;
- image-to-video は 1 枚の画像を最初のフレームまたは視覚アンカーとして、静的素材を動的な映像に変え、制御性は中程度です;
- reference-to-video は参考素材でスタイルと主体を制約し、カットをまたぐ一貫性が必要なシーンに適しています。
選定時にまず 2 つの質問をします:手元にどんな素材があるか?(素材がなければ text-to-video、商品画像があれば image-to-video、一整套の視覚アセットがあれば reference-to-video)出力はどのくらいの長さが必要か?(時間は 1 回の呼び出しコストを直接決定し、何回のリトライを受け入れられるかも決定します)。この 2 つの質問に明確に答えれば、ユースケースはほぼ固まります。以降の 5 つの節はすべてこの枠組みの具体的な展開です。
注意すべきは、動画モデルの失敗コストはテキストモデルよりはるかに高いことです。失敗したリトライは単にトークンが 1 回増えるだけでなく、完全な時間分の費用が余分にかかり、パイプライン全体を遅らせます。したがって動画の導入は最初から「素材—生成—検収—フォールバック」の 4 段階で設計すべきであり、まず 1 回通してからエンジニアリングを補うのではありません。
まず 3 つの入力方式の能力境界を把握する
具体的なユースケースに入る前に、3 つの入力方式ができること・できないことを明確にしておきます。以降の各ユースケースは、そのうちの 1 つまたは複数の組み合わせに帰着します。
text-to-video:説明から直接生成
テキストプロンプトが 1 つあれば、モデルが動画を出力します。強みは素材の敷居がゼロであることで、クリエイティブな探索、バッチバリエーション、コンセプト表現に適しています。代償は主体の細部と画面の一貫性を正確に制御するのが難しく、同じプロンプトでも複数回の呼び出しで結果に差異が出ることです。
書き方の推奨:プロンプトを主体 + シーン + 動作 + カメラ言語 + 時間意図の 5 段に分け、抽象的な形容詞を 1 文に詰め込むのを避けます。業務で固定のブランドカラーや固定の構図が必要な場合、text-to-video は通常最終方案ではなく、初期段階で方向性を探すツールです。
image-to-video:静止画を動かす
1 枚の画像を視覚的な起点として、動きのある動画を生成します。制御点が「テキスト記述」から「最初のフレーム素材」に移るため、素材の品質がほぼ出力品質の下限を決めます。構図が完全で、主体が明確で、背景がきれいな画像の効果が明らかに安定します。
この方式の価値は素材の再利用にあります——既存の商品画像、イラスト、ポスター自体が入力となり、追加撮影は不要です。事前に考える必要があるのは、画面のどの部分が動くべきで、どれが動いてはいけないかです。動きの振幅の想定をプロンプトに書く必要があります。
reference-to-video:参考素材でスタイルと主体を固定する
参考素材でスタイル、人物、または製品の形態を制約し、新しい画面を生成します。これが解決するのは前の 2 方式に共通する課題、すなわちカットをまたぐ視覚的一貫性です。シリーズコンテンツを制作する場合、同一キャラクターの複数クリップ、またはバッチ素材で統一したトーンを保つ必要がある場合、reference-to-video が唯一適切な選択です。
代償は素材準備コストが最も高いことです。参考素材は目標スタイルを代表できる必要があり、かつ無関係な情報が多すぎてモデルを妨げてはいけません。実践的にはまず小バッチで試運転し、参考素材の制約力が想定に合致することを確認してから規模を拡大することを推奨します。
三者の中での役割判断
一言でまとめると:素材がなければ text、画像があれば image、スタイル体系があれば reference です。多くの実際の業務は組み合わせて使用します——text-to-video で方向性を探し、image-to-video で本番カットを出し、reference-to-video でシリーズの一貫性を確保します。
ユースケース 1:EC と商品展示のショート動画
EC は最も典型的な image-to-video のユースケースです。高品質な商品画像が既に手元にあり、必要なのは商品を「展示する」短いカット——わずかな回転、光と影の流れ、部分的なクローズアップの寄り——であり、広告映像を撮り直すことではありません。
入力の準備
商品画像が唯一の核となる入力であり、準備はプロンプトよりも重要です:
- 主体が画面の主体を占め、周囲に動きのスペースを残し、商品が端に寄って動いた後に切れないようにする;
- 背景はできるだけきれいに、単色またはシンプルなシーンは複雑な実写背景より安定する;
- サイズと構図の規範を統一し、同じバッチの商品には同じ撮影またはレタッチテンプレートを使うと、出力の一貫性が明らかに向上する。
プロンプトは動きだけを記述し、商品自体は記述しません——商品情報はすでに画像が担っており、繰り返し記述するとかえって偏差を招きやすいです。カメラの動きの方向、動きの振幅、リズムを重点的に書きます。
フローと検収
フローは固定を推奨:商品画像を入库 → カテゴリ別にプロンプトテンプレートを適用 → 生成 → 人手による抜き取り検査 → 合格品を入库。検収基準は事前に定めておく必要があり、通常 3 点を見ます:主体が変形していないか、動きが自然か、最初のフレームが商品画像と一致しているか。最初のフレームの不一致が最もよくある問題で、素材の構図またはプロンプトの動き記述が強すぎることを示します。
事前に受け入れるべき事実
商品動画の制御性の上限は純粋な画像処理より低く、細かい文字、ロゴ、テクスチャが最も失真しやすいです。精度要求が極めて高いカテゴリでは、生成動画を雰囲気カットや展示トランジションに限定し、詳細ページの核心的なセールスポイント画像にはしないことを推奨します。使わないほうがましで、間違って使ってはいけません。
ユースケース 2:マーケティング素材のバッチバリエーション
配信テストの核心的なニーズは「1 本の良い動画」ではなく「比較可能な一批の動画」です。これこそが text-to-video の主戦場です。同じクリエイティブ方向で、プロンプト内の変数を置き換えることで複数のバリエーションを素早く産出します。
バリエーション管理の鍵:まず変数設計を行う
毎回プロンプト全体を書き換えるのではなく、プロンプトを固定部分と可変部分に分けます。固定部分はブランドトーン、カメラ言語、画面比率などの制約です。可変部分はシーン、主体の動作、リズム、色調方向です。毎回 1〜2 個の変数だけを変えることで、バリエーション間に比較可能性が生まれます——そうでなければ配信データが上がった下がったで、どの変数が効いたのかまったく分かりません。
内部的にバリエーション表を維持することを推奨します:バリエーション番号、変数の組み合わせ、生成時間、配信チャネル、効果データ。この表は生成された動画自体よりも価値があります。なぜならそれは次回の生成の入力になるからです。
バッチ生成のリズム制御
バッチは一度に全部走らせることではありません。「小バッチ検証 → 選別 → 拡大」の 3 段階で進めます。第 1 ラウンドは少数のバリエーションだけを生成して方向性を見て、明らかに不合格なものを人手で除外し、勝ち残った方向に対して生成量を増やします。これにより総時間予算を制御でき、大量の無効動画が審査人力を占有するのを避けられます。
検収と淘汰
バッチのユースケースでは自動または半自動の一次選別を必ず設けます:画面が完全か、明らかな主体の崩壊がないか、時間が想定に合っているか。人手は一次選別を通過したものだけを審査します。淘汰ルールは書き留めておかないと、毎ラウンド同じ問題で繰り返し消耗します。
ユースケース 3:ソーシャルとコンテンツクリエイターの画面補完
コンテンツクリエイターの実際の課題は「カットが足りない」ことです。1 本の動画にトランジションが 1 つ足りない、空鏡が 1 つ足りない、主体の動作が 1 つ足りない、撮り直しのコストが高すぎる。reference-to-video がここでは最適です——既存素材がスタイルを担い、生成部分は缺口を補うだけで済みます。
参考素材でスタイルを固定する
既存の完成フレーム、絵コンテ画像、または視覚設定を参考入力として、生成画面を既存コンテンツの色調、質感、構図の習慣に近づけます。参考素材の選択原則は少なく正確にです。目標スタイルを最もよく代表する 2〜3 枚の画像は、類似度の低い十数枚の素材よりも効果的です。素材が雑すぎると、モデルはどの特徴を必須で保持すべきか判断しにくくなります。
作り直しではなく補完
このユースケースの正しい使い方は補完であり、代替ではありません。生成クリップは編集段階で実素材と拼接するため、冒頭と末尾のフレームの接続、运镜方向、動きの速度に追加の要件があります。プロンプトには「前後のカットと接続する」動きの制約を明記する必要があります。例えば寄りの方向、主体の向きなどです。
失敗のフォールバック
補完タイプの生成は純粋な展示ユースケースより失敗率が高く、制約が多いためです。各缺口に対して 2 セットの代替方案を用意することを推奨します。生成が 2 回失敗したら、生成動画を使わない代替編集方案(静止画に動きを付ける、既存素材を速度変更して再編集)に退避し、コンテンツ全体を 1 つのカットで詰まらせないようにします。
ユースケース 4:アプリ内の動的ビジュアルとモーション素材
モデル生成のショート動画を製品 UI に使うことは、ここ数年で自然な一歩となっています:ローディング画面、空状態、雰囲気背景、カードのホバーアニメーション。静止画に動きを 1 層加えるだけでは物足りず、フレームごとにモーションを設計するコストは高いです。
時間が第一の制約
UI モーションはごく短い動きだけで十分で、通常 1〜数秒です。これは設計要件であると同時にコスト上の強みでもあります——出力秒数で課金される場合、短い時間は 1 回の呼び出しコストが低く、リトライの余地が大きいことを意味します。設計段階で目標時間を固定すべきで、先に生成してから切り取るのではありません。切り取るということは使わない秒数に費用を払ったということです。
image-to-video を優先
UI モーションは通常、明確な最初のフレームのデザイン稿があり、image-to-video が第一選択です。デザイン稿自体が入力となり、出力の動きの方向が制御可能です。text-to-video はここではむしろブランドの視覚規範に合わせにくく、修正を繰り返しやすいです。
エンジニアリングで追加考慮すべきこと
- ファイルサイズとローディング:生成動画をクライアントに直接入れる前に圧縮とトランスコードを行い、導入前に目標ビットレートを確認する;
- 降級方案:弱いネットワークや低スペック端末では静止画にフォールバックし、モーションを可用性のリスク点にしない;
- 素材の再利用:UI モーションは長期的な資産で、1 回生成した後にキャッシュして再利用でき、毎回ページを開くたびに再生成する必要はない。
検収時はループが自然か、冒頭と末尾のフレームが接続しているか、異なる画面比率で主体が画面外に出ていないかを重点的に見ます。
ユースケース 5:プロトタイプと概念実証の迅速な可視化
製品の初期段階では社内外を説得する必要がありますが、予算と時間は正式な動画を許しません。この時 text-to-video が最良のコミュニケーションツールです:説明でリズムと雰囲気を表現できるクリップを生成し、抽象的なアイデアを議論可能な対象に変えます。
期待値を正しく設定する
プロトタイプ動画の位置づけは「コミュニケーション材料」であり、「納品材料」ではありません。主体の精度、細部の一貫性は重要ではなく、重要なのはカメラのリズム、情緒のトーン、物語の順序が想定に合っているかです。チームは明確な共通認識を持つ必要があります:この段階の産出物は直接製品には入らず、その価値は意思決定サイクルを短縮することにあります。
少数の高情報量な呼び出しで大量の試行錯誤を代替する
プロトタイプ段階で最もよくある間違いは、狂ったように生成して 1 つずつ見ることです。時間がかかるうえに焦点が定まりません。より効果的な方法は、まずアイデアをいくつかのキーカットに分け、各カットは 1〜2 版だけ生成し、素早く絵コンテ動画に拼接することです。レビューのフィードバックはテキストレベルに戻し、次のラウンドで何を生成するかを決めます。動画の海の中で選ぶのではありません。
境界と収尾
プロトタイプ検証が通った後、正式生産は通常 image-to-video または reference-to-video に切り替え、より強い制御性と一貫性を得ます。この切り替え点を事前にプロジェクト計画に書き込むことで、チームがプロトタイプ素材に過度に投入するのを避けられます。
コスト、レイテンシ、安定性のエンジニアリング要点
前述の 5 つのユースケースは最終的に同じエンジニアリング問題群に帰着します:呼び出しにいくらかかるか、失敗をどう処理するか、結果をどう再利用するか。seedance-2.0-mini は出力秒数で課金され、この課金口径が最適化の方向を決定します——動画の長さに費用を払うので、時間が予算単位です。
時間制御:まず時間を決め、それからプロンプトを書く
先に生成してからどれくらいの長さかを見るのではなく、目標時間を入力制約としてフローに書き込みます。各業務ラインに時間上限を設定し、上限を超える需要は複数の短いクリップに分けてから拼接します。バッチタスクは実行前に総出力秒数を先に算出し、今回のバッチの予算上限とし、予算超過なら停止して選別段階に戻ります。
リトライ戦略:回数に上限を設け、降級を事前に用意する
失敗リトライは動画コストの主要な漏えい点です。ユースケース別にリトライ回数の上限(通常 1〜2 回)を設定し、リトライのトリガー条件を明確にすることを推奨します:技術的な失敗にのみリトライし、「画面が想定に合わない」場合は自動リトライせず、プロンプトまたは素材レベルに戻って修正します。各ユースケースには必ず降級パスを用意します——静止画代替、既存素材の再編集、または直接テキスト説明にする——これにより業務フローが生成失敗で中断しないことを保証します。
キャッシュ:同じ入力に二度払わない
動画結果はキャッシュ可能な資産です。「入力素材ハッシュ + プロンプト + 時間パラメータ」をキャッシュキーとし、ヒットすれば直接返します。これは UI モーションと商品展示のユースケースで特に有効です。この 2 種類の素材は再利用率が高く、キャッシュヒットが総出力秒数を大幅に削減できるからです。
検収チェックリスト
- 入力素材がそのユースケースの規範(構図、鮮明度、背景のきれいさ)に合っているか;
- 目標時間が固定されているか、バッチ予算内か;
- 失敗判定基準とリトライ上限があるか;
- 降級方案とキャッシュキー設計があるか;
- 生成結果に統一された抜き取り検査と入库フローがあるか。
安定導入の最後の一環
動画機能を製品に組み込む際、HiAPI.ai のインターフェースを統一して経由し、同じ呼び出しとエラー処理ロジックで text-to-video、image-to-video、reference-to-video の 3 つの入力方式をカバーし、能力ごとに別々のチェーンを維持するのを避けることを推奨します。パラメータの細部と課金口径はサイトのドキュメントと価格パネルを基準とし、エンジニアリング側は時間予算、リトライ上限、キャッシュ戦略を設定可能な項目にするだけで済みます。
動画生成は「接続すれば使える」能力ではなく、素材ガバナンス、時間ガバナンス、失敗ガバナンスが必要なパイプラインです。まずこの 5 種類のユースケースの中で最も自分に近い 1 つを閉ループさせ、それから横に拡張するほうが、最初からすべてのユースケースを敷き詰めるより割に合います。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする