
사용 가이드
Vidu Q4 Preview 참조 기반 영상 생성: 내레이션과 브랜드가 포함된 숏폼 영상
9:16 숏폼 영상을 엔드투엔드로 완성하기: 브랜드 소재 패키지와 음성 하나를 고정하고, 클립을 일괄 생성하며, 4K 마스터로 제작해 최종적으로 1080p로 전달합니다.
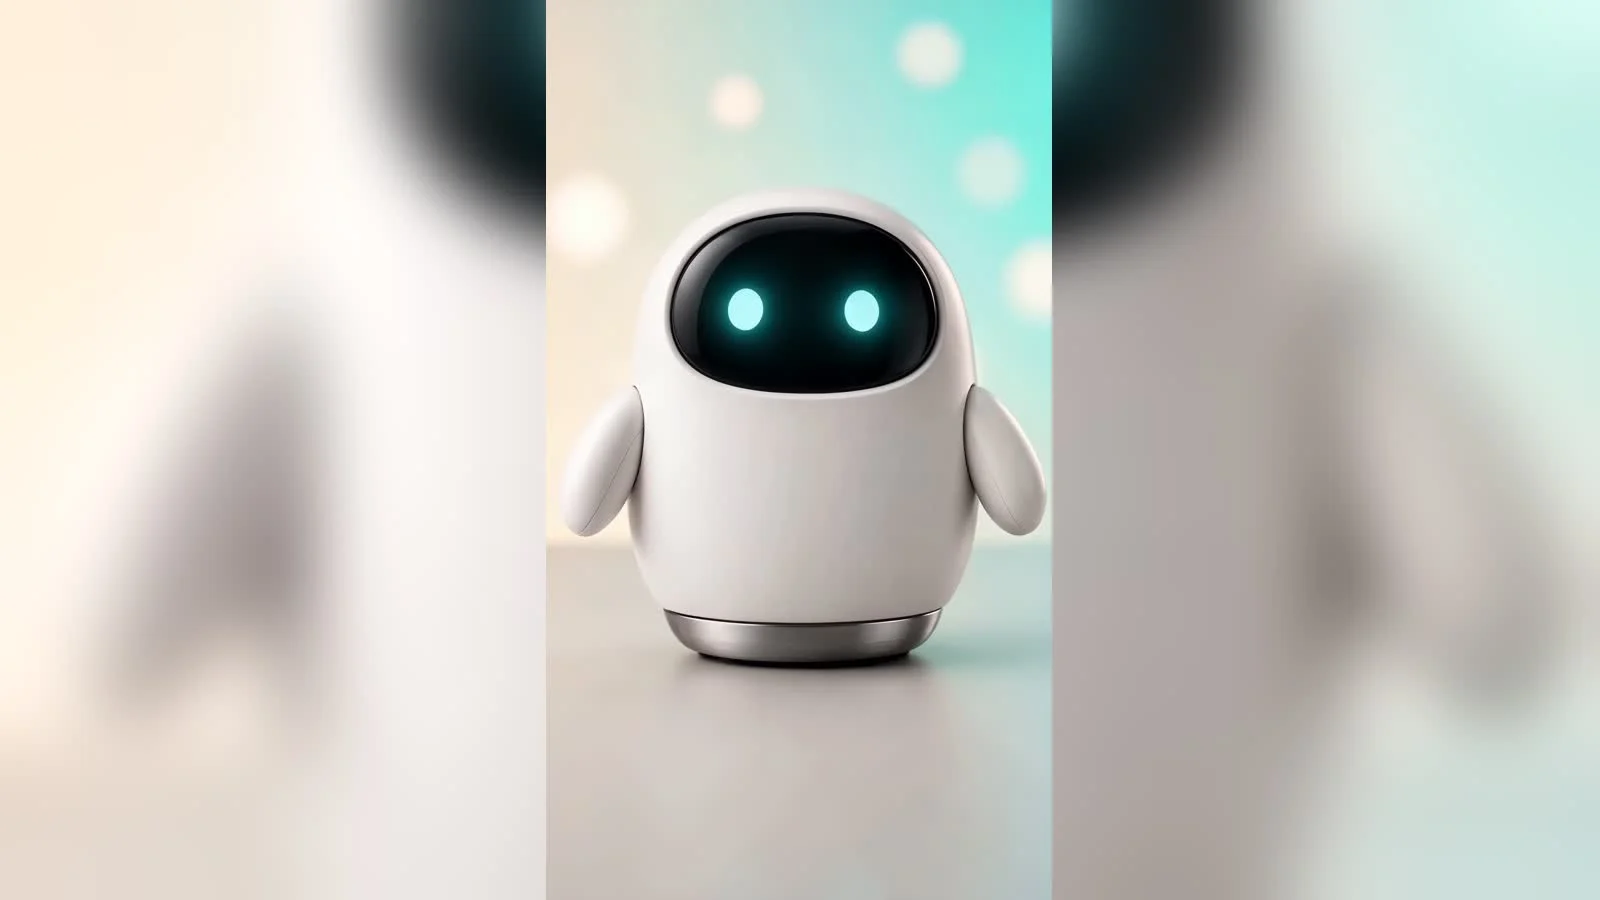
대부분의 숏폼 「AI 영상」 튜토리얼은 보기 좋은 독립 클립 하나를 만드는 법만 알려주지만, 브랜드 숏폼 영상에 필요한 것은 정반대입니다: 연속된 서너 개의 클립에서 동일한 마스코트, 동일한 제품, 동일한 내레이션 음성이 모든 장면을 관통해야 합니다. 바로 이 일관성이 vidu-q4-preview/reference-to-video의 용도입니다. 소량의 참조 이미지(그리고 선택적으로 음성 샘플)를 주면, 이후 모든 렌더링에서 이 소재를 재사용하므로 매번 외형을 새로 굴리는 일이 없습니다.
이 글은 프롬프트 목록이 아니라 워크플로 실전 해설입니다. 저는 약 14초짜리 세로형 숏폼 영상 하나—훅, 내레이션이 있는 본문, 행동 유도—을 이미지 두 장으로 구성된 브랜드 소재 패키지와 음성 샘플 하나만으로 엔드투엔드로 제작했습니다. 그런 다음 일괄 생성하고, 이어 붙이고, 9:16 피드에 맞는 완성품으로 내보냈습니다. 아래의 모든 클립, 모든 비용, 모든 필드는 hiapi의 Vidu Q4 Preview 참조 기반 영상 생성 모델에서 이번에 실제로 실행한 결과입니다.
핵심 요약
- 브랜드 소재 패키지는 한 번만 고정합니다.
reference_image_urls(1–15장의 이미지)는 캐릭터와 제품을 일관되게 유지하고,reference_audio_urls(최대 3개)는 내레이션 음성을 일관되게 유지합니다. 숏폼 영상의 모든 클립이 같은 소재 패키지를 재사용합니다. - 네이티브 세로 촬영.
aspect_ratio: "9:16"은 진짜 1080×1920(4K에서는 2160×3840) 화면을 렌더링하므로 사후 크롭이 필요 없습니다. - 4K로 마스터, 1080p로 전달. 4K 출력은 2160×3840 HEVC/H.265입니다. 이를 H.264로 재인코딩하고 1080×1920으로 다운샘플링해 피드에 게시합니다. 저는 훅은 4K로 유지하고 본문/CTA는 1080p로 만들었습니다.
- 일괄 제출하고 기다리지 마세요. 비동기 작업 API이므로 세 클립을 모두 먼저 제출한 뒤 폴링합니다. 실제 소요 시간은 세 클립의 합이 아니라 가장 느린 클립에 따라 결정됩니다.
- 초 단위로 예산을 계산하세요. 1080p는 초당 $0.1375, 4K는 초당 $0.446이며
duration기준으로 청구됩니다. 제 삼클립 숏폼 영상의 영상 비용은 $3.16이었습니다.
내레이션이 있는 숏폼 영상에 참조 기반 영상 생성이 적합한 이유(그리고 이미지 기반 영상 생성이 부적합한 이유)
커머스 숏폼 영상에는 고정 구조가 있습니다—스크롤을 멈추게 하는 훅, 설명하는 본문, 전환을 유도하는 CTA. 각 구간을 따로 렌더링하면 가장 큰 위험은 동작 품질이 아니라 드리프트입니다: 마스코트 비율이 바뀌고, 제품 질감이 달라지고, 목소리가 다른 브랜드처럼 들립니다. 참조 기반 영상 생성은 이 문제를 정면으로 해결합니다:
reference_image_urls는 시각적 잠금장치입니다. 캐릭터 초상화 한 장과 제품 정지 이미지 한 장이 세 클립의 고정 소재 패키지가 됩니다. 프롬프트에서 순번으로 이들을 가리키면(「참조 이미지 1의 로봇」「참조 이미지 2의 기기」) 모델이 어떤 소재가 무엇인지 알 수 있습니다.reference_audio_urls는 음성 잠금장치입니다. 짧은 음성 샘플을 전달해 내레이션이 있는 모든 클립에서 재사용하면 음성 트랙이 같은 음색을 유지합니다. (Vidu Q3도 이 필드를 받으므로 음성 참조가 Q4만의 장점은 아닙니다—Q4가 Q3보다 나은 점은 4K 출력과 최대 15장의 참조 이미지입니다.)- 4K + 네이티브 9:16은 이후 재구성하거나 다른 용도로 쓸 수 있는 깨끗한 세로 마스터를 제공합니다.
이것이 이미지 기반 영상 생성과의 경계입니다. Vidu Q4 Preview 이미지 기반 영상 생성 모델은 단일 첫 프레임을 움직이게 하는 것—단일 샷에는 적합하지만 여러 클립의 시퀀스에서 캐릭터, 제품, 음성을 동시에 일관되게 유지할 수는 없습니다. 전달물이 한 박자가 아니라 완성된 숏폼 영상 한 편일 때 참조 기반 영상 생성이 필요합니다.
1단계—브랜드 소재 패키지를 한 번에 구축
숏폼 영상 전체가 참조 정지 이미지 두 장과 음성 클립 하나로 돌아갑니다. 저는 hiapi에서 정지 이미지 두 장을 생성했습니다(깨끗하고 조명이 좋은 스튜디오 이미지면 무엇이든 됩니다—모델이 형태, 질감, 색을 읽으므로 단색 배경이 주체를 분리하는 데 도움이 됩니다):
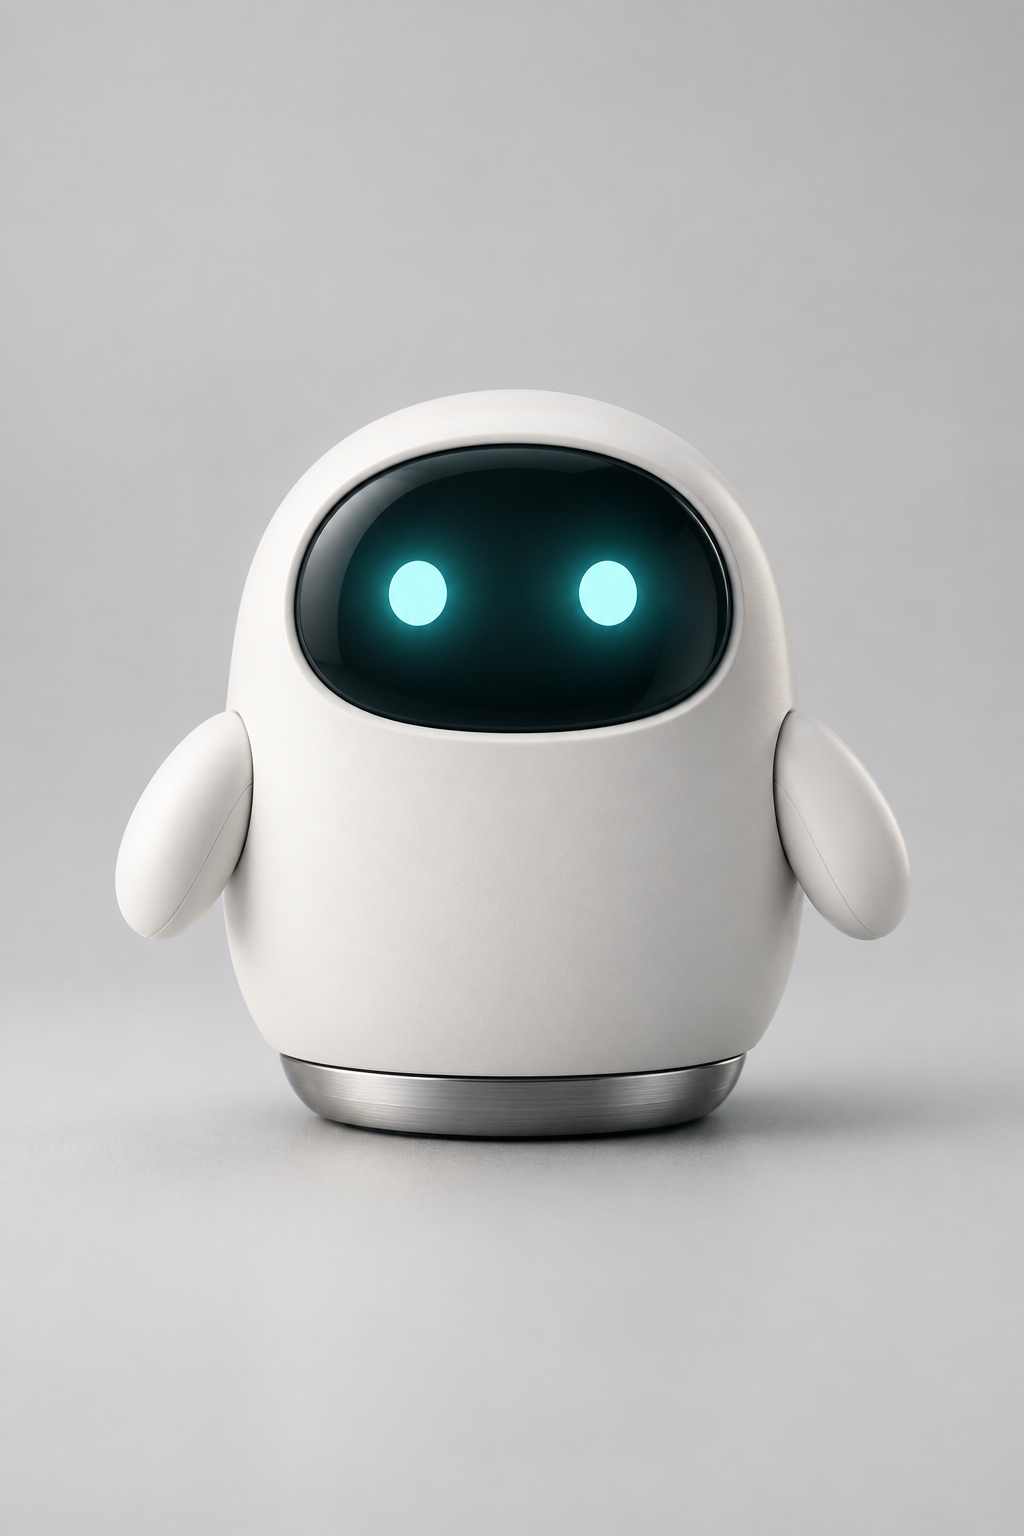
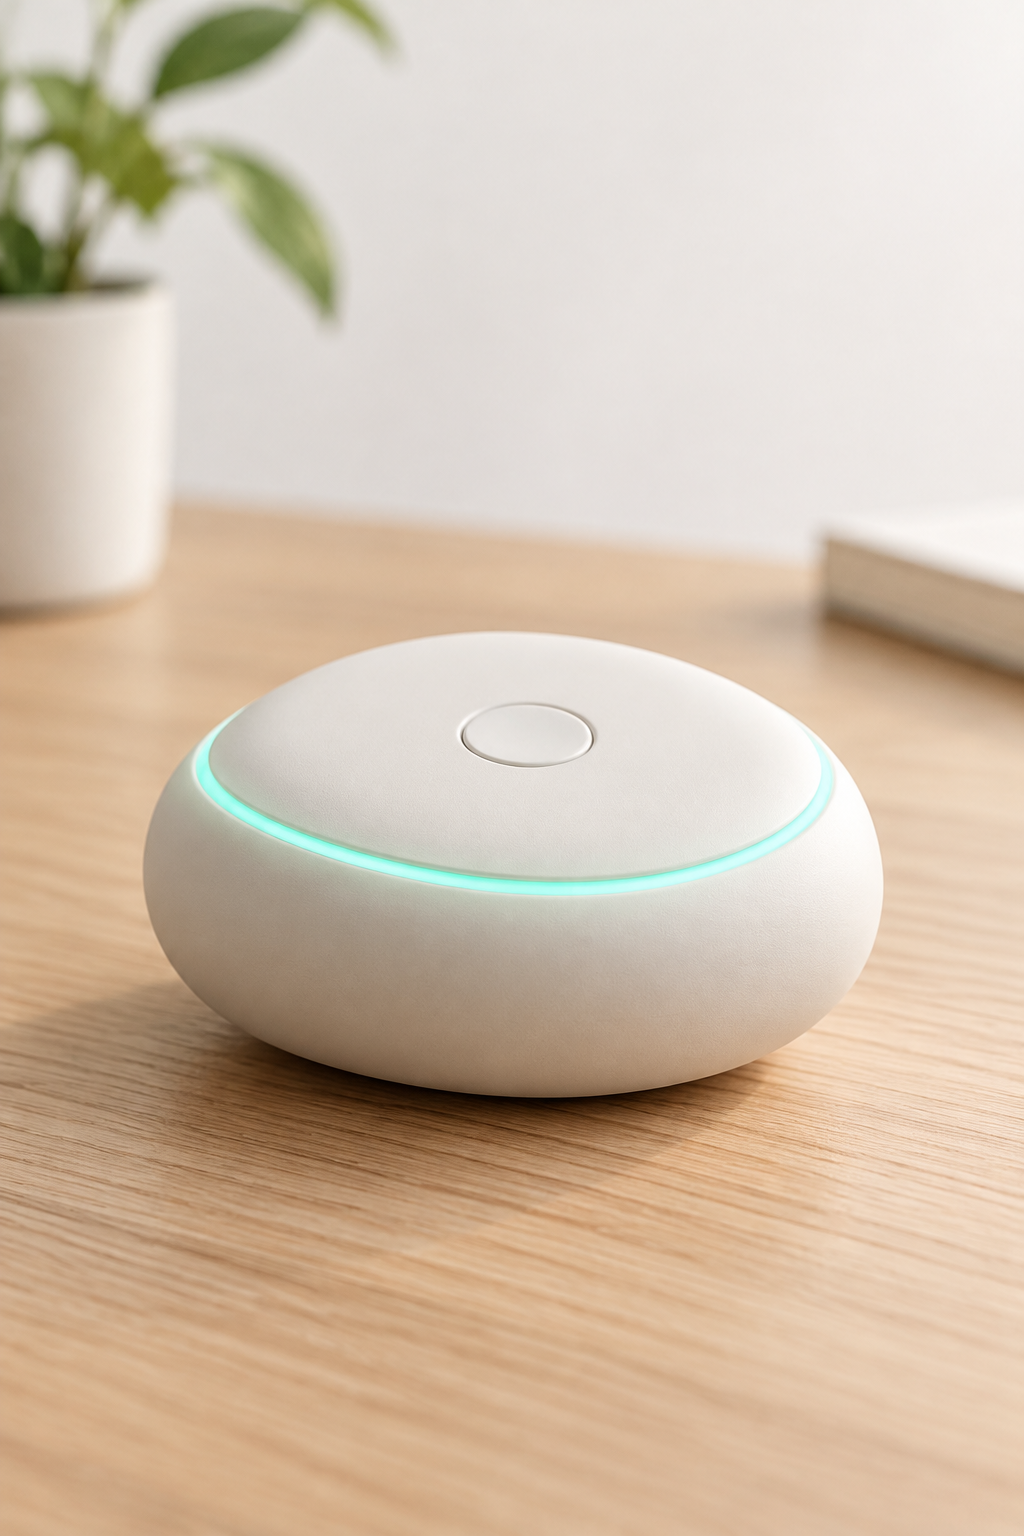
음성은 텍스트 음성 변환 모델로 약 10초짜리 내레이션 샘플을 만들어 공개 URL에 업로드했고, 그 파일이 내레이션 클립의 음성 참조가 되었습니다. 소재 패키지의 핵심은 재사용입니다: 이 세 소재 URL을 아래의 모든 관련 요청에 붙여 넣으며, 이것이 클립을 세 개 렌더링하든 서른 개 렌더링하든 숏폼 영상이 일관성을 유지하는 이유입니다.
중요한 준비 규칙 몇 가지:
- 참조 정지 이미지에는 깨끗하고 균일한 배경을 사용해 주체가 명확히 구분되게 하세요.
- 제출 전에 모든 참조 소재(이미지와 오디오)를 접근 가능한 공개 URL에 호스팅하세요—작업 API가 서버 측에서 이를 가져옵니다.
- 브랜드의 표준 화면 비율을 미리 정하세요. 피드 숏폼 영상이라면 모든 클립에
9:16을 사용합니다.
2단계—훅(4K 렌더링, 1080×1920으로 내보내기)
오프닝 클립의 임무는 하나입니다: 첫 프레임부터 움직임을 주는 것. 저는 의도적으로 4K로 렌더링했습니다—피드에 4K가 필요해서가 아니라(그렇지 않습니다), 2160×3840 마스터가 확대, 다른 게재 위치용 1:1 또는 16:9 재구성, 고품질 아카이브 보존의 여지를 주기 때문입니다. 그런 다음 플랫폼용 1080×1920 사본을 내보냅니다.
제가 실행한 프롬프트(참조 이미지 한 장, 오디오 없음):
The rounded white robot mascot from reference image 1 bounces up into the
centre of a bright minimalist desk scene, its teal eyes brightening as it
gives a cheerful two-arm wave toward the camera. Soft studio light, shallow
depth of field, gentle bokeh, clean pastel background, playful energetic
motion, subtle teal rim light. Vertical social-video framing.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg"],
    "resolution": "4k",
    "duration": 4,
    "aspect_ratio": "9:16"
  }
}
실제로 반환되어 확인된 결과: 4초짜리 2160×3840 파일—이로써 resolution이 고정 라벨이 아니라 9:16 화면의 짧은 변을 설정한다는 점이 확인되었습니다. 4K 출력은 HEVC/H.265(10-bit)로 전달되어 대부분의 브라우저와 일부 편집 소프트웨어에서 인라인 재생이 불가능하므로, 여기서 유일하게 생략할 수 없는 단계는 재인코딩입니다:
ffmpeg -i hook_4k.mp4 -vf "scale=1080:1920" \
  -c:v libx264 -profile:v high -pix_fmt yuv420p -crf 20 \
  -c:a aac -movflags +faststart hook_1080.mp4
이렇게 하면 어디서나 재생되는 H.264 1080×1920 클립을 얻고, 4K 원본은 마스터로 보존됩니다. (4K 마스터가 필요 없다면 훅을 바로 1080p로 렌더링하고 다운샘플링을 건너뛰세요—초당 비용도 약 3배 저렴합니다.)
3단계—내레이션이 있는 본문(음성 참조)
소재 패키지 전체를 사용하는 클립입니다: 참조 이미지 두 장과 음성 샘플. 모델이 마스코트를 제품 옆에 배치하고, 말하게 하며, 참조 오디오의 음색을 빌려옵니다.
The white robot mascot from reference image 1 stands beside the matte-white
pebble focus device from reference image 2 on a tidy wooden desk, turns to the
camera and speaks warmly, gesturing toward the glowing teal device as if
introducing it; it speaks in the voice of reference audio 1. Soft daylight,
cosy home-office background, gentle handheld sway, friendly inviting mood.
Vertical framing.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg",
                             "https://.../paxel-device.jpg"],
    "reference_audio_urls": ["https://.../paxel-narrator.mp3"],
    "resolution": "1080p",
    "duration": 6,
    "aspect_ratio": "9:16"
  }
}
이번 실행에서 알아야 할 두 가지:
- 필드명은
reference_audio_urls입니다.voice_reference_urls를 시도했더니 API가 거부했습니다(additional properties 'voice_reference_urls' not allowed). 정확한 이름을 사용하세요. 최대 세 개의 오디오 클립을 받습니다. - 어쨌든 모든 출력에는 AAC 오디오 트랙이 포함됩니다. 오디오 참조가 없는 클립도 사운드 트랙과 함께 반환됩니다. 차이는 레벨에서 드러납니다: 제 내레이션 본문 클립은 평균 음량이 약 -20 dB로 측정되어—분명한 인물 음성 클립—거의 무음인 CTA는 약 -35 dB였습니다. 일련의 영상에서 일관된 내레이션을 원한다면 내레이션이 있는 모든 클립에 동일한 오디오 URL을 재사용하세요. 음성을 한 번에 고정하는 이유가 바로 이것입니다.
4단계—CTA
짧고 강한 마무리: 마스코트가 제품과 상호작용하고, 브랜드의 청록색 포인트가 켜지고, 이내 카메라를 다시 바라봅니다. 참조 이미지 두 장을 모두 사용하고, 이번에는 음성 없이.
Close vertical shot: the white robot mascot from reference image 1 reaches out
and taps the top button of the pebble device from reference image 2; the teal
LED ring pulses to life with a soft glow, and the mascot looks up at the camera
with bright teal eyes and a small confident nod. Clean minimalist desk, soft
light, crisp focus, upbeat finish. Vertical framing.
1080p로 4초 렌더링—제품의 청록색 고리가 참조 정지 이미지의 색을 유지하며, 이것이 기기를 텍스트로 설명하지 않고 전용 참조 이미지로 제공한 보답입니다.
5단계—렌더링을 일괄 제출하고, 붙잡고 있지 마세요
참조 기반 영상 생성은 비동기 작업 API입니다: POST로 작업을 제출하고 taskId를 받은 뒤 결과를 폴링합니다. 삼클립 숏폼 영상이라면 세 개를 모두 먼저 제출하고 그다음에 폴링하세요—실제 소요 시간은 세 개의 합이 아니라 가장 느린 클립이 됩니다.
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
H = {"Authorization": "Bearer YOUR_KEY", "Content-Type": "application/json"}

clips = [hook_input, body_input, cta_input]   # the three input dicts above
ids = []
for c in clips:
    r = requests.post(BASE, headers=H, json={
        "model": "vidu-q4-preview/reference-to-video", "input": c})
    ids.append(r.json()["data"]["taskId"])     # save IDs immediately

results = {}
while len(results) < len(ids):
    for tid in ids:
        if tid in results:
            continue
        data = requests.get(f"{BASE}/{tid}", headers=H).json()["data"]
        if data["status"] == "success":
            results[tid] = data["output"][0]["url"]   # download now — URLs expire
        elif data["status"] == "fail":
            results[tid] = None                        # handle/retry
    time.sleep(6)
각 taskId를 받는 즉시 저장하고, 작업이 성공하면 즉시 출력 URL을 다운로드하세요—만료되는 직링크입니다. 전체 통합 규약—폴링, 콜백, 멱등성, 검증 오류 표—는 Vidu Q4 Preview 참조 기반 영상 생성 API 가이드와 tasks API 참조를 참고하세요.
6단계—이어 붙이고 피드용으로 내보내기
클립 세 개를 다운로드한 뒤 ffmpeg로 숏폼 영상을 조립합니다. 먼저 모든 클립을 동일한 코덱, 해상도, 프레임레이트로 맞춘 다음(제 클립은 24 fps로 반환되어 30으로 재인코딩했습니다) 이어 붙입니다:
ffmpeg -i hook_1080.mp4 -i body.mp4 -i cta.mp4 \
  -filter_complex "[0:v][0:a][1:v][1:a][2:v][2:a]concat=n=3:v=1:a=1[v][a]" \
  -map "[v]" -map "[a]" -c:v libx264 -pix_fmt yuv420p \
  -c:a aac -movflags +faststart short_full.mp4
이렇게 하면 이 페이지 상단의 14초 1080×1920 숏폼 영상이 생성됩니다. 숏폼 영상에 중요한 내보내기 참고 사항:
- 세로 유지, 짧게 유지.
duration은 클립당 3~16초의 정수입니다. 3~4개 클립 시퀀스는 피드의 주의 지속 시간 안에 쉽게 들어옵니다. - 4K 마스터는 다운샘플링하세요. 조립 버전에는 HEVC 원본이 아니라 훅의 1080×1920 내보내기를 사용했습니다.
- 오디오 트랙을 주의하세요. 모든 클립에 AAC가 포함되므로 이어 붙일 때 무음이라고 가정하지 말고 레벨을 의도적으로 설정하세요.
비용
가격은 출력 초 단위로 계산되고 해상도별로 고정되며 duration을 곱합니다(실시간 가격 페이지로 확인):
| 해상도 | 가격 / 초 |
|---|---|
| 540p | $0.0515 |
| 720p | $0.109 |
| 1080p | $0.1375 |
| 2K | $0.2175 |
| 4K | $0.446 |
제 숏폼 영상의 실제 비용:
| 클립 | 해상도 | 길이 | 비용 |
|---|---|---|---|
| 훅 | 4K | 4초 | $1.784 |
| 본문(음성) | 1080p | 6초 | $0.825 |
| CTA | 1080p | 4초 | $0.550 |
| 영상 합계 | 14초 | $3.159 |
브랜드 소재 패키지 준비—참조 정지 이미지 두 장과 짧은 TTS 음성 샘플—는 몇 센트만 추가됩니다. 가장 큰 비용 변수는 훅의 4K입니다: 이를 1080p로 낮추면 전체 숏폼 영상이 약 $1.92로 내려갑니다. 재구성 가능한 마스터가 정말로 필요할 때만 훅을 4K로 렌더링하세요.
필드 참조(숏폼 영상 빠른 참조표)
| 필드 | 설명 |
|---|---|
prompt |
필수. 순번으로 참조 소재를 가리키세요(「참조 이미지 1」「참조 오디오 1」). |
reference_image_urls |
필수. 배열, 1–15장의 이미지. 시각적 브랜드 소재 패키지. |
reference_audio_urls |
선택. 배열, 최대 3개. 음성 잠금장치. 정확한 필드명—voice_reference_urls는 거부됩니다. |
resolution |
540p / 720p / 1080p / 2k / 4k. 짧은 변을 설정. 4K는 HEVC로 반환. |
duration |
정수, 3–16초. (99 같은 값은 400 … want 16을 반환합니다.) |
aspect_ratio |
16:9 / 9:16 / 1:1 / 4:3 / 3:4. 피드 네이티브 세로는 9:16. |
자주 묻는 질문
프롬프트 레시피 글과 무엇이 다른가요? 다릅니다. 참조 기반 영상 생성 프롬프트 레시피는 복사해 붙여 넣는 독립 창의적 샷입니다. 이 글은 완성된 숏폼 영상의 제작 파이프라인—브랜드 소재 패키지를 고정하고, 클립을 일괄 생성하고, 시퀀스로 이어 붙인 9:16 전달물을 내보내는 일입니다.
음성 참조를 반드시 사용해야 하나요?
아니요—reference_audio_urls는 선택입니다. 없어도 클립은 렌더링되며(여전히 AAC 오디오 트랙 포함) 일련의 영상에서 일관된 내레이션을 원할 때 추가하면 됩니다.
숏폼 영상 전체를 4K로 렌더링할 수 있나요? 가능하지만 피드용으로는 거의 가치가 없습니다: 4K는 초당 $0.446이고 1080p는 초당 $0.1375이며, 피드는 어차피 1080×1920으로 표시합니다. 4K는 재구성하거나 다른 용도로 쓸 수 있는 샷에 남겨두세요.
클립 하나는 얼마나 길 수 있나요?
duration은 클립당 최대 16초입니다. 숏폼 영상이라면 클립당 3–6초, 3–4개 클립 시퀀스가 최적 구간입니다.
4K 파일이 재생되지 않는 이유는 무엇인가요?
4K는 HEVC/H.265(10-bit)로 반환됩니다. 2단계에서 보여준 대로 H.264 yuv420p로 재인코딩하고 +faststart를 추가해 웹과 대부분의 편집 소프트웨어에 맞추세요.
나만의 브랜드 숏폼 영상 만들기
이 패턴은 어떤 마스코트, 제품, 출연자에도 적용됩니다: 참조 소재 패키지를 고정하고, 순번으로 이를 참조하는 프롬프트 세 개를 쓰고, 일괄 렌더링한 뒤 이어 붙이세요. Vidu Q4 Preview 참조 기반 영상 생성 모델 페이지에서 시작하고, 빠른 시작에서 API 키를 받아 오늘 오후에 첫 세로형 숏폼 영상을 게시하세요.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트