
Guida all'uso
Vidu Q4 Preview reference-to-video: video brevi con voce fuori campo e branding
Realizza un video breve 9:16 end-to-end: blocca un kit di asset di brand e una voce, genera le clip in batch, monta su master 4K e consegna in 1080p.
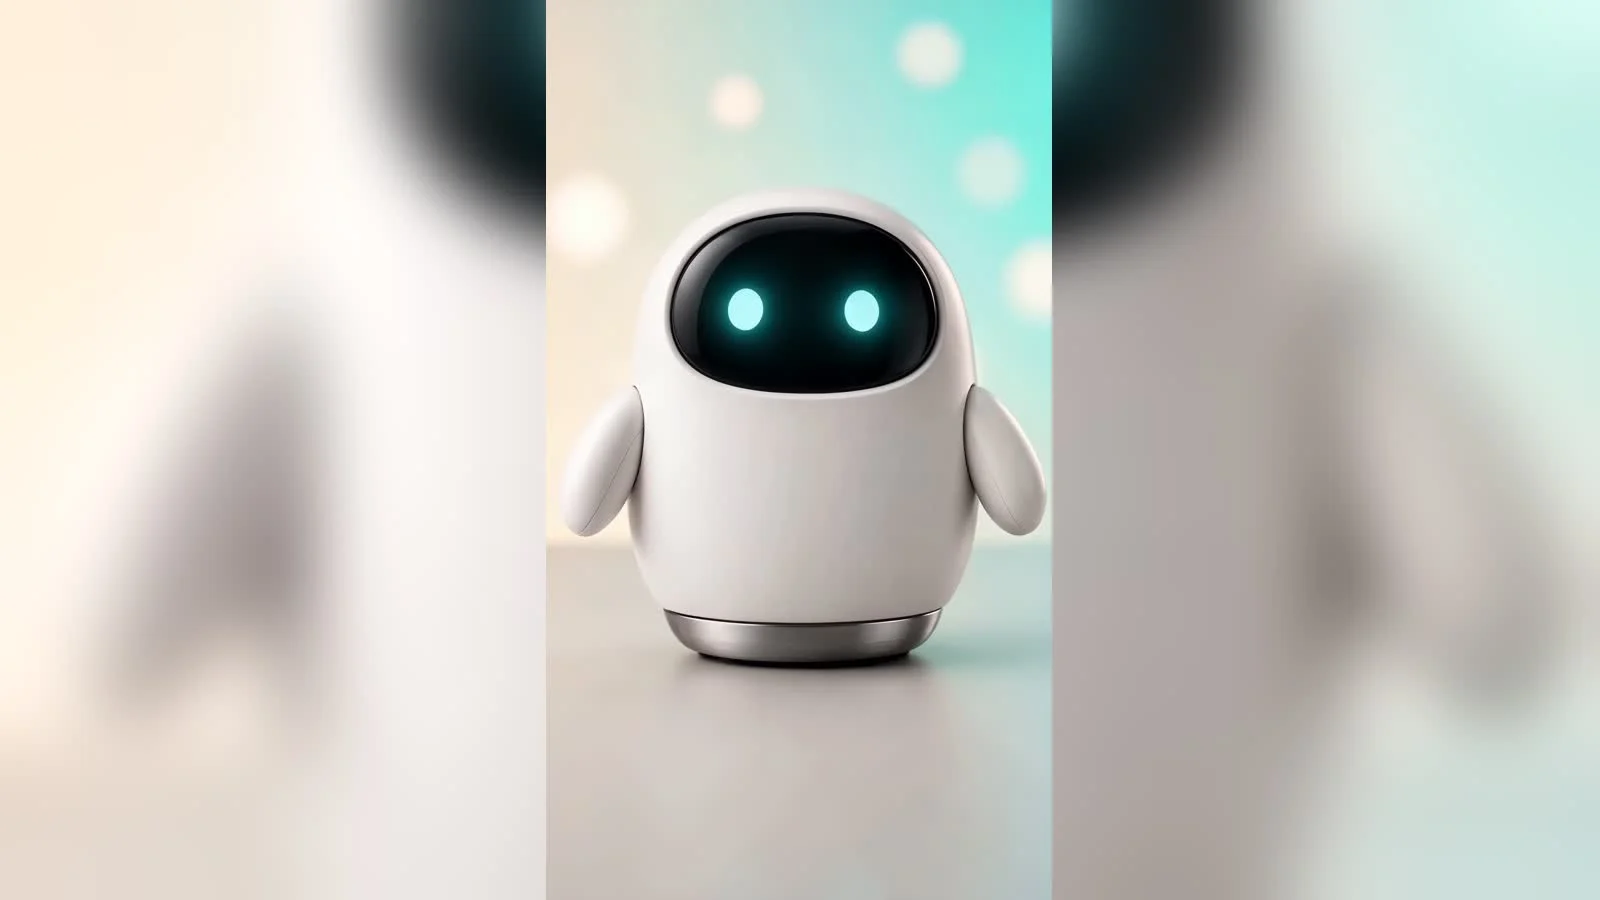
La maggior parte dei tutorial «AI video» per i video brevi ti insegna a realizzare una singola clip bella e autonoma, mentre un video breve di brand richiede esattamente l'opposto: in tre o quattro clip consecutive, lo stesso mascotte, lo stesso prodotto e la stessa voce fuori campo devono attraversare ogni inquadratura. È proprio qui che entra in gioco vidu-q4-preview/reference-to-video: gli passi un piccolo set di immagini di riferimento (e facoltativamente un campione vocale), e ogni rendering successivo riutilizza quel set invece di rilanciare i dadi dell'aspetto ogni volta.
Questo è un resoconto pratico di un workflow, non un elenco di prompt. Ho realizzato end-to-end un video breve verticale di circa 14 secondi — hook, corpo con voce fuori campo, call to action — usando solo un kit di brand composto da due immagini e un campione vocale, poi ho generato in batch, montato ed esportato un prodotto pronto per il feed 9:16. Ogni clip, ogni costo e ogni campo qui sotto proviene da un'esecuzione reale su Vidu Q4 Preview reference-to-video di hiapi.
TL;DR
- Blocca il kit di brand una volta sola.
reference_image_urls(da 1 a 15 immagini) mantiene coerenti il personaggio e il prodotto;reference_audio_urls(fino a 3) mantiene coerente la voce fuori campo. Ogni clip del video breve riutilizza lo stesso kit. - Gira nativamente in verticale.
aspect_ratio: "9:16"produce un vero 1080×1920 (2160×3840 in 4K) — senza ritagli in post-produzione. - Master in 4K, consegna in 1080p. L'output 4K è HEVC/H.265 2160×3840; ricodificalo in H.264 e ridimensionalo a 1080×1920 per la pubblicazione sul feed. Io ho tenuto l'hook in 4K e corpo/CTA in 1080p.
- Invia in batch, non restare ad aspettare. È un'API di task asincrona — invia tutte e tre le clip prima, poi esegui il polling. Il tempo reale dipende dalla clip più lenta, non dalla somma delle tre.
- Budget al secondo. 1080p costa $0,1375/secondo, 4K $0,446/secondo, calcolato su
duration. Il costo video del mio video breve a tre clip è stato di $3,16.
Perché il reference-to-video è adatto ai video brevi con voce fuori campo (e l'image-to-video no)
I video brevi di vendita hanno una struttura fissa — un hook che ferma lo scroll, un corpo che spiega, una CTA che converte. Se ogni segmento viene renderizzato separatamente, il rischio più grande non è la qualità del movimento, ma la deriva: le proporzioni della mascotte cambiano, la consistenza del prodotto cambia, la voce sembra quella di un altro brand. Il reference-to-video affronta il problema di petto:
reference_image_urlsè il tuo blocco visivo. Un ritratto del personaggio più un fermo immagine del prodotto diventano il kit fisso per le tre clip. Nei prompt li citi per numero («il robot nell'immagine di riferimento 1», «il dispositivo nell'immagine di riferimento 2»), così il modello sa quale asset è quale.reference_audio_urlsè il tuo blocco vocale. Passa un breve campione vocale e riutilizzalo su ogni clip con voce fuori campo, e la traccia vocale manterrà lo stesso timbro. (Anche Vidu Q3 accetta questo campo, quindi il riferimento vocale non è un vantaggio esclusivo di Q4 — il vantaggio di Q4 rispetto a Q3 è l'output 4K e fino a 15 immagini di riferimento.)- 4K + 9:16 nativo ti dà un master verticale pulito che poi puoi ricomporre o riutilizzare altrove.
Questa è la linea di demarcazione con l'image-to-video. Il modello Vidu Q4 Preview image-to-video anima un singolo primo fotogramma — adatto a una singola inquadratura, ma incapace di mantenere contemporaneamente coerenti personaggio, prodotto e voce lungo una sequenza di più clip. Quando il deliverable è un intero video breve e non un singolo beat, ti serve il reference-to-video.
Passo 1 — Costruisci il kit di brand una volta sola
L'intero video breve funziona con due fermi immagine di riferimento e un frammento audio. Ho generato i due fermi immagine su hiapi (va bene qualsiasi immagine da studio pulita e ben illuminata — il modello legge forme, materiali e colori, quindi uno sfondo a tinta unita lo aiuta a isolare il soggetto):
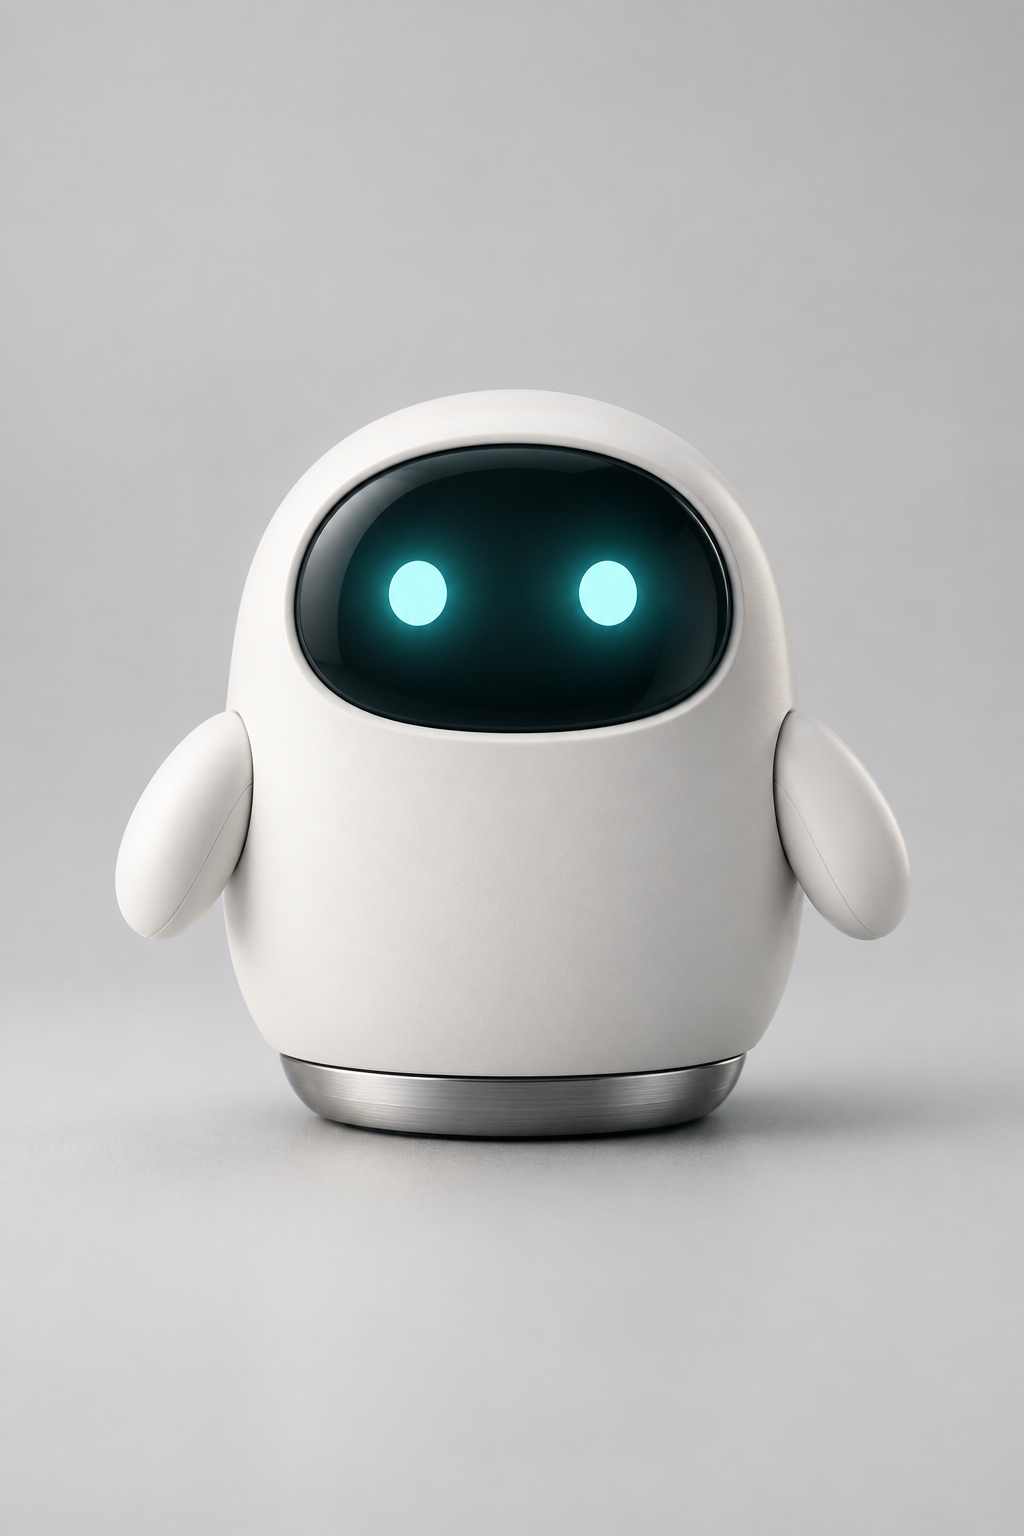
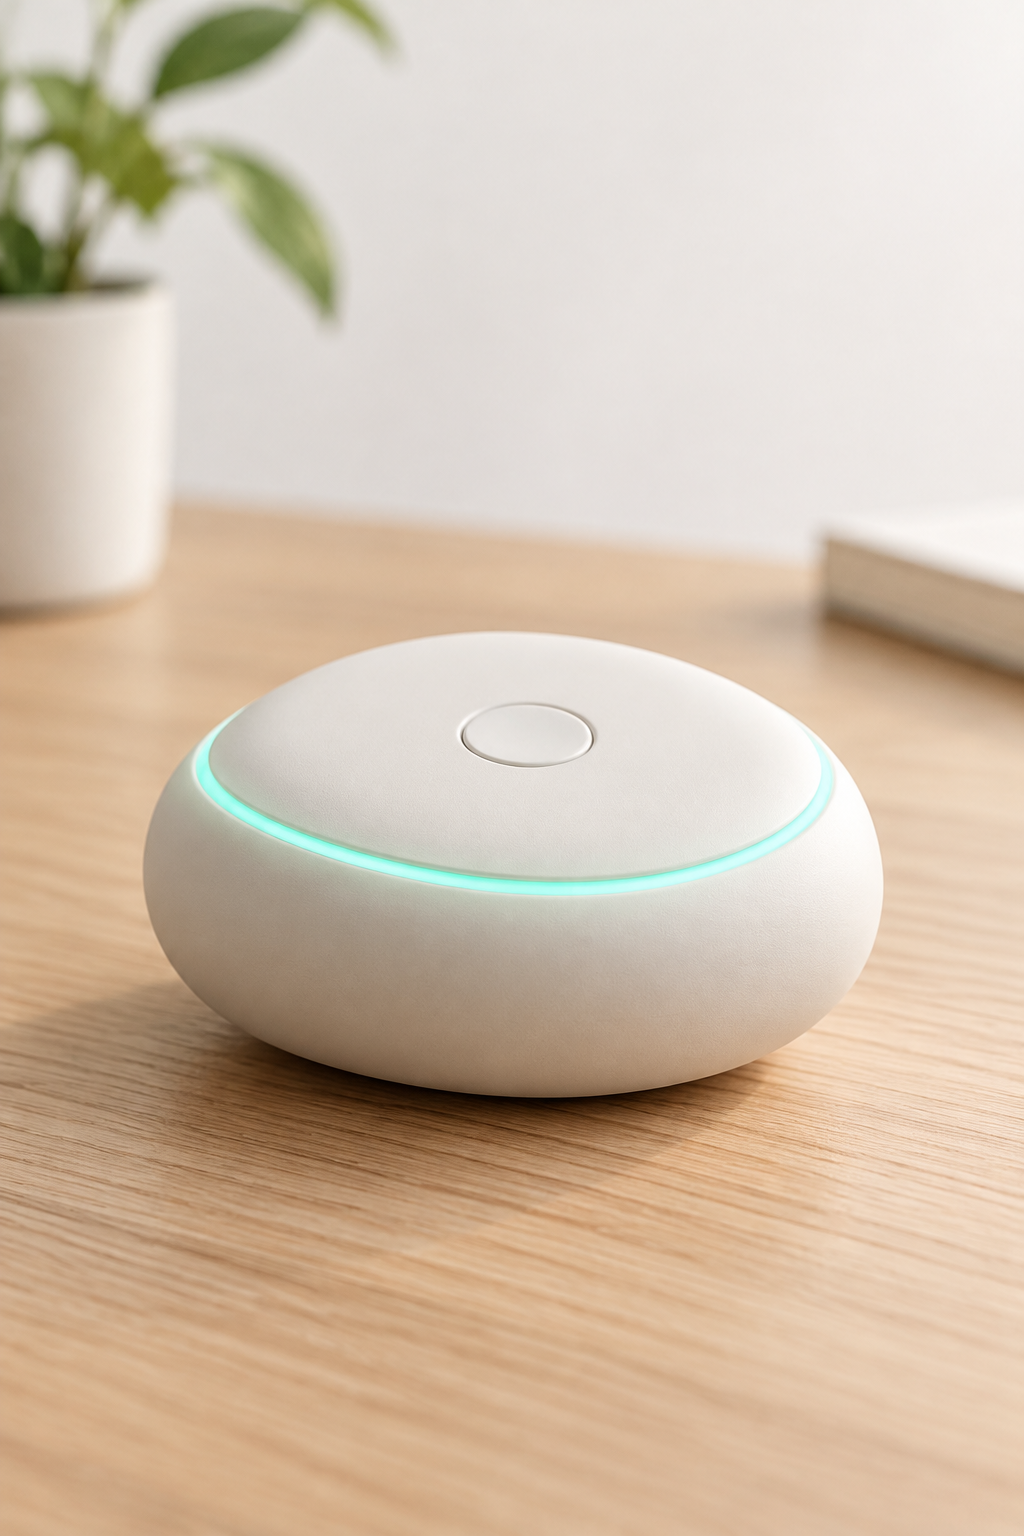
Per la voce, ho creato un campione di voce fuori campo di circa 10 secondi con un modello text-to-speech, l'ho caricato su un URL pubblico e quel file è diventato il riferimento vocale per le clip con voce fuori campo. Il punto del kit è il riutilizzo: questi tre URL di asset vengono incollati in ogni richiesta pertinente qui sotto, ed è proprio questo che rende coerente il video breve, che tu renderizzi tre o trenta clip.
Alcune regole di preparazione importanti:
- Usa sfondi puliti e uniformi per i fermi immagine di riferimento, in modo che il soggetto sia chiaramente distinguibile.
- Ospita ogni asset di riferimento (immagini e audio) su un URL pubblico raggiungibile prima di inviare — l'API dei task li scarica lato server.
- Decidi in anticipo il formato canonico del brand; per i video brevi da feed, usa
9:16per ogni clip.
Passo 2 — L'hook (renderizzato in 4K, esportato in 1080×1920)
La clip di apertura ha un solo compito: avere movimento fin dal primo fotogramma. L'ho renderizzata deliberatamente in 4K — non perché il feed richieda il 4K (non lo richiede), ma perché un master 2160×3840 ti dà spazio per zoomare, ricomporre in 1:1 o 16:9 per altri posizionamenti e conservare un archivio di alta qualità. Poi ne esporti una copia 1080×1920 per la piattaforma.
Il prompt che ho eseguito (una immagine di riferimento, nessun audio):
La mascotte robot bianca e arrotondata dell'immagine di riferimento 1 salta
verso il centro di una scena desk luminosa e minimalista, i suoi occhi
turchesi si illuminano mentre fa un allegro saluto con due braccia verso la
telecamera. Luce da studio morbida, profondità di campo ridotta, bokeh
delicato, sfondo pastello pulito, movimento vivace ed energico, sottile luce
di contorno turchese. Inquadratura verticale da social video.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg"],
    "resolution": "4k",
    "duration": 4,
    "aspect_ratio": "9:16"
  }
}
Risultato effettivamente restituito e verificato: un file 2160×3840 di 4 secondi — il che conferma che resolution imposta il lato corto del formato 9:16, non un'etichetta fissa. L'output 4K viene consegnato in HEVC/H.265 (10-bit), che la maggior parte dei browser e alcuni software di montaggio non riescono a riprodurre inline, quindi l'unico passo qui non eliminabile è la ricodifica:
ffmpeg -i hook_4k.mp4 -vf "scale=1080:1920" \
  -c:v libx264 -profile:v high -pix_fmt yuv420p -crf 20 \
  -c:a aac -movflags +faststart hook_1080.mp4
Così ottieni una clip H.264 1080×1920 che si riproduce ovunque, conservando l'originale 4K come master. (Se non ti serve un master 4K, puoi renderizzare direttamente l'hook in 1080p e saltare il downsampling — costa anche circa 3 volte meno al secondo.)
Passo 3 — Il corpo con voce fuori campo (riferimento vocale)
Questa è la clip che usa l'intero kit: due immagini di riferimento e il campione vocale. Il modello mette la mascotte accanto al prodotto, la fa parlare e prende in prestito il timbro dall'audio di riferimento.
La mascotte robot bianca dell'immagine di riferimento 1 sta accanto al
dispositivo di concentrazione a forma di ciottolo bianco opaco dell'immagine
di riferimento 2 su una scrivania di legno ordinata, si volta verso la
telecamera e parla con calore, gesticolando verso il dispositivo turchese
luminoso come per presentarlo; parla con la voce dell'audio di riferimento 1.
Luce diurna morbida, sfondo accogliente da home office, leggero ondeggio a
mano, atmosfera amichevole e invitante. Inquadratura verticale.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg",
                             "https://.../paxel-device.jpg"],
    "reference_audio_urls": ["https://.../paxel-narrator.mp3"],
    "resolution": "1080p",
    "duration": 6,
    "aspect_ratio": "9:16"
  }
}
Due cose da sapere da questa esecuzione:
- Il nome del campo è
reference_audio_urls. Ho provato convoice_reference_urlse l'API lo ha rifiutato (additional properties 'voice_reference_urls' not allowed), quindi usa il nome esatto. Accetta fino a tre frammenti audio. - In ogni caso, ogni output ha una traccia AAC. Anche le clip senza audio di riferimento tornano con una traccia sonora. La differenza si vede nei livelli: la mia clip del corpo con voce fuori campo misura una loudness media di circa -20 dB — chiaramente una clip vocale — mentre la CTA quasi silenziosa è intorno a -35 dB. Se vuoi una voce fuori campo coerente lungo una serie di video, riutilizza lo stesso URL audio su ogni clip con voce fuori campo; è esattamente il motivo per cui conviene bloccare la voce una volta sola.
Passo 4 — La CTA
Una chiusura breve ed efficace: la mascotte interagisce con il prodotto, l'accento turchese del brand si accende, poi si volta verso la telecamera. Usa entrambe le immagini di riferimento, senza voce questa volta.
Inquadratura verticale ravvicinata: la mascotte robot bianca dell'immagine di
riferimento 1 allunga la mano e tocca il pulsante superiore del dispositivo a
forma di ciottolo dell'immagine di riferimento 2; l'anello LED turchese si
accende con un bagliore morbido, e la mascotte alza lo sguardo verso la
telecamera con occhi turchesi luminosi e un piccolo cenno sicuro. Scrivania
minimalista pulita, luce morbida, messa a fuoco nitida, finale vivace.
Inquadratura verticale.
Renderizzata in 1080p per 4 secondi — l'anello turchese del prodotto conserva il colore del fermo immagine di riferimento, ed è la ricompensa per aver fornito il dispositivo come immagine di riferimento dedicata invece di descriverlo a parole.
Passo 5 — Invia i render in batch, non restare a sorvegliarli
Il reference-to-video è un'API di task asincrona: fai un POST di un task, ottieni un taskId, poi esegui il polling del risultato. Per un video breve a tre clip, invia tutte e tre prima, poi esegui il polling — il tuo tempo reale diventa quello della clip più lenta, non la somma delle tre.
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
H = {"Authorization": "Bearer YOUR_KEY", "Content-Type": "application/json"}

clips = [hook_input, body_input, cta_input]   # the three input dicts above
ids = []
for c in clips:
    r = requests.post(BASE, headers=H, json={
        "model": "vidu-q4-preview/reference-to-video", "input": c})
    ids.append(r.json()["data"]["taskId"])     # save IDs immediately

results = {}
while len(results) < len(ids):
    for tid in ids:
        if tid in results:
            continue
        data = requests.get(f"{BASE}/{tid}", headers=H).json()["data"]
        if data["status"] == "success":
            results[tid] = data["output"][0]["url"]   # download now — URLs expire
        elif data["status"] == "fail":
            results[tid] = None                        # handle/retry
    time.sleep(6)
Salva immediatamente ogni taskId appena lo ricevi e scarica subito l'URL di output quando il task ha successo — sono link diretti a scadenza. Per il contratto di integrazione completo — polling, callback, idempotenza e tabella degli errori di validazione — consulta la guida all'API di Vidu Q4 Preview reference-to-video e il riferimento dell'API tasks.
Passo 6 — Monta ed esporta per il feed
Una volta scaricate le tre clip, assembla il video breve con ffmpeg. Prima uniforma tutte le clip allo stesso codec, risoluzione e frame rate (le mie clip sono tornate a 24 fps; le ho ricodificate a 30), poi concatena:
ffmpeg -i hook_1080.mp4 -i body.mp4 -i cta.mp4 \
  -filter_complex "[0:v][0:a][1:v][1:a][2:v][2:a]concat=n=3:v=1:a=1[v][a]" \
  -map "[v]" -map "[a]" -c:v libx264 -pix_fmt yuv420p \
  -c:a aac -movflags +faststart short_full.mp4
Questo produce il video breve 1080×1920 di 14 secondi in cima a questa pagina. Note di esportazione importanti per i video brevi:
- Resta in verticale, resta breve.
durationè un numero intero compreso tra 3 e 16 secondi, per clip; una sequenza di 3–4 clip rientra facilmente nella finestra di attenzione del feed. - Ridimensiona il master 4K. La versione assemblata usa l'esportazione 1080×1920 dell'hook, non l'originale HEVC.
- Attenzione alla traccia audio. Poiché ogni clip ha una traccia AAC, imposta i livelli deliberatamente durante il montaggio, invece di dare per scontato che sia silenziosa.
Costi
Il prezzo si calcola sui secondi di output, è fisso per risoluzione e si moltiplica per duration (confermato sulla pagina dei prezzi in tempo reale):
| Risoluzione | Prezzo / secondo |
|---|---|
| 540p | $0,0515 |
| 720p | $0,109 |
| 1080p | $0,1375 |
| 2K | $0,2175 |
| 4K | $0,446 |
Costo effettivo del mio video breve:
| Clip | Risoluzione | Durata | Costo |
|---|---|---|---|
| Hook | 4K | 4 secondi | $1,784 |
| Corpo (voce) | 1080p | 6 secondi | $0,825 |
| CTA | 1080p | 4 secondi | $0,550 |
| Totale video | 14 secondi | $3,159 |
La preparazione del kit di brand — due fermi immagine di riferimento e un breve campione vocale TTS — aggiunge solo pochi centesimi. La leva di costo più grande è il 4K dell'hook: abbassandolo a 1080p, l'intero video breve scende a circa $1,92. Renderizza l'hook in 4K solo se vuoi davvero un master ricomponibile.
Riferimento dei campi (scheda rapida per video brevi)
| Campo | Descrizione |
|---|---|
prompt |
Obbligatorio. Cita gli asset di riferimento per numero («immagine di riferimento 1», «audio di riferimento 1»). |
reference_image_urls |
Obbligatorio. Array di 1–15 immagini. Il tuo kit visivo di brand. |
reference_audio_urls |
Facoltativo. Array, fino a 3. Il blocco vocale. Nome del campo esatto — voice_reference_urls viene rifiutato. |
resolution |
540p / 720p / 1080p / 2k / 4k. Imposta il lato corto. Il 4K restituisce HEVC. |
duration |
Numero intero, 3–16 secondi. (Valori come 99 restituiscono 400 … want 16.) |
aspect_ratio |
16:9 / 9:16 / 1:1 / 4:3 / 3:4. Usa 9:16 per il verticale nativo del feed. |
Domande frequenti
In cosa si differenzia dall'articolo sulle ricette di prompt? Sì, è diverso. Le ricette di prompt per il reference-to-video sono shot creativi autonomi che puoi copiare e incollare. Questo articolo è la pipeline di produzione per un video breve finito — bloccare un kit di brand, generare le clip in batch ed esportare un deliverable 9:16 montato in sequenza.
Bisogna per forza usare un riferimento vocale?
No — reference_audio_urls è facoltativo. Senza di esso la clip viene comunque renderizzata (e ha comunque una traccia AAC). Aggiungilo quando vuoi una voce fuori campo coerente lungo una serie di video.
Si può renderizzare l'intero video breve in 4K? Sì, ma per il feed vale raramente la pena: il 4K costa $0,446/secondo contro $0,1375/secondo del 1080p, e il feed mostra comunque in 1080×1920. Riserva il 4K a quella ripresa che potresti ricomporre o riutilizzare altrove.
Quanto può durare una clip?
duration ha un limite massimo di 16 secondi per clip. Per i video brevi, l'intervallo migliore è di 3–6 secondi per clip in sequenze di 3–4 clip.
Perché il mio file 4K non si riproduce?
Il 4K viene restituito in HEVC/H.265 (10-bit). Come mostrato nel Passo 2, ricodificalo in H.264 yuv420p con +faststart per adattarlo al web e alla maggior parte dei software di montaggio.
Crea il tuo video breve di brand
Questo schema vale per qualsiasi mascotte, prodotto o persona in scena: blocca il kit di riferimento, scrivi tre prompt che lo citano per numero, renderizza in batch, poi monta. Inizia dalla pagina del modello Vidu Q4 Preview reference-to-video, ottieni una chiave API dalla guida rapida e pubblica oggi pomeriggio il tuo primo video breve verticale.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori