
Guía de uso
Vidu Q4 Preview referencia-a-vídeo: vídeos cortos con narración y marca
Completa una pieza vertical 9:16 de principio a fin: fija un paquete de marca y una voz, genera clips por lotes, masteriza en 4K y entregalos en 1080p.
La mayoría de los tutoriales de «vídeo con IA» para formatos cortos solo te enseñan a crear un clip suelto que se vea bien, cuando lo que realmente necesita un vídeo de marca corto es lo contrario: en tres o cuatro clips consecutivos, el mismo mascota, el mismo producto y la misma voz de narración deben atravesar cada plano. Esa consistencia es exactamente donde entra vidu-q4-preview/reference-to-video: le das un pequeño conjunto de imágenes de referencia (y opcionalmente una muestra de voz), y cada renderizado posterior reutiliza ese paquete en lugar de tirar los dados de la apariencia desde cero cada vez.
Esta es una explicación práctica de flujo de trabajo, no una lista de prompts. Realicé de principio a fin un vídeo vertical corto de unos 14 segundos —gancho, cuerpo con narración y llamada a la acción— usando solo un paquete de marca de dos imágenes y una muestra de voz, luego generé por lotes, uní y exporté una pieza lista para el feed 9:16. Cada clip, cada coste y cada campo a continuación proviene de esta ejecución real en el modelo Vidu Q4 Preview referencia-a-vídeo de hiapi.
Resumen rápido
- Fija el paquete de marca una sola vez.
reference_image_urls(1–15 imágenes) mantiene tu personaje y producto consistentes;reference_audio_urls(hasta 3) mantiene consistente la voz de narración. Cada clip del vídeo corto reutiliza el mismo paquete. - Rodaje vertical nativo.
aspect_ratio: "9:16"renderiza un auténtico 1080×1920 (2160×3840 en 4K): sin recorte en posproducción. - Masteriza en 4K, entrega en 1080p. La salida 4K es 2160×3840 HEVC/H.265; vuelve a codificarla a H.264 y redúcela a 1080×1920 para publicar en el feed. Dejé el gancho en 4K y el cuerpo/CTA en 1080p.
- Envía por lotes, no esperes de pie. Esta es una API de tareas asíncronas: envía los tres clips primero y luego consulta. El tiempo real depende del clip más lento, no de la suma de los tres.
- Presupuesta por segundo. 1080p cuesta $0.1375/s y 4K $0.446/s, facturado según
duration. El coste de vídeo de mi pieza de tres clips fue de $3.16.
Por qué referencia-a-vídeo encaja con vídeos cortos narrados (y por qué no imagen-a-vídeo)
Un vídeo corto de producto tiene una estructura fija: un gancho que evita que el usuario deslice, un cuerpo que explica y un CTA que convierte. Si cada tramo se renderiza por separado, el mayor riesgo no es la calidad del movimiento, sino la deriva: las proporciones del mascota cambian, la textura del producto cambia, la voz suena como otra marca. La función referencia-a-vídeo ataca esto de frente:
reference_image_urlses tu ancla visual. Un retrato del personaje y una imagen fija del producto se convierten en un paquete fijo para los tres clips. En el prompt los referencias por índice («el robot de la imagen de referencia 1», «el dispositivo de la imagen de referencia 2»), así el modelo sabe qué activo es cuál.reference_audio_urlses tu ancla de voz. Pasa una muestra de voz corta y reutilízala en cada clip narrado; la pista de voz mantendrá el mismo timbre. (Vidu Q3 también acepta este campo, así que la referencia de voz no es una ventaja exclusiva de Q4; la ventaja de Q4 sobre Q3 es la salida 4K y hasta 15 imágenes de referencia.)- 4K + 9:16 nativo te da un máster vertical limpio que luego puedes reencuadrar o reutilizar.
Ahí está la frontera con imagen-a-vídeo. El modelo Vidu Q4 Preview imagen-a-vídeo anima un primer fotograma: sirve para un plano suelto, pero no puede mantener a la vez personaje, producto y voz consistentes en una secuencia de varios clips. Cuando el entregable es una pieza corta completa y no un solo compás, necesitas referencia-a-vídeo.
Paso 1: monta el paquete de marca de una sola vez
Toda la pieza corta funciona solo con dos imágenes fijas de referencia y un fragmento de voz. Generé las dos imágenes fijas en hiapi (sirve cualquier imagen de estudio limpia y bien iluminada; el modelo lee formas, materiales y colores, así que un fondo liso le ayuda a separar el sujeto):
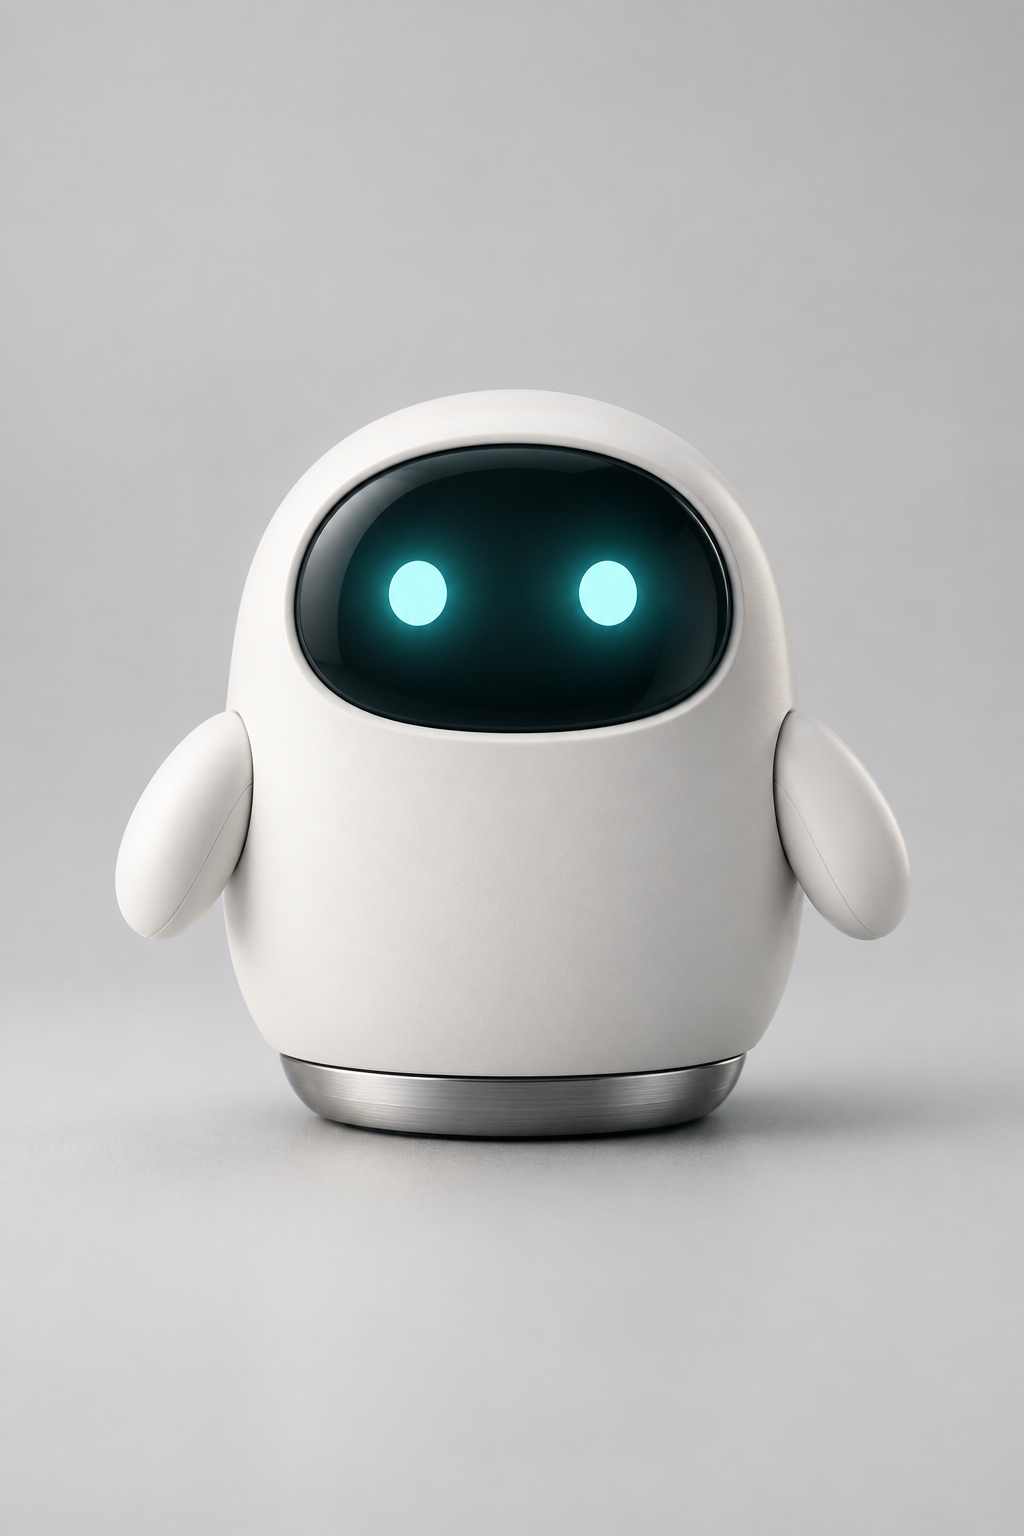
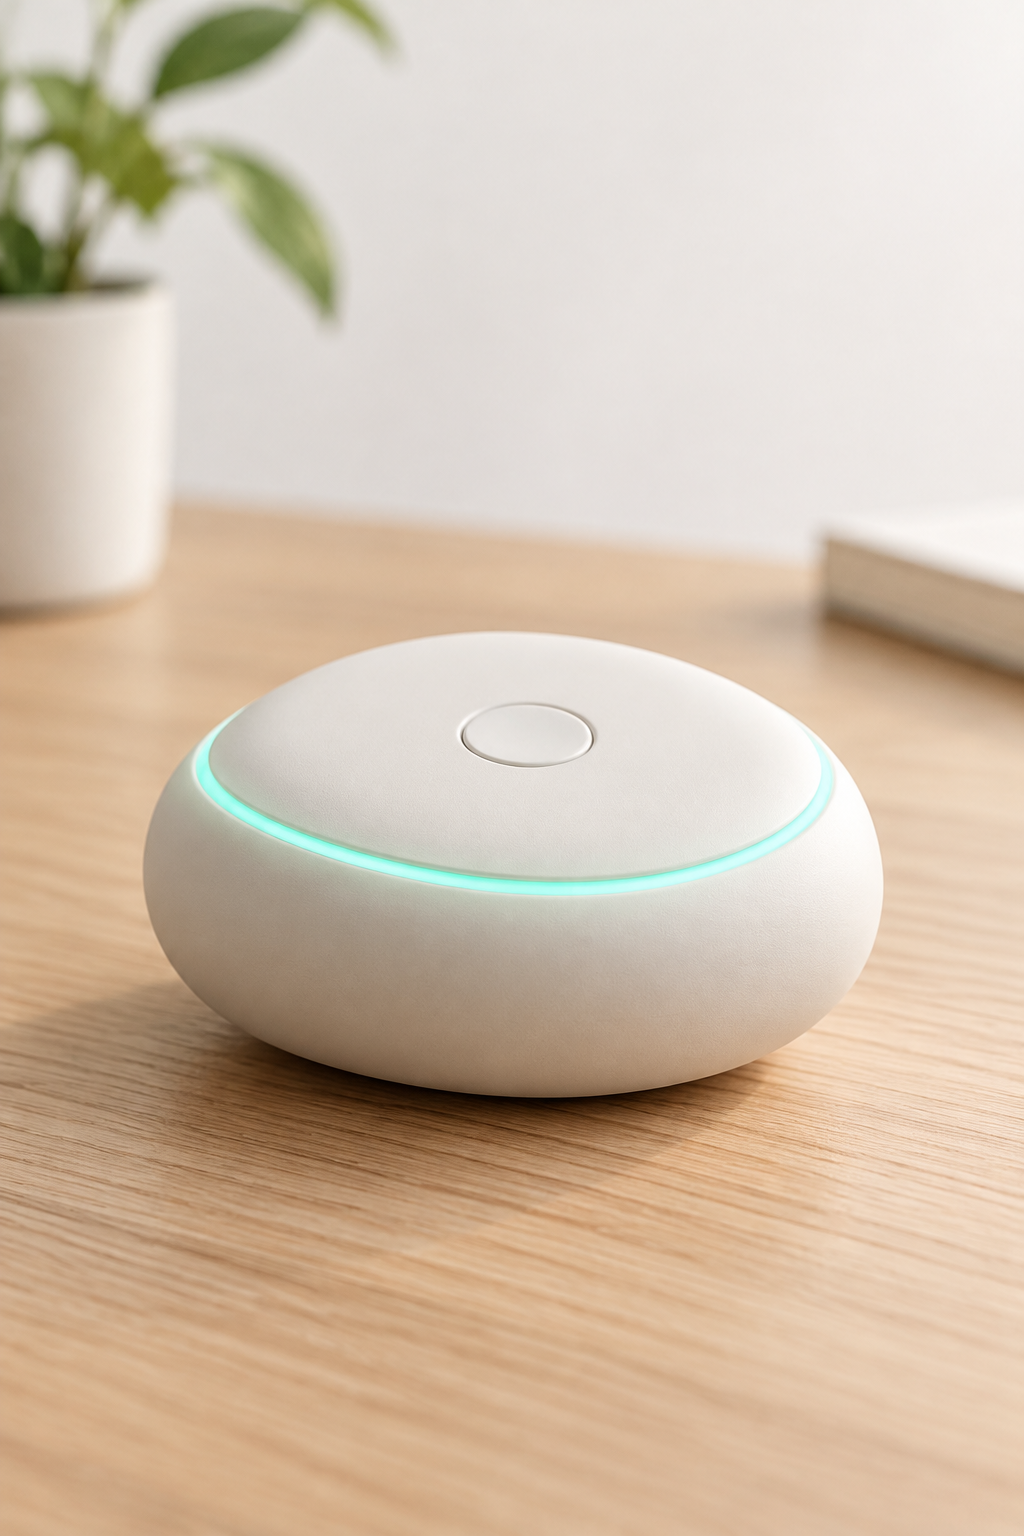
Para la voz, usé un modelo de texto a voz para crear una muestra de narración de unos 10 segundos, la subí a una URL pública y ese archivo se convirtió en la referencia de voz de los clips narrados. El sentido del paquete es la reutilización: esas tres URLs de activos se pegan en cada solicitud relevante de abajo, y eso es exactamente lo que mantiene coherente la pieza corta tanto si renderizas tres clips como treinta.
Algunas reglas de preparación importantes:
- Usa fondos limpios y uniformes en las imágenes fijas de referencia para que el sujeto se distinga con claridad.
- Antes de enviar, aloja cada activo de referencia (imágenes y audio) en una URL pública accesible; la API de tareas los obtiene en el servidor.
- Define de antemano el formato canónico de la marca; para vídeos cortos de feed, usa
9:16en cada clip.
Paso 2: el gancho (renderizado en 4K, exportado a 1080×1920)
El clip de apertura tiene una sola tarea: que haya movimiento desde el primer fotograma. Lo rendericé deliberadamente en 4K, no porque el feed necesite 4K (no lo necesita), sino porque un máster 2160×3840 te da margen para acercar, reencuadrar a 1:1 o 16:9 para otras ubicaciones y conservar un archivo de alta calidad. Luego exportas una copia 1080×1920 para la plataforma.
El prompt que ejecuté (una imagen de referencia, sin audio):
The rounded white robot mascot from reference image 1 bounces up into the
centre of a bright minimalist desk scene, its teal eyes brightening as it
gives a cheerful two-arm wave toward the camera. Soft studio light, shallow
depth of field, gentle bokeh, clean pastel background, playful energetic
motion, subtle teal rim light. Vertical social-video framing.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg"],
    "resolution": "4k",
    "duration": 4,
    "aspect_ratio": "9:16"
  }
}
Resultado real devuelto y verificado: un archivo de 4 segundos a 2160×3840, lo que confirma que resolution fija el lado corto del encuadre 9:16, no una etiqueta fija. La salida 4K se entrega en HEVC/H.265 (10 bits), que la mayoría de navegadores y algunos editores no pueden reproducir en línea, así que el único paso que no puedes omitir aquí es la recodificación:
ffmpeg -i hook_4k.mp4 -vf "scale=1080:1920" \
  -c:v libx264 -profile:v high -pix_fmt yuv420p -crf 20 \
  -c:a aac -movflags +faststart hook_1080.mp4
Así obtienes un clip H.264 1080×1920 que se reproduce en cualquier parte, y conservas el original 4K como máster. (Si no necesitas el máster 4K, puedes renderizar el gancho directamente en 1080p y saltarte la reducción; además es unas 3 veces más barato por segundo.)
Paso 3: el cuerpo narrado (referencia de voz)
Este es el clip que usa el paquete completo: las dos imágenes de referencia y la muestra de voz. El modelo coloca el mascota junto al producto, lo hace hablar y toma el timbre del audio de referencia.
The white robot mascot from reference image 1 stands beside the matte-white
pebble focus device from reference image 2 on a tidy wooden desk, turns to the
camera and speaks warmly, gesturing toward the glowing teal device as if
introducing it; it speaks in the voice of reference audio 1. Soft daylight,
cosy home-office background, gentle handheld sway, friendly inviting mood.
Vertical framing.
{
  "model": "vidu-q4-preview/reference-to-video",
  "input": {
    "prompt": "...",
    "reference_image_urls": ["https://.../paxel-mascot.jpg",
                             "https://.../paxel-device.jpg"],
    "reference_audio_urls": ["https://.../paxel-narrator.mp3"],
    "resolution": "1080p",
    "duration": 6,
    "aspect_ratio": "9:16"
  }
}
Dos cosas que debes saber de esta ejecución:
- El nombre del campo es
reference_audio_urls. Probévoice_reference_urlsy la API lo rechazó (additional properties 'voice_reference_urls' not allowed), así que usa el nombre exacto. Acepta hasta tres fragmentos de audio. - De todos modos, cada salida lleva pista AAC. Los clips sin referencia de audio también vuelven con pista de sonido. La diferencia se nota en el nivel: mi clip de cuerpo narrado midió una sonoridad media de unos -20 dB —claramente un clip de voz—, mientras que el CTA casi silencioso rondó los -35 dB. Si quieres una narración consistente en una serie de vídeos, reutiliza la misma URL de audio en cada clip narrado; esa es precisamente la razón para fijar la voz de una vez.
Paso 4: el CTA
Un cierre breve y contundente: el mascota interactúa con el producto, el acento cian de la marca se enciende y luego mira de nuevo a cámara. Usa las dos imágenes de referencia, esta vez sin voz.
Close vertical shot: the white robot mascot from reference image 1 reaches out
and taps the top button of the pebble device from reference image 2; the teal
LED ring pulses to life with a soft glow, and the mascot looks up at the camera
with bright teal eyes and a small confident nod. Clean minimalist desk, soft
light, crisp focus, upbeat finish. Vertical framing.
Renderizado en 1080p durante 4 segundos: el anillo cian del producto conserva el color de la imagen fija de referencia, y esa es la recompensa de dar el dispositivo como imagen de referencia dedicada en lugar de describirlo con texto.
Paso 5: envía los renderizados por lotes, no te quedes vigilándolos
Referencia-a-vídeo es una API de tareas asíncronas: haces POST de una tarea, obtienes un taskId y luego consultas el resultado. Para una pieza de tres clips, envía los tres primero y consulta después: tu tiempo real pasa a ser el del clip más lento, no la suma de los tres.
import requests, time

BASE = "https://api.hiapi.ai/v1/tasks"
H = {"Authorization": "Bearer YOUR_KEY", "Content-Type": "application/json"}

clips = [hook_input, body_input, cta_input]   # the three input dicts above
ids = []
for c in clips:
    r = requests.post(BASE, headers=H, json={
        "model": "vidu-q4-preview/reference-to-video", "input": c})
    ids.append(r.json()["data"]["taskId"])     # save IDs immediately

results = {}
while len(results) < len(ids):
    for tid in ids:
        if tid in results:
            continue
        data = requests.get(f"{BASE}/{tid}", headers=H).json()["data"]
        if data["status"] == "success":
            results[tid] = data["output"][0]["url"]   # download now — URLs expire
        elif data["status"] == "fail":
            results[tid] = None                        # handle/retry
    time.sleep(6)
Guarda cada taskId en cuanto lo recibas y descarga la URL de salida en cuanto la tarea tenga éxito: son enlaces directos con caducidad. Para el contrato de integración completo —consultas, callbacks, idempotencia y tabla de errores de validación— consulta la guía de la API de Vidu Q4 Preview referencia-a-vídeo y la referencia de la API de tareas.
Paso 6: une y exporta para el feed
Con los tres clips descargados, ensambla la pieza corta con ffmpeg. Primero unifica todos los clips al mismo códec, resolución y velocidad de fotogramas (mis clips volvieron a 24 fps; los recodifiqué a 30), y luego concatena:
ffmpeg -i hook_1080.mp4 -i body.mp4 -i cta.mp4 \
  -filter_complex "[0:v][0:a][1:v][1:a][2:v][2:a]concat=n=3:v=1:a=1[v][a]" \
  -map "[v]" -map "[a]" -c:v libx264 -pix_fmt yuv420p \
  -c:a aac -movflags +faststart short_full.mp4
Así se genera la pieza vertical de 14 segundos a 1080×1920 que aparece en la parte superior de esta página. Notas de exportación importantes para formatos cortos:
- Mantén el vertical, mantén la brevedad.
durationes un entero de 3 a 16 segundos, por clip; una secuencia de 3–4 clips cabe fácilmente en la ventana de atención de un feed. - Reduce el máster 4K. La versión ensamblada usa la exportación 1080×1920 del gancho, no el original HEVC.
- Cuida la pista de audio. Como cada clip lleva AAC, al concatenar ajusta los niveles a propósito en lugar de asumir que está en silencio.
Coste
El precio se calcula por segundos de salida, es fijo según la resolución y se multiplica por duration (confirmado con la página de precios en vivo):
| Resolución | Precio / segundo |
|---|---|
| 540p | $0.0515 |
| 720p | $0.109 |
| 1080p | $0.1375 |
| 2K | $0.2175 |
| 4K | $0.446 |
Coste real de mi pieza corta:
| Clip | Resolución | Duración | Coste |
|---|---|---|---|
| Gancho | 4K | 4 s | $1.784 |
| Cuerpo (voz) | 1080p | 6 s | $0.825 |
| CTA | 1080p | 4 s | $0.550 |
| Total vídeo | 14 s | $3.159 |
La preparación del paquete de marca —dos imágenes fijas de referencia y una muestra de voz TTS corta— solo añade unos céntimos. La mayor palanca de coste es el 4K del gancho: bájalo a 1080p y la pieza completa baja a unos $1.92. Renderiza el gancho en 4K solo cuando realmente quieras un máster reencuadrable.
Referencia de campos (chuleta para vídeos cortos)
| Campo | Descripción |
|---|---|
prompt |
Obligatorio. Referencia los activos por índice («imagen de referencia 1», «audio de referencia 1»). |
reference_image_urls |
Obligatorio. Array, 1–15 imágenes. Tu paquete de marca visual. |
reference_audio_urls |
Opcional. Array, hasta 3. El ancla de voz. Nombre de campo exacto: voice_reference_urls se rechaza. |
resolution |
540p / 720p / 1080p / 2k / 4k. Fija el lado corto. 4K devuelve HEVC. |
duration |
Entero, 3–16 segundos. (Valores como 99 devuelven 400 … want 16.) |
aspect_ratio |
16:9 / 9:16 / 1:1 / 4:3 / 3:4. Para vertical nativo de feed usa 9:16. |
Preguntas frecuentes
¿En qué se diferencia esto del artículo de recetas de prompts? En nada parecido. Las recetas de prompts de referencia-a-vídeo son planos creativos independientes listos para copiar y pegar. Este artículo es la línea de producción para fabricar una pieza corta terminada: fijar un paquete de marca, generar clips por lotes y exportar un entregable 9:16 unido en secuencia.
¿Es obligatorio usar una referencia de voz?
No: reference_audio_urls es opcional. Los clips se renderizan igualmente sin él (y siguen llevando pista AAC). Añádelo cuando quieras mantener una narración consistente en una serie de vídeos.
¿Se puede renderizar toda la pieza corta en 4K? Sí, pero rara vez vale la pena para un feed: 4K cuesta $0.446/s frente a $0.1375/s en 1080p, y el feed muestra de todos modos 1080×1920. Reserva el 4K para el plano que quizá reencuadres o reutilices.
¿Cuánto puede durar un clip?
duration tiene un máximo de 16 segundos por clip. Para formatos cortos, lo óptimo es una secuencia de 3–4 clips de 3–6 segundos cada uno.
¿Por qué no se reproduce mi archivo 4K?
El 4K se devuelve en HEVC/H.265 (10 bits). Recodifícalo a H.264 yuv420p con +faststart como se muestra en el paso 2 para que funcione en la web y en la mayoría de editores.
Crea tu propio vídeo corto de marca
Este patrón sirve para cualquier mascota, producto o persona en pantalla: fija el paquete de referencia, escribe tres prompts que lo referencien por índice, renderiza por lotes y une. Empieza en la página del modelo Vidu Q4 Preview referencia-a-vídeo, consigue una clave de API en la guía de inicio rápido y publica tu primera pieza vertical esta misma tarde.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores