
Guia de uso
GLM 5.3 na prática: extração estruturada com base textual para cada campo JSON
Extração de campos com o modo de objeto JSON: use valores ausentes, citações e validação de negócio para bloquear erros antes da gravação no banco

Nesta página
Por que a saída estruturada ainda precisa de "base textual"
O modo de objeto JSON (response_format: {"type": "json_object"}) resolve a questão de «o formato de saída é um objeto JSON?», e não a de «esta requisição certamente terá sucesso, o conteúdo certamente estará completo e o parsing certamente não lançará exceção». A requisição pode falhar, o modelo pode recusar-se a responder, a saída pode ser truncada por limite de comprimento, a transmissão em streaming pode ser interrompida e o conteúdo retornado pode estar incompleto ou malformado; o cliente deve lidar com esses casos e com exceções de parsing do json.loads. É preciso primeiro confirmar que a resposta foi concluída normalmente e que o conteúdo está completo, para só então iniciar o parsing. Conseguir fazer parsing também não significa que seja utilizável: formato correto não implica correção factual. Se o valor do campo foi extraído do texto original, se o modelo o completou por conta própria, e se determinado campo significa «o original não diz» ou «o original diz vazio», nada disso está coberto pelas restrições de formato.
Escrever um modelo de campos no prompt é, essencialmente, entregar ao modelo um «formulário para preencher», e não uma «lista de evidências». Quando falta suporte textual a um campo, o modelo tende a fornecer um valor aparentemente razoável — este é o modo de falha mais perigoso em tarefas de extração, porque não gera erro, apenas contamina silenciosamente os dados a jusante.
Portanto, o contrato de extração deste artigo é composto por três partes: definição de campos e tipos, citação textual que acompanha cada valor e modelagem explícita de valores ausentes. Juntas, elas fazem com que «de onde veio esta frase» seja parte da saída, e não uma suposição posterior.
Projetar o contrato de extração: campos, tipos e convenção de nulabilidade
O contrato começa pela lista de campos. Suponha que a tarefa seja extrair informações estruturadas de uma descrição de vaga/colaboração; primeiro fixe os campos-alvo:
title: string, obrigatóriobudget: número, anuláveldeadline: string (data ISO), anulávelcontact: string, anulávelskills: array de strings, pode ser array vazio
O ponto-chave é que «anulável» não significa «pode ser omitido». Convencione que todo campo deve aparecer na saída; quando desconhecido, forneça explicitamente null ou array vazio; não é permitido omitir chaves. Omitir chaves impede que o downstream distinga «o modelo julgou vazio» de «o modelo simplesmente não processou este campo».
Nos tipos, é preciso restringir ainda mais, a um nível que a máquina possa julgar: budget aceita apenas números, não aceita strings como "a combinar"; deadline segue o formato YYYY-MM-DD; skills deve ser um array de strings, não se permite empurrar uma única string concatenada com vírgulas. Quanto mais específico o tipo, mais a camada de validação a seguir conseguirá barrar problemas.
O trecho abaixo é a descrição de campos escrita no prompt, não parâmetros da requisição; os parâmetros da requisição apenas ativam o modo de objeto JSON.
Por favor, gere um objeto JSON que contenha e somente contenha as seguintes chaves:
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
Todas as chaves devem aparecer. Quando não for possível determinar a partir do texto original, preencha com null (arrays com array vazio); não faça suposições.
Fazer cada campo carregar um trecho de citação
Fornecer apenas o valor sem a fonte equivale a abandonar a rastreabilidade. A abordagem é transformar cada campo extraível em uma estrutura pareada: valor e citação juntos.
{
  "title": {"value": "Estagiário de análise de dados", "evidence": "Contratação de 2 estagiários de análise de dados"},
  "budget": {"value": 300, "evidence": "diária de 300 yuans"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "Envie o currículo para hr@example.com"},
  "skills": [
    {"value": "SQL", "evidence": "Requisito de familiaridade com SQL"},
    {"value": "Python", "evidence": "Conhecimento de Python é preferencial"}
  ]
}
Alguns pontos importantes. Primeiro, evidence deve ser um trecho contínuo do texto original, não uma paráfrase ou resumo do modelo — paráfrases fazem a citação perder valor de comparação. Segundo, quando o valor é null, evidence também deve ser null; essa restrição por si só já inibe parte das invenções: se o modelo inventou um valor, geralmente não consegue inventar o trecho correspondente no original, e o formato fica autocontraditório. Terceiro, campos de array devem fornecer citação por elemento, não uma citação para o array inteiro; caso contrário, um elemento errado contamina a credibilidade do grupo todo. Quarto, o trecho de citação deve ser o mais curto possível, cobrindo apenas o texto mínimo que sustenta o valor, para facilitar a comparação por contenção de string posteriormente.
O volume da saída aumenta, mas em troca: qualquer registro gravado no banco pode responder «em qual frase do original este campo se baseia».
Tratar explicitamente valores ausentes e incerteza
Em tarefas de extração, o erro mais comum do modelo não é extrair errado, mas «completar». É preciso modelar separadamente três situações no nível do contrato.
Ausência. O original não contém informação alguma sobre o assunto; o campo recebe null. Essa semântica deve ser distinguida de «valor é string vazia»: string vazia é um valor extraído; null é não extraído. Com o upstream bem definido, o downstream pode decidir se pula ou alerta.
Ambiguidade. O original tem menção relacionada, mas insuficiente para determinar. Por exemplo, escreve apenas «salário a combinar»; nesse caso budget deve ser null, e o prompt deve deixar claro: não converter descrições qualitativas em números, nem mapear «a combinar» para 0.
Múltiplos candidatos. O original apresenta dois contatos ou duas datas, mas o contrato aceita apenas valor único. As opções são fazer a estrutura do campo suportar lista de candidatos ou definir no prompt uma prioridade (por exemplo, pegar o primeiro que aparece). Qualquer que seja a escolha, ela deve estar escrita no contrato; caso contrário, a estratégia de decisão do modelo pode variar a cada vez, tornando o resultado difícil de reproduzir de forma estável.
Adicione uma salvaguarda: permitir que o modelo produza um array unresolved listando informações-chave que não conseguiu classificar em nenhum campo. Isso é muito mais seguro do que forçar a inclusão em algum campo e também lhe dá um ponto de observação dos modos de falha do modelo.
Três camadas de validação de negócio antes da gravação
O modo de objeto JSON apenas restringe a forma da saída; o parsing ainda pode falhar. A validação é executada em ordem: primeiro confirme a integridade da resposta, depois faça validação estrutural e de negócio no cliente, e por fim a verificação de evidências; se a camada anterior não passar, não se avança para a próxima.
Antes do parsing, verifique: se a requisição retornou com sucesso, se houve recusa de resposta, se o motivo de término indica truncamento por comprimento, se a resposta em streaming terminou normalmente e se o conteúdo está vazio. Após confirmar que a resposta foi concluída normalmente e o conteúdo está completo, execute json.loads; exceções de parsing vão diretamente para o tratamento de falha, sem enviar conteúdo parcial para as validações seguintes. Somente após parsing bem-sucedido entra-se nas três camadas de validação abaixo.
Primeira camada: tipo e estrutura
As chaves estão completas, os tipos correspondem, deadline atende ao formato de data, budget é um número finito. Esta camada pode ser feita com código comum, tem baixo custo e a maior taxa de interceptação.
Segunda camada: enumeração e domínio de valores
Bloqueie valores impossíveis no negócio: valores negativos, datas anteriores a hoje, strings vazias ou itens duplicados em skills, comprimento de string acima do limite do campo. Se o campo tiver vocabulário controlado (como setor, nível de cargo), faça correspondência de lista branca aqui e reserve espaço para normalização de sinônimos.
Terceira camada: consistência entre campos
Um campo válido isoladamente não significa que o registro inteiro seja válido. Verificações típicas incluem: quando budget não é nulo, deadline também não é nulo (em muitos cenários de negócio os dois estão vinculados), se contact contradiz o tipo de cargo sugerido por skills, se a distribuição de campos de registros com o mesmo title no mesmo lote é anormalmente concentrada. Esta camada é a mais próxima da semântica de negócio e a que mais exige que você escreva testes.
Não se esqueça de fazer validação mecânica de evidence: quando o valor não é nulo, evidence deve ser não nulo e deve poder ser encontrado no texto de entrada por contenção de string ou correspondência aproximada. Falha na correspondência não precisa levar ao descarte imediato, mas pelo menos deve ser marcada com baixa confiança e enviada para fila de revisão manual.
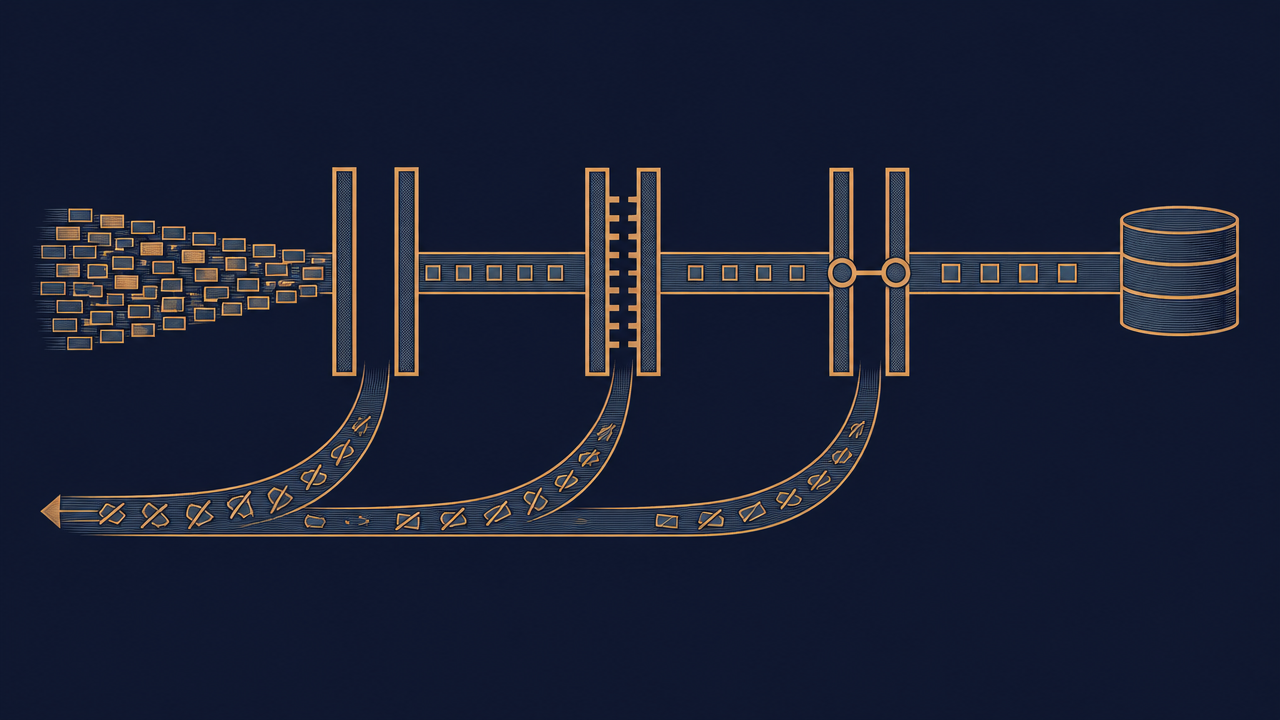
Transformar falha de validação no prompt da próxima rodada
Após uma falha de validação, a pior abordagem é reenviar a requisição como está, esperando que desta vez a extração acerte. Melhor é realimentar os motivos da falha de forma estruturada:
A última saída não passou na validação:
- o valor de deadline "o quanto antes" não está no formato YYYY-MM-DD
- o evidence de skills[2] não foi encontrado no texto original
Corrija apenas os problemas acima, mantenha os demais campos inalterados e gere novamente o JSON completo.
Três detalhes merecem atenção. Primeiro, a mensagem de erro deve apontar o caminho específico do campo, para que o modelo possa fazer correção localizada em vez de refazer tudo. Segundo, exigir explicitamente «os demais campos permanecem inalterados»; caso contrário, é fácil introduzir novos erros e criar oscilação de corrigir um e quebrar outro. Terceiro, definir um limite de tentativas (por exemplo, duas rodadas); ao ultrapassar o limite, encaminhar para fila de revisão manual, em vez de laço infinito — retentativas infinitas aumentam a latência e elevam o custo.
Se o mesmo tipo de erro se repete nas retentativas, geralmente não é problema do modelo, mas do contrato mal escrito. Nesse caso, deve-se revisar a definição de campos e exemplos, em vez de continuar adicionando prompts.
Forma de chamada e limites deste artigo
No HiAPI, glm-5.3 é chamado por meio do protocolo compatível com OpenAI Chat Completions; para ativar o modo de objeto JSON, define-se response_format como tipo objeto na requisição, e os parâmetros e nomes de campos específicos seguem a documentação da interface na página do modelo. A marca de capacidade jsonObject=true indica que o modelo suporta o modo de objeto JSON, não significa que a interface suporte o modo de resposta JSON Schema, nem que se possa depender de validação por Schema no lado do servidor; a estrutura de campos, tipos e restrições de negócio deste artigo são validadas localmente no cliente após o parsing. A lógica de extração, os campos de citação e a camada de validação ficam no seu próprio servidor; o modelo apenas produz texto conforme o contrato.
Este artigo discute apenas o projeto do contrato e o fluxo de validação, sem tratar de números de cobrança ou promessas de desempenho; preços e cotas em tempo real devem ser consultados no painel de preços do site. Somente após concluir as três tarefas — definição de campos, validação de citações e estratégia de retentativa — é que se avança de «formato legal» para «semanticamente utilizável»; formato correto não implica correção factual, e seed fixa também não garante reprodução completa; a estratégia de retentativa ainda precisa combinar com limites e fila de revisão manual.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de geração de imagens a partir de texto com o Nano Banana Basic: proporção, espaço em branco e uso de prompts
Use os campos aspect_ratio e prompt da API de tarefas para gerar imagens com composição clara para banners e cards sociais
-

Guia de uso
Kimi K3 na prática: tratamento de respostas, streaming interrompido e limites de retry
-

Guia de uso
Guia de produção de músicas curtas com o MiniMax Music 3: como separar letra, tags de seção e briefing de arranjo
Com base nas duas entradas obrigatórias do contrato atual, projete uma requisição de música curta reproduzível