
Guia de uso
Guia de introdução ao gpt-6.2-sol: limites de capacidade, integração via API e noções de precificação por token
Decisões de integração e pontos práticos para equipes de engenharia

Nesta página
O que é o gpt-6.2-sol e para quem ele é indicado
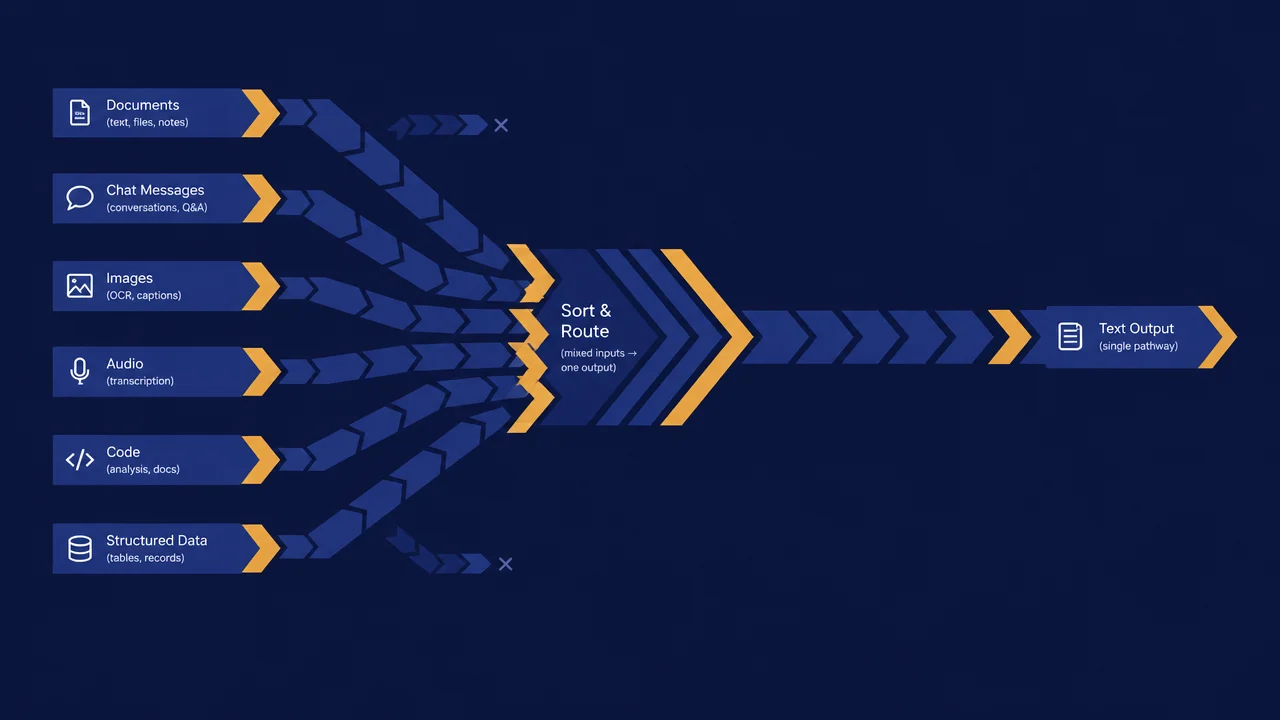
gpt-6.2-sol é um modelo de texto lançado pela OpenAI, já disponível na interface unificada do HiAPI.ai. Ele é a versão principal de uso diário da série GPT-6, e a OpenAI o posiciona como um modelo de uso comum, adequado desde programação até a condução de agentes em larga escala. Seu tipo de saída é texto puro, e esse é o primeiro filtro para julgar se ele é adequado para você, em vez de tratá-lo como uma caixa-preta genérica que «faz tudo».
Os cenários em que ele se sai melhor são: perguntas e respostas de conhecimento e consolidação/agrupamento de resultados de busca, rascunhos e reescrita de conteúdo, extração e classificação de dados estruturados, julgamento semântico em diálogos de múltiplas rodadas e decisões textuais como parte de um fluxo (triagem, rotulagem, resumo, reconhecimento de intenção). O ponto comum dessas tarefas é que a entrada é texto e a saída esperada também é texto, permitindo que o modelo seja embutido em serviços existentes como uma chamada de função.
O público-alvo são equipes de engenharia: que estão avaliando a introdução de um novo modelo de texto ou se preparando para migrar em lote as chamadas existentes para o novo modelo. Se você precisa gerar imagens ou áudio, isso está fora dos limites dele e deve ser descartado já na fase de seleção.
Um critério prático de julgamento: primeiro escreva em uma frase a tarefa que você quer resolver e pergunte «a entrada e a saída dessa tarefa são ambas texto?». Se a resposta for não, o modelo poderá, no máximo, assumir o trecho textual do fluxo.
Limites de capacidade: o que a saída de texto pode e não pode
Pense no gpt-6.2-sol como um duto de texto que entra e texto que sai. O que o duto faz é claro: dado um contexto de texto, produz um resultado de texto. Com base nisso, as tarefas que podem ser assumidas diretamente incluem classificação e rotulagem, resumo e reescrita, extração de informações, geração de perguntas e respostas, conversão de formato (por exemplo, de texto livre para o texto estruturado que você definiu) e ordenação e explicação de resultados de múltiplos candidatos.
As partes que precisam de etapas adicionais também devem ser reconhecidas desde já:
- Necessidade de saída estritamente estruturada: ao chamar a API Responses, é possível passar um JSON Schema em
text.formate ativar strict, fazendo com que o retorno seja gerado diretamente conforme a definição dos campos; no Chat Completions não há essa opção, sendo necessário recorrer à restrição por prompt. No Chat Completions, é preciso combinar restrições de prompt com validação e novas tentativas no servidor, não se podendo assumir que o primeiro retorno será necessariamente analisável. - Necessidade de fatos atualizados: a saída do modelo não equivale à fonte dos fatos; conteúdos que envolvem dados, tempo e estados externos devem ser fornecidos pela sua camada de busca ou banco de dados e então entregues ao modelo para organizar a linguagem.
- Necessidade de produtos não textuais: geração de imagens, voz e afins não estão no tipo de saída dele, sendo necessário conectar etapas especializadas.
- Necessidade de comportamento determinístico: a mesma requisição não garante reprodução literal; partes que envolvem lógica de consistência forte devem ficar no código, e não ser delegadas ao julgamento do modelo.
Escrever os limites no documento de design é muito mais barato do que corrigir na produção depois. Toda etapa que ultrapassa a capacidade de texto deve ser explicitamente marcada como «requer componente externo», para que não haja desalinhamento de expectativas na revisão.
Parâmetros principais e preço do gpt-6.2-sol
A seguir estão as informações já confirmadas ao chamar o gpt-6.2-sol via HiAPI; a integração e a estimativa de custos nas seções seguintes se baseiam nelas.
- Posicionamento: versão principal de uso diário da série GPT-6. A OpenAI o posiciona como um modelo de uso comum adequado desde programação até a condução de agentes em larga escala; é mais inteligente e econômico em tokens do que o GPT-6.1 Sol.
- Contexto e saída: janela de contexto de 1.050.000 tokens, saída máxima de 128.000 tokens por chamada.
- Data de corte do conhecimento: 2026-06-01.
- Saída e capacidades: saída em texto, com suporte a streaming e chamada de ferramentas (
tools). - Formas de chamada: suporta a API Responses (
https://api.hiapi.ai/v1/responses) e Chat Completions (https://api.hiapi.ai/v1/chat/completions). O nível de raciocínioreasoning.effort(low / medium / high / xhigh / max, padrão medium) e a saída JSON estruturadatext.formatsó estão disponíveis na API Responses. - Preço: o preço atual exibido na página do modelo (por milhão de tokens) é entrada US$ 0,500, entrada em cache US$ 0,025, saída US$ 2,500 e gravação em cache (5 minutos) US$ 0,625. A cobrança segue o exibido em tempo real na página do modelo gpt-6.2-sol.
Como escolher entre ele e o gpt-6.2-astra
O gpt-6.2-astra da mesma série é a versão de topo de linha, voltada aos projetos mais difíceis e de maior duração, com preço unitário mais alto. Recomenda-se que a maioria das tarefas comece com o Sol; diante de problemas que o Sol não resolve bem, como refatorações complexas entre módulos ou documentos técnicos de alta exigência, troque para o Astra. A forma de chamada dos dois é a mesma; a troca exige apenas alterar o nome do modelo.
Informações de interface a confirmar antes da integração
Na integração via HiAPI.ai, a página do modelo /models/gpt-6.2-sol é o ponto de entrada de informações. Recomenda-se verificar item a item a lista abaixo antes de escrever a primeira linha de código de chamada, tendo como referência a documentação oficial e da plataforma, sem adivinhar com base em posts da comunidade ou configurações de projetos antigos:
- Credenciais e forma de autenticação: de onde vem a chave, onde fica armazenada e como é injetada com segurança no servidor, jamais enviada ao navegador.
- Campos de requisição e obrigatórios: nomenclatura exata e restrições de valores de campos como identificador do modelo, estrutura de mensagens e limite de comprimento da geração.
- Restrições de contexto e comprimento de saída: a janela de contexto do gpt-6.2-sol é de 1.050.000 tokens e a saída máxima por chamada é de 128.000 tokens; como o limite de saída entra em vigor determina diretamente sua estratégia de divisão em blocos.
- Critérios de limitação de taxa e cota: em que dimensão o limite de taxa é contado (número de requisições ou volume de tokens) e qual é o formato de resposta após o acionamento.
- Semântica dos códigos de erro: quais erros vale a pena tentar novamente e quais são problemas de parâmetro em que a nova tentativa é inútil, precisam ser distinguidos.
- Critérios de precificação: este modelo é precificado por token, e a página do modelo indica separadamente os preços unitários de entrada, entrada em cache, saída e gravação em cache.
Consolide essas conclusões na documentação interna de integração da equipe; ao trocar de pessoa ou de modelo no futuro, essa lista de verificação poderá ser reutilizada diretamente. Qualquer item ainda não confirmado não deve ser incluído no ramo de produção.
Pontos-chave da chamada de API e organização de parâmetros
O trabalho central do lado da chamada não é enviar uma requisição, mas organizar a requisição em um encapsulamento reutilizável, observável e com degradação. Vejamos primeiro um exemplo mínimo: obter JSON estruturado com a API Responses. Ao usar o SDK oficial da OpenAI, basta apontar base_url para o HiAPI:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Extraia campos do ticket; preencha com null os campos ausentes.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Quem já tem um cliente Chat Completions pode chamar apenas trocando o nome do modelo para gpt-6.2-sol, mas o nível de raciocínio e a saída JSON estruturada não estão disponíveis no Chat Completions. A seguir, coloque em prática na ordem abaixo:
Estrutura da requisição
Separe as mensagens em duas camadas: restrições do sistema e conteúdo do usuário. A camada do sistema contém papel, requisitos de formato de saída e itens proibidos; a camada do usuário contém os dados de negócio. Não concatene os dados de negócio com as instruções em um mesmo trecho, caso contrário, quando houver problema, não será possível identificar se é problema de dados ou de instrução.
Contrato de saída
Deixe claro o formato esperado da saída (por exemplo, nomes de campos e se texto explicativo é permitido). Mesmo que isso esteja escrito, faça uma validação de análise no servidor: se a análise falhar, considere como uma chamada falha e siga para nova tentativa ou degradação, em vez de repassar o resultado incompleto diretamente ao frontend.
Exceções e novas tentativas
Novas tentativas só devem ocorrer em erros recuperáveis, como falhas de rede transitórias ou limitação de taxa. Erros como parâmetros inválidos ou conteúdo muito longo não fazem sentido para nova tentativa e devem ser reportados diretamente. As novas tentativas devem ter limite de número e intervalo de backoff, evitando amplificar uma falha em cascata.
Conjunto mínimo de observabilidade
Cada chamada deve registrar no mínimo: tempo de execução, volume de tokens de entrada e saída, se houve nova tentativa, e se o resultado final foi sucesso ou degradação. Esses itens determinam a capacidade de calcular custos e localizar problemas posteriormente. Uma integração sem logs equivale a não ter integração.
Estrutura de custos sob a precificação por token
O gpt-6.2-sol é precificado por token, o que significa que o custo de uma chamada não é um valor fixo, mas cresce linearmente com o volume de entrada e saída. O que deve ser estabelecido na engenharia é um modelo de custos, e não a memorização de um número:
- Lado da entrada: prompts de sistema, histórico de diálogo e contexto recuperado entram na conta. Em diálogos de múltiplas rodadas, se não houver corte, a entrada continua crescendo a cada rodada.
- Lado da saída: quanto mais longa a geração, maior a cobrança. Exigir explicações longas do modelo faz o custo subir de forma descontrolada.
- Custo total: o custo de uma requisição é composto por entrada e saída, portanto a otimização deve olhar os dois lados.
As contramedidas correspondentes: simplificar e reutilizar prompts de sistema; aplicar janela deslizante ou compressão por resumo no histórico de diálogo; dividir documentos longos antes de enviá-los conforme a necessidade; definir limites razoáveis para a saída; deduplicar e armazenar em cache tarefas em lote, para que a mesma entrada não seja cobrada repetidamente.
A forma correta de estimar o orçamento é executar uma rodada com amostras reais, calcular a média de tokens de entrada e saída e multiplicar pela escala de chamadas para obter uma ordem de grandeza. O preço atual está em «Parâmetros principais e preço» acima; os preços podem ser ajustados, e a cobrança segue o exibido em tempo real na página do modelo.
Usar comparação lado a lado para decidir se deve mudar
A seleção não deve se basear apenas em uma avaliação ou em uma única métrica. A forma mais segura é colocar o gpt-6.2-sol e seu modelo candidato atual no mesmo lote de amostras reais de negócio para comparação:
- Amostragem: extrair um lote de requisições representativas dos logs de produção ou dos dados anotados, cobrindo tarefas comuns e tarefas de cauda longa.
- Entrada unificada: mesmo prompt e mesmo lote de dados, alterando apenas o identificador do modelo, para eliminar a interferência de diferenças de prompt.
- Pontuação multidimensional: não olhar apenas a pontuação, mas também a taxa de conformidade de formato, a taxa de falhas, o consumo médio de tokens e o tempo médio de execução.
- Amostragem manual: a qualidade de expressão e os erros factuais que as métricas automáticas não capturam precisam ser verificados por pessoas.
- Decisão: definir claramente a linha de aprovação para a mudança, por exemplo, em que nível de conformidade de formato e de taxa de falhas a liberação é permitida.
O objetivo da comparação não é provar que o novo modelo é melhor, mas responder «na tarefa atual, os ganhos da mudança cobrem os custos de migração e operação?». Se a diferença não for significativa, manter o status quo também é uma decisão correta. Dentro da mesma série, para as tarefas mais difíceis e de maior duração, o gpt-6.2-astra também pode entrar na comparação; para a maioria das tarefas, recomenda-se começar com o Sol.
Perguntas frequentes e caminho de solução de erros
Para os problemas frequentes no início da integração, a investigação na ordem abaixo costuma ser a mais rápida:
- Tempo esgotado: primeiro verifique se a entrada está longa demais, elevando o tempo de processamento, e depois se é limitação de rede ou do servidor. O plano de degradação deve estar pronto antes da falha.
- Saída truncada: verifique se o limite de comprimento da geração está definido muito baixo e se o prompt do sistema exige uma saída longa demais. O truncamento muitas vezes não é problema do modelo, mas dos parâmetros.
- Formato de saída não conforme: confirme se os requisitos de formato no prompt são específicos o suficiente e se foram adicionadas validação e novas tentativas no servidor; em caso de falhas consecutivas, considere usar exemplos mais claros como restrição.
- Falha de autenticação: verifique se a chave foi injetada corretamente, se a chave do servidor não foi exposta ao frontend por engano e se há variáveis de ambiente ausentes.
- Erro de limitação de taxa: confirme a dimensão e o limite da limitação de taxa, adicione backoff e fila para evitar saturação por concorrência instantânea.
A disciplina básica de solução de erros é: primeiro identificar se é problema de construção da requisição, de restrição do servidor ou de análise do código de negócio, e só então fazer a alteração. Não tente a sorte ajustando parâmetros.
Monitoramento e iteração após o lançamento
O lançamento não é o fim. Trate a integração como uma cadeia em operação contínua e acompanhe pelo menos estas métricas: volume de chamadas e taxa de sucesso, taxa de conformidade de formato, média de tokens de entrada e saída, tempo médio de execução, proporção de degradação e de novas tentativas. Elas correspondem às quatro dimensões de capacidade, qualidade, custo e estabilidade.
No ritmo de iteração, recomenda-se revisar periodicamente as amostras de falha e o feedback dos usuários, consolidar erros típicos em novos casos de avaliação e, com base nisso, ajustar prompts, estratégias de divisão em blocos e limites de saída. Quando o modelo ou a configuração da plataforma mudarem, rode novamente a mesma bateria de casos de avaliação antes de decidir aumentar o tráfego.
Um princípio de lançamento útil: primeiro validar o efeito real com uma pequena parcela de tráfego em canário, depois ampliar gradualmente e, a qualquer momento, manter um interruptor para reverter ao modelo antigo. Se quiser ver primeiro os detalhes do modelo e as informações de integração, comece por /models/gpt-6.2-sol. Só consolidando ao mesmo tempo os três pilares — limites de capacidade, modelo de custos e monitoramento — o gpt-6.2-sol poderá se tornar uma etapa textual estável e confiável no seu sistema.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao gpt-6.2-astra: limites de capacidade do modelo de texto, pontos de integração e controle de custos
-

Guia de uso
Guia de introdução ao Tripo H3.1: três modos de entrada, parâmetros e como escolher o preço
Decisão de integração e controle de custos na geração 3D para desenvolvedores
-

Guia de uso
Gerar imagens de produtos de e-commerce com qwen-image-2.1-turbo via API HiAPI
Fluxo de trabalho visual de catálogo rápido para desenvolvedores: saída em PNG transparente e requisições de API executáveis