
Avaliação comparativa
GPT Image 2.6 vs 2.5: teste prático com o mesmo prompt — vale a pena atualizar?
Com o mesmo prompt de balcão de café, onde exatamente se manifesta a diferença entre 0,049 e 0,025
Nesta página
Conclusão antecipada: quando atualizar e quando permanecer no 2.5
Em uma frase: quando a imagem precisa conter texto preciso e legível, separação detalhada de componentes e camadas de material, atualize para o 2.6; se basta a atmosfera geral, a composição e o aspecto de esboço, permanecer no 1K do 2.5 é mais econômico.
Detalhando:
-
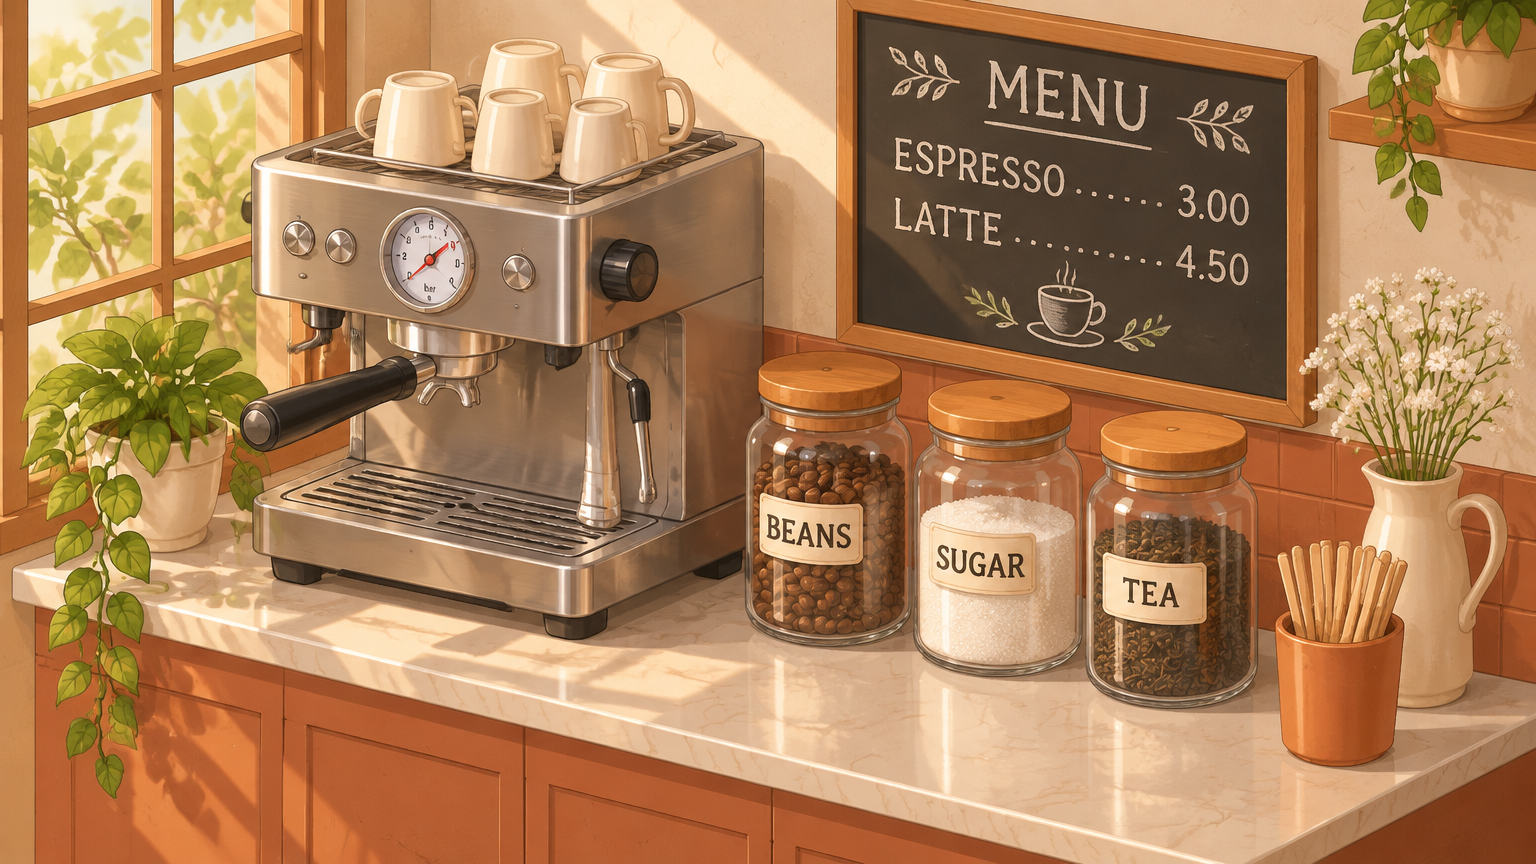
Se você precisa de marcações de manômetro, rótulos de produto, texto de embalagem e outros detalhes que devem permanecer nítidos mesmo ampliados, escolha o 2.6. Neste teste, o manômetro do 2.6 trouxe números de escala completos, e o menu até acrescentou uma linha de preço por conta própria.
-
Se você precisa manter personagens, produtos e layout consistentes em edições de múltiplas rodadas, escolha o 2.6 Sunburst com qualidade medium ou superior.
-
Se é apenas para testar composições rapidamente, produzir em lote ou criar imagens de fundo atmosféricas, o 1K do 2.5 já basta, com custo por imagem significativamente menor.
-
O nível de qualidade padrão do 2.6 é high; sem passar
quality, a imagem sai em high. É importante saber disso desde o início, caso contrário o custo pode subir sem você perceber.
Comparação de parâmetros: o 2.5 tem apenas a dimensão de resolução, o 2.6 acrescenta o nível de qualidade
Essa é a diferença mais fundamental entre os dois modelos e o ponto de partida de todas as comparações.
Os parâmetros de gpt-image-2.5-flare/text-to-image são apenas resolution (1K / 2K / 4K), aspect_ratio, background, output_format e prompt, sem o parâmetro quality. Você só pode escolher a resolução; o nível de qualidade de imagem do modelo não é um botão que você possa ajustar.
Já o gpt-image-2.6-flare/text-to-image tem duas dimensões independentes:
-
quality: low / medium / high / xhigh / max, padrão high. -
resolution: 1K / 2K / 4K, padrão 1K.
Além disso, há complexity (low / medium / high, nível de planejamento, independente de quality, padrão high), output_format (png por padrão, além de jpeg / webp / gif / svg; gif e svg disponíveis apenas em texto para imagem), output_compression (0–100, aplicável apenas a jpeg e webp) e background (auto / opaque / transparent, transparent requer png ou webp).
Conclusão: ao comparar 2.5 e 2.6, a única dimensão alinhável é a resolução. A dimensão de qualidade simplesmente não existe no 2.5, então afirmar uma «comparação no mesmo nível» não tem base. É por isso que todos os números abaixo são alinhados por resolução.
Comparação de critério de cobrança: onde está a diferença entre 0,049 e 0,025
Os critérios de cobrança dos dois lados são diferentes — essa é a razão estrutural da diferença de preço, e não simplesmente «o 2.6 é mais caro».
O 2.5 padrão cobra por resolução: 1K a 0,025 por imagem. Como não tem nível de qualidade, o preço na mesma resolução é fixo.
O 2.6 cobra por duas dimensões: nível de qualidade × resolução. Neste teste, sem passar quality, o modelo gerou em high por padrão, com high + 1K a 0,049 por imagem.
Assim, alinhando por resolução: 2.6 high 1K a 0,049 por imagem, 2.5 1K a 0,025 por imagem, diferença de 0,024 por imagem.
Essa diferença deve ser vista em dois contextos:
-
A diferença compra o teto de qualidade proporcionado pelo nível de qualidade. Se você não passa
quality, recebe high, e não o nível mais baixo do 2.6. Para reduzir custo, baixe explicitamentequalitypara low ou medium, e o preço acompanha. -
qualityeresolutionno 2.6 são dois botões independentes; qualquer combinação de «definir qualidade e depois resolver» funciona, não é preciso maximizar tudo.
Se passar explicitamente quality=low, o 1K do 2.6 fica em US$ 0,023, US$ 0,002 mais barato que o 1K do 2.5; o medium 1K fica em US$ 0,041.
Configuração do teste: mesmo prompt e parâmetros das duas chamadas
Para tornar as diferenças reproduzíveis, as duas chamadas usam exatamente o mesmo prompt, alterando apenas o modelo e os parâmetros necessários.
Texto do prompt:
Uma ilustração isométrica organizada de um pequeno balcão de café: uma máquina de espresso com manômetro visível, três potes de vidro rotulados BEANS, SUGAR e TEA, e um menu em lousa listando ESPRESSO e LATTE, luz quente da manhã através de uma janela, paleta em terracota suave e creme, bordas nítidas e limpas, sem marca d'água.
As duas chamadas:
-
2.6: modelo
gpt-image-2.6-flare/text-to-image, passandoquality=high,resolution=1K,aspect_ratio=16:9, imagem em 1536 × 864, US$ 0,049 por imagem. -
2.5: modelo
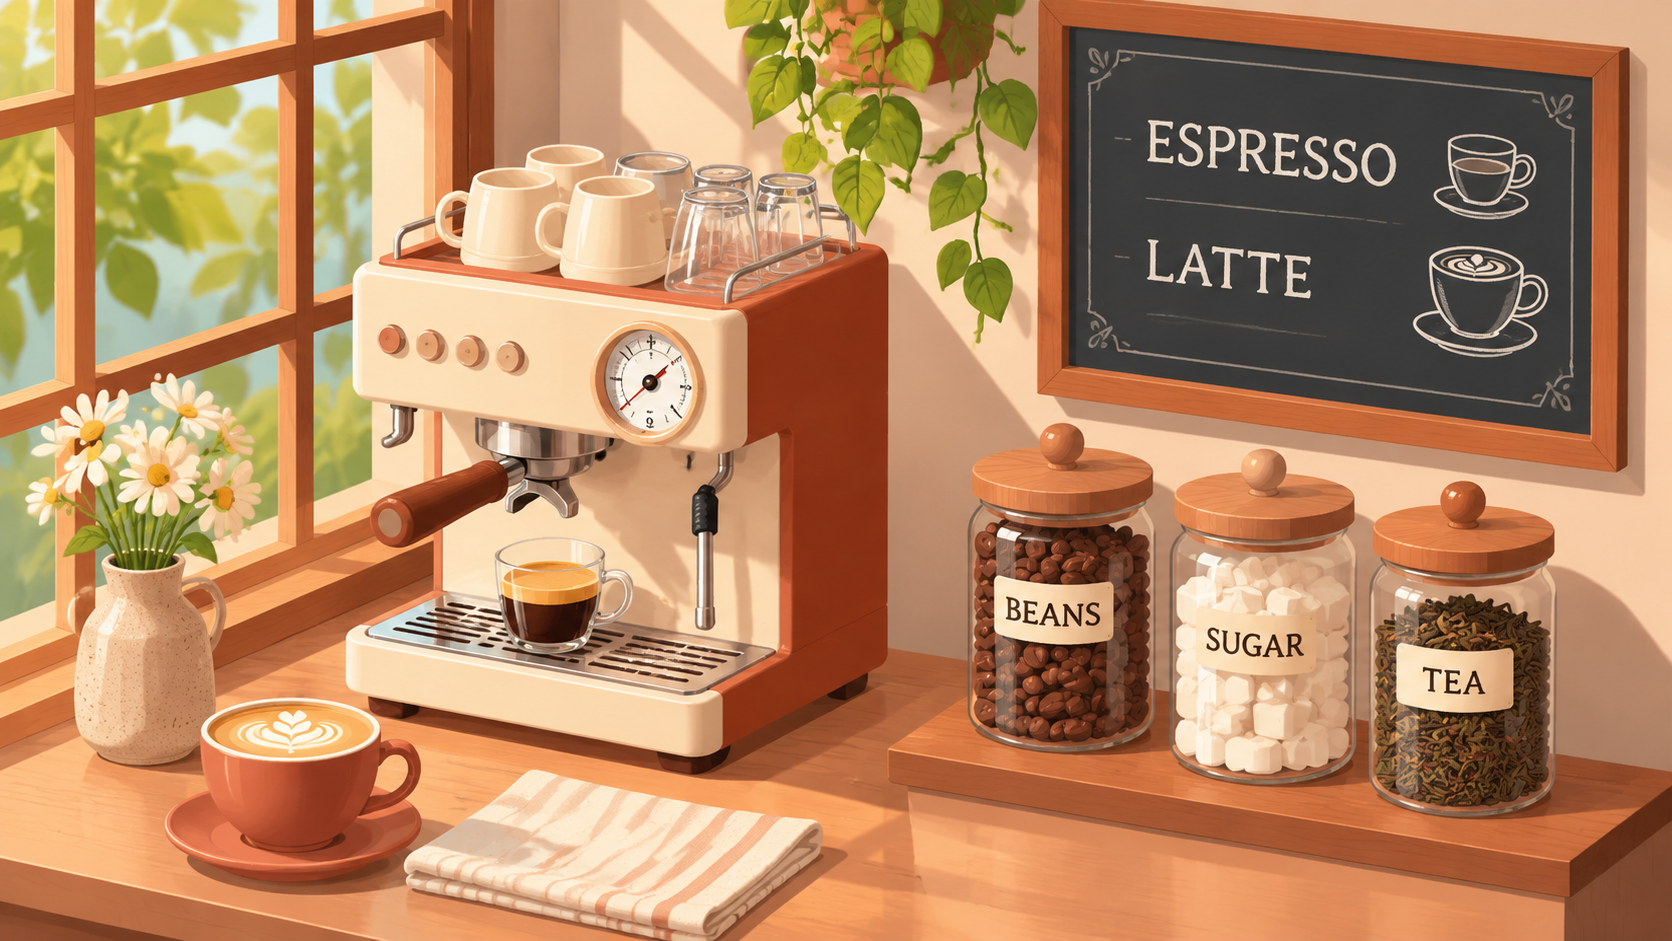
gpt-image-2.5-flare/text-to-image, passandoresolution=1K,aspect_ratio=16:9(esse modelo não tem o parâmetroquality), imagem em 1672 × 941, US$ 0,025 por imagem.
Cada lado gerou uma imagem, sem retentativas nem seleção — comparamos diretamente o primeiro resultado. A escolha desse prompt é intencional: ele contém texto (três rótulos de potes + duas linhas de nomes de pratos no menu), escala de manômetro, vários utensílios e representação de materiais, cobrindo justamente os pontos em que o 2.6 pode se destacar em relação ao 2.5.
Diferenças na imagem: texto, manômetro, utensílios e materiais
Primeiro, as duas imagens originais (ambas primeiras gerações, sem retentativas nem seleção).
Renderização de texto
Ambas acertaram os três rótulos de potes BEANS, SUGAR e TEA e os dois nomes de pratos ESPRESSO e LATTE, sem erros de escrita. A diferença está na quantidade de informação: o 2.6 acrescentou ao menu o título MENU e as duas linhas de preço «3.00» e «4.50» (não solicitado no prompt), com tipografia clara; o 2.5 desenhou dois ícones de xícara ao lado dos nomes dos pratos, sem preços.
Escala do manômetro
Manômetro da máquina de café: o mostrador do 2.6 tem números de escala completos e a unidade bar; o 2.5 também tem mostrador, linhas de escala e ponteiro, mas com poucos números.
Detalhes dos utensílios
Ambos desenharam o vaporizador, o grupo de extração, o porta-filtro e a bandeja de gotejamento. O 2.6 tem textura de aço inoxidável, com reflexos metálicos e emendas mais finos; o 2.5 tem corpo retrô cor de creme, formato mais arredondado e menos detalhes.
Materiais e estilo
No pote de açúcar do 2.6 há açúcar refinado; no do 2.5, cubos de açúcar. O 2.6 usa bancada de mármore, com mais camadas de reflexos e sombras, visual mais nítido e próximo de ilustração realista; o 2.5 usa bancada de madeira, com imagem mais suave e próxima de ilustração achatada.
Ambos entregaram o balcão completo em 16:9, sem falhas evidentes de composição. A diferença está na densidade de detalhes e na nitidez, não na estrutura da imagem. Esta é apenas uma amostra; o efeito com o seu prompt pode ser diferente, e vale a pena gerar uma imagem com cada modelo usando o seu próprio prompt.
Diferenças nas dimensões de saída e na semântica de resolução
Um ponto fácil de ignorar: passando igualmente resolution=1K, aspect_ratio=16:9, os dois modelos entrega pixels diferentes.
-
2.6 Flare: 1536 × 864
-
2.5 Flare: 1672 × 941
Ou seja, 1K é um nível de resolução, não um conjunto fixo de pixels; modelos diferentes entregam pixels diferentes. Tratar 1K como «sempre tantos pixels» para adaptação de layout, sobreposição de camadas ou pós-processamento em lote facilmente leva a erros.
Recomendação prática: se o fluxo downstream depende de dimensões fixas em pixels, não presuma — valide e redimensione com base na largura e altura realmente retornadas; os pixels só são estáveis dentro do mesmo modelo e do mesmo nível de resolução. Ao comparar antes e depois, a diferença de pixels no nível 1K também não deve ser tratada como diferença de qualidade; é apenas um mapeamento diferente de nível.
Seleção por cenário: precisão de texto, iteração em lote e sensibilidade a custo
Levando as conclusões do teste para a escolha de linha, há basicamente três casos.
Necessidade de texto preciso e detalhes de componentes
Use o 2.6 diretamente. Para conteúdos como escalas de manômetro e rótulos de produto, que devem permanecer nítidos mesmo ampliados, o nível high do 2.6 se mostrou mais claro neste teste. Nesses casos, os US$ 0,024 adicionais por imagem costumam sair mais baratos que o retrabalho. Consulte a descrição de parâmetros do gerador de imagens a partir de texto gpt-image-2.6-flare e especifique quality explicitamente conforme necessário.
Iteração em lote e teste rápido de composição
Use o 2.6 Flare com quality reduzido para low ou medium: teste a composição em nível baixo primeiro e, após escolher, suba para high para a versão final. O Flare gera imagens mais rapidamente, adequado para iteração rápida e produção em lote, sendo a linha recomendada por padrão. Se você precisa manter personagens, produtos e layout consistentes em edições de múltiplas rodadas, use o Sunburst com qualidade medium ou superior; o gerador de imagens a partir de texto gpt-image-2.6-sunburst tem parâmetros, uso e preço idênticos aos do Flare, mudando apenas a orientação de detalhes.
Sensível a custo, apenas atmosfera e composição
Permaneça no 2.5. Também em 1K, o preço por imagem do 2.5 é significativamente menor; se a necessidade é apenas imagem de fundo, atmosfera ou esboço, e a precisão de texto não é crítica, esse nível é a escolha mais econômica. Neste teste, o gerador de imagens a partir de texto gpt-image-2.5-flare acertou os rótulos e nomes de pratos, e a imagem também ficou completa.
Para memorizar em uma frase: defina primeiro o nível de qualidade por cenário e depois a resolução, o que economiza mais do que maximizar tudo por padrão; veja todos os preços de níveis na página de preços.
Atualizar ou não depende de se os detalhes e a nitidez na sua imagem valem os US$ 0,024 — se valem, atualize; se não, o 2.5 continua suficiente.
Artigos relacionados
Ver todos os artigos →-

Avaliação comparativa
Wan 2.6 Flash vs Wan 2.7: vale a pena atualizar?
Orçamento em 720P e resultados em 1080P da raposa e do carro; condições de áudio e faixas reais indicadas conjunto por conjunto.
-

Avaliação comparativa
Vidu Q4 Preview vs Kling 3.0: como escolher para vídeo a partir de imagem?
Com som padrão, 16 segundos e 5 níveis de resolução, escolha o Vidu Q4 Preview; para travar a imagem com primeiro e último frame, escolha o Kling 3.0. Inclui duas comparações com o mesmo prompt: hidroavião e barista.
-

Avaliação comparativa
Alternativa ao Replicate: comparação entre hiapi e Replicate para geração de imagem e vídeo (2026)
O que precisa mudar nas chamadas de previsão, nos webhooks e na cobrança ao migrar do Replicate para o hiapi, com uma lista de migração em 10 passos.