
Confronto e valutazione
GPT Image 2.6 vs 2.5: test pratico con lo stesso prompt, l'aggiornamento vale la pena?
Con lo stesso prompt del bancone da caffè, dove si vede davvero la differenza tra 0,049 e 0,025
In questa pagina
Prima la conclusione: quando aggiornare e quando restare alla 2.5
Versione in una frase: quando nell'immagine devono comparire testo preciso e leggibile, componenti dettagliati e livelli di materiale, aggiorna alla 2.6; se ti serve solo l'atmosfera generale, la composizione e un effetto bozza, restare alla 2.5 a 1K conviene di più.
Spiegando meglio:
-
Se servono dettagli come tacche di strumenti, etichette di prodotto e testi su confezioni che devono restare chiari anche ingranditi, scegli la 2.6. In questo test, il manometro della 2.6 riporta tutte le tacche numeriche e il menu aggiunge da solo una riga di prezzo.
-
Se servono più round di modifica mantenendo coerenti personaggi, prodotti e impaginazione, scegli la 2.6 Sunburst con qualità medium o superiore.
-
Se devi solo provare rapidamente la composizione, produrre in serie o creare immagini di sfondo atmosferiche, la 2.5 a 1K basta e il costo per immagine è nettamente inferiore.
-
La qualità predefinita della 2.6 è high: se non passi
quality, l'immagine viene generata in high. È bene saperlo subito, altrimenti si rischia di alzare i costi senza accorgersene.
Confronto dei parametri: la 2.5 ha solo la risoluzione, la 2.6 aggiunge la qualità
È la differenza più radicale tra i due modelli, nonché il punto di partenza di ogni confronto.
I parametri di gpt-image-2.5-flare/text-to-image sono solo resolution (1K / 2K / 4K), aspect_ratio, background, output_format e prompt, senza il parametro quality. Puoi scegliere solo la risoluzione; il livello di qualità del modello non è una manopola che puoi regolare.
gpt-image-2.6-flare/text-to-image ha invece due dimensioni indipendenti:
-
quality: low / medium / high / xhigh / max, predefinito high. -
resolution: 1K / 2K / 4K, predefinito 1K.
Inoltre ci sono complexity (low / medium / high, livello di pianificazione, indipendente da quality, predefinito high), output_format (png predefinito, oltre a jpeg / webp / gif / svg; gif e svg sono disponibili solo nella generazione da testo), output_compression (0–100, valido solo per jpeg e webp) e background (auto / opaque / transparent; transparent richiede png o webp).
In conclusione: confrontando 2.5 e 2.6, l'unica dimensione allineabile è la risoluzione. La dimensione della qualità non esiste affatto nella 2.5, quindi parlare di «confronto a parità di livello» non ha fondamento. È anche il motivo per cui tutti i numeri seguenti sono allineati per risoluzione.
Confronto dei criteri di tariffazione: dove sta la differenza tra 0,049 e 0,025
I criteri di tariffazione dei due modelli sono diversi: è questa la causa strutturale della differenza di prezzo, non un semplice «la 2.6 costa di più».
La 2.5 standard fattura per risoluzione: 1K a 0,025 per immagine. Non ha livelli di qualità, quindi a parità di risoluzione il prezzo è fisso.
La 2.6 fattura su due dimensioni, qualità × risoluzione. In questo test non abbiamo passato quality, quindi il modello ha generato in high predefinito: high + 1K a 0,049 per immagine.
Pertanto, a parità di risoluzione: 2.6 high 1K a 0,049, 2.5 1K a 0,025, differenza di 0,024 per immagine.
Questa differenza va letta in due contesti:
-
La differenza paga il limite massimo di qualità consentito dal livello qualitativo. Se non passi
quality, ottieni high, non il livello minimo della 2.6. Per ridurre i costi, abbassa esplicitamentequalitya low o medium e il prezzo scenderà di conseguenza. -
qualityeresolutiondella 2.6 sono due manopole indipendenti: qualsiasi combinazione «prima il livello di qualità, poi la risoluzione» è valida, non serve puntare sempre al massimo.
Se passi esplicitamente quality=low, la 2.6 a 1K costa $0,023, cioè $0,002 in meno della 2.5 a 1K; medium 1K costa $0,041.
Impostazioni del test: stesso prompt e parametri delle due chiamate
Per rendere le differenze riproducibili, le due chiamate usano esattamente lo stesso prompt, cambiando solo modello e parametri necessari.
Testo del prompt:
A tidy isometric illustration of a small coffee counter: an espresso machine with a visible pressure gauge, three glass jars labelled BEANS, SUGAR and TEA, and a chalkboard menu listing ESPRESSO and LATTE, warm morning light through a window, muted terracotta and cream palette, crisp clean edges, no watermark.
Le due chiamate:
-
2.6: ID modello
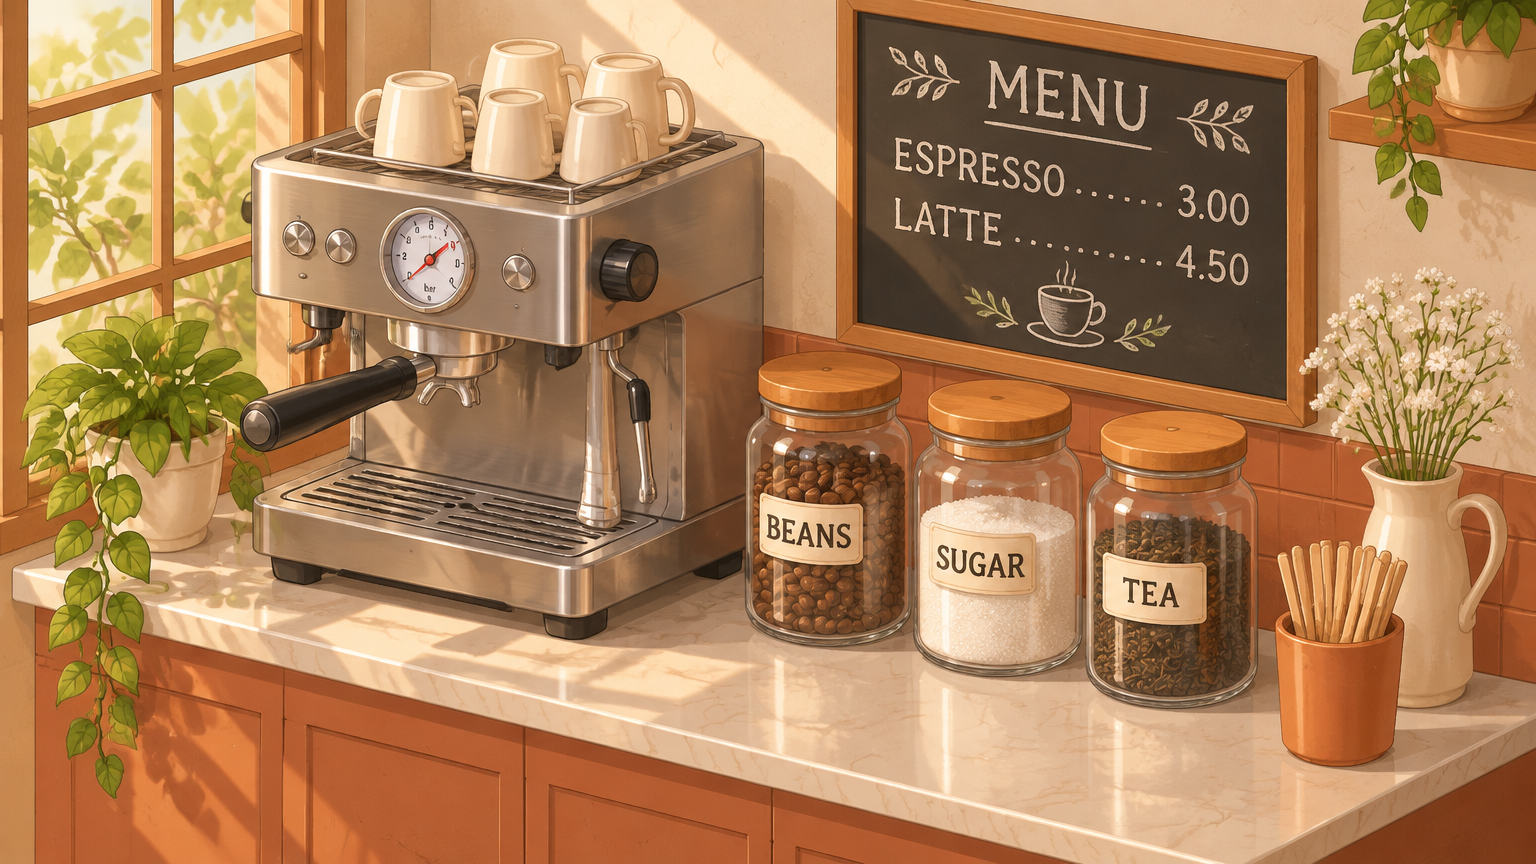
gpt-image-2.6-flare/text-to-image, conquality=high,resolution=1K,aspect_ratio=16:9, immagine 1536 × 864, 0,049 per immagine. -
2.5: ID modello
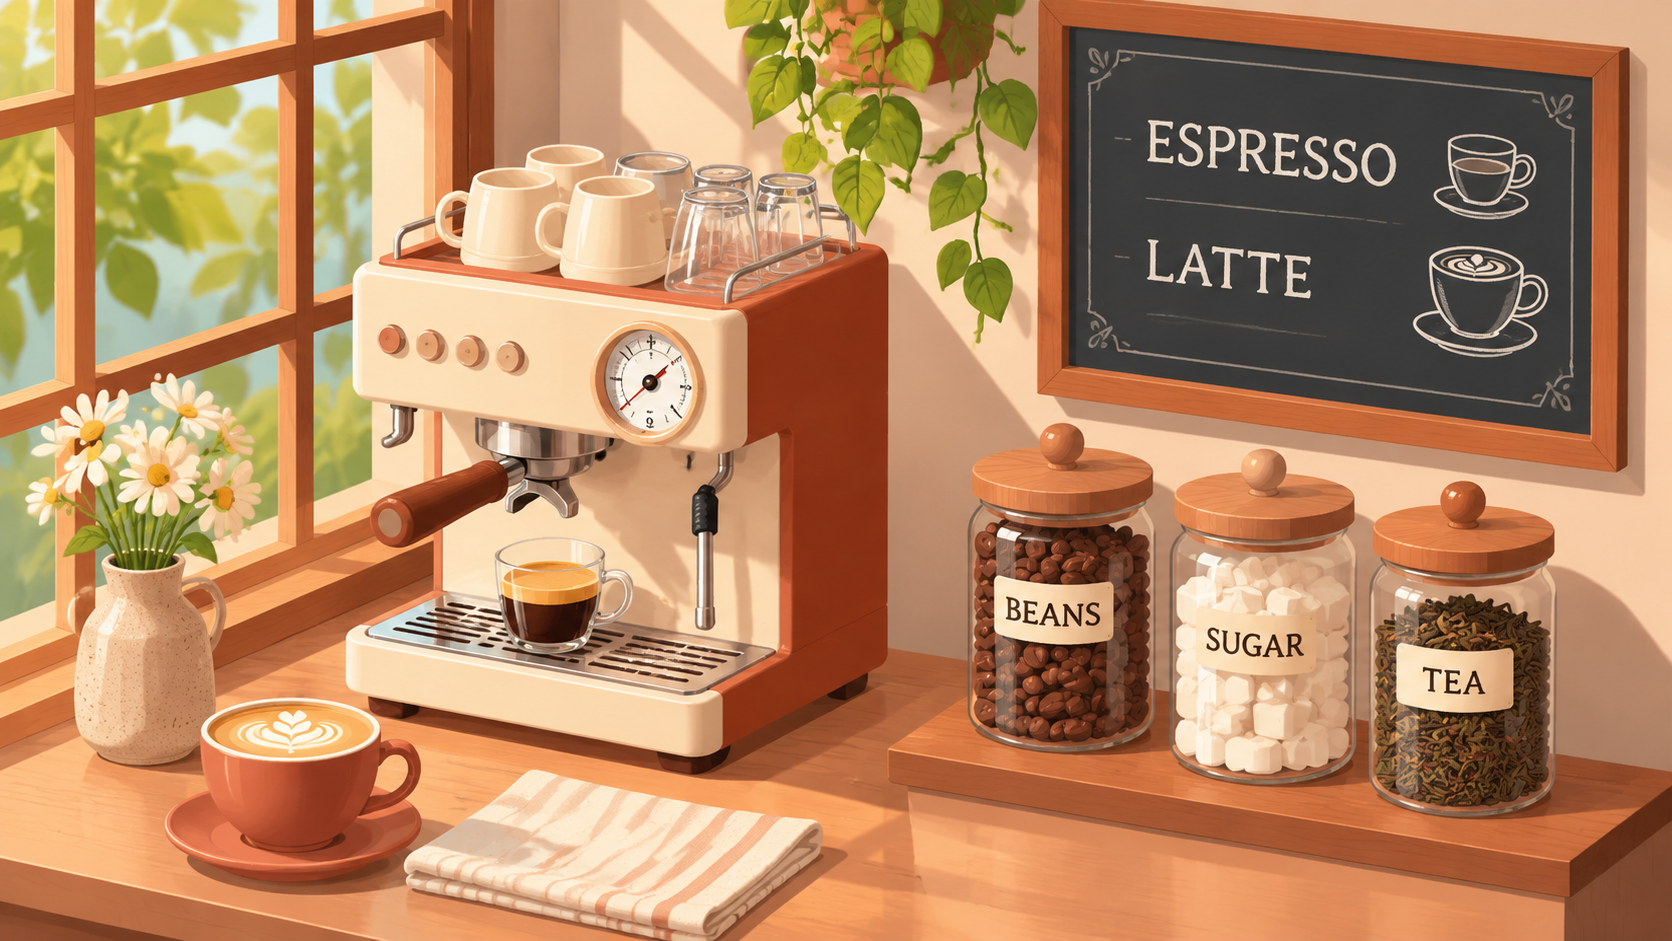
gpt-image-2.5-flare/text-to-image, conresolution=1K,aspect_ratio=16:9(questo modello non ha il parametroquality), immagine 1672 × 941, 0,025 per immagine.
Abbiamo eseguito una generazione per ciascuno, senza retry e senza selezione, confrontando direttamente il primo risultato. La scelta del prompt è intenzionale: contiene testo (le etichette dei tre barattoli + le due voci del menu), tacche di uno strumento, più utensili e resa dei materiali, coprendo proprio i punti in cui la 2.6 potrebbe distanziare la 2.5.
Differenze nell'immagine: testo, strumenti, utensili e materiali
Guardiamo prima le due immagini originali (entrambe al primo tentativo, senza retry né selezione).
Rendering del testo
Entrambe scrivono correttamente le etichette BEANS, SUGAR e TEA dei tre barattoli e le due voci ESPRESSO e LATTE, senza errori. La differenza è nella quantità di informazioni: la 2.6 aggiunge al menu il titolo MENU e due righe di prezzo «3.00» e «4.50» (non richiesti nel prompt), con caratteri nitidi; la 2.5 disegna due icone di tazzine da caffè accanto alle voci, senza prezzi.
Tacche dello strumento
Manometro della macchina da caffè: il quadrante della 2.6 riporta tutte le tacche numeriche e l'unità bar; anche la 2.5 ha quadrante, tacche e lancetta, ma con pochi numeri.
Dettagli degli utensili
Entrambe disegnano l'asta del vapore, il gruppo di erogazione, il portafiltro e la vaschetta di raccolta. La 2.6 ha una resa in acciaio inox, con riflessi metallici e giunzioni più fini; la 2.5 ha una carrozzeria vintage color crema, forme più arrotondate e meno dettagli.
Materiali e stile
Nel barattolo dello zucchero la 2.6 mette zucchero semolato, la 2.5 zollette; la 2.6 usa un piano in marmo, con più livelli di macchie di luce e ombre, risultando più nitida e vicina a un'illustrazione realistica; la 2.5 ha un piano in legno, un'immagine più morbida e tendente all'illustrazione piatta.
Entrambe mostrano un bancone completo in 16:9, senza evidenti errori di composizione. Le differenze stanno nella densità dei dettagli e nella nitidezza, non nella struttura dell'immagine. Questo è solo un campione: con il tuo prompt il risultato può essere diverso, vale la pena eseguirlo con entrambi i modelli.
Differenze nelle dimensioni di output e nel significato della risoluzione
Un punto facile da trascurare: pur passando resolution=1K e aspect_ratio=16:9, i due modelli restituiscono pixel diversi.
-
2.6 Flare: 1536 × 864
-
2.5 Flare: 1672 × 941
In altre parole, 1K è un livello di risoluzione, non un insieme fisso di pixel: modelli diversi restituiscono pixel diversi. Trattare 1K come «un numero preciso di pixel» per adattare l'impaginazione, sovrapporre livelli o eseguire post-elaborazioni in batch porta facilmente a errori.
Consiglio pratico: se il flusso a valle dipende da dimensioni in pixel fisse, non dare nulla per scontato; verifica e ridimensiona in base a larghezza e altezza effettivamente restituite. I pixel sono stabili solo all'interno dello stesso modello e dello stesso livello di risoluzione. Nei confronti prima/dopo, la differenza di pixel a 1K non va interpretata come differenza di qualità: è solo una diversa mappatura dei livelli.
Scelta per scenario: precisione del testo, iterazioni in batch e sensibilità ai costi
Traducendo le conclusioni del test in scelte operative, si delineano tre casi.
Servono testo preciso e dettagli dei componenti
Usa direttamente la 2.6. Per contenuti come tacche di strumenti ed etichette di prodotto che devono restare chiari anche ingranditi, in questo test il livello high della 2.6 è più nitido. Quando ci sono questi requisiti, i $0,024 in più per immagine di solito costano meno di un rifacimento. Puoi consultare la descrizione dei parametri di gpt-image-2.6-flare text-to-image e specificare esplicitamente quality secondo necessità.
Iterazioni in batch e prove rapide di composizione
Usa 2.6 Flare e abbassa quality a low o medium: esegui prima la composizione a livello basso, poi passa a high per la versione finale dopo aver scelto. Flare genera più velocemente, è adatto a iterazioni rapide e generazione in batch ed è la linea consigliata predefinita. Se hai bisogno di mantenere coerenti personaggi, prodotti e impaginazione su più round di modifica, usa Sunburst con qualità medium o superiore; gpt-image-2.6-sunburst text-to-image ha parametri, utilizzo e prezzi identici a Flare, cambia solo l'orientamento ai dettagli.
Sensibilità ai costi, solo atmosfera e composizione
Resta alla 2.5. A parità di 1K, il prezzo per immagine della 2.5 è nettamente inferiore: se l'esigenza è solo un'immagine di base, atmosfera o bozza e la precisione del testo non è critica, questo livello è la scelta più economica. In questo test, gpt-image-2.5-flare text-to-image ha scritto correttamente etichette e nomi dei piatti, con un'immagine completa.
Da ricordare in una frase: prima si sceglie il livello di qualità in base allo scenario, poi la risoluzione: così si risparmia rispetto a puntare sempre al massimo; tutti i prezzi dei livelli sono nella pagina dei prezzi.
Se aggiornare o no dipende dal valore che dettagli e nitidezza hanno nella tua immagine rispetto a quei $0,024: se valgono, aggiorna; se non valgono, la 2.5 resta sufficiente.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Wan 2.6 Flash vs Wan 2.7: conviene aggiornare?
Budget 720P e risultati 1080P di volpe e auto; condizioni audio e livello effettivo indicati per ogni gruppo.
-

Confronto e valutazione
Vidu Q4 Preview vs Kling 3.0: come scegliere per il video da immagine?
Con audio di default, 16 secondi e 5 livelli di risoluzione scegli Vidu Q4 Preview; con primo e ultimo frame per bloccare l'immagine scegli Kling 3.0. In allegato due confronti con lo stesso prompt: idrovolante e barista.
-

Confronto e valutazione
Alternativa a Replicate: confronto hiapi vs Replicate per la generazione di immagini e video (2026)
Cosa cambia nelle chiamate di prediction, nei webhook e nella fatturazione quando si migra da Replicate a hiapi, con una checklist di migrazione in 10 passaggi.