
Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Портретно-управляемая модель говорящего видео от Pruna AI: на основе одного портретного изображения она генерирует говорящие видеоролики с синхронизацией губ и сменой выражений лица; её можно приводить в действие загруженным аудио или же сразу озвучивать сценарий встроенным синтезом речи. Подходит для объяснений на курсах, многоязычного дубляжа и массового производства коротких видео с цифровыми аватарами.
Попробовать p-video-2-pro-avatar
Ввод
Работы
Все работыВывод
videoВизуальные заметки о языке кадра: цифровой ведущий объясняет команды
Стиль Голосовое озвучивание · язык-камеры · студия
Референсные входы
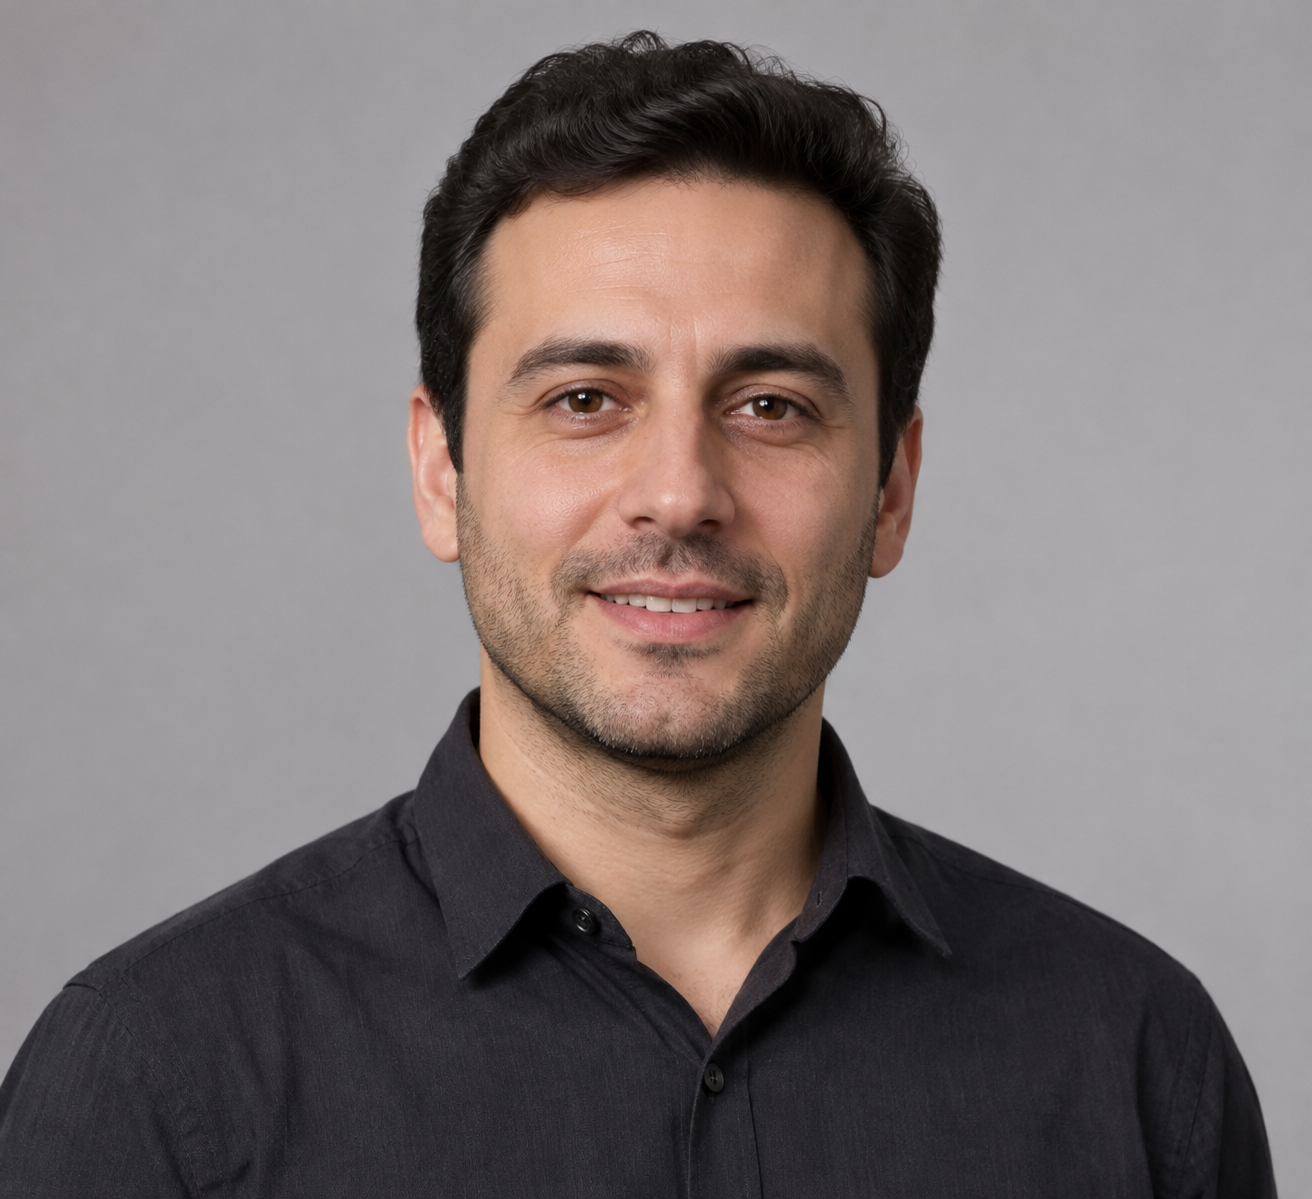
Изображение портрета
Промпт
Лектор в тёмной рубашке со спокойной манерой стоит перед мягким светло-серым фоном студии и, обращаясь к камере, поочерёдно объясняет термины движения камеры. Плечи и голова слегка двигаются в ритме речи, выражение сосредоточенное и сдержанное, взгляд ровно направлен в камеру. Спереди сбоку падает нейтральный мягкий основной свет, дополненный лёгкой отражённой подсветкой, создавая тихую атмосферу учебного класса; текстура кожи реалистична, по ходу фраз он естественно моргает и слегка кивает.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Рассказ куратора после закрытия галереи
Стиль Говорящий портрет · Музей · Культура
Референсные входы
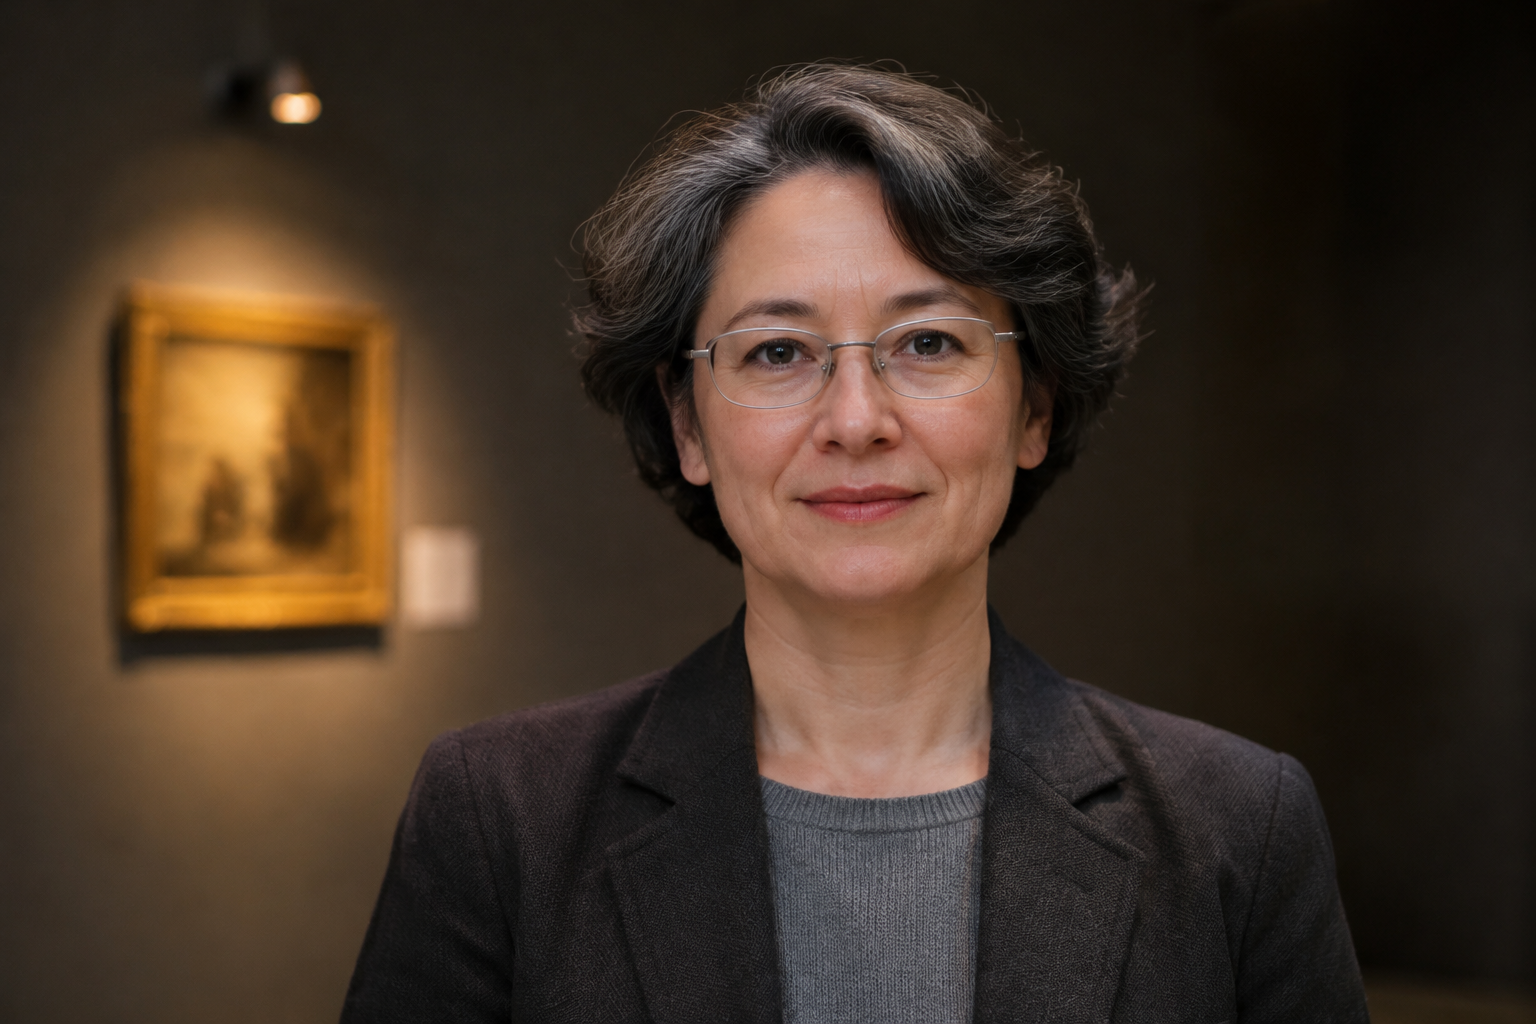
Изображение портрета
Промпт
Куратор, женщина средних лет, сидит на краю скамьи в галерее; позади неё, чуть сбоку, мягко освещённая выставочная стена, она спокойно рассказывает в камеру об одном экспонате; она слегка кивает, естественно моргает, выражение лица сдержанное и доброжелательное; малая глубина резкости, тёплый свет вольфрамовых ламп галереи с мягким затуханием, тихая музейная атмосфера, едва заметное движение только в области лица и плеч.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
p-video-2-pro-avatar per second
| Характеристики | Цена за единицу |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Краткое описание
Модель генерации видео для сценариев с цифровым ведущим: загрузите портрет человека в качестве первого кадра, затем предоставьте аудио с речью или введите текст сценария — и модель создаст видео, в котором человек говорит. Сценарий озвучивается встроенным синтезатором речи с выбором из нескольких голосов и языков, а с помощью промпта описываются движения и мимика говорящего человека. Подходит для создателей контента, которым нужен реальный человек в кадре: обучающие курсы, маркетинговые ролики, короткие видео для соцсетей — без съёмок и работы над синхронизацией губ.
Ключевые возможности
- Один портрет — и говорящее видео готово — достаточно одного портрета в качестве первого кадра, без исходного видеоматериала, чтобы получить кадры с говорящим человеком.
- Два способа управления: аудио и сценарий — можно загрузить аудио с речью длительностью до 3 минут или ввести сценарий для озвучивания встроенным синтезатором; длина видео соответствует длине речи.
- Управление мимикой и движениями через промпт — опишите в промпте внешний вид, движения и выражение лица говорящего человека, а также задайте случайное зерно для воспроизводимости результата.
- Несколько разрешений под любые задачи — доступны пять уровней разрешения: 480p, 768p, 1080p, 2k и 4k, что позволяет выбрать качество под конкретную площадку публикации.
Описание возможностей
Говорящее видео на основе портрета: укажите HTTPS-ссылку на портрет в формате jpg, jpeg, png или webp в качестве первого кадра — модель создаст видео с говорящим человеком, а содержимое кадра описывается в промпте через внешний вид, движения и мимику.
Управление артикуляцией по загруженному аудио: предоставьте HTTPS-ссылку на аудио с речью; длина видео будет соответствовать длине аудио, максимум 3 минуты; при использовании разрешения 4k максимальная длина аудио — 125 секунд. В этом случае настройки сценария, голоса, языка и стиля речи не применяются.
Управление через сценарий с озвучиванием: если аудио не предоставлено, введите сценарий длиной до 5000 символов — он будет озвучен встроенным синтезатором речи, и на его основе будет создано видео. Язык сценария выбирается из десяти заданных языков; для описания тона и ритма речи можно использовать до 1000 символов описания стиля речи.
Выбор голоса и параметров кадра: выберите один из 30 встроенных голосов для озвучивания сценария, опишите кадр промптом до 2000 символов и задайте случайное зерно в диапазоне от 0 до 2147483647; разрешение выбирается из 480p, 768p, 1080p, 2k и 4k, по умолчанию — 768p.
Сценарии применения
- Массовые видео с лектором для курсов — преподаватель предоставляет портрет и сценарий лекции, а модель массово создаёт видео с человеком в кадре для онлайн-курсов или образовательных рубрик.
- Маркетинговые материалы с реальным человеком в кадре — маркетологи создают ролики с портретом представителя бренда и рекламным текстом для размещения в лентах или на брендовых аккаунтах в соцсетях.
- Готовое видео по уже имеющейся записи — авторы загружают собственную аудиозапись и портрет, артикуляция на видео синхронизируется с записью, и получается короткое видео для соцсетей.
- Превращение статичного портрета в говорящее видео — используйте имеющуюся фотографию человека вместе со сценарием или аудио, чтобы получить говорящий кадр с мимикой и артикуляцией для рубрик с цифровым ведущим или презентационных страниц.
Ограничения и рекомендации по выбору
Для сценария и промпта есть ограничения по длине: промпт — до 2000 символов, сценарий — до 5000 символов, описание стиля речи — до 1000 символов. Встроенная озвучка не поддерживает китайский язык; язык сценария нужно выбирать из английского, испанского, французского, немецкого, итальянского, португальского (Бразилия), японского, корейского и хинди. Длина видео определяется речью и составляет максимум 3 минуты; при использовании разрешения 4k максимальная длина аудио — 125 секунд.
Новости
Смотреть changelog →- Новая модель Запуск P-Video 2 Pro Avatar: одно портретное фото плюс аудио или текст — видео с говорящим человеком длительностью до 3 минут
Частые вопросы
Все частые вопросы →-
Каким аудио управлять цифровым человеком?
Передайте HTTPS-ссылку на аудио через audio_url; длительность видео равна длительности аудио, максимум 3 минуты (для 4k — максимум 125 секунд). После передачи аудио параметры script, voice, voice_language и voice_prompt не действуют; если переданы и аудио, и они, приоритет у аудио.
-
Какой длины текст сценария можно ввести?
Поле script допускает не более 5000 символов, но итоговая длина видео определяется длительностью озвучивания этого сценария встроенным TTS, при этом верхний предел — 3 минуты; при приближении к лимиту рекомендуется сначала сократить текст или генерировать по частям.
-
Как лучше составить prompt для видео с говорящим человеком?
В prompt описывается внешность персонажа, его движения и выражение лица во время речи, без реплик. Рекомендуется писать в порядке «внешность персонажа → амплитуда движений → мимика и направление взгляда → ощущение от кадра», например «мужчина в тёмном костюме, естественная поза сидя, время от времени кивает, с улыбкой смотрит в камеру, статичный средний план», укладываясь в 2000 символов; значение по умолчанию — просто «The person is talking.».
-
Какие языки и голоса поддерживаются?
В voice_language доступно 10 языков: американский английский, британский английский, испанский, французский, немецкий, итальянский, бразильский португальский, японский, корейский и хинди; китайского пока нет. В voice есть 30 предустановленных голосов, в названиях указан пол, по умолчанию — Zephyr (Female). Текст script должен соответствовать выбранному языку.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: p-video-2-pro-avatar
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для p-video-2-pro-avatar и маршрута default — см. таблицу параметров ниже.
seedintegerНеобязательноmin 0max 2147483647Случайное зерно, целое число от 0 до 2147483647; передача одинакового зерна при неизменных прочих входных данных помогает воспроизвести результат, если не передано — значение случайное.
voicestringНеобязательноПо умолчанию: "Zephyr (Female)"Тембр голоса, используемый встроенным синтезом речи, по умолчанию Zephyr (Female). Если указан audio_url, этот параметр игнорируется.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Показать все (22)Свернуть
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringНеобязательноПо умолчанию: "The person is talking."maxLength 2000Описание содержимого видео: внешний вид, движения и поведение персонажа во время речи; по умолчанию «The person is talking.».
scriptstringНеобязательноmaxLength 5000Точный текст, который будет озвучивать цифровой человек, записанный на выбранном voice_language (китайский не поддерживается). Обязателен, если не указан audio_url; длительность озвучивания определяет длину видео, максимум 3 минуты.
audio_urlstringНеобязательноpattern ^https://HTTPS-URL аудио с речью, максимум 3 минуты (при разрешении 4k — максимум 125 секунд); длина видео совпадает с длиной аудио. Если указан, параметры script, voice, voice_language и voice_prompt игнорируются.
image_urlstringОбязательноpattern ^https://HTTPS-URL портретного изображения говорящего человека, используется как первый кадр видео; поддерживаются форматы jpg, jpeg, png, webp.
resolutionstringНеобязательноПо умолчанию: "768p"Выходное разрешение: 480p, 768p, 1080p, 2k или 4k, по умолчанию 768p; чем выше разрешение, тем выше стоимость.
480p768p1080p2k4kvoice_promptstringНеобязательноПо умолчанию: "Say the following."maxLength 1000Инструкция по стилю речи, описывающая тональность, ритм, акцент или эмоциональную окраску и т. п.; не озвучивается; по умолчанию «Say the following.». Если указан audio_url, игнорируется.
voice_languagestringНеобязательноПо умолчанию: "English (US)"Язык текста script, по умолчанию English (US). Если указан audio_url, игнорируется.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseПоказать все (2)Свернуть
KoreanHindicallbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →
Похожие модели
Все модели →Тот же тип
-
 Hailuo 2.3 MiniMax $0.270 /видео
-
 Kling 2.5 Kuaishou $0.090 /секунду
-
 Gemini Omni 1.1 Google $0.450 /видео
-
 Muse Video 1.0 Meta $0.034 /видео
-
 Vidu Q4 Preview Vidu $0.051 /секунду
-
 Kling 4.0 Kuaishou $0.204 /секунду
-
 Grok Imagine 1.5 xAI $0.011 /секунду
-
 PixVerse V6 Max PixVerse $0.030 /секунду
-
 Vidu Q3 Vidu $0.149 /секунду
-
 Wan 2.6 Flash Alibaba $0.043 /секунду
-
 P-Video 2 Pro Replace Pruna AI $0.036 /секунду
-
 Veo 3.1 Google $0.290 /секунду