Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Modello di video parlante guidato da ritratti di Pruna AI: da un singolo ritratto è possibile generare clip di parlato con sincronizzazione labiale e variazioni di espressione, azionabili tramite audio caricato oppure leggendo direttamente il copione con la sintesi vocale integrata; ideale per spiegazioni didattiche, doppiaggi multilingua e produzione in serie di video brevi con avatar digitali
Prova p-video-2-pro-avatar
Input
Creazioni
Vedi tutte le creazioniOutput
videoNote visive sul linguaggio cinematografico · presentazione di un avatar digitale che spiega i termini
Stile Voce fuori campo · linguaggio-della-fotocamera · studio
Input di riferimento
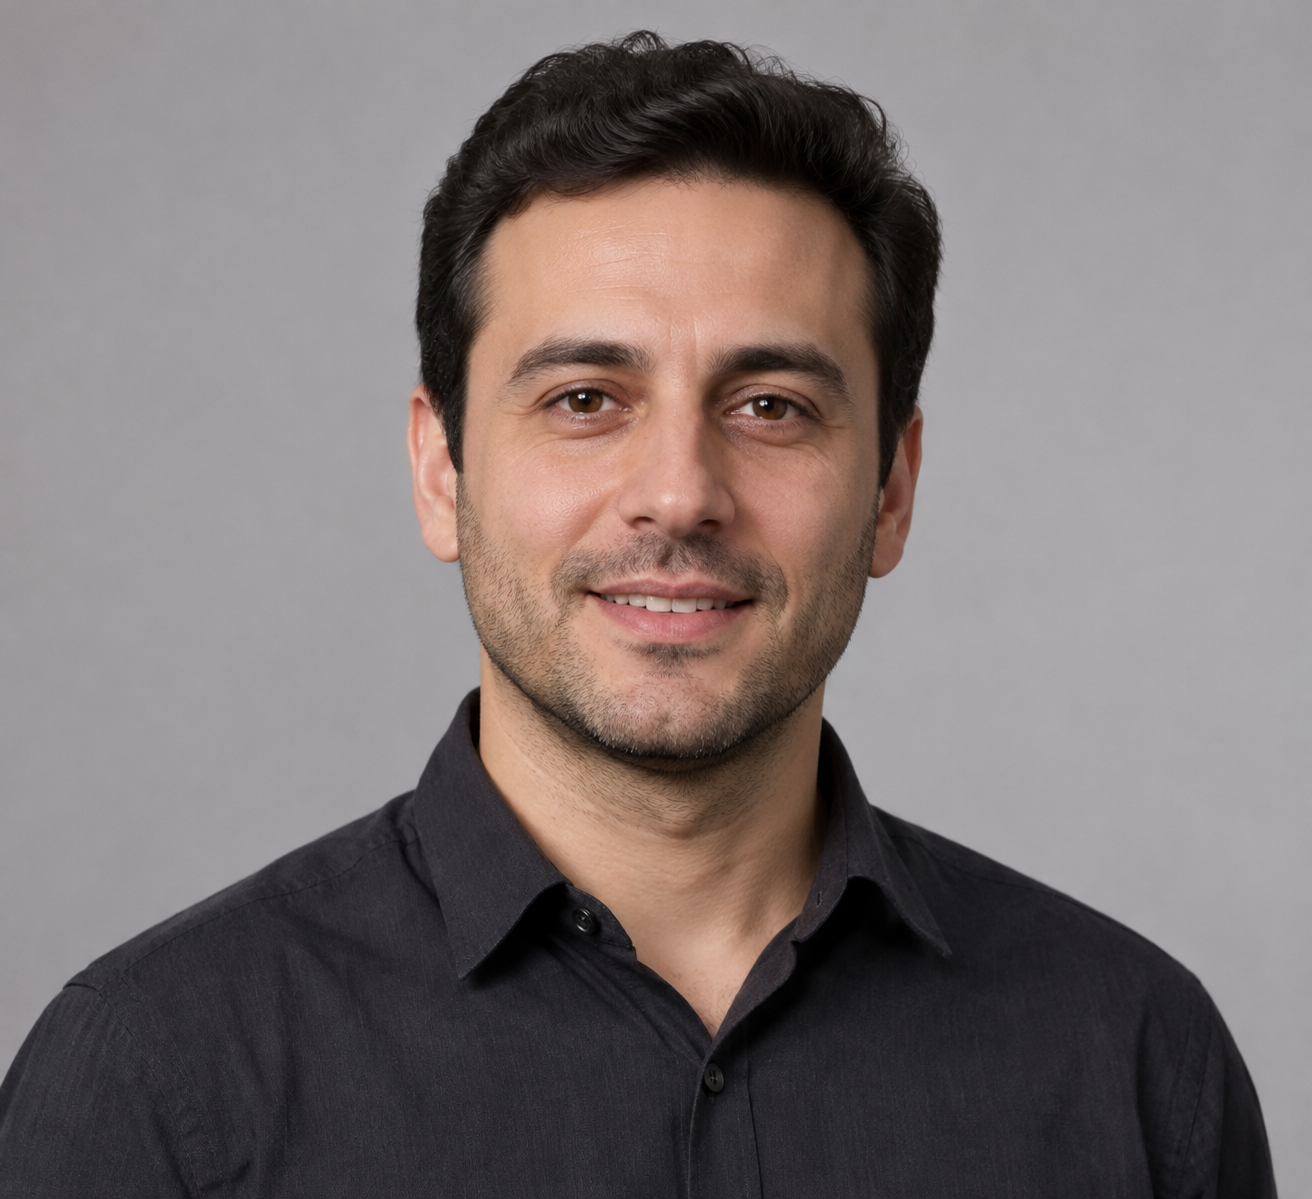
Immagine ritratto
Prompt
Un relatore dall'aspetto calmo, con una camicia scura, si trova davanti a uno sfondo da studio fotografico grigio chiaro e morbido e spiega alla telecamera, uno per uno, i termini dei movimenti di macchina. Le spalle e la testa si muovono leggermente seguendo il ritmo del discorso, l'espressione è concentrata e misurata, lo sguardo è stabile verso l'obiettivo. Una luce principale neutra e morbida arriva di lato dalla parte anteriore, integrata da una sottile luce di riempimento riflessa, che crea un'atmosfera da lezione tranquilla; la texture della pelle è realistica e, man mano che le frasi si concludono, la persona sbatte naturalmente le palpebre e annuisce leggermente.
Copia il prompt completo e adattalo alla tua generazione.
Tag
La testimonianza di una curatrice dopo la chiusura del museo
Stile Ritratto parlante · Museo · Cultura
Input di riferimento
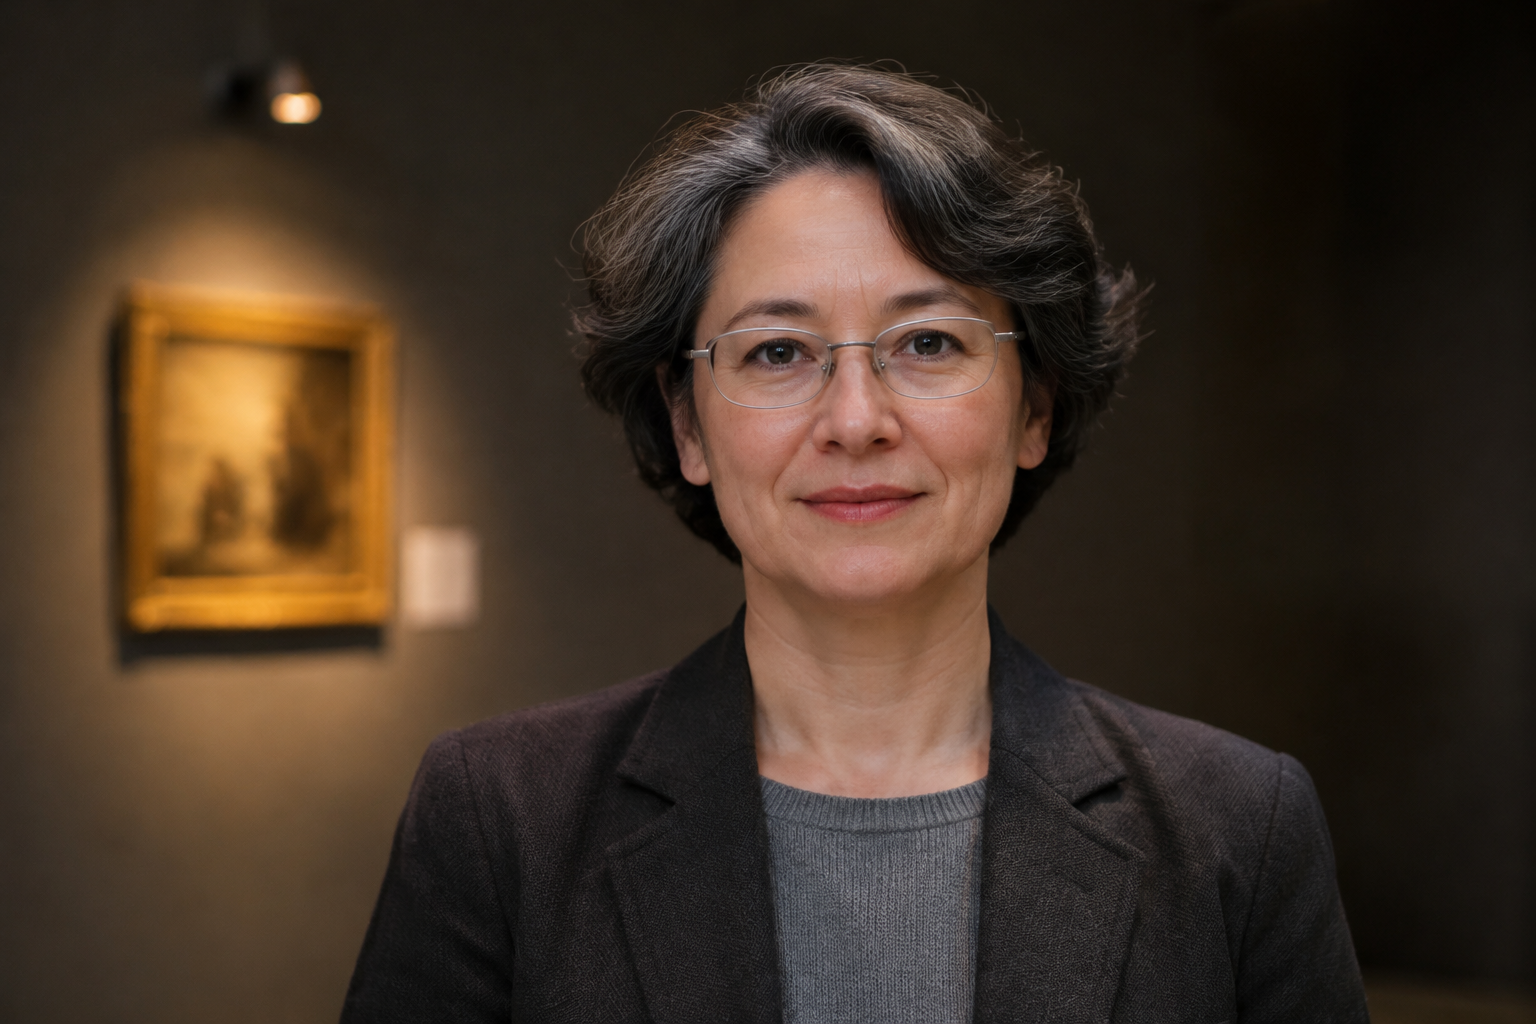
Immagine ritratto
Prompt
Una curatrice di mezza età seduta sul bordo di una panchina della galleria, dietro la spalla una parete espositiva illuminata con luce morbida, racconta con calma un'opera rivolta alla camera; annuisce leggermente, sbatte le palpebre in modo naturale, espressione composta e gentile; profondità di campo ridotta, calda luce al tungsteno della galleria con una morbida caduta, atmosfera silenziosa da museo, solo lievi movimenti del viso e delle spalle.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
p-video-2-pro-avatar per second
| Specifiche | Prezzo unitario |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Panoramica e posizionamento
Modello di generazione video per scenari di presentazione con avatar digitale: basta caricare un ritratto come primo fotogramma e fornire un audio vocale o un testo di script per generare un video in cui la persona parla. Lo script viene letto da una voce integrata, con possibilità di scegliere tra diverse voci e lingue, e con un prompt si descrivono i movimenti e l'espressione del personaggio mentre parla. È adatto a chi crea contenuti che richiedono la presenza in video di una persona reale, come lezioni, presentazioni marketing e video brevi per i social, eliminando le fasi di ripresa e di sincronizzazione labiale.
Punti salienti
- Un solo ritratto basta per generare un video parlato — è sufficiente un ritratto come primo fotogramma, senza bisogno di materiale video esistente, per generare un'immagine in cui la persona parla.
- Due modalità di guida: audio e script — è possibile caricare un audio vocale di massimo 3 minuti, oppure inserire uno script che viene letto dalla voce integrata; la durata del video segue quella dell'audio.
- Controllo di espressione e movimenti tramite prompt — con un prompt si descrivono aspetto, movimenti ed espressione del personaggio mentre parla, ed è possibile impostare un seed casuale per riprodurre il risultato.
- Più livelli di risoluzione per ogni esigenza di output — sono disponibili cinque risoluzioni: 480p, 768p, 1080p, 2k e 4k, per scegliere la qualità in base alla piattaforma di pubblicazione.
Descrizione delle capacità
Video parlato guidato da un ritratto: si fornisce tramite link HTTPS un ritratto in formato jpg, jpeg, png o webp come primo fotogramma per generare un video in cui la persona parla; il contenuto visivo, i movimenti e l'espressione sono descritti dal prompt.
Guida del labiale tramite audio caricato: si fornisce un link HTTPS a un audio vocale; la durata del video coincide con quella dell'audio, fino a un massimo di 3 minuti; con la specifica 4k l'audio può durare al massimo 125 secondi. In questo caso le impostazioni di script, voce, lingua e stile vocale non hanno effetto.
Guida tramite conversione dello script in voce: se non viene fornito un audio, si inserisce uno script di massimo 5000 caratteri che viene letto dalla voce integrata per generare il video; la lingua dello script deve essere scelta tra le dieci lingue disponibili, e si può usare una descrizione dello stile vocale di massimo 1000 caratteri per definire tono e ritmo.
Scelta di voce e parametri visivi: si può scegliere una delle 30 voci integrate per leggere lo script, usare un prompt di massimo 2000 caratteri per descrivere l'immagine e impostare un seed casuale tra 0 e 2147483647; la risoluzione va scelta tra 480p, 768p, 1080p, 2k e 4k, con valore predefinito 768p.
Casi d'uso
- Video parlati in serie per docenti di corsi — il docente fornisce ritratto e script di spiegazione per generare in serie video in cui appare in persona, da pubblicare in corsi online o rubriche di divulgazione.
- Presentazioni con volto reale per materiali marketing — gli operatori marketing usano il ritratto del testimonial del prodotto insieme a testi promozionali per generare clip parlate da pubblicare nei feed o sui canali social del brand.
- Video finali da registrazioni audio esistenti — i creator caricano la propria registrazione e il proprio ritratto per sincronizzare il labiale con l'audio e produrre direttamente video brevi per i social.
- Da ritratto statico a video parlato — con una foto esistente della persona e uno script o un audio si genera un'immagine parlante con espressioni e labiale, per rubriche di avatar digitale o pagine dimostrative.
Limiti e consigli per la scelta
Script e prompt hanno limiti di lunghezza: il prompt può avere al massimo 2000 caratteri, lo script al massimo 5000 caratteri e la descrizione dello stile vocale al massimo 1000 caratteri. La voce integrata non supporta il cinese; la lingua dello script deve essere scelta tra inglese, spagnolo, francese, tedesco, italiano, portoghese (Brasile), giapponese, coreano e hindi. La durata del video è determinata dall'audio, fino a un massimo di 3 minuti; con la specifica 4k l'audio può durare al massimo 125 secondi.
Novità
Vedi il changelog →- Nuovo modello P-Video 2 Pro Avatar disponibile: da un ritratto più un audio o un testo, genera un video parlato di massimo 3 minuti
Domande frequenti
Vedi tutte le domande →-
Con quale audio si pilota l'avatar digitale?
Usa audio_url per passare un link audio HTTPS; la durata del video corrisponde a quella dell'audio, con un massimo di 3 minuti (per il 4k massimo 125 secondi). Una volta fornito l'audio, script, voice, voice_language e voice_prompt non hanno effetto; se vengono passati entrambi, prevale l'audio.
-
Quanto può essere lungo il testo dello script che posso inserire?
Il campo script può contenere al massimo 5000 caratteri, ma la durata del video è determinata in ultima analisi dalla durata della voce del TTS integrato che legge lo script, con un limite massimo di 3 minuti; quando ci si avvicina al limite, si consiglia di abbreviare il testo o di generare a segmenti.
-
Come si scrive meglio il prompt per un video parlato in prima persona?
La descrizione del prompt indica l'aspetto, i movimenti e l'espressione della persona mentre parla, senza scrivere il dialogo. Si consiglia di seguire l'ordine «aspetto del personaggio → ampiezza dei movimenti → espressione e sguardo → sensazione della ripresa», ad esempio «un uomo in abito scuro, seduto in modo naturale, che annuisce occasionalmente, sorride guardando verso la camera, inquadratura fissa a mezzo busto», mantenendo il testo entro 2000 caratteri; il valore predefinito è solo «The person is talking.».
-
Quali lingue e voci sono supportate?
voice_language supporta 10 lingue: inglese americano, inglese britannico, spagnolo, francese, tedesco, italiano, portoghese brasiliano, giapponese, coreano e hindi; al momento il cinese non è incluso. voice dispone di 30 voci preimpostate, con il genere indicato nel nome; il valore predefinito è Zephyr (Female). Il testo di script deve essere nella stessa lingua selezionata.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: p-video-2-pro-avatar
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per p-video-2-pro-avatar e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionalemin 0max 2147483647Seme casuale, un numero intero compreso tra 0 e 2147483647; fornire lo stesso seme mantenendo invariati gli altri input aiuta a riprodurre il risultato, se non fornito è casuale.
voicestringOpzionalePredefinito: "Zephyr (Female)"La voce utilizzata per la sintesi vocale integrata, predefinita Zephyr (Female). Questo parametro viene ignorato quando viene fornito audio_url.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Mostra tutto (22)Mostra meno
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringOpzionalePredefinito: "The person is talking."maxLength 2000Descrizione del contenuto del video, che specifica l'aspetto, i movimenti e il comportamento della persona mentre parla; predefinito «The person is talking.».
scriptstringOpzionalemaxLength 5000Il testo esatto che l'avatar digitale leggerà, scritto nella voice_language selezionata (il cinese non è supportato). Obbligatorio quando audio_url non è fornito; la durata della lettura determina la lunghezza del video, massimo 3 minuti.
audio_urlstringOpzionalepattern ^https://URL HTTPS dell'audio vocale, massimo 3 minuti (massimo 125 secondi con risoluzione 4k); la lunghezza del video corrisponde a quella dell'audio. Una volta fornito, script, voice, voice_language e voice_prompt vengono tutti ignorati.
image_urlstringObbligatoriopattern ^https://URL HTTPS dell'immagine ritratto della persona che parla, utilizzata come primo fotogramma del video; supporta i formati jpg, jpeg, png, webp.
resolutionstringOpzionalePredefinito: "768p"Risoluzione di output, selezionabile tra 480p, 768p, 1080p, 2k, 4k, predefinita 768p; maggiore è la risoluzione, maggiore è il costo.
480p768p1080p2k4kvoice_promptstringOpzionalePredefinito: "Say the following."maxLength 1000Istruzione sullo stile vocale, utilizzata per descrivere il tono, il ritmo, l'accento o l'emozione e altri modi di esprimersi, non verrà letta; predefinito «Say the following.». Viene ignorato quando viene fornito audio_url.
voice_languagestringOpzionalePredefinito: "English (US)"La lingua utilizzata dal testo script, predefinita English (US). Viene ignorata quando viene fornito audio_url.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseMostra tutto (2)Mostra meno
KoreanHindicallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 FLUX 3 Max Black Forest Labs $0.121 /secondo
-
 Seedance 2.0 ByteDance $0.017 /secondo
-
 PixVerse V6 Max PixVerse $0.030 /secondo
-
 PixVerse V6 PixVerse $0.036 /secondo
-
 HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Seedance 2.5 ByteDance $0.121 /secondo
-
 Gemini Omni 1.2 Google $0.023 /secondo
-
 Ray 3.2 Luma $0.214 /video
-
 Vidu Q3 Vidu $0.149 /secondo
-
 Grok Imagine 1.5 Lite xAI $0.029 /secondo
-
 MiniMax H3 MiniMax $0.072 /secondo
-
 Wan 2.6 Flash Alibaba $0.043 /secondo