Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Pruna AI의 인물 사진 기반 말하는 영상 모델로, 단 한 장의 인물 사진으로 입모양 동기화와 표정 변화가 포함된 구술 클립을 생성할 수 있으며, 업로드한 오디오로 구동하거나 내장된 텍스트 음성 변환 기능으로 스크립트를 직접 낭독하게 할 수 있어 강의 설명, 다국어 더빙, 디지털 휴먼 숏폼 영상의 대량 제작에 적합합니다
p-video-2-pro-avatar 사용해 보기
입력
작품 갤러리
모든 작품 보기출력
video렌즈 언어 비주얼 노트·명령어 해설 디지털 휴먼 구술
스타일 구술 · 카메라 언어 · 스튜디오
참조 입력
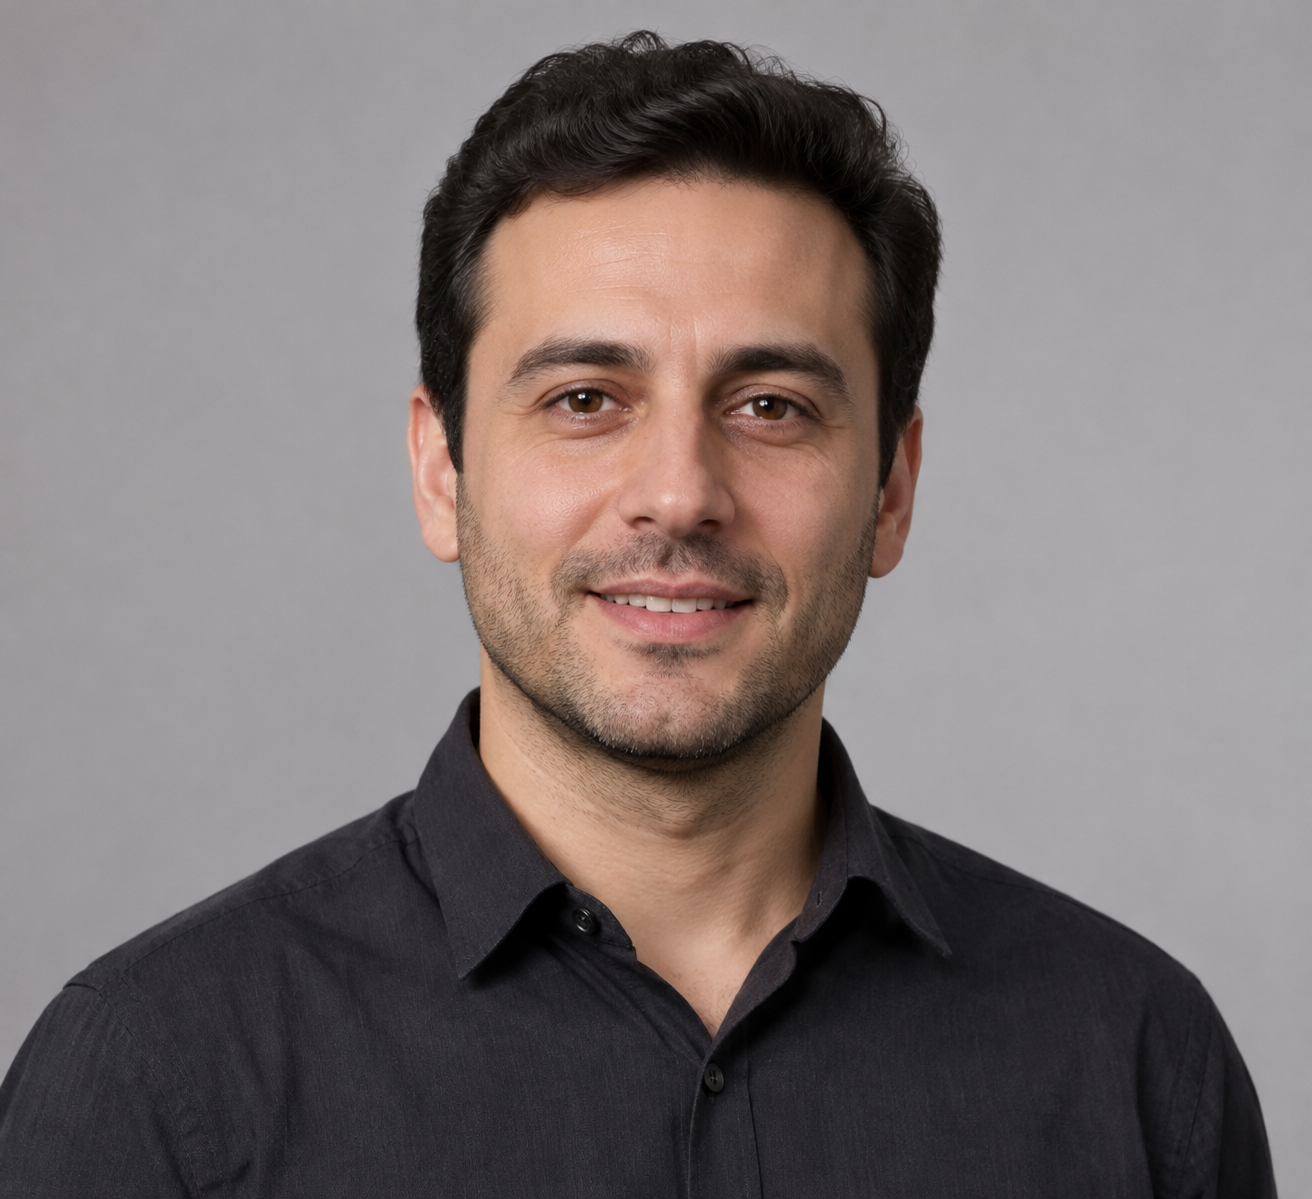
인물 사진
프롬프트
짙은 셔츠를 입고 침착한 태도를 지닌 강사가 부드러운 연회색 스튜디오 배경 앞에 서서 카메라를 향해 카메라 무빙 용어를 하나씩 설명한다. 어깨와 머리가 말하는 리듬에 따라 살짝 움직이고, 표정은 집중되고 절제되어 있으며, 시선은 안정적으로 카메라를 바라본다. 앞쪽 측면에서 중성적인 부드러운 주광이 비추고 미세한 반사 보조광이 더해져 조용한 수업 분위기를 만들며, 피부 질감이 사실적이고, 문장이 끝날 때 자연스럽게 눈을 깜빡이며 살짝 고개를 끄덕인다.
전체 프롬프트를 복사해 원하는 생성 작업에 맞게 활용하세요.
태그
미술관 폐관 후 큐레이터의 독백
스타일 말하는 인물 · 박물관 · 문화
참조 입력
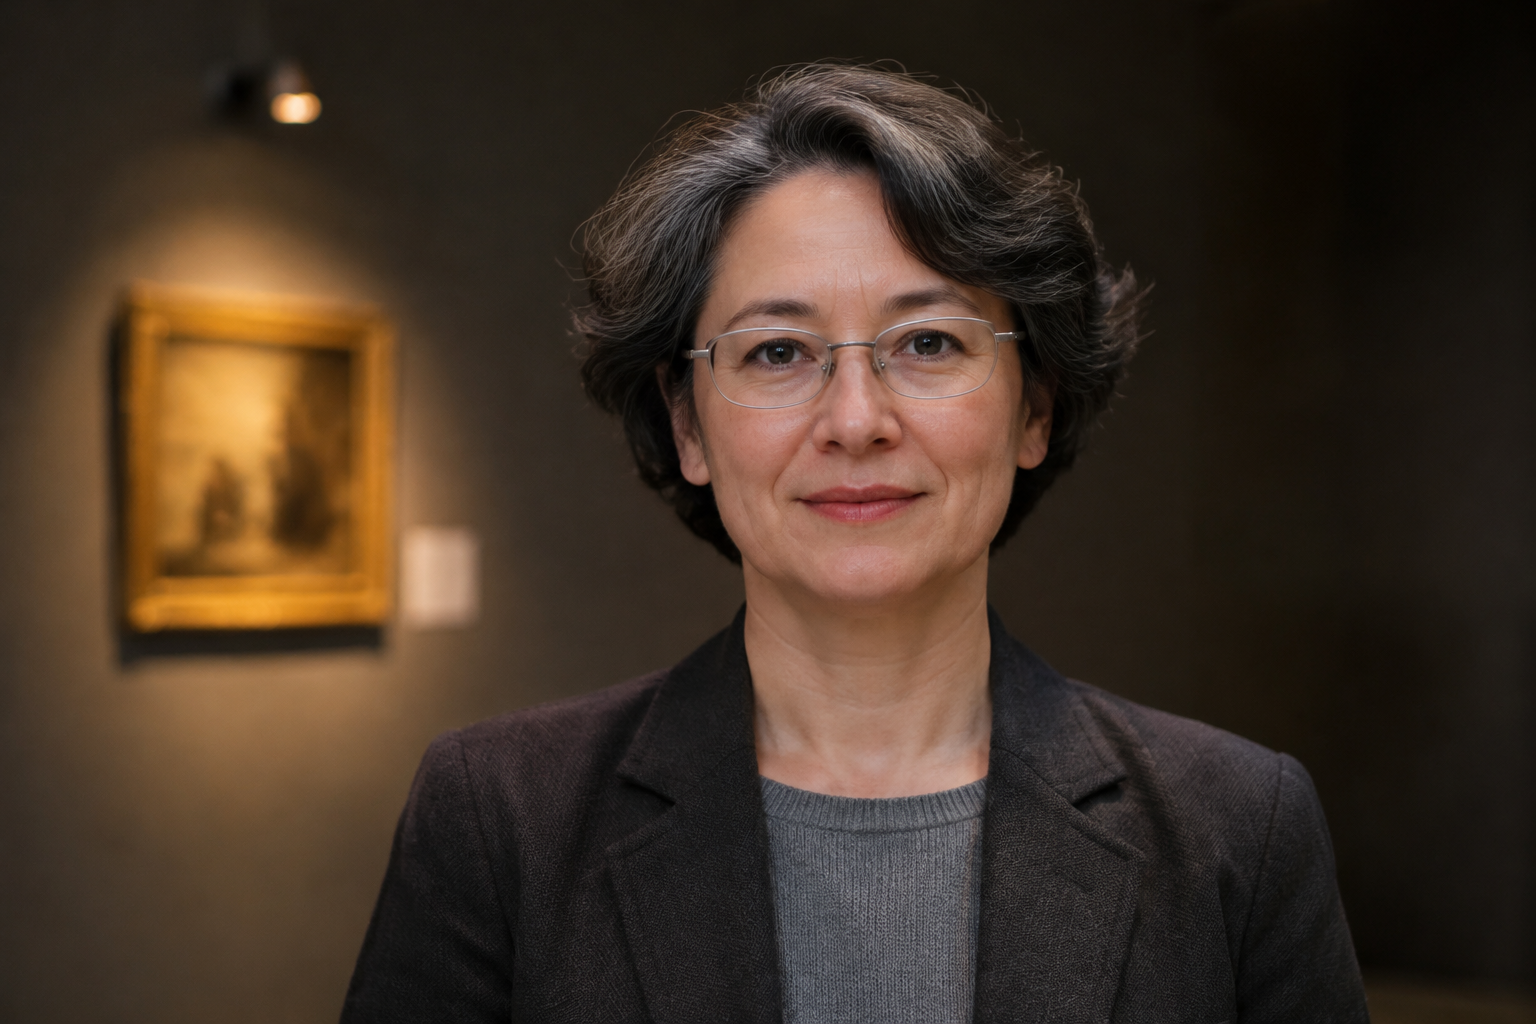
인물 사진
프롬프트
한 중년 여성 큐레이터가 갤러리 긴 의자 가장자리에 앉아 있고, 어깨 뒤쪽에는 부드러운 조명이 비치는 전시 벽이 있으며, 그녀는 침착하게 카메라를 향해 한 점의 전시품에 대해 이야기한다. 그녀는 가볍게 고개를 끄덕이고 자연스럽게 눈을 깜빡이며, 태도는 차분하고 온화하다. 얕은 심도, 따뜻한 텅스텐 갤러리 조명이 부드럽게 감쇠하며, 고요한 박물관 분위기 속에서 얼굴과 어깨에만 미세한 움직임이 있다.
전체 프롬프트를 복사해 원하는 생성 작업에 맞게 활용하세요.
태그
가격
p-video-2-pro-avatar per second
| 사양 | 단가 |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
포지셔닝 소개
디지털 휴먼 구두 발표 시나리오를 위한 비디오 생성 모델입니다. 인물 초상 사진 한 장을 첫 프레임으로 업로드한 뒤 음성 오디오를 제공하거나 스크립트 텍스트를 입력하면 인물이 말하는 비디오를 생성할 수 있습니다. 스크립트는 내장 음성으로 낭독되며 다양한 음색과 언어를 선택할 수 있고, 프롬프트로 인물이 말할 때의 동작과 표정을 묘사할 수 있습니다. 강의 해설, 마케팅 구두 발표, 소셜 숏폼 비디오 등 실제 인물이 출연하는 콘텐츠 제작자에게 적합하며 촬영과 립싱크 과정을 생략할 수 있습니다.
핵심 하이라이트
- 초상 사진 한 장으로 말하는 비디오 구동——인물 초상 사진 한 장만 첫 프레임으로 있으면 기존 비디오 소재 없이도 인물이 말하는 화면을 생성할 수 있습니다.
- 오디오와 스크립트 두 가지 구동 방식——3분 이내의 음성 오디오를 업로드하거나 스크립트를 입력해 내장 음성으로 낭독하게 할 수 있으며, 비디오 길이는 음성을 따릅니다.
- 프롬프트로 표정과 동작 제어——프롬프트로 인물이 말할 때의 외형, 동작, 표정을 묘사할 수 있고 랜덤 시드를 설정해 결과를 재현할 수 있습니다.
- 다양한 해상도로 완성본 요구 충족——480p, 768p, 1080p, 2k, 4k 다섯 가지 해상도를 선택할 수 있어 게시 플랫폼에 맞춰 화질을 고를 수 있습니다.
기능 설명
초상 사진 기반 말하는 비디오: HTTPS 링크로 jpg, jpeg, png 또는 webp 형식의 인물 초상 사진을 첫 프레임으로 제공하면 인물이 말하는 비디오를 생성하며, 화면 내용은 프롬프트로 외형, 동작, 표정을 묘사합니다.
음성 업로드로 입모양 구동: HTTPS 음성 오디오 링크를 제공하면 비디오 길이는 오디오와 일치하며 최대 3분입니다. 4k 사양 사용 시 오디오는 최대 125초입니다. 이때 스크립트, 음색, 언어, 음성 스타일 설정은 적용되지 않습니다.
스크립트를 음성으로 변환해 구동: 오디오를 제공하지 않으면 최대 5000자 스크립트를 입력해 내장 음성으로 낭독하고 비디오를 생성합니다. 스크립트 언어는 주어진 열 가지 언어 중에서 선택해야 하며, 최대 1000자 음성 스타일로 어조와 리듬을 설명할 수 있습니다.
음색과 화면 파라미터 선택: 30가지 내장 음색 중 하나를 선택해 스크립트를 낭독하게 하고, 최대 2000자 프롬프트로 화면을 묘사하며, 0에서 2147483647 사이의 랜덤 시드를 설정할 수 있습니다. 해상도는 480p, 768p, 1080p, 2k, 4k 중에서 선택하며 기본값은 768p입니다.
적용 시나리오
- 강의 강사 대량 구두 발표 비디오——강사가 초상 사진과 해설 스크립트를 제공하면 인물이 출연하는 해설 비디오를 대량 생성해 온라인 강의나 지식 콘텐츠 게시에 활용합니다.
- 마케팅 소재 실제 인물 구두 발표——운영 담당자가 제품 모델의 초상 사진과 홍보 문안을 조합해 구두 발표 클립을 생성하고 피드 광고나 브랜드 소셜 계정에 게시합니다.
- 기존 녹음으로 더빙 완성본 제작——크리에이터가 본인 녹음과 초상 사진을 업로드해 화면 입모양을 녹음에 맞추고 소셜 플랫폼 숏폼 비디오를 바로 제작합니다.
- 정지 초상 사진을 말하는 비디오로 변환——보유한 인물 사진에 스크립트나 오디오를 조합해 표정과 입모양이 있는 말하는 화면을 생성해 디지털 휴먼 콘텐츠나 전시 페이지에 활용합니다.
제한 및 선택 가이드
스크립트와 프롬프트에는 길이 상한이 있습니다. 프롬프트는 최대 2000자, 스크립트는 최대 5000자, 음성 스타일 설명은 최대 1000자입니다. 내장 음성은 중국어를 지원하지 않으며, 스크립트 언어는 영어, 스페인어, 프랑스어, 독일어, 이탈리아어, 포르투갈어(브라질), 일본어, 한국어, 힌디어 중에서 선택해야 합니다. 비디오 길이는 음성에 의해 결정되며 최대 3분이고, 4k 사양 사용 시 오디오는 최대 125초입니다.
새소식
변경 이력 보기 →- 새 모델 P-Video 2 Pro Avatar 출시: 인물 사진 한 장과 오디오 또는 텍스트 스크립트로 최대 3분 분량의 토킹헤드 영상 생성
자주 묻는 질문
모든 질문 보기 →-
어떤 오디오로 디지털 휴먼을 구동하나요?
audio_url에 HTTPS 오디오 링크를 전달하면 영상 길이는 오디오 길이와 같아지며, 최대 3분입니다(4k는 최대 125초). 오디오를 전달하면 script, voice, voice_language, voice_prompt는 모두 적용되지 않으며, 둘 다 전달할 경우 오디오가 우선합니다.
-
스크립트 텍스트는 얼마나 길게 입력할 수 있나요?
script 필드는 최대 5000자까지 입력할 수 있지만, 영상 길이는 결국 내장 TTS가 해당 스크립트를 읽는 음성 길이에 따라 결정되며 상한은 3분입니다. 상한에 가까워질 때는 먼저 텍스트를 간결하게 하거나 분할 생성하는 것을 권장합니다.
-
토킹 헤드 영상의 prompt는 어떻게 작성하면 더 좋을까요?
prompt는 인물이 말할 때의 외모, 동작, 표정을 묘사하며 대사는 쓰지 않습니다. '인물 외모→동작 범위→표정과 시선→카메라 느낌' 순서로 작성하는 것을 권장합니다. 예: '짙은 색 정장을 입은 남성이 자연스럽게 앉아 있고, 때때로 고개를 끄덕이며 미소 지으며 카메라를 바라보고, 고정된 중간 샷'. 2000자 이내로 유지하며, 기본값은 'The person is talking.'입니다.
-
어떤 언어와 음성을 지원하나요?
voice_language는 10개 언어를 지원합니다: 미국 영어, 영국 영어, 스페인어, 프랑스어, 독일어, 이탈리아어, 브라질 포르투갈어, 일본어, 한국어, 힌디어이며 현재 중국어는 포함되지 않습니다. voice에는 30개의 프리셋 음성이 있고 이름에 성별이 표시되어 있으며 기본값은 Zephyr (Female)입니다. script의 텍스트는 선택한 언어와 일치해야 합니다.
생성 작업 제출
https://api.hiapi.ai/v1/tasks 헤더
Authorizationstring필수계정 API 키. 모든 요청에 필수입니다. 예: Bearer YOUR_HIAPI_API_KEY. API 키 받기
Content-Typestring선택요청 본문은 항상 JSON으로 파싱됩니다. 전송 시 application/json(charset 포함 가능)만 허용되며, 다른 값은 415를 반환합니다. 예: application/json.
Idempotency-Keystring선택멱등 키. 최대 255바이트. 같은 계정에서 같은 키의 재시도는 태스크를 한 번만 생성하며, 재전송 시 최초의 taskId를 반환합니다.
네트워크 타임아웃이나 클라이언트 자동 재시도 시 같은 키로는 태스크를 한 번만 생성하고 이중 과금되지 않습니다(범위 = API 키의 계정). 업무 고유 식별자(예: "order-42")를 키로 사용할 것을 권장합니다. 같은 키 재전송 시 최초 taskId를 반환하며, 키는 첫 제출 후 24시간 뒤 만료됩니다. 자세한 시나리오 표는 통합 비동기 API 소개 페이지를 참고하세요.
본문
modelstring필수현재 고정 값: p-video-2-pro-avatar
routestring선택현재 고정 값: default
inputobject필수
p-video-2-pro-avatar 및 루트 default의 비즈니스 파라미터 객체. 아래 파라미터 표를 참조하세요.
seedinteger선택min 0max 2147483647랜덤 시드, 0–2147483647 사이의 정수를 사용합니다. 동일한 시드를 전달하고 다른 입력을 그대로 유지하면 결과 재현에 도움이 되며, 전달하지 않으면 무작위로 설정됩니다.
voicestring선택기본값: "Zephyr (Female)"내장 텍스트 음성 변환에 사용되는 음색이며, 기본값은 Zephyr (Female)입니다. audio_url을 제공하면 이 매개변수는 무시됩니다.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)전체 보기(22개)접기
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstring선택기본값: "The person is talking."maxLength 2000영상 내용 설명으로, 인물이 말할 때의 외모, 동작 및 행동 표현을 설명합니다. 기본값은 「The person is talking.」입니다.
scriptstring선택maxLength 5000디지털 휴먼이 낭독할 정확한 대본으로, 선택한 voice_language로 작성해야 합니다(중국어는 지원되지 않습니다). audio_url을 제공하지 않을 때 필수이며, 낭독 길이가 영상 길이를 결정하고 최대 3분까지 가능합니다.
audio_urlstring선택pattern ^https://음성 오디오의 HTTPS URL로, 최대 3분(4k 해상도에서는 최대 125초)까지 가능하며, 영상 길이는 오디오와 일치합니다. 제공하면 script, voice, voice_language, voice_prompt는 모두 무시됩니다.
image_urlstring필수pattern ^https://말하는 인물 초상화 이미지의 HTTPS URL로, 영상 첫 프레임으로 사용됩니다. jpg, jpeg, png, webp 형식을 지원합니다.
resolutionstring선택기본값: "768p"출력 해상도로, 480p, 768p, 1080p, 2k, 4k 중 선택할 수 있으며 기본값은 768p입니다. 해상도가 높을수록 비용이 더 많이 듭니다.
480p768p1080p2k4kvoice_promptstring선택기본값: "Say the following."maxLength 1000음성 스타일 지시문으로, 어조, 리듬, 억양 또는 감정 등의 표현 방식을 설명하는 데 사용되며 낭독되지 않습니다. 기본값은 「Say the following.」입니다. audio_url을 제공하면 무시됩니다.
voice_languagestring선택기본값: "English (US)"script 대본에 사용되는 언어이며, 기본값은 English (US)입니다. audio_url을 제공하면 무시됩니다.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)Japanese전체 보기(2개)접기
KoreanHindicallbackobject선택
종료 상태 알림 설정. 생략하면 콜백이 전송되지 않으며 호출 측에서 폴링합니다.
생성 시 callback.url을 지정하면 태스크 종료 시 HiAPI가 서비스로 POST하여 폴링이 필요 없습니다. 콜백 본문은 태스크 상세와 동일한 구조입니다. 서명 검증·재시도·멱등에 대한 자세한 내용은 통합 비동기 API 소개 페이지의 콜백 설명을 참고하세요.
urlstring필수callback 사용 시 필수. 태스크 종료 후 이 URL로 POST됩니다. 유효한 http(s) URL이어야 합니다.
whenstring선택기본값: "final"현재는 final만 지원(success / fail 모두 알림).
finalstoragestring선택기본값: "temp"산출물 저장 등급: temp(기본·약 7일) 또는 persistent(장기 보관·용량 과금). 잔액 부족이나 저장 한도 초과 시 자동으로 temp로 강등됩니다. 실제 적용된 등급은 태스크 상세 응답에서 확인할 수 있습니다.
temppersistent요청 예시
# 비동기 태스크 제출. 성공 시 즉시 taskId 반환(생성 완료 대기 없음)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
작업 상세 조회
https://api.hiapi.ai/v1/tasks/:id 응답 필드
taskIdstring필수태스크 ID. 접두사는 항상 tk-hiapi-.
modelstring필수확인된 전체 모델명. route 파라미터로 제출한 태스크는 base@route(예: gpt-image-2/text-to-image@ext)를 반환하며, 그 외에는 제출 시의 모델명과 동일합니다.
routestring선택route 파라미터를 명시해 제출한 태스크에만 나타나며, 제출한 값을 그대로 반환합니다.
statusstring필수태스크 상태.
queued 대기 중, 아직 시작되지 않음.
handling 처리 중.
archiving 처리 완료, 산출물 준비 중.
success 종료: 완료. 산출물 사용 가능(output 반환).
fail 종료: 실패(error 반환).
제출 후 status로 판단합니다: success와 fail이 종료 상태이며 나머지는 비종료입니다. 1~3초 간격으로 종료까지 폴링하세요. 성공 시 output[].url에서 산출물을 다운로드하고 expireAt 전에 옮기세요. 장기 보관이 필요하면 생성 시 storage: "persistent"를 사용하세요.
creatednumber필수태스크 생성 시각(Unix 초).
completednumber필수종료 상태가 된 Unix 초. 비종료 상태에서는 0.
outputarray선택
status == success일 때만 나타납니다. 산출물 목록 — 항상 배열이며, 하나의 태스크에서 여러 type을 동시에 반환할 수 있습니다(예: video + first_frame).
Array [ object ]
배열 항목
urlstring필수산출물 URL. 바로 다운로드할 수 있습니다.
typestring필수현재 가능한 값: video, image, audio, first_frame, last_frame, thumbnail. 이후 확장될 수 있습니다.
expireAtnumber필수산출물 접근 가능 기한(Unix 초). 만료 전에 다운로드하거나 이전하세요.
errorobject선택
status == fail일 때만 나타납니다.
codestring필수비즈니스 오류 코드.
messagestring필수오류 설명.
응답 예시
성공
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
처리 중(비종료)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
실패
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}아티클
모든 아티클 보기 →
관련 모델
모든 모델 보기 →동일 유형
-
 MiniMax H3 MiniMax $0.072 /초
-
 Runway Gen 4.5 Runway $0.172 /초
-
 Veo 3.1 Lite Google $0.060 /초
-
 Gemini Omni 1.1 Google $0.450 /동영상
-
 Seedance 2.5 ByteDance $0.121 /초
-
 FLUX 3 Max Black Forest Labs $0.121 /초
-
 Ray 3.2 Luma $0.214 /동영상
-
 HeyGen Avatar V HeyGen $0.150 /초
-
 LTX 2.5 Fast Lightricks $0.086 /초
-
 Gemini Omni 1.2 Google $0.023 /초
-
 Seedance 2.0 ByteDance $0.017 /초
-
 FLUX 3 Video Black Forest Labs $0.090 /초