Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Modelo de video hablado con avatar de Pruna AI: a partir de un solo retrato genera clips de narración con sincronización labial y cambios de expresión, puede impulsarse con audio subido o leer el guion directamente con la conversión de texto a voz integrada; ideal para explicaciones de cursos, doblaje multilingüe y producción masiva de videos cortos con avatares digitales
Probar p-video-2-pro-avatar
Entrada
Creaciones
Ver todas las creacionesSalida
videoNotas visuales del lenguaje cinematográfico: presentación de un avatar digital que explica los términos de los movimientos de cámara
Estilo Locución · lenguaje-de-cámara · estudio
Entradas de referencia
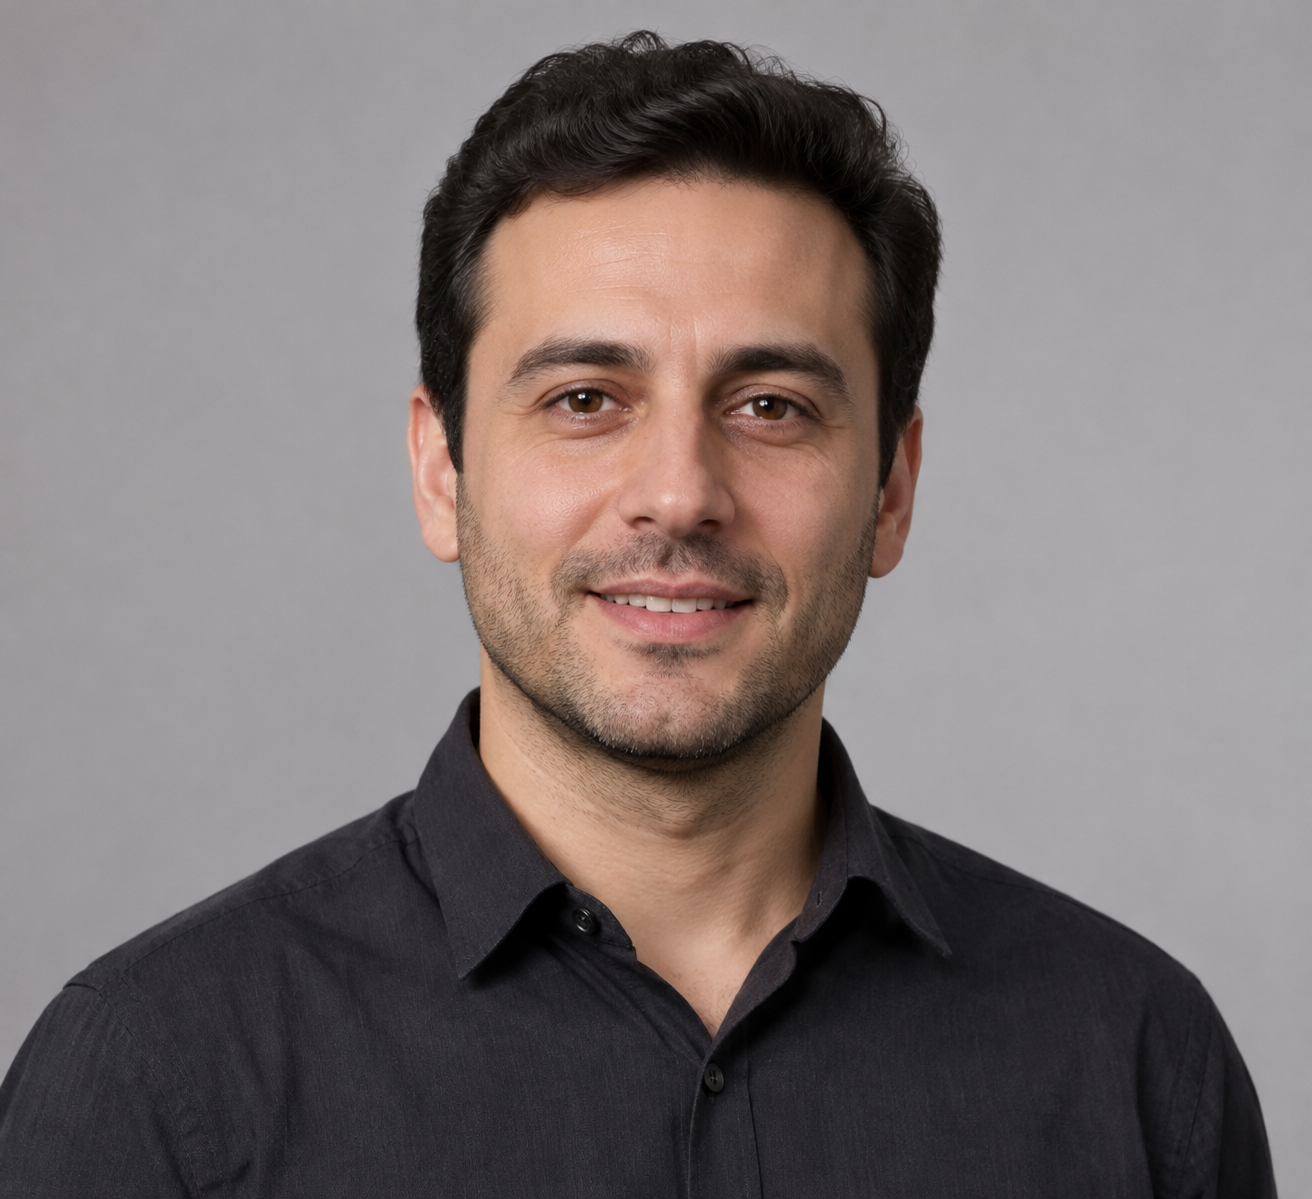
Imagen de retrato
Prompt
Un instructor de aspecto sereno, vestido con una camisa oscura, está de pie frente a un fondo de estudio fotográfico de color gris claro y suave, y explica uno a uno los términos de los movimientos de cámara mirando a la cámara. Los hombros y la cabeza se mueven ligeramente al ritmo del habla, la expresión es concentrada y contenida, y la mirada se dirige de forma estable hacia la cámara. Desde el frente y un lado llega una luz principal neutra y suave, complementada con un sutil relleno de luz reflejada, creando una atmósfera tranquila de clase; la textura de la piel es realista, y parpadea con naturalidad y asiente levemente al terminar las frases.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Autorretrato de la curadora tras el cierre del museo
Estilo Retrato que habla · Museo · Cultura
Entradas de referencia
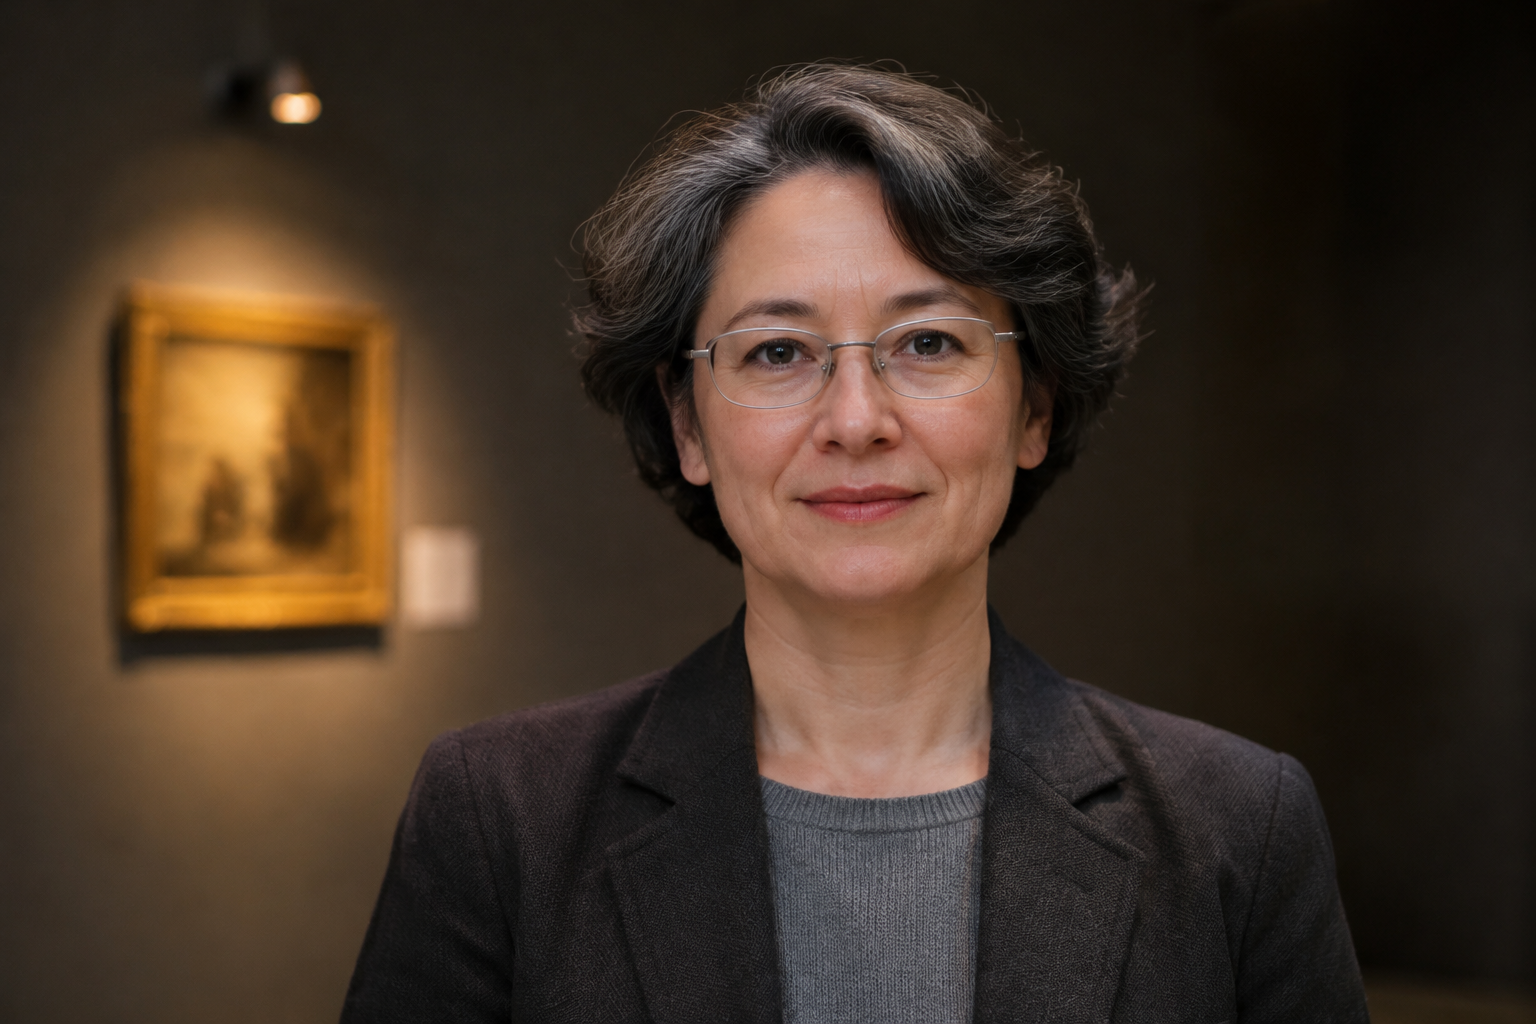
Imagen de retrato
Prompt
Una curadora de mediana edad sentada en el borde de un banco de la galería, con una pared de exposición suavemente iluminada detrás de su hombro, habla con calma a la cámara sobre una pieza; asiente levemente, parpadea de forma natural, con una expresión serena y amable; profundidad de campo reducida, cálida iluminación de tungsteno de galería con una suave atenuación, ambiente silencioso de museo, solo movimientos sutiles en el rostro y los hombros.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
p-video-2-pro-avatar per second
| Especificaciones | Precio unitario |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Descripción general
Modelo de generación de video orientado a escenarios de locución con avatares digitales: basta con subir un retrato de una persona como primer fotograma y, a continuación, proporcionar un audio de voz o introducir un texto de guion para generar un video en el que la persona habla. El guion se lee mediante la síntesis de voz integrada, con la posibilidad de elegir entre varias voces e idiomas, y se emplea un prompt para describir los movimientos y la expresividad de la persona mientras habla. Resulta adecuado para creadores de contenido que necesitan mostrar una imagen real en cámara, como explicaciones de cursos, locuciones de marketing o videos cortos para redes sociales, y elimina las fases de rodaje y sincronización labial.
Aspectos destacados
- Un único retrato basta para impulsar un video con habla: solo se necesita un retrato de una persona como primer fotograma, sin material de video previo, para generar una imagen en la que la persona habla.
- Dos modos de impulso: audio y guion: se puede subir un audio de voz de hasta 3 minutos o introducir un guion que la síntesis de voz integrada leerá, y la duración del video se ajusta a la del audio.
- Control de la expresividad y los movimientos mediante prompts: el prompt describe la apariencia, los movimientos y la expresión de la persona al hablar, y se puede fijar una semilla aleatoria para reproducir resultados.
- Varias resoluciones que cubren las necesidades del producto final: se puede elegir entre cinco resoluciones (480p, 768p, 1080p, 2k y 4k) para adaptar la calidad de imagen a la plataforma de publicación.
Descripción de capacidades
Video con habla impulsado por un retrato: se proporciona mediante un enlace HTTPS un retrato de una persona en formato jpg, jpeg, png o webp como primer fotograma para generar un video en el que la persona habla, y el prompt describe su apariencia, sus movimientos y su expresión.
Sincronización labial impulsada por audio subido: se proporciona un enlace HTTPS a un audio de voz; la duración del video coincide con la del audio, hasta un máximo de 3 minutos; con la especificación 4k, el audio puede durar como máximo 125 segundos. En este caso, los ajustes de guion, voz, idioma y estilo de voz dejan de tener efecto.
Impulso mediante conversión de guion a voz: si no se proporciona audio, se introduce un guion de hasta 5000 caracteres que la síntesis de voz integrada lee para generar el video; el idioma del guion debe elegirse entre los diez idiomas disponibles, y se puede usar una descripción de estilo de voz de hasta 1000 caracteres para indicar el tono y el ritmo.
Selección de voz y parámetros de imagen: se puede elegir una de las 30 voces integradas para leer el guion, usar un prompt de hasta 2000 caracteres para describir la imagen y fijar una semilla aleatoria entre 0 y 2147483647; la resolución se elige entre 480p, 768p, 1080p, 2k y 4k, con 768p como valor predeterminado.
Escenarios de aplicación
- Videos de locución masivos para instructores de cursos: el instructor proporciona su retrato y el guion de la explicación para generar por lotes videos explicativos con la persona en cámara, destinados a cursos en línea o secciones de conocimiento.
- Locuciones con imagen real para materiales de marketing: el personal de operaciones usa el retrato del embajador del producto junto con el texto promocional para generar fragmentos de locución y publicarlos en feeds o en las cuentas sociales de la marca.
- Grabaciones de audio ya existentes convertidas en producto final: el creador sube su propia grabación de voz y su retrato para que la sincronización labial de la imagen se ajuste a la grabación y obtener directamente un video corto para redes sociales.
- Retratos estáticos convertidos en videos con habla: se usa una foto existente de la persona junto con un guion o un audio para generar una imagen en la que habla, con expresión y sincronización labial, destinada a secciones de avatares digitales o páginas de presentación.
Limitaciones y recomendaciones de selección
El guion y el prompt tienen límites de longitud: el prompt admite como máximo 2000 caracteres, el guion 5000 caracteres y la descripción del estilo de voz 1000 caracteres. La voz integrada no admite chino, por lo que el idioma del guion debe elegirse entre inglés, español, francés, alemán, italiano, portugués (Brasil), japonés, coreano e hindi. La duración del video la determina el audio, con un máximo de 3 minutos; con la especificación 4k, el audio puede durar como máximo 125 segundos.
Novedades
Ver el registro de cambios →- Nuevo modelo P-Video 2 Pro Avatar ya está disponible: un retrato más un audio o un guion para generar vídeos de locución de hasta 3 minutos
Preguntas frecuentes
Ver todas las preguntas →-
¿Con qué audio se impulsa el avatar digital?
Usa audio_url para pasar un enlace de audio HTTPS; la duración del video será igual a la del audio, con un máximo de 3 minutos (4k, máximo 125 segundos). Una vez que se pasa el audio, script, voice, voice_language y voice_prompt dejan de tener efecto; si se pasan ambos, prevalece el audio.
-
¿Qué longitud de texto de script se puede introducir?
El campo script admite hasta 5000 caracteres, pero la duración final del video está determinada por la duración de la voz que el TTS integrado genera al leer dicho script, con un límite máximo de 3 minutos; cuando se acerque al límite, se recomienda primero simplificar el texto o generar por segmentos.
-
¿Cómo escribir mejor el prompt de un vídeo de locución a cámara?
El prompt describe la apariencia, los movimientos y la expresión de la persona mientras habla, sin escribir el diálogo. Se recomienda seguir el orden «apariencia de la persona → amplitud del movimiento → expresión y mirada → sensación de cámara», por ejemplo «un hombre con traje oscuro, sentado de forma natural, asiente de vez en cuando, sonríe mirando a cámara, plano medio fijo», y mantenerlo dentro de los 2000 caracteres; el valor predeterminado es solo «The person is talking.».
-
¿Qué idiomas y voces se admiten?
voice_language tiene 10 idiomas: inglés estadounidense, inglés británico, español, francés, alemán, italiano, portugués brasileño, japonés, coreano e hindi; por ahora no incluye chino. voice cuenta con 30 voces predefinidas, cuyos nombres indican el género; la predeterminada es Zephyr (Female). El texto de script debe coincidir con el idioma seleccionado.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: p-video-2-pro-avatar
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para p-video-2-pro-avatar y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria, un número entero entre 0 y 2147483647; pasar la misma semilla y mantener las demás entradas sin cambios ayuda a reproducir el resultado; si no se pasa, es aleatoria.
voicestringOpcionalPredeterminado: "Zephyr (Female)"Timbre de voz integrado usado para la conversión de texto a voz; por defecto Zephyr (Female). Este parámetro se ignora cuando se proporciona audio_url.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Mostrar todo (22)Mostrar menos
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringOpcionalPredeterminado: "The person is talking."maxLength 2000Descripción del contenido del video, que indica la apariencia, las acciones y el comportamiento de la persona mientras habla; por defecto «The person is talking.».
scriptstringOpcionalmaxLength 5000El guion exacto que el humano digital va a leer, escrito en el voice_language seleccionado (no se admite chino). Obligatorio cuando no se proporciona audio_url; la duración de la lectura determina la duración del video, con un máximo de 3 minutos.
audio_urlstringOpcionalpattern ^https://URL HTTPS del audio de voz, con una duración máxima de 3 minutos (máximo 125 segundos en resolución 4k); la duración del video coincide con la del audio. Una vez proporcionado, se ignoran script, voice, voice_language y voice_prompt.
image_urlstringObligatoriopattern ^https://URL HTTPS de la imagen de retrato de la persona que habla, que se usa como primer fotograma del video; admite formatos jpg, jpeg, png y webp.
resolutionstringOpcionalPredeterminado: "768p"Resolución de salida, con opciones 480p, 768p, 1080p, 2k y 4k; por defecto 768p. Cuanto mayor sea la resolución, mayor será el coste.
480p768p1080p2k4kvoice_promptstringOpcionalPredeterminado: "Say the following."maxLength 1000Instrucción de estilo de voz para describir el tono, el ritmo, el acento o la emoción, entre otros modos de expresión; no se lee en voz alta. Por defecto «Say the following.». Se ignora cuando se proporciona audio_url.
voice_languagestringOpcionalPredeterminado: "English (US)"Idioma en el que está escrito el guion de script; por defecto English (US). Se ignora cuando se proporciona audio_url.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseMostrar todo (2)Mostrar menos
KoreanHindicallbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Grok Imagine 1.5 xAI $0.011 /segundo
-
 Muse Video 1.0 Meta $0.034 /vídeo
-
 Kandinsky 6.0 Pro $1.93 /vídeo
-
 Seedance 2.5 ByteDance $0.121 /segundo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 Kling 2.5 Kuaishou $0.090 /segundo
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 FLUX 3 Video Black Forest Labs $0.090 /segundo
-
 Gemini Omni 1.1 Google $0.450 /vídeo
-
 Grok Imagine 1.5 Lite xAI $0.029 /segundo
-
 Vidu Q4 Preview Vidu $0.051 /segundo
-
 Hailuo 2.3 MiniMax $0.270 /vídeo