
Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Pruna AI 的肖像驱动说话视频模型,基于单张人像即可生成带唇形同步与表情变化的口播片段,可由上传音频驱动,也可用内置文本转语音直接朗读脚本,适合课程讲解、多语言配音与数字人短视频的批量制作
试用 p-video-2-pro-avatar
输入
作品灵感
查看全部作品输出
video镜头语言视觉笔记·口令讲解的数字人口播
风格 口播 · camera-language · studio
参考输入
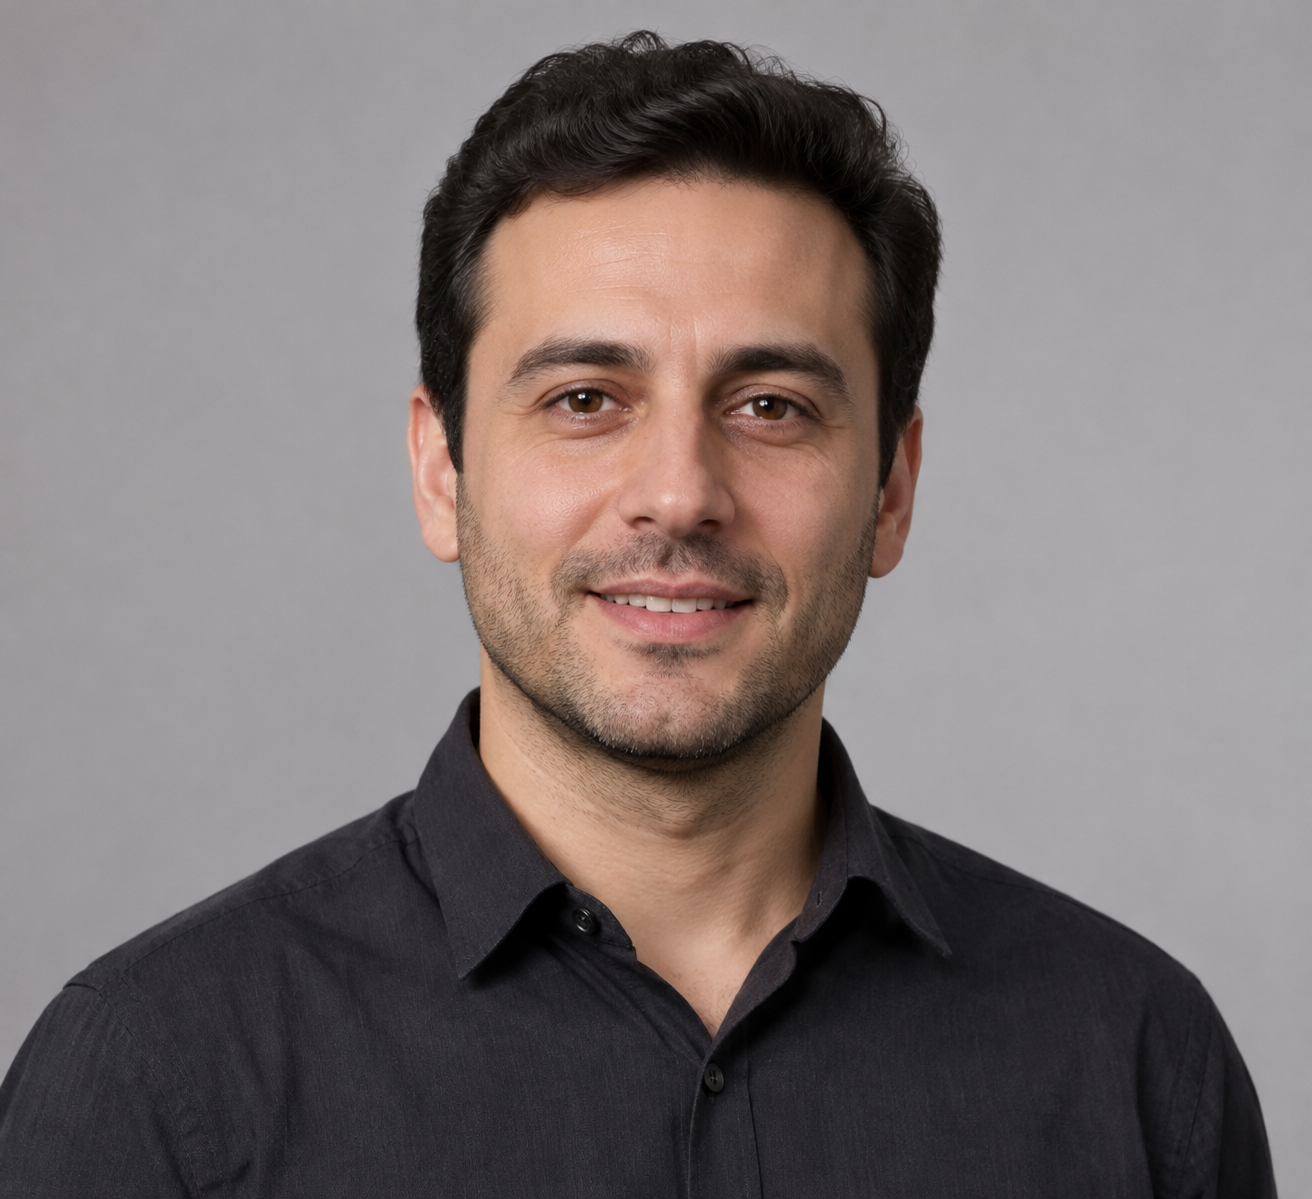
人像图片
提示词
一位身穿深色衬衫、神态沉稳的讲师站在柔和的浅灰色摄影棚背景前,面向镜头逐一讲解运镜术语。肩膀与头部随着说话节奏轻轻移动,表情专注而克制,目光平稳地看向镜头。前方侧面打来中性柔光主光,辅以细微的反射补光,营造安静的课堂氛围,皮肤质感真实,随着语句落下自然眨眼并微微点头。
复制完整提示词,改成你自己的生成任务。
标签
价格
p-video-2-pro-avatar 每秒
| 规格 | 单价 |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
定位简介
面向数字人口播场景的视频生成模型:上传一张人物肖像作为首帧,再提供语音音频或输入脚本文本,即可生成人物开口说话的视频。脚本由内置语音朗读,可选多种音色与语言,并用提示词描述人物说话时的动作和神态。适合课程讲解、营销口播、社交短视频等需要真人形象出镜的内容制作者,省去拍摄与对口型环节。
核心亮点
- 单张肖像即可驱动说话视频——只需一张人物肖像作为首帧,无需现有视频素材,即可生成人物开口说话的画面。
- 音频与脚本两种驱动方式——可上传不超过3分钟的语音音频,或输入脚本由内置语音朗读,视频长度跟随语音。
- 提示词控制神态与动作——用提示词描述人物说话时的外观、动作与神情,并可设置随机种子复现结果。
- 多档分辨率覆盖成片需求——可选480p、768p、1080p、2k、4k五档分辨率,便于按发布平台选择画质。
能力说明
肖像驱动的说话视频:以HTTPS链接提供jpg、jpeg、png或webp格式的人物肖像作为首帧,生成人物说话的视频,画面内容由提示词描述其外观、动作与神态。
上传语音驱动口型:提供HTTPS语音音频链接,视频长度与音频一致,最长3分钟;使用4k规格时音频最长125秒。此时脚本、音色、语言和语音风格设置不再生效。
脚本转语音驱动:未提供音频时,输入最多5000字符的脚本,由内置语音朗读并生成视频,脚本所用语言需从给定的十种语言中选择,可用最多1000字符的语音风格描述语气与节奏。
音色与画面参数选择:可从30种内置音色中择一朗读脚本,用最多2000字符的提示词描述画面,并设置0到2147483647之间的随机种子;分辨率在480p、768p、1080p、2k、4k中择一,默认768p。
适用场景
- 课程讲师批量口播视频——讲师提供肖像与讲解脚本,批量生成人物出镜的讲解视频,用于在线课程或知识栏目发布。
- 营销素材真人形象口播——运营人员用产品代言人肖像配合推广文案生成口播片段,投放至信息流或品牌社交账号。
- 已有录音配音成片——创作者上传本人录音与肖像,让画面口型贴合录音,直接产出社交平台短视频。
- 静态肖像转为说话视频——用已有的人物照片配合脚本或音频,生成带表情与口型的说话画面,用于数字人栏目或展示页。
限制与选型建议
脚本与提示词有长度上限:提示词最多2000字符,脚本最多5000字符,语音风格描述最多1000字符。内置语音不支持中文,脚本语种需从英文、西班牙文、法文、德文、意大利文、葡萄牙文(巴西)、日文、韩文和印地文中选择。视频长度由语音决定,最长3分钟;使用4k规格时音频最长125秒。
近期更新
查看更新日志 →- 模型上新 P-Video 2 Pro Avatar 上线:一张人像加音频或文字稿,生成最长 3 分钟的口播视频
常见问题
查看全部常见问题 →-
用什么音频驱动数字人?
用 audio_url 传入一段 HTTPS 音频链接,视频长度等于音频时长,最长 3 分钟(4k 最长 125 秒)。传了音频后,script、voice、voice_language 和 voice_prompt 都不生效,两者都传时以音频为准。
-
可以输入多长的脚本文本?
script 字段最多 5000 字符,但视频长度最终由内置 TTS 朗读该脚本的语音时长决定,上限为 3 分钟;接近上限时建议先精简文本或分段生成。
-
口播视频的提示词怎么写更好?
prompt 描述人物在说话时的外观、动作和神态,不写台词。建议按「人物外观→动作幅度→表情与视线→镜头感觉」的顺序写,例如「一位穿深色西装的男士,自然坐姿,偶尔点头,微笑注视镜头,固定中景」,控制在 2000 字符内,默认值仅为「The person is talking.」。
-
支持哪些语言和声音?
voice_language 有 10 种语言:美式英语、英式英语、西班牙语、法语、德语、意大利语、巴西葡萄牙语、日语、韩语、印地语,暂不含中文;voice 有 30 种预置声音,名称里标了性别,默认 Zephyr (Female)。script 的文字要和所选语言一致。
提交生成任务
https://api.hiapi.ai/v1/tasks 请求头
Authorizationstring必填账号 API Key,所有请求必填。示例:Bearer YOUR_HIAPI_API_KEY。获取 API Key
Content-Typestring可选请求体固定按 JSON 解析;如携带,仅接受 application/json(可带 charset),其他取值返回 415。示例:application/json。
Idempotency-Keystring可选幂等键,最长 255 字节。同账户同键的重试只创建一次任务,重放返回首次 taskId。
网络超时或客户端自动重试时,同键只创建一次任务、不会重复扣费(幂等范围 = API Key 所属账户)。建议用业务侧唯一标识做键(如 "order-42");同键重放返回首次 taskId,键在首次提交 24 小时后过期。详细的场景矩阵见统一异步接口介绍页。
请求体
modelstring必填当前固定值:p-video-2-pro-avatar
routestring可选当前固定值:default
inputobject必填
p-video-2-pro-avatar 和线路 default 的业务参数对象,见下方参数表。
seedinteger可选min 0max 2147483647随机种子,取 0–2147483647 的整数;传入相同的种子并保持其他输入不变,有助于复现结果,不传则随机。
voicestring可选默认值: "Zephyr (Female)"内置文本转语音所用的音色,默认 Zephyr (Female)。当提供 audio_url 时该参数被忽略。
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)显示全部(22 项)收起
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstring可选默认值: "The person is talking."maxLength 2000视频内容描述,说明人物在说话时的外观、动作与行为表现;默认「The person is talking.」。
scriptstring可选maxLength 5000数字人将要朗读的精确文稿,使用所选 voice_language 书写(不支持中文)。当未提供 audio_url 时必填;朗读时长决定视频长度,最长 3 分钟。
audio_urlstring可选pattern ^https://语音音频的 HTTPS URL,最长 3 分钟(4k 分辨率下最长 125 秒);视频长度与音频一致。提供后 script、voice、voice_language、voice_prompt 均被忽略。
image_urlstring必填pattern ^https://说话人物肖像图的 HTTPS URL,作为视频首帧使用;支持 jpg、jpeg、png、webp 格式。
resolutionstring可选默认值: "768p"输出分辨率,可选 480p、768p、1080p、2k、4k,默认 768p;分辨率越高费用越高。
480p768p1080p2k4kvoice_promptstring可选默认值: "Say the following."maxLength 1000语音风格指令,用于描述语气、节奏、口音或情绪等表达方式,不会被朗读;默认「Say the following.」。当提供 audio_url 时被忽略。
voice_languagestring可选默认值: "English (US)"script 文稿所使用的语言,默认 English (US)。当提供 audio_url 时被忽略。
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)Japanese显示全部(2 项)收起
KoreanHindicallbackobject可选
终态通知配置;为空则不回调,由调用方自行查询。详见下方回调说明。
创建任务时提供 callback.url,任务终态时 HiAPI 主动 POST 通知你的服务,可免去轮询。回调请求体与任务详情数据结构同构;签名校验、投递重试与幂等说明见统一异步接口介绍页的回调说明。
urlstring必填callback 存在时必填;任务终态后向该 URL 发起 POST,须为合法 http(s) URL。
whenstring可选默认值: "final"当前仅支持 final,即 success / fail 均回调。
finalstoragestring可选默认值: "temp"产物存储档位:temp(默认,保留约 7 天)或 persistent(长期保存,按大小计费)。余额不足或超出存储上限会静默降级为 temp;实际生效档位见任务详情响应。
temppersistent请求示例
# 提交异步任务,成功立即返回 taskId(不等待生成完成)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
获取任务详情
https://api.hiapi.ai/v1/tasks/:id 响应字段
taskIdstring必填任务 ID,前缀固定 tk-hiapi-。
modelstring必填解析后的模型全名。用 route 参数提交的任务返回 base@线路(如 gpt-image-2/text-to-image@ext);否则与创建时传入的模型名一致。
routestring可选仅当任务用显式 route 参数提交时出现,回显提交时的原值。
statusstring必填任务状态。
queued 已入队,尚未开始。
handling 处理中。
archiving 处理完成,产物准备中。
success 终态:完成,产物可用(返回 output)。
fail 终态:失败(返回 error)。
提交后按 status 判断:success 或 fail 为终态,其余为非终态,建议按 1~3 秒间隔轮询直至终态。成功终态后从 output[].url 下载产物,并在 expireAt 前完成下载或转存;需要长期保留时在创建任务时使用 storage: "persistent"。
creatednumber必填任务创建时间(Unix 秒)。
completednumber必填进入终态的 Unix 秒;非终态固定为 0。
outputarray可选
仅 status == success 时出现。产物列表,始终为数组,同一任务可能同时返回多个 type(如 video + first_frame)。
Array [ object ]
数组元素
urlstring必填资源 URL,可直接下载。
typestring必填当前可能值:video、image、audio、first_frame、last_frame、thumbnail,后续可能会扩展。
expireAtnumber必填资源可访问截止时间(Unix 秒);过期前请完成下载或转存。
errorobject可选
仅 status == fail 时出现。
codestring必填业务错误码。
messagestring必填错误描述。
响应示例
成功
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
处理中(非终态)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
失败
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}相关文章
查看全部文章 →
相关模型
查看全部模型 →同类型模型
-
 Grok Imagine 1.5 xAI $0.011 /秒
-
 Creatify Boreal Creatify $0.015 /秒
-
 OmniHuman 2.0 ByteDance $0.100 /秒
-
 LTX 2.5 Fast Lightricks $0.086 /秒
-
 Kandinsky 6.0 Pro $1.93 /条
-
 MiniMax H3 MiniMax $0.072 /秒
-
 Veo 3.1 Fast Google $0.170 /秒
-
 Wan 3.0 Video Alibaba $0.040 /秒
-
 Kling 2.5 Kuaishou $0.090 /秒
-
 Vidu Q3 Vidu $0.149 /秒
-
 P-Video 2 Pro Replace Pruna AI $0.036 /秒
-
 PixVerse V6 PixVerse $0.036 /秒