Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Pruna AI のポートレート駆動トーキングビデオモデル。1枚の人物写真からリップシンクと表情変化を伴う口播(トーク)クリップを生成でき、アップロードした音声で駆動させることも、内蔵のテキスト読み上げで台本をそのまま読み上げることも可能です。講座解説、多言語吹き替え、デジタルヒューマンのショート動画の一括制作に適しています
p-video-2-pro-avatar を試す
入力
作品ギャラリー
すべての作品を見る出力
videoカメラ言語ビジュアルノート・口令解説のデジタルヒューマンによるナレーション
スタイル ナレーション · カメラ言語 · スタジオ
参照入力
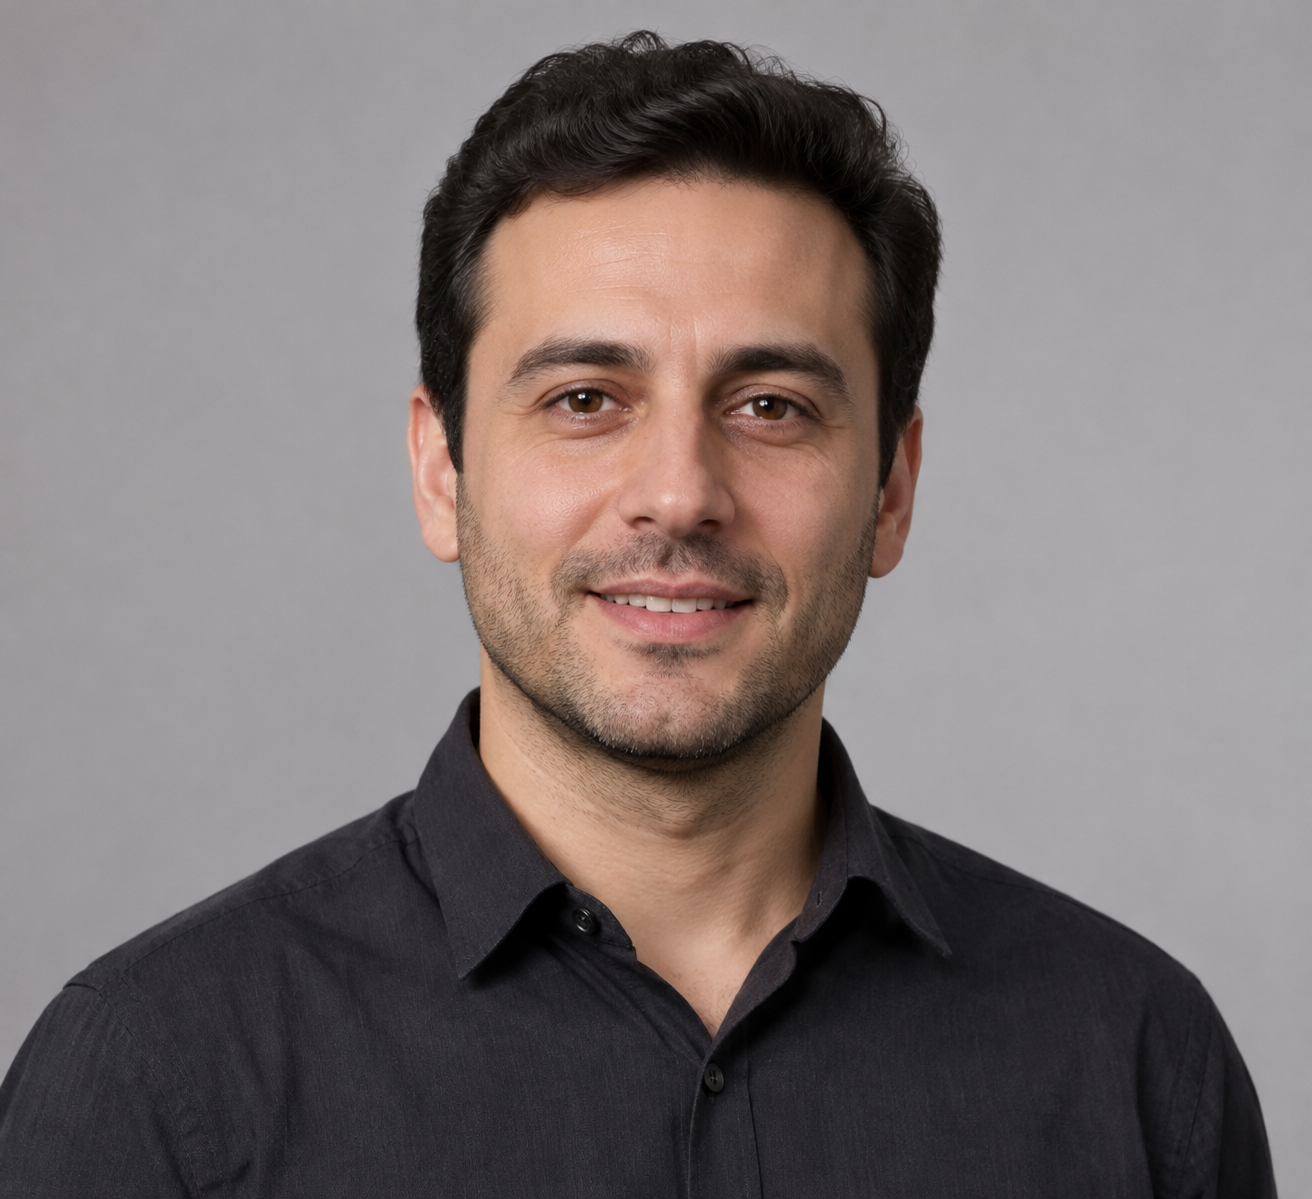
人物ポートレート画像
プロンプト
濃い色のシャツを着た落ち着いた表情の講師が、柔らかなライトグレーのスタジオ背景の前に立ち、カメラに向かってカメラワークの用語を一つずつ解説している。肩と頭は話すリズムに合わせて軽く動き、表情は集中して抑制が効いており、視線は安定してカメラを見つめている。前方の側面からニュートラルで柔らかなキーライトが当たり、繊細な反射による補助光が加わり、静かな授業の雰囲気を醸し出している。肌の質感はリアルで、言葉が区切りに差し掛かると自然にまばたきし、軽くうなずく。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
料金
p-video-2-pro-avatar per second
| 仕様 | 単価 |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
位置づけ概要
デジタルヒューマンのトーキングヘッド(口播)シーン向けの動画生成モデルです。人物の肖像を1枚アップロードして最初のフレームとし、さらに音声ファイルを提供するか台本テキストを入力するだけで、人物が話している動画を生成できます。台本は内蔵音声が読み上げ、複数の声種と言語を選択でき、プロンプトで人物が話す際の動作や表情を描写できます。講座解説、マーケティングの口播、SNS向けショート動画など、実在の人物が出演するコンテンツ制作に適しており、撮影やリップシンクの工程を省けます。
主な特長
- 1枚の肖像だけで話す動画を駆動——人物の肖像を1枚最初のフレームとして用意するだけで、既存の動画素材なしに人物が話す映像を生成できます。
- 音声と台本の2つの駆動方式——3分以内の音声をアップロードするか、台本を入力して内蔵音声に読み上げさせることができ、動画の長さは音声に追随します。
- プロンプトで表情と動作を制御——プロンプトで人物が話す際の外見、動作、表情を描写でき、ランダムシードを設定して結果を再現できます。
- 完成品のニーズをカバーする多段階の解像度——480p、768p、1080p、2k、4kの5段階の解像度を選択でき、配信プラットフォームに合わせて画質を選べます。
機能説明
肖像駆動のトーキング動画:HTTPSリンクでjpg、jpeg、png、webp形式の人物肖像を最初のフレームとして提供し、人物が話す動画を生成します。画面の内容はプロンプトで外見、動作、表情を描写します。
音声アップロードによるリップシンク駆動:HTTPSの音声リンクを提供すると、動画の長さは音声と一致し、最長3分です。4k仕様を使用する場合、音声は最長125秒です。この場合、台本、声種、言語、音声スタイルの設定は無効になります。
台本から音声への変換駆動:音声を提供しない場合、最大5000文字の台本を入力すると、内蔵音声が読み上げて動画を生成します。台本の言語は指定された10言語から選択する必要があり、最大1000文字の音声スタイルで語気とリズムを描写できます。
声種と画面パラメータの選択:30種の内蔵声種から1つを選んで台本を読み上げさせ、最大2000文字のプロンプトで画面を描写し、0から2147483647の間のランダムシードを設定できます。解像度は480p、768p、1080p、2k、4kから1つを選択し、デフォルトは768pです。
適用シーン
- 講座講師の口播動画の一括生成——講師が肖像と解説台本を提供し、人物が出演する解説動画を一括生成して、オンライン講座や知識系番組の配信に使用します。
- マーケティング素材の実在人物による口播——運用担当者が製品代言人の肖像と販促コピーを組み合わせて口播のクリップを生成し、フィード広告やブランドのSNSアカウントに配信します。
- 既存の録音による完成品の制作——クリエイターが自身の録音と肖像をアップロードし、画面のリップシンクを録音に合わせて、そのままSNSプラットフォーム向けのショート動画を制作します。
- 静止肖像をトーキング動画に変換——既存の人物写真に台本や音声を組み合わせて、表情とリップシンクを伴う話す映像を生成し、デジタルヒューマン番組や紹介ページに使用します。
制限と選定のアドバイス
台本とプロンプトには長さの上限があります。プロンプトは最大2000文字、台本は最大5000文字、音声スタイルの描写は最大1000文字です。内蔵音声は中国語に対応しておらず、台本の言語は英語、スペイン語、フランス語、ドイツ語、イタリア語、ポルトガル語(ブラジル)、日本語、韓国語、ヒンディー語の中から選択する必要があります。動画の長さは音声によって決まり、最長3分です。4k仕様を使用する場合、音声は最長125秒です。
最新情報
更新履歴を見る →- 新しいモデル P-Video 2 Pro Avatar 公開:1枚のポートレート画像と音声または台本から、最長3分のトーキングビデオを生成
よくある質問
よくある質問を見る →-
デジタルヒューマンを駆動するにはどのオーディオを使いますか?
audio_url に HTTPS のオーディオリンクを渡すと、動画の長さはオーディオの長さと等しくなり、最長 3 分(4k は最長 125 秒)です。オーディオを渡した場合、script、voice、voice_language、voice_prompt はすべて無効になり、両方を渡した場合はオーディオが優先されます。
-
どれくらいの長さのスクリプトテキストを入力できますか?
script フィールドは最大 5000 文字ですが、動画の長さは最終的に内蔵 TTS がそのスクリプトを読み上げる音声の長さで決まり、上限は 3 分です。上限に近づく場合は、まずテキストを簡潔にするか分割して生成することをおすすめします。
-
トーキングビデオのプロンプトはどう書けばよいですか?
prompt では、人物が話しているときの外見・動作・表情を描写し、セリフは書きません。おすすめは「人物の外見→動作の大きさ→表情と視線→カメラの印象」の順で書くことです。例えば「紺色のスーツを着た男性、自然な座り姿勢、時々うなずく、微笑みながらカメラを見つめる、固定の中景」のように、2000文字以内に収めます。デフォルト値は「The person is talking.」のみです。
-
対応している言語と音声は?
voice_language は10言語に対応しています:アメリカ英語、イギリス英語、スペイン語、フランス語、ドイツ語、イタリア語、ブラジルポルトガル語、日本語、韓国語、ヒンディー語で、中国語は現在含まれていません。voice には30種類のプリセット音声があり、名前には性別が記載されており、デフォルトは Zephyr (Female) です。script のテキストは選択した言語と一致させる必要があります。
生成タスクの作成
https://api.hiapi.ai/v1/tasks ヘッダー
Authorizationstring必須アカウントの API キー。すべてのリクエストで必須です。例:Bearer YOUR_HIAPI_API_KEY。API キーを取得
Content-Typestring任意リクエストボディは常に JSON として解析されます。送信する場合は application/json(charset 付き可)のみ受け付け、他の値は 415 を返します。例:application/json。
Idempotency-Keystring任意冪等キー。最大 255 バイト。同じアカウントで同じキーの再試行はタスクを 1 つだけ作成し、リプレイは最初の taskId を返します。
ネットワークタイムアウトやクライアントの自動再試行時、同じキーではタスクを 1 回だけ作成し、二重課金は発生しません(適用範囲 = API キーのアカウント)。業務側の一意識別子(例:"order-42")をキーに使うことを推奨します。同じキーのリプレイは最初の taskId を返し、キーは初回送信から 24 時間で失効します。詳細なシナリオ表は統一非同期 API の紹介ページをご覧ください。
ボディ
modelstring必須現在の固定値:p-video-2-pro-avatar
routestring任意現在の固定値:default
inputobject必須
p-video-2-pro-avatar とルート default の業務パラメータオブジェクト。下のパラメータ表を参照してください。
seedinteger任意min 0max 2147483647ランダムシード。0~2147483647 の整数を指定します。同じシードを渡し、他の入力を変えなければ結果の再現に役立ちます。渡さない場合はランダムになります。
voicestring任意デフォルト: "Zephyr (Female)"内蔵テキスト読み上げで使用する音色。デフォルトは Zephyr (Female)。audio_url が指定された場合、このパラメータは無視されます。
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)すべて表示(22 件)閉じる
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstring任意デフォルト: "The person is talking."maxLength 2000動画内容の説明。人物が話す際の外見、動作、振る舞いを記述します。デフォルトは「The person is talking.」。
scriptstring任意maxLength 5000デジタルヒューマンが読み上げる正確な原稿。選択した voice_language で記述します(中国語は非対応)。audio_url が指定されていない場合は必須です。読み上げ時間が動画の長さを決め、最長 3 分です。
audio_urlstring任意pattern ^https://音声ファイルの HTTPS URL。最長 3 分(4k 解像度では最長 125 秒)。動画の長さは音声と同じになります。指定された場合、script、voice、voice_language、voice_prompt はすべて無視されます。
image_urlstring必須pattern ^https://話す人物の肖像画像の HTTPS URL。動画の最初のフレームとして使用します。jpg、jpeg、png、webp 形式に対応しています。
resolutionstring任意デフォルト: "768p"出力解像度。480p、768p、1080p、2k、4k から選択でき、デフォルトは 768p です。解像度が高いほど費用も高くなります。
480p768p1080p2k4kvoice_promptstring任意デフォルト: "Say the following."maxLength 1000音声スタイルの指示。話し方のトーン、リズム、アクセント、感情などの表現方法を記述するもので、読み上げられることはありません。デフォルトは「Say the following.」。audio_url が指定された場合は無視されます。
voice_languagestring任意デフォルト: "English (US)"script 原稿で使用する言語。デフォルトは English (US)。audio_url が指定された場合は無視されます。
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)Japaneseすべて表示(2 件)閉じる
KoreanHindicallbackobject任意
終了状態の通知設定。省略した場合はコールバックされず、呼び出し側でポーリングします。
作成時に callback.url を指定すると、タスク終了時に HiAPI があなたのサービスへ POST し、ポーリングが不要になります。コールバックのリクエストボディはタスク詳細と同構造です。署名検証・再送・冪等の詳細は統一非同期 API 紹介ページのコールバック説明を参照してください。
urlstring必須callback を指定する場合は必須。タスク終了後にこの URL へ POST します。有効な http(s) URL である必要があります。
whenstring任意デフォルト: "final"現在は final のみ対応(success / fail の両方で通知)。
finalstoragestring任意デフォルト: "temp"成果物の保存期間:temp(デフォルト・約 7 日)または persistent(長期保存・サイズ課金)。残高不足や保存上限超過の場合は temp に自動降格します。実際に適用された段階はタスク詳細レスポンスで確認できます。
temppersistentリクエスト例
# 非同期タスクを送信。成功すると即座に taskId を返します(生成完了は待ちません)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
タスク詳細の取得
https://api.hiapi.ai/v1/tasks/:id レスポンスフィールド
taskIdstring必須タスク ID。先頭は固定で tk-hiapi-。
modelstring必須解決済みのモデル完全名。route パラメータで送信したタスクは base@route(例:gpt-image-2/text-to-image@ext)を返し、それ以外は送信時のモデル名と同一です。
routestring任意route パラメータを明示して送信したタスクでのみ出現し、送信時の値をエコーします。
statusstring必須タスク状態。
queued キュー投入済み、未開始。
handling 処理中。
archiving 処理完了、成果物準備中。
success 終端:完了。成果物利用可能(output を返却)。
fail 終端:失敗(error を返却)。
送信後は status で判断します:success と fail が終端、それ以外は非終端です。1〜3 秒間隔で終端までポーリングすることを推奨します。成功したら output[].url から成果物をダウンロードし、expireAt までに保存先へ転送してください。長期保存が必要な場合は作成時に storage: "persistent" を指定します。
creatednumber必須タスク作成時刻(Unix 秒)。
completednumber必須終了状態になった Unix 秒。非終端では 0 固定。
outputarray任意
status == success のときのみ出現。成果物リスト — 常に配列で、1 タスクで複数の type を同時に返すことがあります(例:video + first_frame)。
Array [ object ]
配列要素
urlstring必須成果物の URL。直接ダウンロードできます。
typestring必須現在の候補値:video、image、audio、first_frame、last_frame、thumbnail。今後拡張される可能性があります。
expireAtnumber必須成果物にアクセスできる期限(Unix 秒)。期限までにダウンロードまたは転送してください。
errorobject任意
status == fail のときのみ出現。
codestring必須業務エラーコード。
messagestring必須エラーの説明。
レスポンス例
成功
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
処理中(非終端)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
失敗
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}関連記事
すべての記事を見る →
関連モデル
すべてのモデルを見る →同タイプ
-
 Veo 3.1 Fast Google $0.170 /秒
-
 Grok Imagine 1.5 xAI $0.011 /秒
-
 Vidu Q4 Preview Vidu $0.051 /秒
-
 HappyHorse 1.1 Alibaba $0.160 /秒
-
 Wan 2.7 Video Alibaba $0.100 /秒
-
 Kling 3.0 Kuaishou $0.100 /秒
-
 Gemini Omni 1.2 Google $0.023 /秒
-
 Wan 3.0 Video Alibaba $0.040 /秒
-
 Kling 4.0 Kuaishou $0.204 /秒
-
 HeyGen Avatar IV HeyGen $0.150 /秒
-
 Seedance 2.0 ByteDance $0.017 /秒
-
 Veo 3.1 Google $0.290 /秒