
使用ガイド
P-Video 2 Pro Avatar 入門ガイド:ポートレート1枚と音声または台本から、最長3分のトーキング動画を生成
機能、入力ルール、API 呼び出し、価格、プロンプトの書き方
- モデル
- p-video-2-pro-avatar
このページの内容
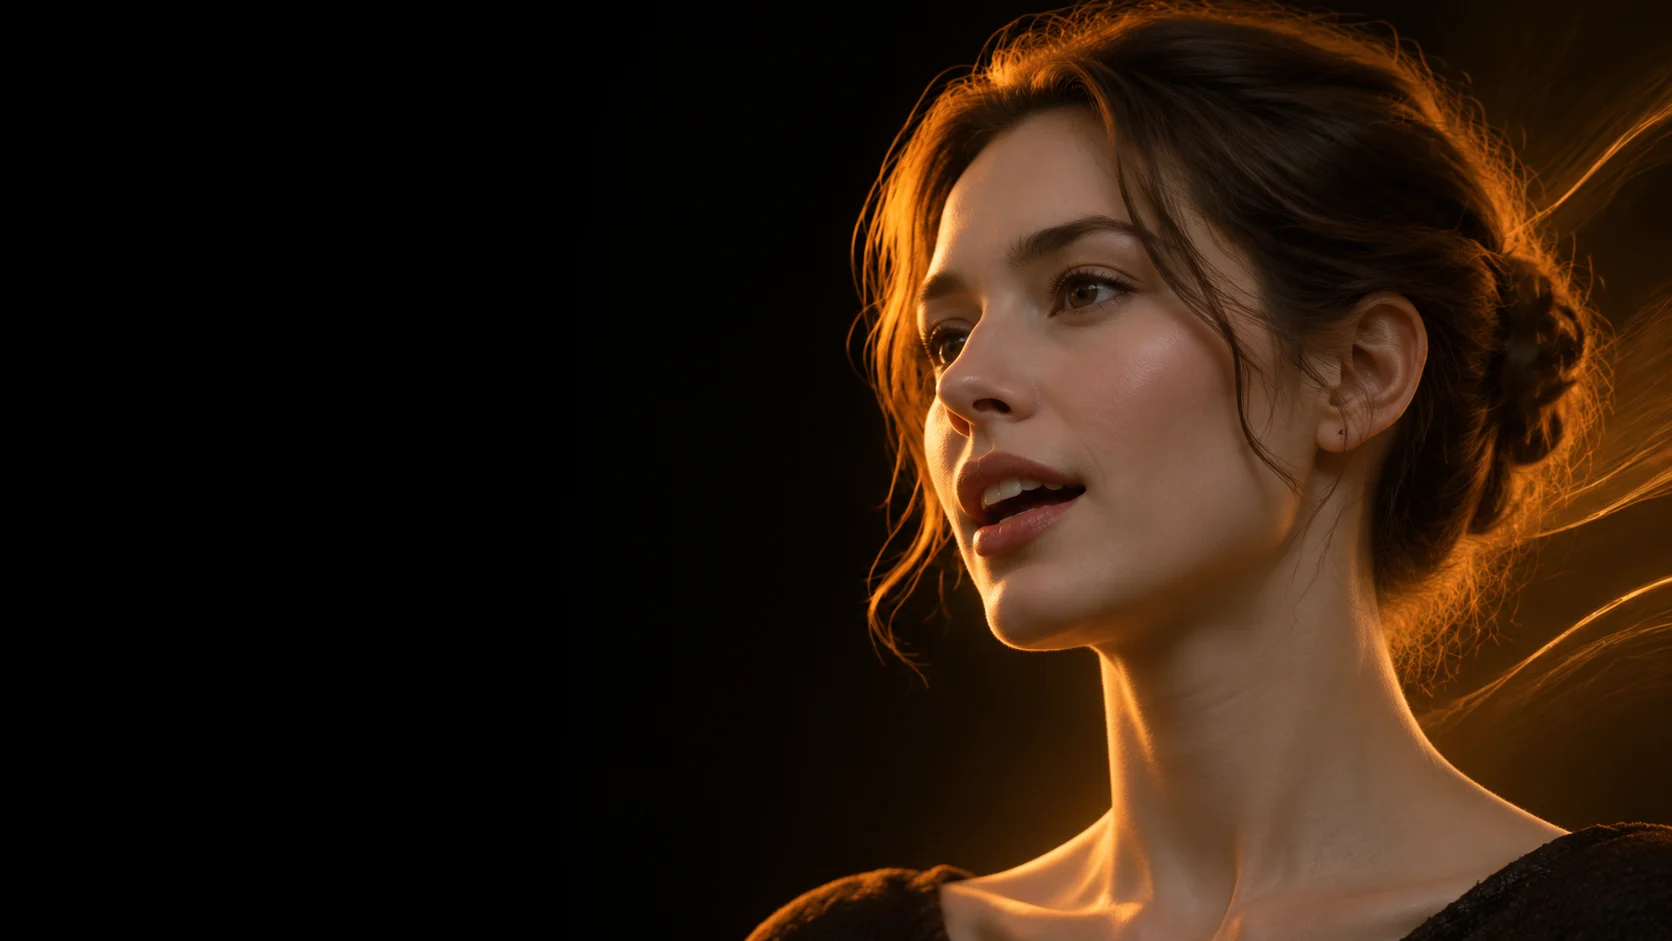
P-Video 2 Pro Avatar は Pruna AI のトーキング動画モデルです。ポートレート1枚と、音声または台本を渡すと、その人物が口を開いて話す動画を生成します。この記事では、何ができるのか、どう呼び出すのか、料金はどう計算されるのか、そしてどんなときに別のモデルに切り替えるべきかを解説します。
できること
- ポートレート1枚で出演できる:必須なのはポートレート画像
image_url(jpg、jpeg、png、webp)だけです。これが動画の最初のフレームになり、動画素材も、事前の人物学習も不要です。 - 2つの駆動方式:音声
audio_urlを渡すと、動画の長さは音声の長さと同じになります。台本script(最大5000文字)だけを渡すと、内蔵音声で読み上げます。1本あたり最長3分、4k では音声が最長125秒です。 - 内蔵音声を選択可能:30種類の声(名前に性別が付記されており、デフォルトは Zephyr (Female))、10言語:アメリカ英語、イギリス英語、スペイン語、フランス語、ドイツ語、イタリア語、ブラジルポルトガル語、日本語、韓国語、ヒンディー語に対応しています(中国語は現時点では未対応)。
voice_promptには話し方、話す速さ、感情を書きます。このテキストは読み上げられません。 - プロンプトで画面を制御:
prompt(最大2000文字)で、人物が話すときの様子、動作、表情を記述します。デフォルトは “The person is talking.” です。 - 5段階の解像度:480p、768p、1080p、2k、4k、デフォルトは 768p。
入力ルール
- 音声と台本は少なくとも一方を指定してください。両方を指定した場合は音声が優先され、
script、voice、voice_language、voice_promptは無効になります。 - どちらも指定しない場合、タスクは失敗し、いずれかを補うよう促され、料金は全額返金されます。
- コンテンツセーフティフィルターはデフォルトで有効です。違反コンテンツは失敗し
CONTENT_POLICY_VIOLATIONを返し、料金は全額返金されます。
呼び出し方
非同期タスクを送信し、taskId を取得してから結果をポーリングします:
curl https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "p-video-2-pro-avatar",
    "input": {
      "image_url": "https://example.com/portrait.png",
      "script": "Welcome to the course. Today we cover three ideas.",
      "voice": "Charon (Male)",
      "voice_language": "English (US)",
      "voice_prompt": "Calm and clear, moderate pace",
      "resolution": "768p"
    }
  }'

curl https://api.hiapi.ai/v1/tasks/<taskId> \
-H "Authorization: Bearer $HIAPI_KEY"自分の録音を使う場合は、script と voice 系のパラメータを "audio_url": "https://example.com/voice.mp3" に置き換えるだけです。タスクが成功すると、output に動画の URL が入ります。
価格
出力動画の長さに応じて課金され、1秒未満の端数は課金されません:
- 480p:$0.0286/秒
- 768p:$0.0572/秒
- 1080p:$0.0858/秒
- 2k:$0.1143/秒
- 4k:$0.1715/秒
たとえば30秒の 768p トーキング動画は約 $1.72、30秒の 480p は約 $0.86 です。音声を渡す場合は音声の長さで事前に引き落とされます。台本だけを渡す場合は、送信時点では読み上げの長さがわからないため、まず3分として事前に引き落とされ、完了後に実際の動画の長さで精算され、余分に引かれた分は返金されます。失敗したタスクは全額返金されます。
プロンプトの書き方
prompt には画面だけを書き、セリフは書きません。「人物の外見 → 動作の大きさ → 表情と視線 → 光やカメラ」の順に書きます。たとえば:
- 講座解説:
A calm instructor in a dark shirt, small head nods, steady eye contact, soft studio light - 展示館ガイド:
A curator speaking warmly to camera, blinks naturally, warm gallery lighting
話し方やリズムは voice_prompt に書きます。たとえば “Speak softly, small pauses between sentences”。
別のモデルを選ぶべきとき
- 既存動画の人物の口の動きを新しい音声に合わせたい場合、または誰も話さない画像からの動画生成を行いたい場合:これは P-Video 2 Pro Avatar の用途ではありません。対応する動画編集モデルまたは画像からの動画生成モデルを選んでください。
- 動画内の人物を別の人物に置き換え、元の動画の動作やカメラワークを保ちたい場合:同シリーズの P-Video 2 Pro Replace を使用してください。
実際に試したい場合は、HiAPI Playground でポートレートをアップロードし、台本を書いて生成できます。
関連記事
すべての記事を見る →-

使用ガイド
hiAPI API で Ideogram V3 Character Edit を使ってEC商品画像を編集する
開発者ガイド:一貫した主体、クリーンな背景差し替え、そして実用的な hiAPI リクエスト
-

使用ガイド
HiAPI API で happyhorse-1.1/reference-to-video を使う:プロンプトレシピとショート動画ワークフロー
開発者ガイド:HiAPI で参照画像を構成し、アイデンティティの一貫性を保つプロンプトを書き、ショート動画のテンポを制御する方法
-

使用ガイド
qwen-image-2.1-pro でEC商品画像を生成する:APIの使い方とプロンプトレシピ
エンドツーエンドの開発者ガイド:透過PNG、画像編集、文字描画、そしてすぐにコピーできる curl と Python requests のプロンプト