
Benutzerhandbuch
ElevenLabs Text to Dialogue – Leitfaden: Dialogaudio für zwei Sprecher über ein dialogue-Array übermitteln
Vom Aufteilen eines Zwei-Sprecher-Skripts bis zur stimmweisen Anfrage pro Zeile: Übermittlung und Abnahme gemäß aktuellem HiAPI-Vertrag
Auf dieser Seite
Zuerst klären: Dialog-Synthese statt Einzelvorlesung
Wenn Ihr Material ein Dialogskript mit zwei (oder mehr) Rollen ist, ist der naheliegendste Weg oft, jede Zeile einzeln zu synthetisieren und dann der Reihe nach zusammenzufügen. Die Probleme dieser Methode zeigen sich erst in der Auslieferungsphase: Jede Zeile ist eine eigene Audiodatei, Pausen zwischen den Zeilen, Sprechtempo-Übergänge und Stimmkonsistenz müssen Sie auf der Zusammenfüge-Ebene erneut nachbessern; bei vielen Rollen werden Reihenfolge und Stimm-Fehlzuordnung zur Hauptfehlerquelle.
elevenlabs/text-to-dialogue ist dafür gedacht, einen gesamten Dialog mit einer einzigen Anfrage auszudrücken. Sie teilen das gesamte Skript in ein dialogue-Array auf und übermitteln es; das Modell erzeugt in demselben Generierungsvorgang einen Dialog mit mehreren Stimmen und gibt eine einzige vollständige Audiodatei aus. Verglichen mit „mehrfacher Einzelsynthese + Zusammenfügen“ sind sowohl Rollenzuordnung als auch Zeilenreihenfolge im Request-Body enthalten, und bei der Abnahme müssen Sie nur ein Ergebnis prüfen.
Treffen Sie daher zunächst eine Entscheidung:
- Ist der Inhalt eine fortlaufende Vorlesung desselben Sprechers, genügt Text-to-Speech; ein
dialogue-Array ist nicht nötig; - Ist der Inhalt ein Dialog mit zwei oder mehr abwechselnden Rollen und wünschen Sie einen einheitlichen Gesamtklang, sollten Sie das
dialogue-Array dieser Schnittstelle verwenden; - Ist der Inhalt ein Dialog, aber die Gesamtzeichenzahl weit über dem Limit, müssen Sie ihn semantisch in Abschnitte teilen und diese getrennt übermitteln, statt zur zeilenweisen Synthese zurückzukehren.
Nachdem Sie festgestellt haben, dass Fall zwei vorliegt, müssen Sie als Nächstes die Struktur des Arrays selbst verstehen.
Struktur des dialogue-Arrays: text und voice pro Zeile
Im HiAPI-Vertrag hat elevenlabs/text-to-dialogue im Kern nur ein Pflichtfeld als Eingabe: dialogue. Es ist ein Array mit mindestens 1 Element; jedes Element ist eine Dialogzeile und enthält zwei Pflicht-Unterfelder:
text: der Text der jeweiligen Zeile, String, mindestens 1 Zeichen;voice: die für die Zeile verwendete Stimme, String; ein vordefinierter Stimmenname oder einevoice_idist zulässig, StandardwertEkK5I93UQWFDigLMpZcX.
Beide Felder sind Pflichtfelder – selbst wenn Sie nur die Standardstimme verwenden möchten, empfiehlt es sich, voice explizit anzugeben, damit der Request-Body selbsterklärend ist. Eine minimale Anfrage für zwei Sprecher sieht so aus:
{
  "dialogue": [
    { "text": "Wie steht es bei dir mit dem Fortschritt?", "voice": "EkK5I93UQWFDigLMpZcX" },
    { "text": "Diese Woche schaffe ich die erste Version.", "voice": "Z3R5wn05IrDiVCyEkUrK" },
    { "text": "Gut, dann schicke ich dir zuerst die Abnahmeliste.", "voice": "EkK5I93UQWFDigLMpZcX" }
  ]
}
Beachten Sie: Die Reihenfolge des Arrays ist die Dialogreihenfolge. Die Schnittstelle hat kein zusätzliches Feld für den „Sprecher“; die Rollen werden ausschließlich über voice unterschieden. Das ist der Punkt, der während der gesamten Integration am frühesten durchdacht werden muss.
Ein Zwei-Sprecher-Skript in Zeileneinträge aufteilen
Vom Skripttext zum dialogue-Array empfiehlt sich eine feste Pipeline, um Fehler beim manuellen Schreiben von JSON zu vermeiden.
Schritt eins: Zeilenweise aufteilen und Sprecher kennzeichnen
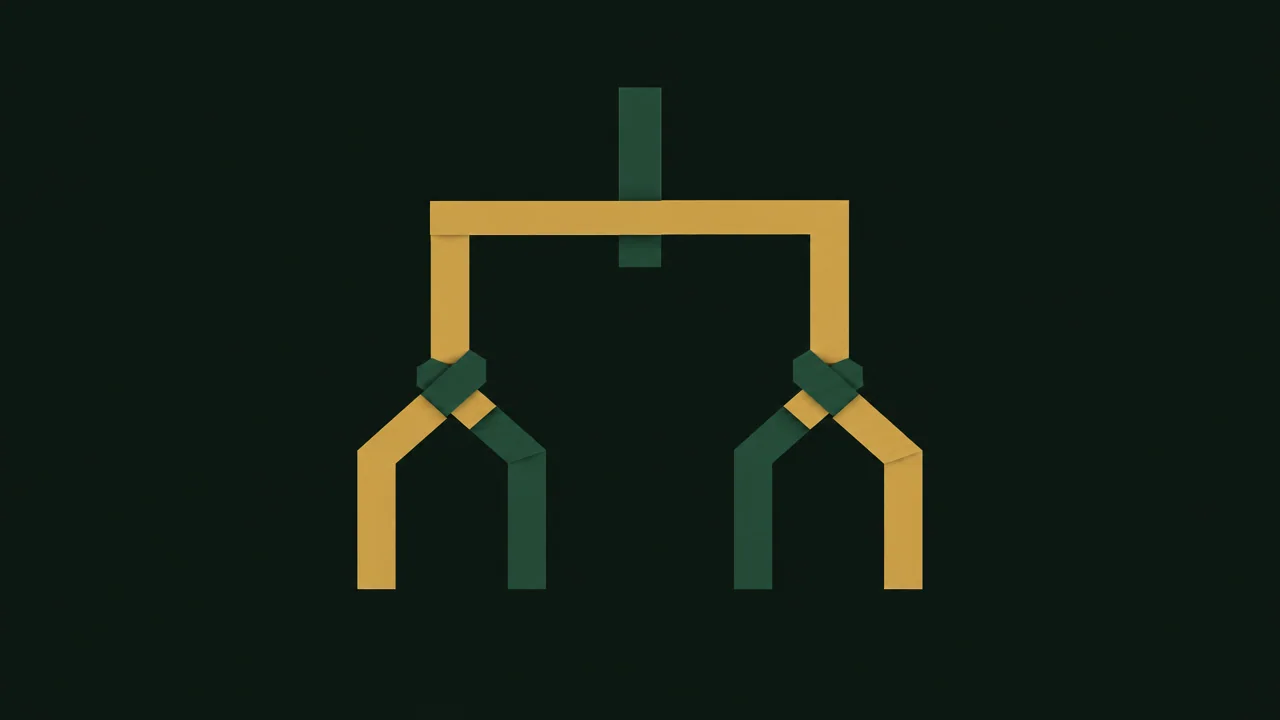
Bringen Sie das Skript in eine paarweise Struktur aus „Sprecher + Text“, eine Zeile pro Eintrag. Fassen Sie die Texte zweier Rollen nicht in einem einzigen text zusammen – ein Element kann nur eine voice tragen, nach dem Zusammenfassen lassen sich die Rollen nicht mehr unterscheiden. Erzählertext und in Klammern stehende Bühnenanweisungen gehören nicht zum Dialog; entfernen Sie sie separat und stecken Sie sie nicht in text.
Schritt zwei: Text bereinigen
Prüfen Sie jeden Eintrag: Entfernen Sie führende und nachfolgende Leerzeichen, vereinheitlichen Sie Satzzeichen und Zeilenumbrüche, löschen Sie Leerzeilen. Die Mindestlänge von text beträgt 1 Zeichen; ein leerer String löst direkt einen Validierungsfehler aus. Besteht eine Zeile nur aus Füllwörtern (etwa „mhm“ oder „ja“), kann sie bleiben; wird sie nach der Bereinigung jedoch zum leeren String, muss mit der Inhaltsseite geklärt werden, ob die Zeile entfällt.
Schritt drei: Rollenzuordnung aufbauen und Array erzeugen
Jedes Sprecher-Label wird einer eindeutigen Stimme zugeordnet, dann werden die Elemente in Zeilenreihenfolge erzeugt. Der Pseudocode sieht etwa so aus:
speaker_voice = {
    "A": "EkK5I93UQWFDigLMpZcX",
    "B": "Z3R5wn05IrDiVCyEkUrK",
}

dialogue = [
    {"text": line.text, "voice": speaker_voice[line.speaker]}
    for line in script
]
Häufige Fallstricke
- Dieselbe Rolle erhält an zwei Stellen unterschiedliche Stimmen, was den Höreindruck deutlich zerreißt;
voicewird vergessen, sodass der gesamte Abschnitt auf die Standardstimme zurückfällt und der Zwei-Personen-Dialog zu „eine Person spricht beide Rollen“ wird;- Die Array-Reihenfolge wird durch Sortier- oder Deduplizierungslogik durcheinandergebracht, wodurch die Dialogbedeutung zerbricht.
Geben Sie nach der Erzeugung zunächst die ersten Einträge aus und prüfen Sie sie manuell, bevor Sie zum Zeichenbudget übergehen.
Feste Stimmzuordnung: eine einzige voice pro Rolle
Der Grund, voice zu „fixieren“, liegt darin, dass es sowohl die Stimme selbst bestimmt als auch die Semantik „wer hier spricht“ trägt. Taucht für dieselbe Rolle im gesamten Dialog zwei unterschiedliche voice-Werte auf, glauben die Zuhörer an einen Sprecherwechsel; umgekehrt verlieren zwei Rollen die Unterscheidbarkeit, wenn sie auf dieselbe voice treffen.
In der Praxis empfiehlt es sich, im Code eine konstante Zuordnungstabelle von Rollen zu Stimmen zu pflegen, statt String-Literale über die einzelnen Zeilen zu verstreuen:
const VOICE = {
  host: "EkK5I93UQWFDigLMpZcX",
  guest: "Z3R5wn05IrDiVCyEkUrK",
};
Alle Zeilen beziehen ihren Wert nur aus dieser Tabelle; Zeilenumbrüche oder Umstellungen im Skript zerstören die Konsistenz nicht. voice akzeptiert vordefinierte Stimmenamen oder eine voice_id; verfügt das Team bereits über ein eigenes Namensschema für Stimmen, kann man in der Konfigurationsschicht einmal umwandeln und beim Request einheitlich auf vom Schnittstellenvertrag akzeptierte Werte bringen. Der Vertrag gibt eine Stimmen-Enumeration vor; eine Prüfung gegen diese Enumeration vor dem Übermitteln fängt triviale Fehler wie Tippfehler ab – Werte außerhalb der Enumeration werden nicht stillschweigend als Standardwert behandelt.
Ein weiterer oft übersehener Punkt ist die Stabilität über Abschnitte hinweg. Wenn die Gesamtzeichenzahl das Limit überschreitet und die Anfrage in mehrere Requests aufgeteilt werden muss, muss die Stimmzuordnungstabelle unverändert wiederverwendet werden; wählen Sie in neuen Requests keine Stimmen neu aus, sonst hört man bei derselben Rolle zwischen verschiedenen Abschnitten Unterschiede.
Zeichenbudget und Aufteilung der Anfrage
Die Schnittstelle hat eine harte Beschränkung beim Umfang: Die Gesamtzeichenzahl aller text-Felder im dialogue-Array darf 5000 nicht überschreiten. Gemeint ist die Summe aller Texte im Array, nicht die Länge einer Zeile und nicht die Anzahl der Elemente. Chinesische und englische Zeichen sowie Satzzeichen zählen in der Regel als Zeichen; kalkulieren Sie im Zweifel großzügig und lassen Sie Puffer.
Die Zähl-Logik sollte nach dem Erzeugen des Arrays und vor dem Absenden des Requests laufen:
total = sum(len(item["text"]) for item in dialogue)
assert total <= 5000
Bei Überschreitung des Limits ist der richtige Weg, den Inhalt an semantischen Grenzen aufzuteilen in mehrere Teil-Dialoge, diese getrennt zu übermitteln, jeweils Audio zu erhalten und dann nach Geschäftsanforderung zu kombinieren – nicht, Zeilen abzuschneiden oder zu löschen. Beim Aufteilen sind drei Punkte zu beachten:
- Wählen Sie die Schnittpunkte an Szenenwechseln und Themenwechseln, um Frage und Antwort nicht auf zwei Requests zu verteilen;
- Zählen Sie jedes Teilsegment separat; auch dieses darf 5000 nicht überschreiten;
- Beim Neuaufbau des Arrays für jedes Teilsegment bleiben die ursprüngliche Zeilenreihenfolge und die Stimmzuordnung der Rollen erhalten.
Ist der Inhalt selbst ein langer Dialog, empfiehlt es sich, ihn bereits auf der Inhaltsseite nach „Akten“ oder „Kapiteln“ zu organisieren, sodass jeder Akt von Natur aus im Budget bleibt und Hörbrüche durch Ad-hoc-Aufteilungen reduziert werden.
Optionale Parameter: stability und language_code
Neben dialogue bietet die Schnittstelle zwei optionale Parameter, deren Verwendung vom Inhaltstyp abhängt.
stability
stability ist ein numerischer Parameter mit den zulässigen Werten 0, 0.5 und 1, Standard 0.5. Die Semantik ist die Stimmstabilität:
- Je kleiner der Wert, desto ausdrucksstärker und variabler die Emotion – geeignet für Dialoge mit emotionalen Schwankungen und erzählerische Inhalte;
- Je größer der Wert, desto stabiler und gleichmäßiger die Ausgabe – geeignet für Markenansagen, Kundenservice-Skripte und ähnliche Szenarien mit einheitlichem Höreindruck;
- Der Standardwert 0.5 ist ein Kompromiss zwischen beidem.
Beachten Sie: Dies ist ein Parameter auf Ebene der gesamten Anfrage, keine Einstellung pro Zeile. Wenn die emotionalen Unterschiede der Rollen innerhalb eines Dialogs groß sind, akzeptieren Sie entweder einen Kompromisswert oder lassen Sie beim Aufteilen in Abschnitte die einzelnen Segmente unterschiedliche stability-Werte verwenden.
language_code
language_code ist ein Sprachcode im ISO-Format, Standardwert ist ein leerer String; leer bedeutet automatische Spracherkennung. Wenn die Inhaltssprache eindeutig ist und Sie Erkennungsabweichungen vermeiden möchten, ist eine explizite Angabe sicherer, etwa zh für chinesische Inhalte. Der Vertrag enthält eine vollständige Enumeration der Sprachcodes; vor dem Übermitteln sollte gegen diese validiert werden, um nicht unterstützte Werte zu vermeiden.
Beide Parameter sind optional; hat der Inhalt keine besonderen Anforderungen, können Sie sie weglassen und das Standardverhalten verwenden.
Übermittlung und Abnahme: Prüfung nach dem aufgabenbasierten Vertrag
Die Schnittstelle wird aufgabenbasiert übermittelt: Sie senden die Eingabe, erhalten ein Aufgabenergebnis und nehmen die Abnahme anhand dieses Ergebnisses vor. Das bedeutet zweierlei.
Erstens: Den Eingabevertrag selbst validieren. Prüfen Sie vor dem Absenden des Requests Punkt für Punkt: dialogue ist ein Array mit mindestens 1 Element; jedes Element hat sowohl ein nicht leeres text als auch ein nicht leeres voice; die Gesamtzeichenzahl aller text überschreitet 5000 nicht; stability nimmt nur 0/0.5/1 an; language_code gehört zur Enumeration oder bleibt leer. Diese Prüfungen im Client unterzubringen reduziert ungültige Übermittlungen deutlich.
Zweitens: Keine im Vertrag nicht deklarierten Verhaltensweisen annehmen. Die Schnittstellendokumentation verspricht weder automatische Wiederholungen noch Idempotenzschlüssel oder Fehlerkompensation; verlassen Sie sich daher nicht auf „wiederholtes Senden derselben Anfrage“ als Absicherung – jede Übermittlung sollte als eigenständige Aufgabe betrachtet werden. Ein solides Vorgehen in der Praxis ist:
- Vor dem Übermitteln eine Zusammenfassung der Eingabe dieser Anfrage protokollieren (Anzahl Array-Elemente, Gesamtzeichenzahl, Version der Stimmzuordnung), um später vergleichen zu können;
- Nach Erhalt des Ergebnisses zuerst prüfen, ob das Audio verwendbar, die Dauer plausibel und die Rollen unterscheidbar sind, bevor Sie es nachgelagert verteilen;
- Wenn ein erneuter Lauf nötig ist, die vollständige Eingabevalidierung erneut durchlaufen statt den ungeprüften alten Request-Body wiederzuverwenden.
Der Schwerpunkt der Abnahme ist „ob das Ergebnis den Erwartungen entspricht“, nicht die Spekulation über interne Abläufe des Servers. Bei HiAPI können Sie sich auf der Modellseite von elevenlabs/text-to-dialogue den aktuellen Vertrag ansehen, bevor Sie loslegen.
Selbstprüfliste vor dem Produktivbetrieb
Machen Sie aus der folgenden Prüfgruppe einen automatischen Ablauf vor dem Übermitteln; damit sind die meisten Fehlerursachen abgedeckt:
dialogueist ein Array mit Elementanzahl ≥ 1;- Jedes Element enthält zugleich
textundvoice, und keines davon ist ein leerer String; - Jede
voiceliegt innerhalb der Vertrags-Enumeration, und dieselbe Rolle verwendet global nur einen einzigen Wert; - Die Array-Reihenfolge entspricht der Zeilenreihenfolge des Skripts; keine Sortier- oder Deduplizierungslogik greift ein;
- Die Gesamtzeichenzahl aller
textist ≤ 5000; über dem Limit liegende Inhalte wurden semantisch aufgeteilt; - Falls explizit gesetzt:
stability∈ {0, 0.5, 1},language_code∈ Enumeration oder leer; - Die Eingabezusammenfassung (Anzahl Elemente, Zeichenzahl, Mapping-Version) ist protokolliert, um die Abnahme vergleichen zu können.
Über die Liste hinaus gilt eine Erfahrungsregel: Erst mit einem kurzen Beispiel Ende-zu-Ende zum Laufen bringen, dann auf das gesamte Skript ausweiten. Probleme mit der Rollenzuordnung und dem Zeichenbudget zeigen sich bereits an einem Beispiel mit einigen Dutzend Zeilen; man muss nicht warten, bis der gesamte Inhalt übermittelt ist, um sie zu entdecken.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Leitfaden für den Einstieg in gpt-6.2-sol: Grenzen der Fähigkeiten, API-Anbindung und Hinweise zur Token-Abrechnung
Entscheidungshilfen und praktische Hinweise zur Anbindung für Engineering-Teams
-

Benutzerhandbuch
gpt-6.2-astra Einstiegsleitfaden: Grenzen der Textmodell-Fähigkeiten, Integrationspunkte und Kostenkontrolle
-

Benutzerhandbuch
Tripo H3.1 Einstiegsleitfaden: Drei Eingabewege, Parameter und Preiswahl
Praktische Entscheidungsfindung und Kostenkontrolle bei der 3D-Generierungsintegration für Entwickler